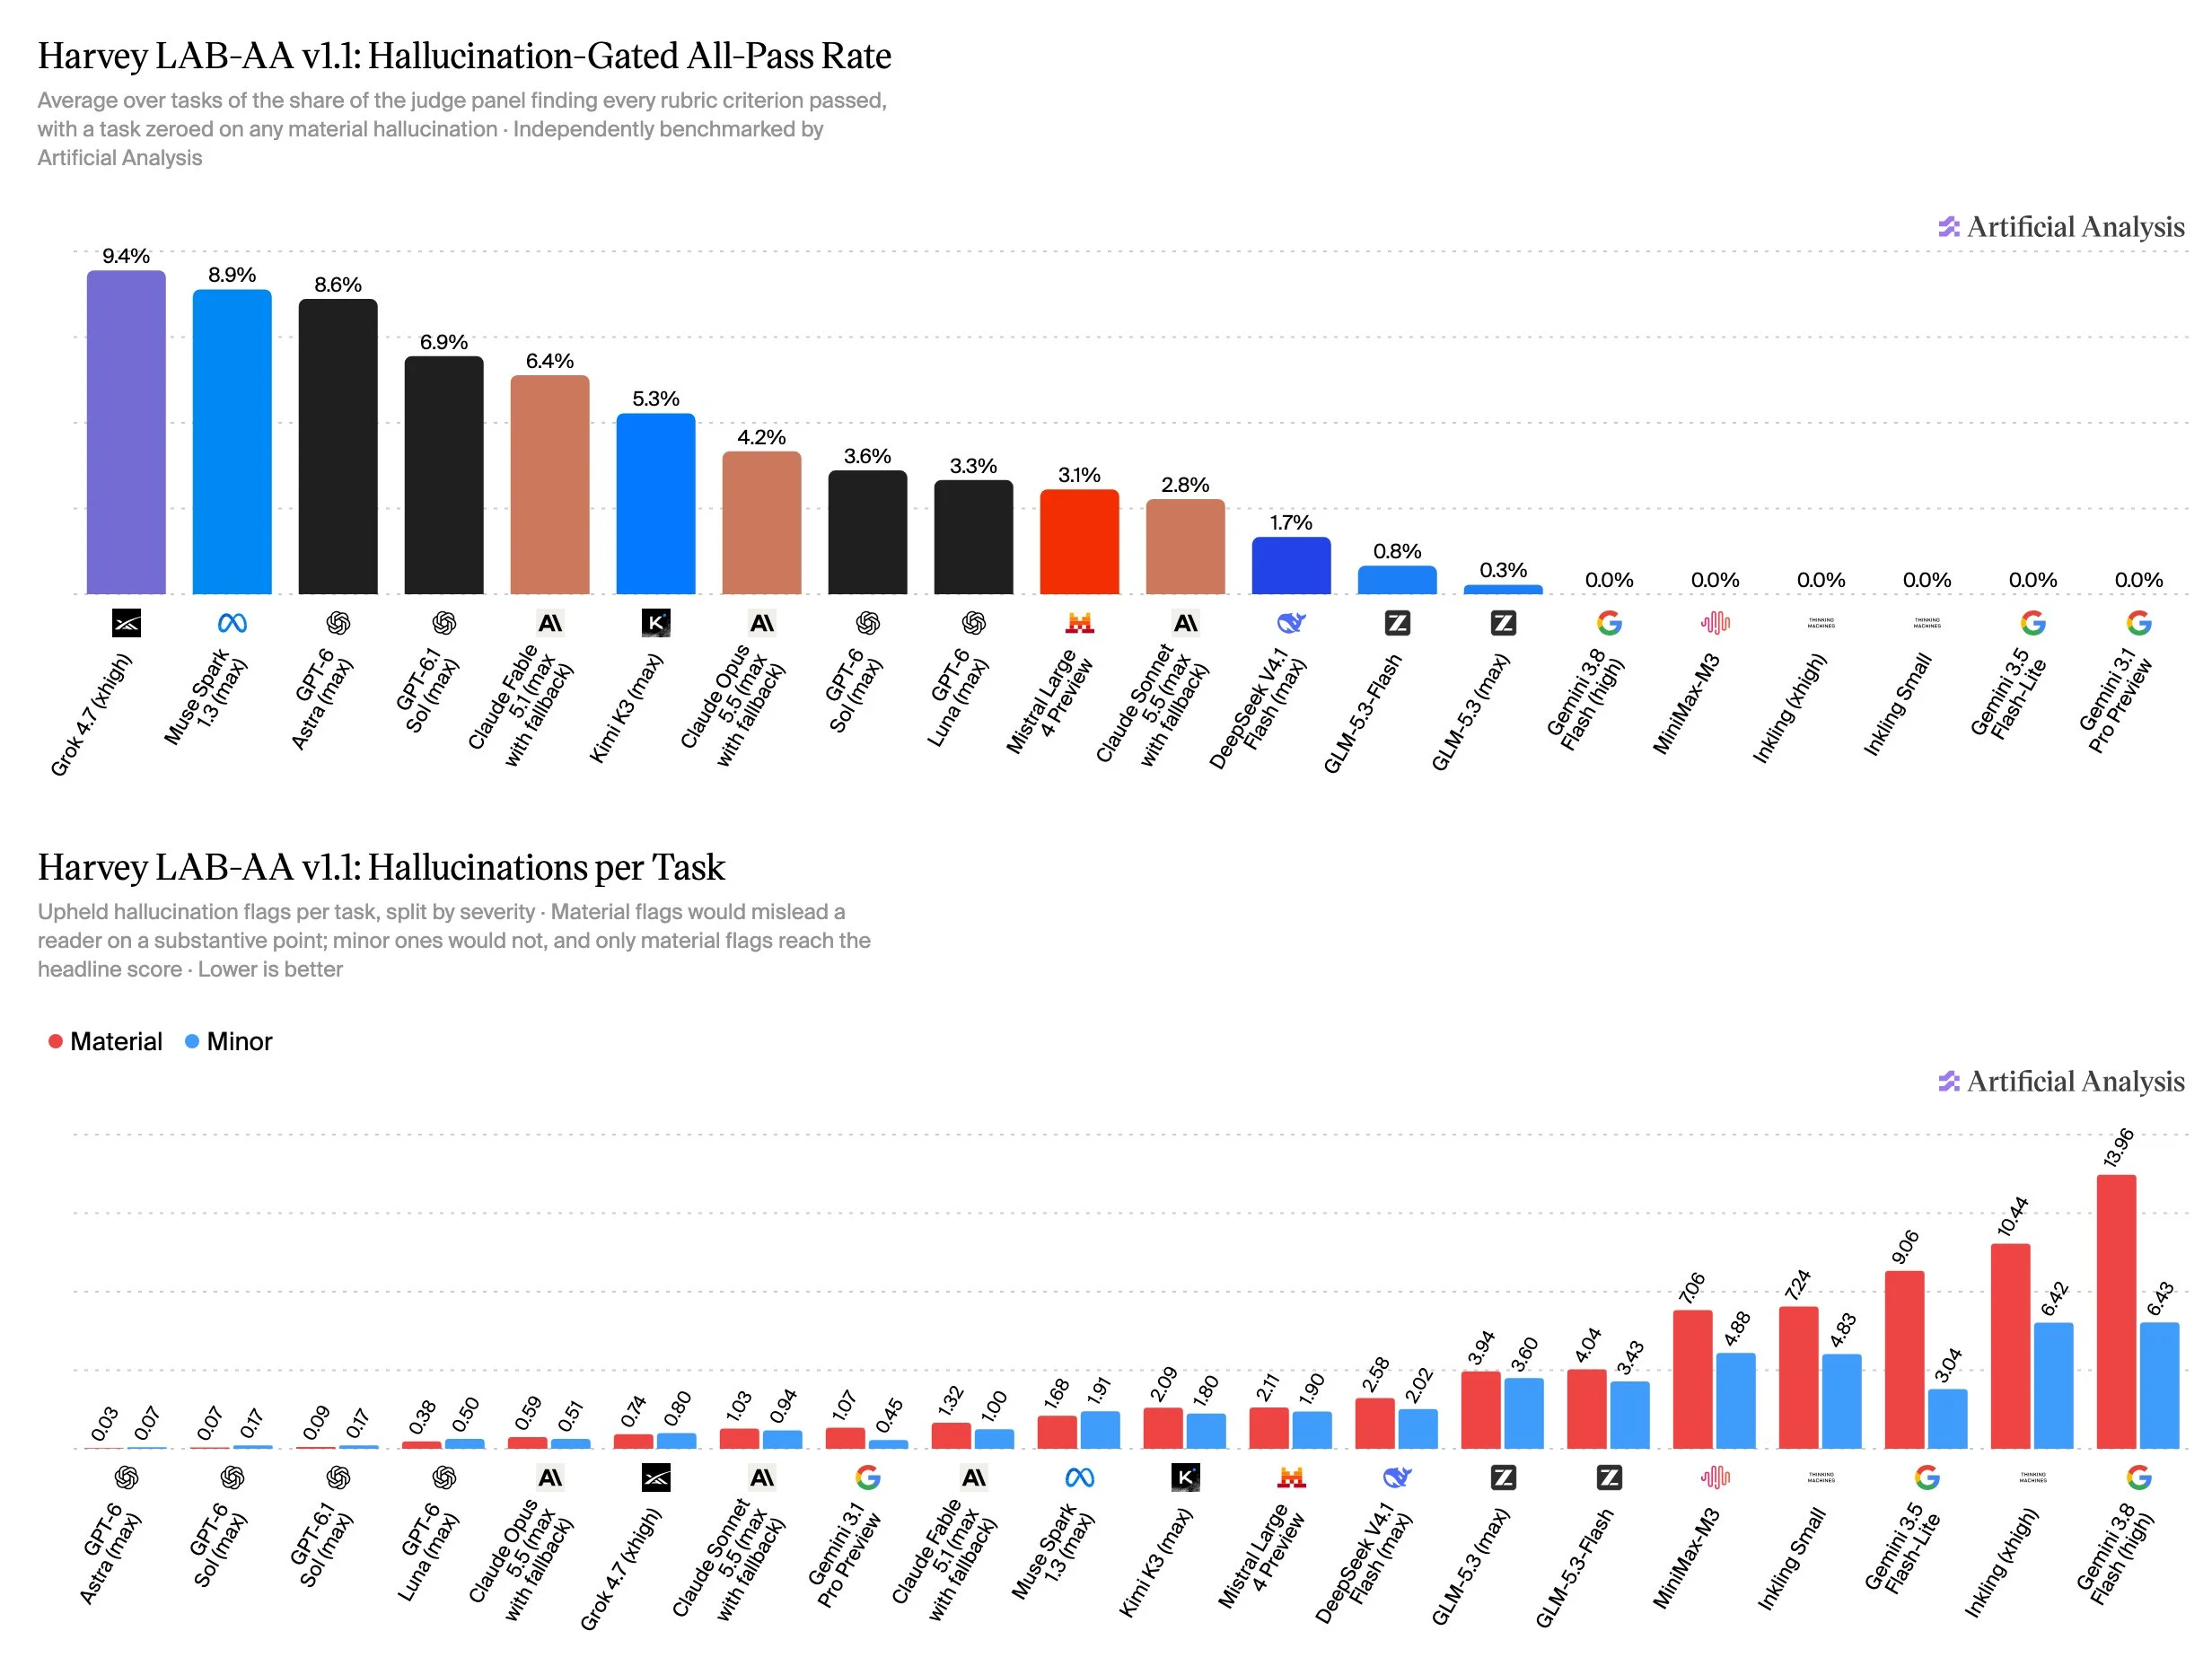
Heute veröffentlichen wir Harvey LAB-AA v1.1 in Zusammenarbeit mit Harvey. Diese Aktualisierung der Bewertungsmethode für den Legal Agent Benchmark (LAB) führt eine Überprüfung von Halluzinationen ein und verlangt korrekte Antworten, damit keine unangemessenen Aussagen enthalten sind. Die neue Hauptmetrik von LAB-AA v1.1, die Hallucination-Gated All-Pass Rate, belohnt eine Aufgabe nur dann, wenn die Ergebnisse alle Kriterien erfüllen und keine unangemessenen Aussagen enthalten.
Wir definieren eine Materialhalluzination als eine, die den Leser in einem wesentlichen Punkt täuscht, wie zum Beispiel eine falsche vertraglich vorgeschriebeneDatum. Eine geringfügige Halluzination hingegen ist ein echter Fehler, der unwahrscheinlich die rechtliche Interpretation einer Leistung bedeutend beeinflusst. Geringfügige Halluzinationen werden separat berichtet und haben keinen Einfluss auf die Hauptpunktzahl.
Grok 4.7 (xhigh) führt mit einer Halluzinationen-gesteuerten All-Pass-Rate von 9,4% und >60% der ansonsten erfolgreichen Ergebnisse der getesteten Modelle bei der Veröffentlichung enthalten eine materielle Halluzination.
Dies ist der erste Schritt zur Verbesserung der Methodik für Harvey LAB-AA. In zukünftigen Updates arbeiten wir mit Harvey zusammen, um die gesamte Reihe von Faktoren besser zu berücksichtigen, die die Anwälte schätzen, einschließlich Nutzungsmerkmalen wie Stil und Tonfall.
Wichtigste Punkte:
➤ Spitze der Rangliste: Grok 4.7 (xhigh) von @SpaceXAI führt mit einer Rate von 9,4% bei der Hallucination-Gated All-Pass Rate, knapp vor Muse Spark 1.3 (max) von @AIatMeta mit 8,9% und GPT-6 Astra (max) von @OpenAI mit 8,6%.
➤ Halluzinationen verändern die Rangliste: Ohne das Halluzinationstor würde Muse Spark 1.3 (max) mit einer 26,7-prozentigen allgemeinen Passrate deutlich an der Spitze stehen, doch zwei Drittel dieser Passungen enthalten eine oder mehrere materielle Halluzinationen, was zu einer durch Halluzination geschlossenen allgemeinen Passrate von 8,9% führt. GPT-6 Astra (max) behält fast alle seine Passungen nach dem Halluzinationstor (8,9% auf 8,6%) und rückt vom 10. auf den 3. Platz.
➤ Die GPT-6-Modellfamilie ist am besten entwickelt: GPT-6 Astra (max) erzielt im Durchschnitt 0,03 Materialhalluzinationen pro Aufgabe (4 bei insgesamt 120 Aufgaben), während GPT-6 Sol (max) im Durchschnitt 0,07 erzielt. Wenn sechs Checkermodelle an einem 20-Aufgabensubset verglichen werden, erzielte GPT-6 Astra unter allen Checkern null Materialhalluzinationen, einschließlich Claude Opus 5,5 (hoch). Im Vergleich erzielt Gemini 3,8 Flash (hoch) im Durchschnitt 13,96 Materialhalluzinationen pro Aufgabe.
➤ Die am besten bewerteten Modelle sind nicht die teuersten: Grok 4.7 (xhigh) belegt den ersten Platz auf der Rangliste mit einem Kostenaufwand von ~$9.50 pro Aufgabe, was knapp die Hälfte des Kostenaufwands von Claude Fable 5.1 (max mit Fallback) beträgt, der etwa $21.70 pro Aufgabe kostet – das teuerste Modell. Muse Spark 1.3 (max) zeigt für seinen Preis hervorragende Leistung und belegt den zweiten Platz mit ~$4.20 pro Aufgabe.
Vielen Dank an @nikogrupen und @ItsJulioPereyra von @harvey für ihre Arbeit am Harvey LAB und die Zusammenarbeit.