
Letzte Woche wollte ich eine kleine Version des Prompt-Rewriters haben, der mit Qwen-Image 2.1 ausgeliefert wird. Das offizielle Modell ist ein 9B-Modell, das etwa 20 GB Speicher benötigt und tausende Tokens nachdenkt, bevor es einen einzigen Absatz schreibt. Auf dem Hub fand ich nur komprimierte Kopien desselben 9B-Modells. Also beschrieb ich ML Intern, was ich wollte, und am nächsten Tag hatte ich eine 0.8B-Version , die auf einer CPU läuft. Sie liefert in 99.7% der Fälle gültige Ausgaben und verbraucht etwa ein Viertel der Tokens des Lehrermodells. Die Rechenleistung für das gesamte Projekt, einschließlich der Kennzeichnung von 8,797 Beispielanfragen durch das 9B-Modell, belief sich auf USD 16.
Im Laufe der nächsten Tage erstellte ich auf dieselbe Weise fünf weitere Modelle. Jedes begann als Nachricht in HuggingChat mit eingeschaltetem ML-intern und endete als öffentliches Modell auf dem Hub mit seiner Evaluierung in der Modellkarte. ML-intern plant die Arbeit, fragt mich nach einem Budget, bevor es etwas ausgibt, führt einen kleinen Test vor dem eigentlichen Auftrag durch, trainiert dann, evaluiert und veröffentlicht auf Hugging-Face-Hardware.
Wie ich ML Intern prompte
Die erste Nachricht ist der Ort, an dem ich meine Mühe investiere. Mein erster Prompt, für das unten geteilte citrus -Modell, war etwa 450 Wörter lang. Bei meinem 6. Projekt lag er näher an 2,000, weil jedes Projekt mir etwas beibrachte, das ich im nächsten wollte. Alle sieben Prompts liegen auf GitHub unter yvrjsharma/ml-intern-prompts, genau so, wie ich sie geschrieben habe.
Ein Prompt beginnt mit der Idee in einer Zeile und warum ich sie will. Dann benennt er die genauen Bestandteile: den Datensatz, das Basismodell, das Trainingsskript. Alles, was ich bereits überprüft habe, steht unter einer Überschrift, die wörtlich lautet "Verified facts, do not re-derive", damit der Agent sein Budget für die Arbeit ausgibt, statt neu zu entdecken, was ich bereits weiß. Für die Kamerawinkel-LoRA listete dieser Abschnitt auf, welcher Trainer gerade Unterstützung für transparente Bilder hinzugefügt hatte und welche offenen GitHub-Issues den Fallback-Trainer riskant machten.
Zwei Zeilen im Prompt sind entscheidend. Die erste verlangt eine Baseline vor jedem Training. Zum Beispiel sagt der citrus prompt : "Berichte außerdem den Zero-Shot-Score des Basismodells für dieselbe Metrik vor dem Training, damit wir den Zuwachs sehen können." Ohne sie erhält man ein trainiertes Modell und keine Ahnung, ob es besser ist als das, womit man begonnen hat. Die zweite ist ein Smoke-Test mit angehängter Prüfung. Bei den Bild-LoRAs bat ich um 50 Trainingsschritte und dann um eine Prüfung, ob sich die gespeicherten Gewichte tatsächlich geändert hatten, bevor ich für den vollen Lauf bezahlte.
Am Ende des Prompts lege ich die erwarteten Ergebnisse dar und begrenze die Kosten. Ich definiere, was in die Modellkarte gehört, und füge eine Anweisung wie diese ein: "Begrenze die Gesamtausgaben auf USD 12 und frage mich, bevor du sie überschreitest." Da ML-intern jede Aufgabe mit einem Budget von null Dollar beginnt und eine Erlaubnis braucht, bevor es kostenpflichtige Jobs ausführt, bleibt dieses Ausgabenlimit strikt durchgesetzt. Wenn man kein Budget angibt, schlägt der Agent je nach Projektgröße ein paar Wege vor und fragt, welchen man bevorzugt.
Du brauchst das nicht unbedingt alles beim ersten Versuch. Zum Beispiel hatte ich den verified-facts -Abschnitt in meiner citrus -Vorgabe nicht, und ML Intern erstellte dennoch ein Modell, das die Genauigkeit mehr als verdreifachte des Qwen3.5-2B Modells. Ich stelle Ihnen 6 Dinge vor, die ich mit Ml-Intern in nur ein paar Tagen gebaut habe.
1. Ein Modell, das Ihr Fachgebiet kennt
Ein allgemeines Vision-Modell kann ein vergilbtes Citrus-Blatt beschreiben. Ihnen aber zu sagen, ob es sich um einen Milbenbefall oder einen Magnesiummangel handelt, und welche biologischen und nicht-biologischen Maßnahmen zur Behandlung der Pflanze geeignet sind, ist sehr schwer. Mit Claude habe ich einen Trainingsdatensatz zusammengestellt, der aus drei Quellen der Project-AgML Organisation auf dem Hub zusammengeführt wurde. Der daraus resultierende citrus-disease-vlm-instruct Datensatz enthält 3,017 annotierte Bilder über 21 verschiedene Schädlinge, Krankheiten, Nährstoffdefizite und Behandlungsansätze. ML-intern übernahm das Fine-Tuning von Qwen3.5-2B mit diesen Beispielen und bewertete dabei zuvor das Basismodell als Benchmark.
Auf den 335 Testfotos nannte das Basismodell in 14.9% der Fälle das richtige Problem. Nach zwei Epochen auf einem A10G erreichte das fine-getunte Modell 52.8%. Rechenkosten: etwa USD 1.90.
Schauen Sie sich an: Modell · Datensatz · Citrus Doctor App
2. Ein Modell, das Ihre Figur zeichnet
Bildmodelle kennen jede Menge Charaktere. Huggy, gezeichnet im flachen Stil der Hugging Face Brand Assets, gehörte nicht dazu. Ich bat ML-Intern um ein LoRA auf FLUX.2 klein base 4B, trainiert auf 84 beschrifteten Zeichnungen aus dem Chunte/huggy_for_training Datensatz.
Der Agent speicherte alle 100 Schritte einen Checkpoint und zeichnete bei jedem denselben Satz Prompts, was die Auswahl leicht machte. Schritt 200 war der erste, bei dem Huggy vollständig on-modelwar. Ab Schritt 500 begann Huggys Stil in Prompts hineinzusickern, die nichts mit Huggy zu tun hatten! Das trainierte LoRA funktioniert auch auf dem destillierten klein-Modell bei 4 Schritten. Rechenkosten: etwa 7,60 USD.
Schauen Sie sich an: Modell · Datensatz · Huggy Generator App
3. Ein Modell, das einen neuen Trick beherrscht
- Camera-angle-LoRAs zählen zu den am häufigsten gelikten Community-Erweiterungen für frühere Qwen-Image-Modelle. Man kann dem Modell ein Bild eines Objekts geben und darum bitten, es aus 45 Grad von links zu sehen. Als ich einige Tage nach der Veröffentlichung des Qwen-Image 2.1 Modells nachsah, hatte noch niemand eines gebaut, also beauftragte ich ML-intern damit.
ML-intern renderte 1,030 gescannte Haushaltsobjekte aus Google Scanned Objects mit jeweils 24 Winkeln, 24,722 transparente Bilder, in einem CPU-Job, der wenige Cent kostete. Es finalisierte später 461 Objekte für das Training und 40 zurückerhalten für Tests sowie 1,844 Vorher-Nachher-Trainingspaare, gleichmäßig verteilt über 23 Kamera-Anweisungen.
Das Training lief 2,000 Schritte in etwa 90 Minuten auf einer A100 (~USD 3.75). Das gesamte Projekt dauerte etwa einen halben Tag und 48 Jobs, mitgerechnet diejenigen, die an fehlenden Paketen oder falschen Pfaden scheiterten und von ML-Intern neu eingereicht werden mussten. Gesamte Rechenkosten: etwa USD 16.
Schauen Sie sich an: Modell · Datensatz · Viewpoint Orbit App
- Doodle-in LoRA ist eine weitere coole Idee. Man lädt ein Foto mit einer magentafarbenen Kritzelei hoch und ergänzt einen kurzen Prompt, der ein Objekt benennt. Das LoRA ersetzt die Kritzelei durch dieses Objekt und hält dabei die ursprüngliche Beleuchtung und Komposition konsistent.
Dafür existierte kein Datensatz, also beschrieb mein Prompt, wie man einen erstellt. Von einem echten Foto aus Open Images ausgehen, ein Objekt mit dem LaMa-Inpainting-Modell entfernen und eine Kritzelei dorthin zeichnen, wo sich das Objekt befand. Das unveränderte Foto ist das Ziel. ML-intern schrieb und testete die Skripte zum Paar-Aufbau in einer CPU-Sandbox und führte sie dann als GPU-Jobs aus, wobei es Autor und Lizenz jedes Quellfotos festhielt. Es baute 6,042 Trainingspaare und einen 160-Paare-Testsatz, wobei 40 der Testpaare aus 23 Objektklassen stammen, die vollständig aus dem Training ferngehalten wurden.
Vor dem Training maß es das Basismodell allein und mit dem Viggle turbo LoRA und prüfte, dass das Ausführen von Edits in Batches identische Bilder lieferte, was die Evaluation billiger machte. Das Training lief 2,000 Schritte in 1 Stunde 38 Minuten auf einer A100 (~4 USD), und ein Vergleich der gespeicherten Checkpoints auf 48 Testpaaren wählte Schritt 500.
In Kombination mit dem Viggle turbo LoRA bei 6 Schritten schnitt das LoRA wirklich gut ab. 67.5% der Objekte dort erkannt, wo sie gezeichnet waren, bei 4,7 Sekunden pro Edit. Objekte aus den 23 ungesehenen Klassen landeten ebenso zuverlässig wie der Rest (65,0% gegenüber 64,2%). Das Projekt dauerte gut einen Tag und 59 Jobs. Rechenkosten gesamt: etwa 24 USD.
Schauen Sie sich an: Model · Dataset · Doodle-in App
4. Ein Modell, das auf dein Gerät passt
- Das Pocket Rewriter von oben in diesem Beitrag ist das erste. ML-intern begann damit, 8,797 kurze Bildanfragen mit einem kleinen Instruct-Modell über Inference Providers zu generieren, entsprechend einer Mischung, die in meinem Prompt festgelegt war: Fotos, Poster, Logos, Infografiken und mehr, etwa ein Drittel davon mit Anfrage nach exaktem Text in Anführungszeichen, und viele in anderen Sprachen als Englisch. Das 9B-Lehrermodell schrieb dann alle davon auf einer A100 in 2 Stunden 37 Minuten um (~USD 6.50). Nach der Qualitätsfilterung wurden 1,840 Beispiele für den Trainingsdatensatz ausgewählt.
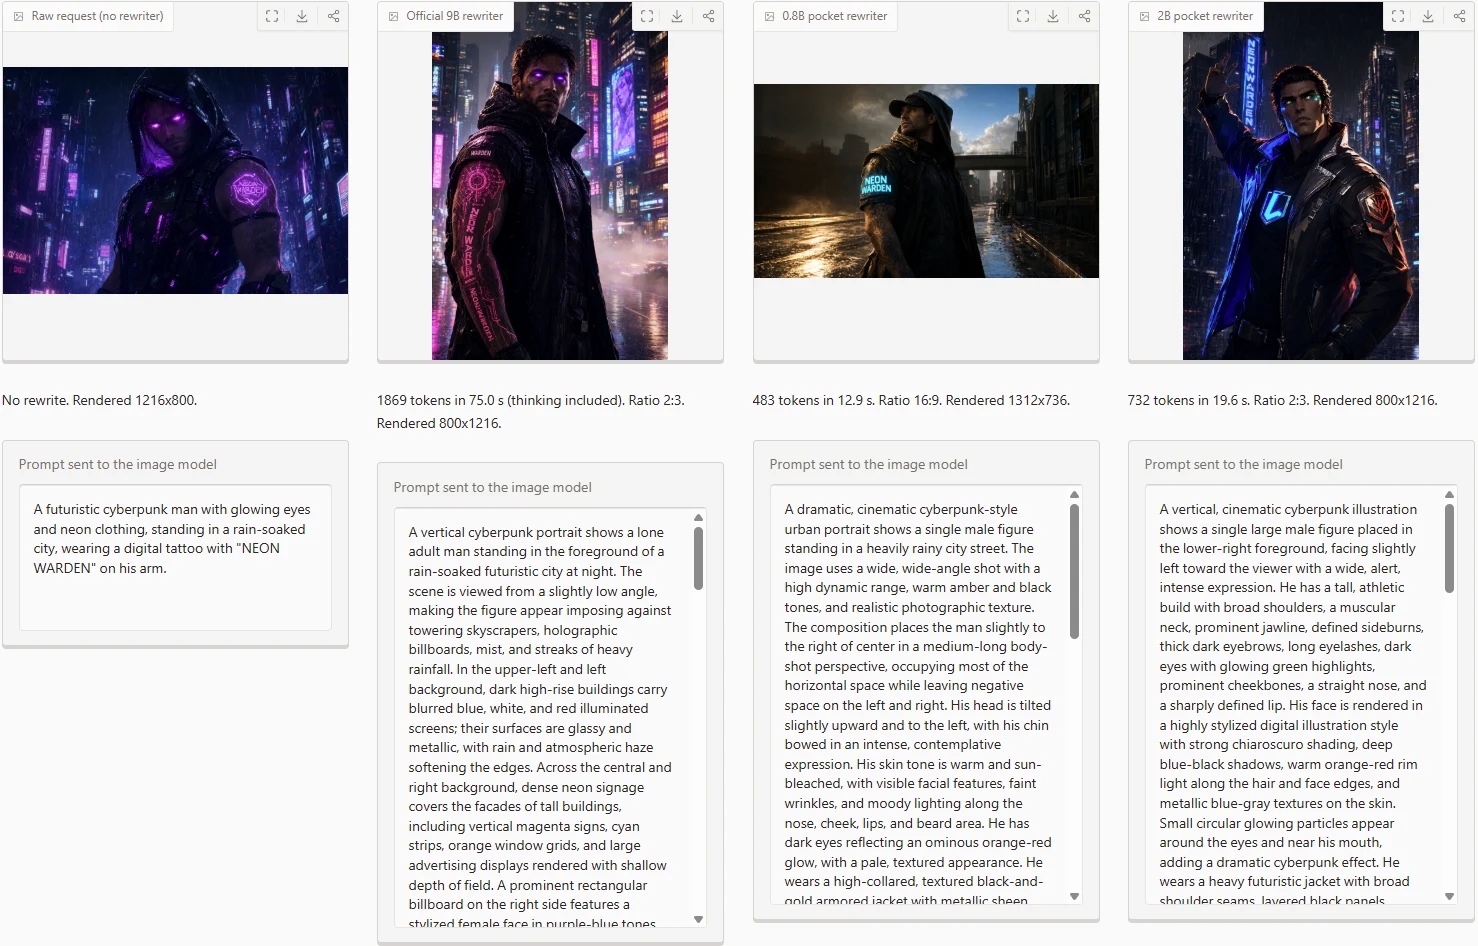
Das Training der 0.8B- und 2B-Schülermodelle dauerte 12 bzw. 18 Minuten auf einer A10G (USD 0.75 für beide). Das 0.8B-Modell wird außerdem als 812 MB große GGUF-Datei ausgeliefert, um auf einer CPU zu laufen. Das Projekt dauerte etwa 11 Stunden und umfasste 24 Jobs. Gesamte Rechenkosten: etwa USD 16.
Schauen Sie sich an: Pocket Rewriter 0.8B Student · 2B Student · Datensatz · Pocket Studio App · Vergleichen Sie den Teacher-Student im Rewriter Arena
- Agate-Preview-002-4step ist der zweite. Logolabs' Agate Preview 002 ist ein Text-zu-Bild-Modell mit 260M Parametern, klein genug für den Browser, aber es benötigt 50 Schritte mit Guidance, was 100 Netzwerkdurchläufe pro Bild bedeutet. Ich habe ML-Intern gebeten, es auf nur 4 Durchläufe zu destillieren!
Es dauerte zwei Durchläufe. Der erste speicherte 155,000 Trainingsbilder als Latents zwischen, backte die Guidance ins Modell ein und reduzierte dann die Schrittanzahl stufenweise von 16 auf 8 auf 4, alles auf A100s. Der 4-Schritte-Student schlug den Teacher-Lauf mit denselben 4 Schritten bei GenEval und FID; danach exportierte ML-Intern ihn für den Browser nach ONNX. Dieser Lauf dauerte etwa 13 Stunden und kostete 22 USD.
Ich machte einen zweiten Trainingslauf, indem ich ML-Intern bat, den 4-Schritte-Studenten noch etwas zu verbessern. Er erstellte dann 24,000 weitere Bildpaare mit dem Teacher bei 16 Schritten und fine-tunte den 4-Schritte-Studenten daran für etwa eine Stunde. GenEval stieg von 0.509 auf 0.536, gegenüber 0.563 des Teachers bei 50 Schritten, mit nur 4 Schritten (ein Viertel des Rechenaufwands). ML-Intern exportierte die Browser-Version neu. Der zweite Lauf dauerte etwa 8 Stunden. Die Gesamtrechenkosten über beide Läufe beliefen sich auf etwa 37 USD.
Schauen Sie sich an: Agate 4-Schritte-Modell · Datensatz · Führen Sie Agate in Ihrem Browser aus · Agate 4-step LIVE
Was es kostete
| Modell | Basismodell | Rechenleistung |
|---|---|---|
| Citrus Doctor | Qwen3.5-2B | 1,90 USD |
| Huggy LoRA | FLUX.2 klein base 4B | 7,60 USD |
| Pocket Rewriter (0.8B und 2B) | Qwen3.5-0.8B und 2B | 16,05 USD |
| Viewpoint Orbit LoRA | Qwen-Image 2.1 | USD 16 |
| Doodle-in LoRA | Qwen-Image 2.1 | USD 24.30 |
| Agate 4-step (zwei Durchläufe) | Agate Preview 002 | USD 37 |
| Gesamt | etwa USD 103 |
Dies sind die GPU- und CPU-Jobkosten, die für jede Sitzung gemeldet wurden.
Erstelle deins
ML-intern ist in HuggingChatverfügbar. Aktiviere den ML-intern-Modus und füge einen Prompt ein. Wenn du einen Ausgangspunkt möchtest, meine Beispiel-Prompts können frei kopiert werden. Starte mit einem Modell, das du dir wünschst, und einem Datensatz, den du hast oder den du beschreiben kannst. Gib ihm ein kleines Budget, bitte um einen Baseline-Test und einen Smoke-Test, und lies, was zurückkommt, bevor du das Limit erhöhst.
Wenn du damit etwas baust, teile es auf X und markiere @Gradio und @HuggingFace. Wir würden gerne die Modelle sehen, die du erstellst, an die niemand sonst denken würde, sie für dich zu bauen.