
Yunzhong, von QvFeisi aus
Quantum Bit | WeChat-Konto QbitAI
Schiebt man eine Barriere weg, wird der Durchgang verschlossen; bringt man eine Rampe heran, wird die hohe Mauer überwindbar.
Jede Handlung verändert die Welt, und die veränderte Welt wiederum bildet den Ausgangspunkt für die nächste Entscheidung des Agenten.
Wenn eine solche Welt durch Code konstruiert und von Diffusionsmodellen in Echtzeit gezeichnet werden kann, besitzt die KI eine „Erprobungsstätte“, die sie immer wieder erkunden kann: selbst handeln, die Folgen beobachten, Hypothesen überprüfen und die Erfahrungen in die nächste Runde mitnehmen.
Dies ist AgentGarten, das vom Team MirroS neu veröffentlicht wurde. Es verbindet eine ausführbare Code-Umgebung mit einem Echtzeit-Neural-Renderer: Der Code definiert die physikalischen Regeln, das Modell erzeugt die visuelle Rückmeldung – mit einem Durchsatz von über 30 fps können Agenten kontinuierlich mit der Welt interagieren.
Im klassischen Verstecken-Experiment traten Veränderungen schnell ein. Der Versteckende lernte in Runde 4, Barrieren zu verschieben und Deckungen zu bauen; der Suchende beherrschte in Runde 10 das Überklettern der Mauer mithilfe der Rampe. Nach einem fehlgeschlagenen Sprung schob der Suchende die Rampe sogar von selbst näher heran, passte die Position an und versuchte es erneut.
Die Triebfeder dieser Strategieentwicklung ist ein „Experimenthandbuch“, das die Agenten selbst verfassen.
Am Ende jeder Runde werten sie ihre Versuche aus, halten Entdeckungen fest und markieren offene Fragen; in der nächsten Runde erkunden sie weiter – nun mit diesen Erfahrungen im Gepäck.
Der Code lässt die Welt funktionieren, das Echtzeit-Rendering macht die Welt sichtbar, und das fortgesetzte Training lässt Erfahrungen sich ständig ansammeln.
AgentGarten verbindet diese drei Elemente zu einem Kreislauf und erforscht eine größere Frage:
Wenn Agenten eine Welt besitzen, in der sie handeln, Fehler machen und Erfahrungen sammeln können – wie wird sich Intelligenz darin kontinuierlich weiterentwickeln?
Vollständiger Blog: https://mirros.ai/blog/worlds-for-evolving-agents
Technischer Bericht: https://mirros.ai/report/agent-garten.pdf
Code: https://github.com/MirroS-Lab/AgentGarten
Projektseite: https://mirros-lab.github.io/agent-garten
Was den Agenten fehlt, ist eine Welt zum wiederholten Üben
Will man, dass die KI die physische Welt wirklich versteht, reicht es bei Weitem nicht aus, ihr nur riesige Mengen von Videos zu zeigen. So wie man Schwimmen nicht allein durch Ansehen von Videos lernen kann, müssen Agenten selbst „aufs Feld gehen“, also handeln, die tatsächlichen Ergebnisse beobachten und erst dann den nächsten Schritt entscheiden.
Dazu braucht es eine Umgebung mit physischer Kausaler Determiniertheit: Der verschobene Kasten muss an seinem Platz bleiben, der versperrte Durchgang muss unpassierbar sein, und alle nachfolgenden Handlungen müssen durch diese physischen Veränderungen fortwährend bestimmt werden.
Die beiden aktuellen dominierenden technologischen Wege haben jeweils ihre Grenzen:
Traditionelle Code-/Game-Engine-Umgebungenbieten präzise Zustände und transparente Regeln; jede physikalische Kollision ist eindeutig erkennbar.
Doch die Schwachstelle liegt im Bild: prozedural aufgebaute Szenen bestehen oft nur aus groben geometrischen Weißmodellen und sich wiederholenden Texturen. Damit Hunderte oder Tausende offener Szenen eine realistische Licht- und Materialanmutung erhalten, wäre ein astronomischer Aufwand an künstlerischer Modellierung und Engineering nötig.
Auf Videogenerierung basierende Weltmodelle(wie die verschiedenen großen Videomodelle) können zwar atemberaubende HD-Bilder erzeugen und auch nachfolgende Frames je nach Aktion generieren.
Das Problem ist jedoch, dass die physikalischen Informationen vollständig implizit im Gedächtnis des neuronalen Netzes verborgen liegen und kein abfragbarer, eingreifbarer, expliziter Zustand bereitgestellt wird. Ob man herausfinden will, wie viel Wasser noch in der Tasse ist, ob eine Roboterarm-Schraube festgezogen werden soll oder ob man strenge Schiedsrichterregeln für Aufgaben festlegen möchte – im reinen Video-Blackbox ist all dies kaum möglich.
Die Lösung von MirroS besteht darin:beide Komponenten ihre jeweiligen Aufgaben erledigen zu lassen – die Physik dem Code, Licht und Schatten dem neuronalen Modell.
Code treibt die Welt an, das Modell ist für das „Aussehen“ zuständig
In AgentGarten läuft eine standardisierte Interaktionsschleife folgendermaßen ab:
Der Agent gibt eine Aktionsanweisung; die Code-Umgebung berechnet sofort physikalische Kollisionen und Zustandsaktualisierungen und exportiert aus der Egoperspektive der Kamera des Agents eine leichte „geometrische Skizze“ (also räumliche Tiefe oder Oberflächennormalen);
Anschließend liest der neuronale Renderer diese geometrische Skizze ein, kombiniert sie mit dem bisherigen visuellen Gedächtnis und rendert in Sekundenschnelle eine realistische nächste Bildfolge, die dem Agent übergeben wird.
△ Abbildung 2|Geschlossener Kreislauf zwischen Code-Umgebung und neuronalem Renderer. Der Agent sendet eine Aktionsanweisung, die Code-Welt aktualisiert den Zustand und exportiert geometrische Bedingungen, der neuronale Renderer erzeugt in Echtzeit die nächste visuelle Beobachtung.
Diese Arbeitsteilung bringt zwei qualitative Sprünge mit sich:
Erstens sind die physikalischen Regeln immer „deterministisch und kontrollierbar“.
Szenenlayout, Kollisionserkennung und Spielausgang werden vollständig vom Code entschieden; es entsteht keinerlei „Halluzinationsphysik“.
Zweitens wird der Aufbau völlig neuer Welten extrem schnell.
Früher erforderte der Aufbau von 100 realistischen Simulationsumgebungen ein professionelles Art-Team für Modellierung, Texturierung und Beleuchtung – die Kosten waren kaum tragbar. In AgentGarten hingegen kann jeder minimalistische Codeszenario, solange er nur einfache Tiefen- und Normalenkonturen ausgibt, direkt diesen neuronalen Renderer verwenden und erhält im Handumdrehen fotorealistische Licht- und Schatteneffekte sowie Materialien. Wingsuit-Flug, Robotarm-Steuerung, Kochen in der Küche, Rennen mehrerer Fahrzeuge – alle teilen sich dieselbe visuelle Schnittstelle. Die Erweiterungskosten virtueller Umgebungen wurden damit zum ersten Mal von „kunstintensiver Handarbeit“ zu „programmatischer Code-Erweiterung“.
△ Abbildung 3 | Vielfältige physikalische Welten über verschiedene Aufgaben hinweg. Sie umfassen räumliche Navigation, Objektmanipulation, Kamerafahrten mit Neuaufnahme und Mehrfahrzeug-Interaktion. Links die simple White-Modell-Ausgabe aus dem Code, rechts die vom Renderer in Echtzeit erzeugten realistischen Visualisierungen.
Noch entscheidender ist, dass dieser Rendererstreamend generiert: Ein Aktionsschritt, ein Bildabschnitt – der Agent sieht das Ergebnis klar, bevor er die nächste Entscheidung trifft, und die Interaktion verläuft wirklich so fließend wie in der realen Welt.
Wiederkehr des Versteckspiel-Experiments: 25 Millionen Runden gegenüber 4 Runden
Die Welt steht – nun kommt es auf den Agenten an: Wenn er in einer solchen Welt wiederholt handelt und sein Vorgehen auswertet, kann er sich selbst stetig verbessern?
Ein klassischer Bezugspunkt ist das Versteckspiel-Experiment von OpenAI aus dem Jahr 2019: Verstecker und Sucher traten auf einem Spielfeld mit Barrieren und Rampen gegeneinander an und lernten durch umfangreiches Selbstspiel nacheinander, Deckungen zu bauen und über Rampen Mauern zu überklettern.
Das MirroS-Team hat dieses Experiment in AgentGarten nachgestellt, in einem Eins-gegen-eins-Setting: Der Verstecker richtet zunächst die Szene ein, dann ist der Sucher an der Reihe.
Die Kampfregeln sind klar und pur: Der Verstecker versperrt zuerst die Eingänge, danach betritt der Sucher das Feld. Die Agenten steuern Bewegung und Greifen über Python-Code, treffen ihre Entscheidungen allein anhand der generierten Bilder und kennen weder räumliche Koordinaten noch die Position des Gegners.
Beide starten mit einem völlig leeren Handbuch und pflegen jeweils eine Strategiebibliothek aus einzelnen Fertigkeiten. Pro Runde werden zehn Partien gespielt; danach folgt eine Auswertung, und in der nächsten Runde wird ein zufällig ausgewählter Teil der Fertigkeitsbibliothek angewandt.
Bald traten die klassischen Spielstrategien innerhalb weniger Runden nacheinander auf: Barrieren verschieben, um Türen zu blockieren; Rampen herantragen, um Brücken zu bauen; nach einem gescheiterten Kletterversuch die Rampe näher an die Wand ziehen und es erneut versuchen.
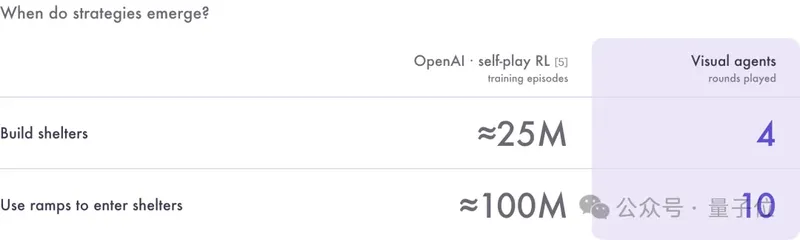
Die Studie von 2019 wurde durch das Auftreten dieser klassischen Verhaltensweisen berühmt und bietet einen anschaulichen Vergleich (siehe Abbildung 4): In jener Studie entwickelte die KI, gestützt auf bestärkendes Lernen von Grund auf, den Bau von Deckungen nach etwa 25 Millionen Partien; das Überklettern von Mauern über Rampen lernte sie nach etwa 100 Millionen Partien.
In AgentGarten hingegen blickt der Agent auf Ego-Perspektiv-Bilder und überarbeitet zwischen den Runden sein Text-Handbuch: Der Verstecker lernte den Bau einer Deckung in Runde 4, der Sucher das Überklettern über Rampen in Runde 10.
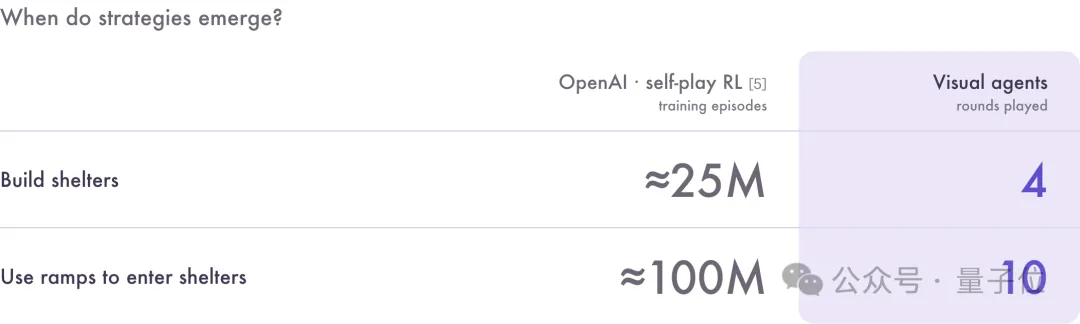
△ Abbildung 4 | Vergleich des Umfangs der gespielten Partien vor dem Auftreten repräsentativer Strategien. Selbstspiel-RL trainierte von Grund auf über zig bis hunderte Millionen Partien auf privilegierten physikalischen Zuständen; die MirroS-Agenten handelten anhand von Ego-Perspektiv-Renderings und beherrschten die jeweiligen Strategien durch Runde-für-Runde-Reflexion ihrer Handbücher innerhalb weniger Runden.
Lernend mitschreiben: Erfahrung verschriftlichen
Der schnelle Fortschritt im Versteckspiel beruht auf einem universellen Übungsablauf.
Der Ansatz von MirroS besteht darin,den Agenten selbst „Notizen schreiben zu lassen“. Alles, was er lernt, wird in Handbücher eingetragen.
Die Übungen sind in vier strenge, aufeinander aufbauende Phasen gegliedert:
- Aufgabe annehmen: Der Agent erhält eine Aufgabendatei mit klaren Handlungszielen und Regelgrenzen, aber ohne jegliche Musterlösung.
- Blindbox-Ausprobieren: Autonomes Handeln unter strengen Schritte- und Zeitlimits. Nur Kamerabilder – keine Gott-Koordinaten, keine Minimap, und vor Spielende ist auch der Punktestand nicht sichtbar.
- Handbuch schreiben: Nach jeder Runde folgt eine ehrliche Selbstreflexion: Was wurde versucht, welche Phänomene wurden beobachtet, welche Urteile sind fragwürdig, welche neuen Hypothesen sollten beim nächsten Mal überprüft werden.
- Archivieren und Weitergeben: Das Handbuch wird eingefroren und archiviert und direkt als ererbtes Vorwissen an den Agenten der nächsten Runde übergeben.
Blättert man durch diese von den Agenten verfassten Handbücher, stellt man fest, dass sie stark wissenschaftlich-erkundenden Charakter tragen. Das Modell unterscheidet strikt zwischen „beobachteten Fakten“ und „ergeannten Vermutungen“ und hinterlässt den Nachfolgern sogar eigens Leitfäden, um Fallen zu vermeiden:
- Der Verstecker hat eine praktische Wahrheit formuliert: „Der Kern der Verteidigung liegt darin, Durchgänge zu blockieren, und nicht lediglich die Sichtlinie zu verdecken“; er mahnt die Nachfolger, tote Winkel zu nutzen, um Lücken zu verringern, und mit kleinen Bewegungen die Blockierwirkung zu testen;
- Der Sucher hat ein Kontrollprinzip erarbeitet: „Ziehe vor dem Transport eines Gegenstands zuerst einmal testweise daran und verwechsele nicht Feststecken mit festem Griff“; nach dem Herantreten drückt er zuerst kurz die Mikroziehtaste und prüft, ob sich das Objekt relativ zu Raummarken bewegt, um so zu testen, ob es wirklich gegriffen wurde;
- Die Warnung eines Brückenfahrers ist besonders zum Nachdenken anregend: „Dass die Zielscheibe in den toten Winkel der Fahrzeugfront rutscht, bedeutet nicht, dass das Fahrzeug bereits sicher angekommen ist”。
Bewährte Erfahrungen, die die Prüfung bestanden, werden von Nachfolgern übernommen; gescheiterte Lektionen veranlassen sie, neue strategische Zweige auszuprobieren.
Dieselbe Schleife, noch einmal in vier Welten durchlaufen
Hide-and-seek ist nur ein Anfang. Da die Code-Welt im Wesentlichen eine programmierbare Software-Umgebung ist, lässt sich dieselbe Schleife aus „Erkunden–Nachbereiten–Festhalten“ mühelos auf viele weitere komplexe Szenarien übertragen.
Das Team führte in vier weiteren völlig unterschiedlichen Welten jeweils vier Runden Übungen durch:
- Welpen begleiten: Der Agent muss innerhalb von 60 Sekunden durch Streicheln mit ausgestreckter Hand und rechtzeitiges Ballspielen die Zuneigung des Welpen aufrechterhalten. Die Punktzahl stieg von 13 in der ersten Runde auf 19 in der 4. Runde.
- Begegnung auf schmaler Brücke: Zwei Fahrzeuge verhandeln auf Grundlage der Egoperspektive des Fahrens gegenseitiges Ausweichen und tauschen auf einer schmalen Einspurstrecke in möglichst kurzer Zeit die Enden. Die Gesamtzeit für das bestandene Manöver beider Fahrzeuge wurde von 71 Sekunden drastisch auf 41 Sekunden reduziert.
- Kooperative Schäferei: Zwei Schäferhunde arbeiten allein auf Grundlage ihrer eigenen Sichtwartung treu zusammen, treiben vier Schafe in den Pferch und halten dies 5 Sekunden lang. Von einer Zeitüberschreitung in Runde 1 mit nur drei eingepferchten Schafen bis zur stabilen Verwirklichung von „kein einziges verpasst“ – alle wurden in den letzten drei Runden eingepfercht.
- Steinbruchlader: Der schwere Lader muss Steine schieben, Material zuführen und einlagern. In Runde 1 schaffte er nur mühsam, die Steine wegzuschieben; bis Runde 4 konnte er den gesamten Ablauf innerhalb des 360-Sekunden-Zeitlimits sauber und 31 Sekunden vor Ablauf durchlaufen.
Diese äußerst unterschiedlichen Aufgaben zeigen alle dasselbe: Dieser geschlossene Kreislauf der Erfahrungsspeicherung funktioniert genauso in völlig anderen Welten.
Wie die Bilder den Aktionen folgen: Wie 30 fps auf einer einzelnen Karte erreicht werden
Damit ein Agent in der virtuellen Welt „handelnd while schauen“ kann, muss der neuronale Renderer drei Berge überwinden, die generative Videos seit langem plagen:plötzlichen Aktionen folgen können, sehr lange Interaktionen stabil halten und zugleich schnell genug laufen。
Das MirroS-Team startete vom grundlegenden omnimodalen Modell aus und schlug die TrainingsmethodeAdversarial Forcingvor, kombiniert mit Inferenzoptimierung, und öffnete damit diesen visuellen Kanal:
1. Von der kompletten Offline-Generierung zum streamierenden, blockweisen Rendering
Bisherige Videomodelle gewöhnten sich daran, ein komplettes Video auf einmal zu generieren; AgentGarten hat dies in eine streamierende, blockweise Generierung umgebaut. Führt der Agent eine Aktion aus, erzeugt das Modell sofort den entsprechenden kurzen Bildblock, sieht das Ergebnis klar und trifft dann die nächste Entscheidung.
2. Kein Drift bei langfristiger Interaktion (exakte Wiederholung)
Je länger die kontinuierliche Generierung dauert, desto leichter summieren sich kleine Fehler zu einem Erscheinungsbild-Drift. Viele Modelle trennen zur Speichereinsparung den historischen Berechnungsgraphen, sodass Gradienten nicht zu den historischen Speichern zurückfließen können; berechnet man beim zweiten Durchlauf die gesamte Sequenz einheitlich neu, führen winzige Unterschiede in der zugrunde liegenden Ausführungsreihenfolge zu Fehlern von mehreren Prozentpunkten.
Das Team entwarf einen Mechanismus zur exakten Wiederholung: Beim ersten Durchlauf gradientenfreies Forward-Unfolding, beim zweiten Durchlauf erneute Ausführung mit Gradienten in exakt gleichem blockweisem Takt, wodurch die Inferenz-Trajektorie exakt reproduziert und die zeitliche Konsistenz bei Interaktionen mit langen Sequenzen stabilisiert wurde.
3. Einführung echter Videos als Gegenspieler: Vermeidung von Bildverschlechterung und Artefakten
Verlässt man sich nur auf vom Modell selbst erzeugte Samples für Score-Distillation, verzerren lange Inferenzzeiten leicht und es entstehen gitterförmige Artefakte.
Das Team führte im Training einen Diskriminator mit echten Videos ein, um ein adversariales Signal aufzubauen; mit der realen physikalischen Bildqualität als Anker werden sowohl die Bildtextur eingeschränkt als auch die Generierungsergebnisse streng an die vom Code vorgegebenen geometrischen Konturen angepasst.
4. Aufrechterhaltung der Echtzeit-Interaktion mit 30+ fps
Das Team schrieb maßgeschneiderte Triton-Fused-Operatoren von Hand, beseitigte Speicher-Hin-und-Her-Transfers und vermied die mehrminütigen Kaltstart-Wartezeiten herkömmlicher Full-Graph-Kompilierung; zusammen mit CUDA Graph zur Beseitigung von CPU-Scheduling-Overhead und einem superleichten Decoder mit einer Latenz von unter 10 Millisekunden stabilisierte sich der Durchsatz schließlich bei 480p Auflösung und über 30 fps und trägt die closed-loop-Interaktion stabil.
Für kontinuierlich evolvierende Agenten: Welten, die erlebt werden können
Ausführbarer Code ermöglicht es, die Trainingswelten unendlich programmatisch zu generieren; der gelernte Renderer verleiht diesen Welten wahrnehmbares, realistisches physikalisches Feedback; das gesammelte Experimentierhandbuch macht jede Erkundung zur Stufe für die nächste Erkundungsrunde.
In Kombination dieser drei Elemente besitzt der Agent einen Raum, in dem er wirklich erkunden, Fehler machen und evolvieren kann.
Dies ist genau die Kernidee von MirroS‘ Erforschung von Physical RSI (rekursive Selbstverbesserung in der physischen Welt).
Das Scaling von Sprachmodellen läuft auf Hochtouren, während das Scaling von Intelligenz in der physischen Welt gerade erst beginnt.
Eine wirklich allgemeine verkörperte Intelligenz erfordert ein kontinuierliches Wachstum im echten Wechselspiel mit der physischen Welt:
Möge jedes Unbekannte zum Ausgangspunkt der nächsten Evolutionsrunde werden.
Vollständiger Blog: https://mirros.ai/blog/worlds-for-evolving-agents
*Dieser Artikel wurde mit Genehmigung von QbitAI veröffentlicht; die Ansichten gehören ausschließlich den ursprünglichen Autoren.