
IT之家 Bericht vom 9. Oktober: JetBrains veröffentlichte gestern (8. Oktober) einen Blogpost, in dem das Mellum2.1-Modell eingeführt wird, um die Programmierfähigkeiten von KI-Agenten zu verbessern. Das Modell setzt die 12B-Hybrid-Experten-Struktur von Mellum2 fort, verfügt über 2,5B aktive Parameter und wird weiterhin unter der Apache 2.0-Lizenz veröffentlicht.
Mellum2.1 führt die Hauptupgrades in der nach dem Vorlernen stattfindenden Verstärkungslernphase durch. Es erweitert die kurzfristigen Abschlussschritte auf den eigentlichen Lernprozess und fügt Trainingsdaten hinzu für Aufgaben wie Mathematik, Algorithmuswettbewerbe, Wissenschaft, Toolnutzung und Softwareentwicklung.
JetBrains hat eine interne Reinforcement-Learning-Umgebung für das Modell aufgebaut, bei der während des Trainings Millionen von Sandboxes aktiviert werden, die Tausende von Umgebungen abdecken. Darüber hinaus haben das Team vor dem Training offene Datensätze ausgewählt und solche mit Testfehlern, nicht verifizierbaren Antworten und unangemessenem Schwierigkeitsgrad entfernt.
Nach der Aktualisierung kann Mellum 2.1 das Code-Paket erkunden, Dateien bearbeiten und seine eigenen Änderungen überprüfen. JetBrains behauptet, dass die größten Verbesserungen im Bereich der Agenten-Programmierung liegen – das Modell kann die Ursache von Fehltests erkennen, eine Korrektionslösung erstellen und die Ergebnisse validieren.
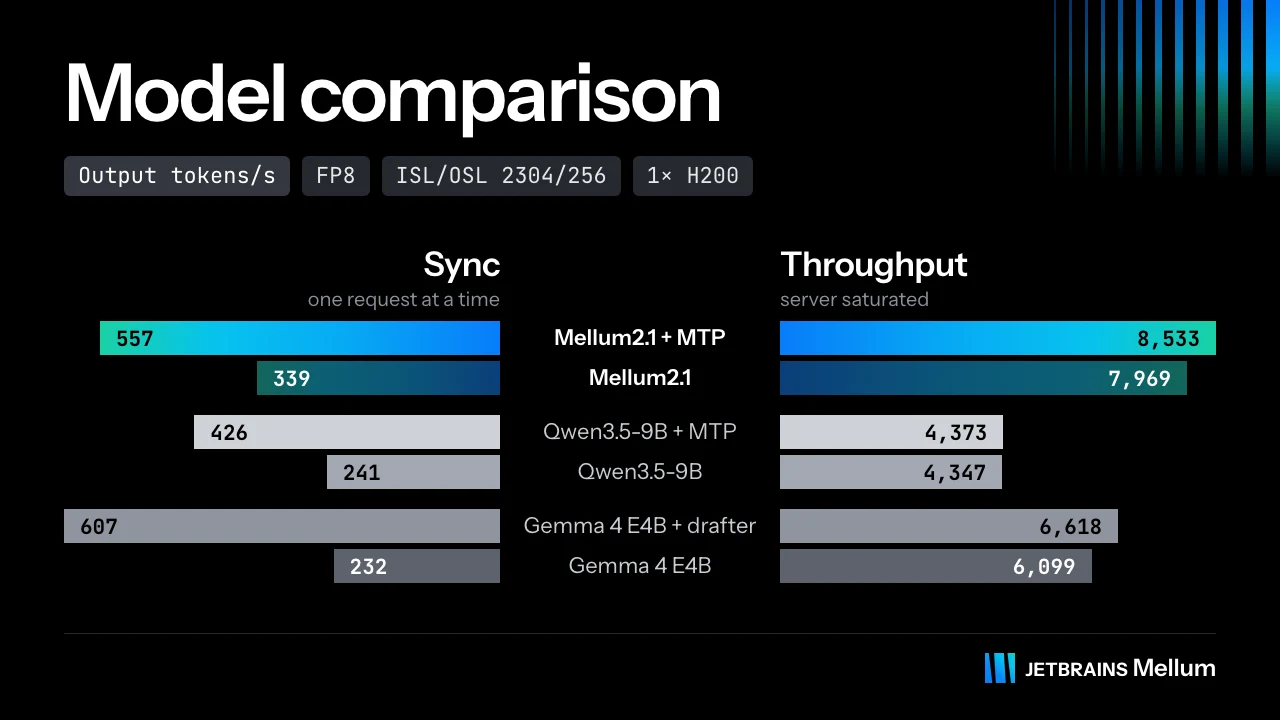
In Bezug auf die Leistung ist die Mellum2.1-Architektur identisch mit der Mellum2-Architektur, wobei die Geschwindigkeit unverändert bleibt. Die Multi-Token-Prediction (MTP) verbessert die Reaktionsgeschwindigkeit weiterhin. Im Fall einer einzigen Anfrage erhöht MTP ihre Geschwindigkeit um etwa 1,6 Mal.
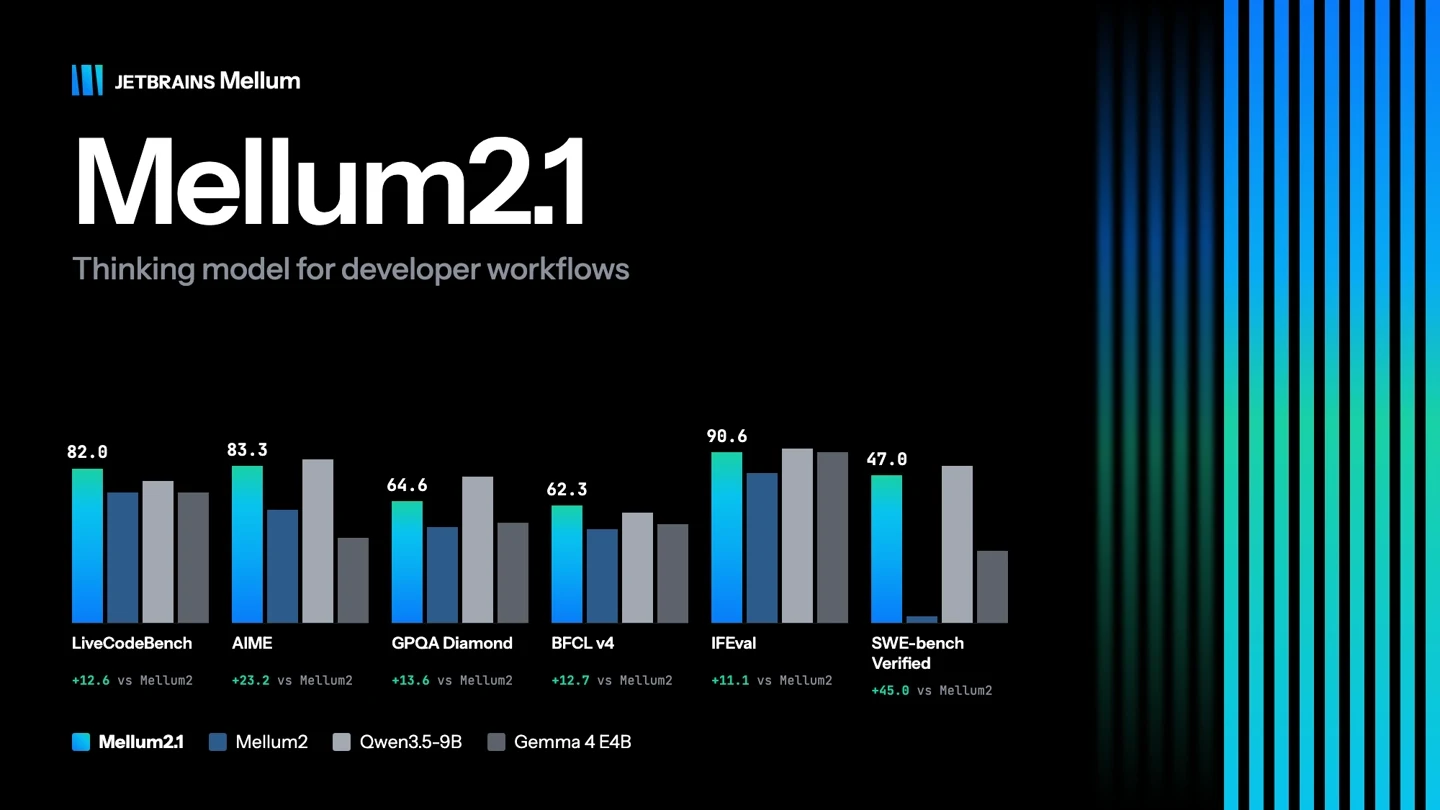
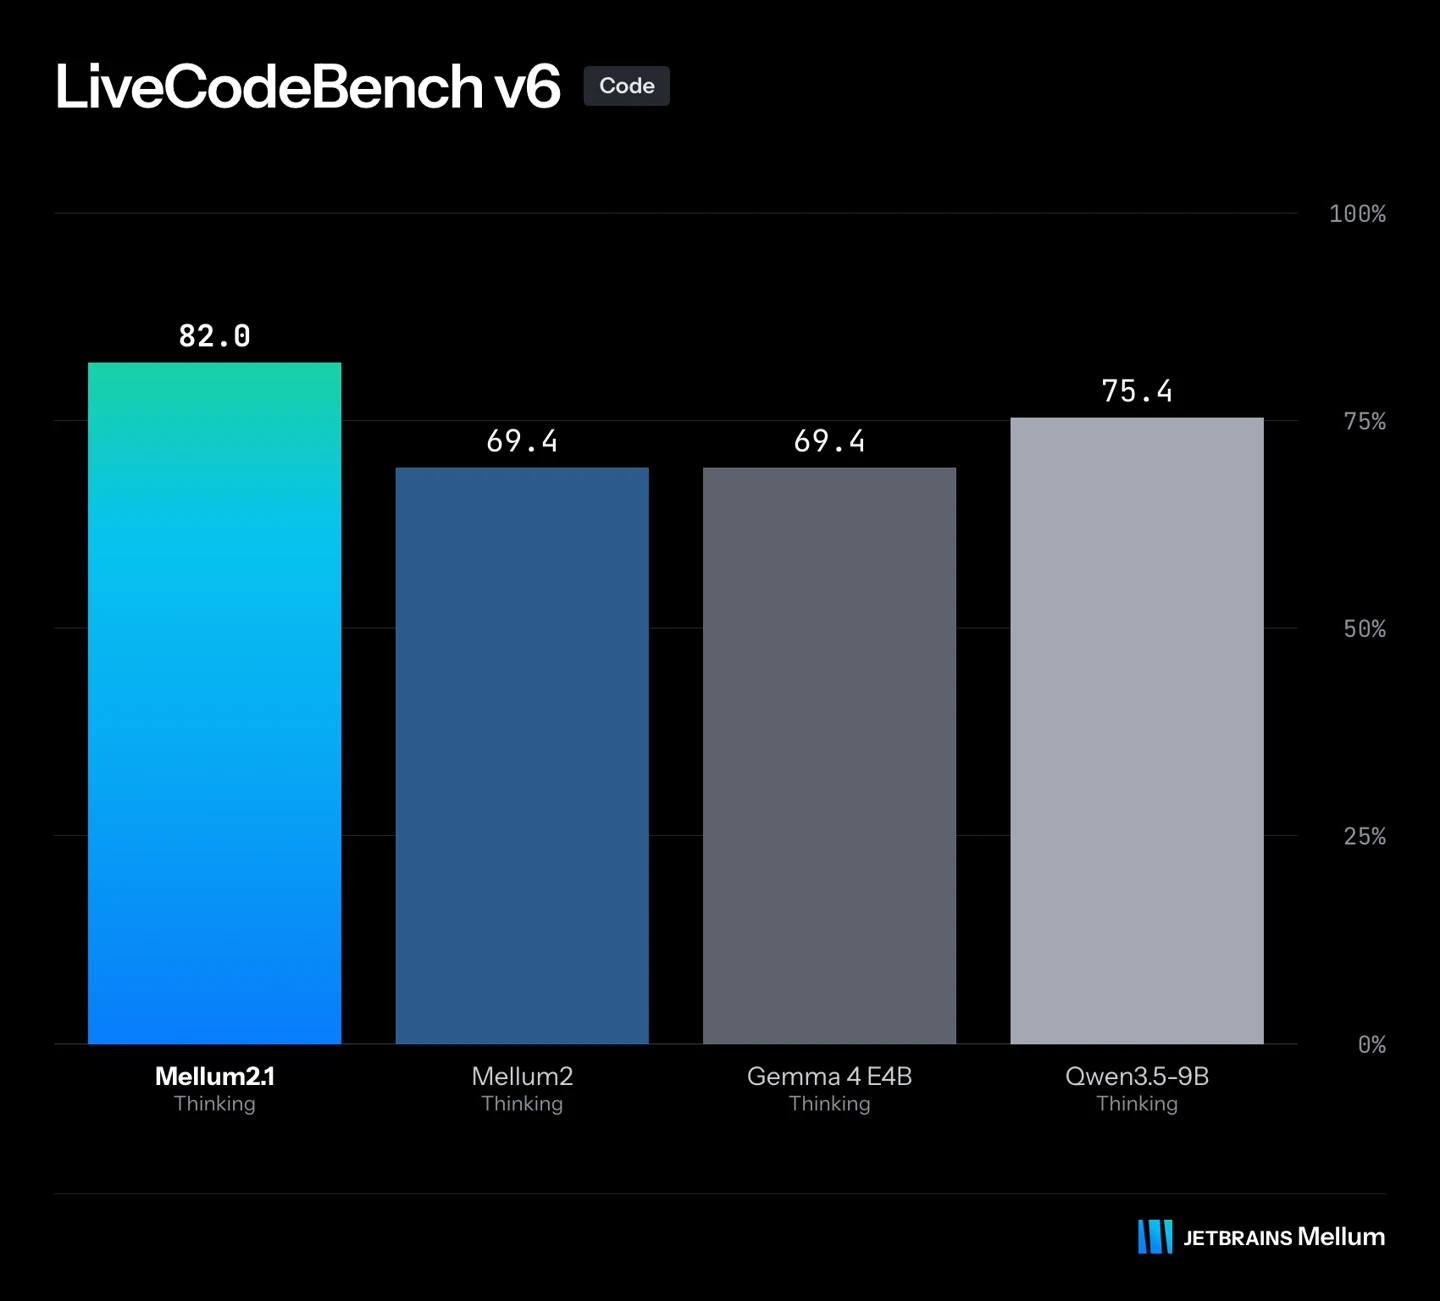
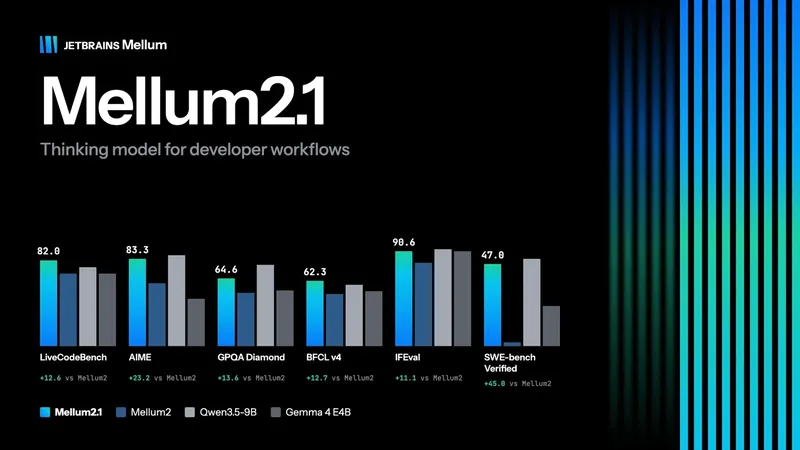
JetBrains vergleicht Mellum2.1 mit Mellum2, Qwen3.5-9B und Gemma 4 E4B unter denselben Bewertungsbedingungen. Die Ergebnisse zeigen, dass bei hohem Lastbedarf die Rechenleistung von Mellum2.1 in Bezug auf die Anzahl der Token fast das Doppelte von Qwen3.5-9B beträgt, und dies ist auch in Bereichen wie Programmierung, Algorithmuswettbewerbe, Mathematik, Toolaufrufe und allgemeines Wissen verbessert. IT Home hat folgende Screenshots veröffentlicht:
Mellum2.1 ist jetzt auf Hugging Face verfügbar und unterstützt die Installation auf lokaler oder eigenen Infrastruktur, sodass Unternehmen den Code und die Daten in ihrem eigenen Umfeld aufbewahren können. In Zukunft werden auch Versionen in GGUF für llama.cpp, Ollama und LM Studio sowie der MTP-Prädiktionsdekodierungskomponente von vLLM veröffentlicht.