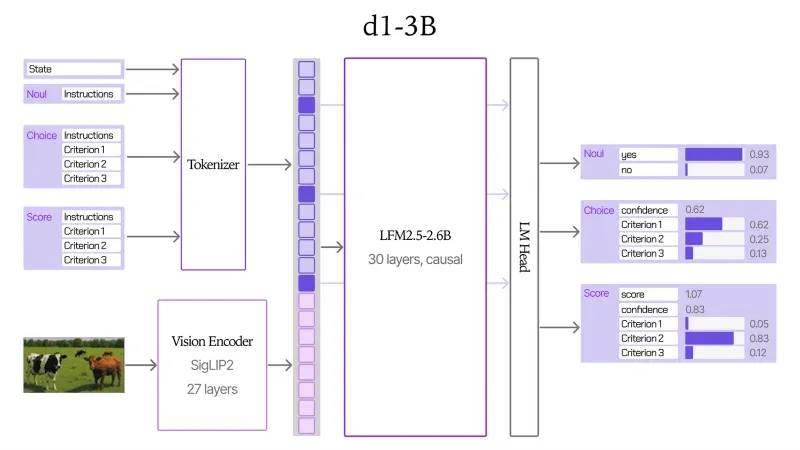
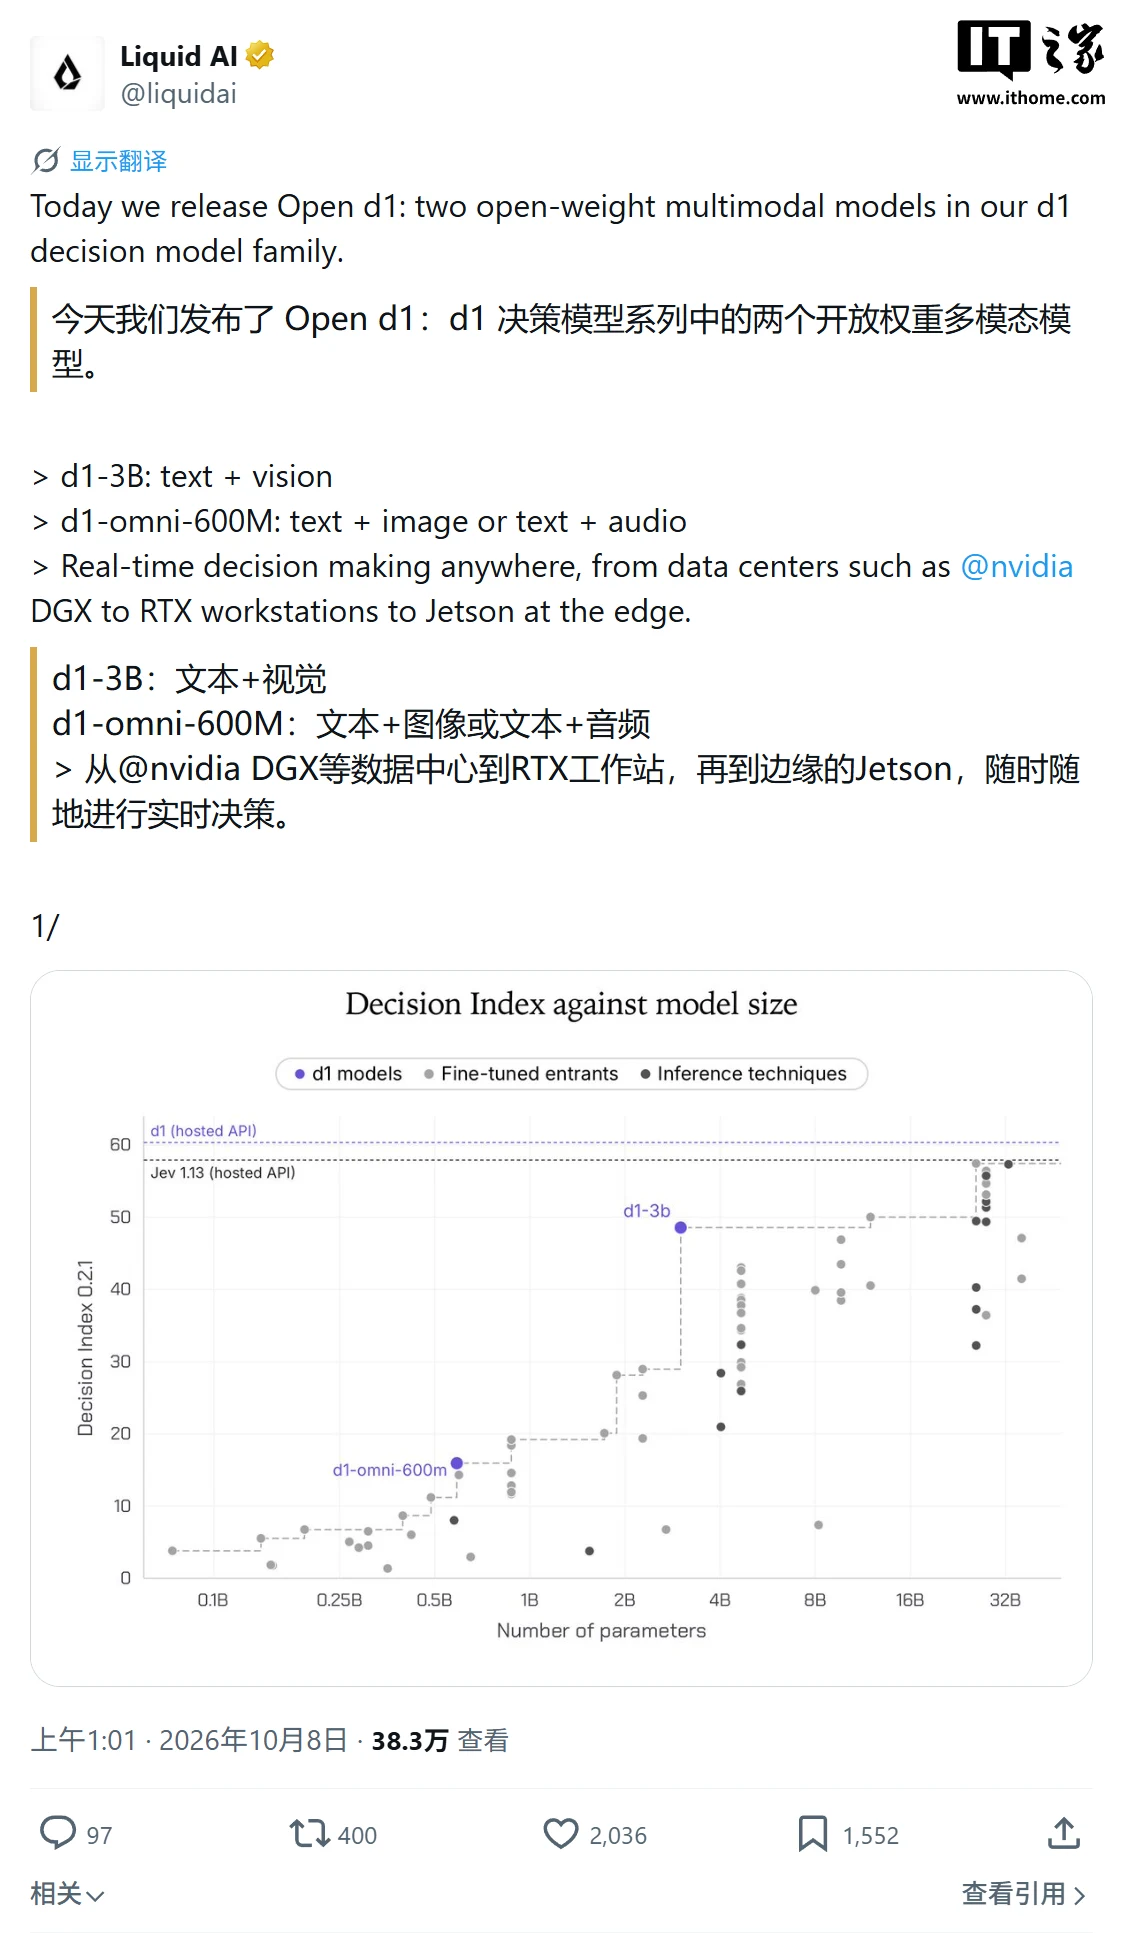
IT之家 Meldung vom 9. Oktober: Liquid AI hat am 7. Oktober einen Blogbeitrag veröffentlicht und darin zwei Open-Weight-Entscheidungsmodelle der d1-Serie vorgestellt: d1-3B unterstützt Text- und Bildbewertungen mit 3,12 Milliarden Parametern,d1-omni-600M unterstützt mit 587 Millionen Parametern Text-, Bild- und Spracheingaben.
IT之家 zitiert aus dem Blogbeitrag:Nachdem das Jev-Modell im September veröffentlicht wurde und viral ging,,haben auch Unternehmen wie OpenAI ähnliche Entscheidungsmodelle vorgestelltund Liquid AI ist ein neuer Teilnehmer in diesem Wettbewerb. Die nun vorgestellten Modelle d1-3B und d1-omni-600M sind auf Hugging Face öffentlich zugänglich, Nutzer können sie herunterladen, feinjustieren und einsetzen.
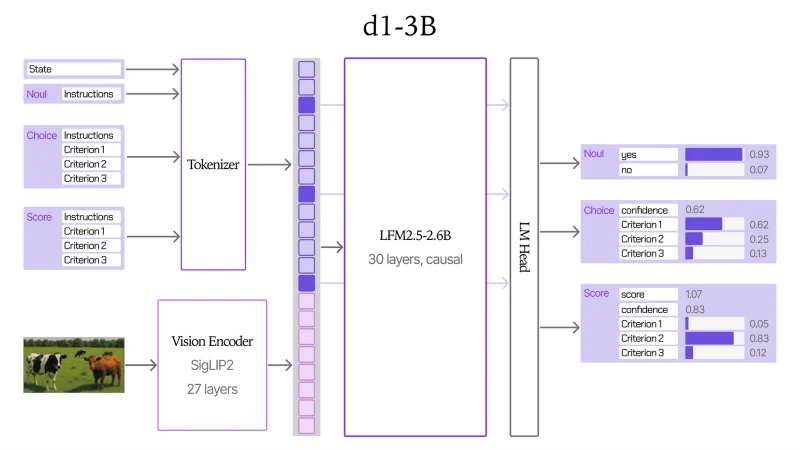
d1-3B verfügt über 3,12 Milliarden Parameter und wurde auf Basis des Vision-Language-Modells LFM2.5-VL-3B trainiert; es unterstützt Text- und Bildeingaben. Das Modell erreichte im öffentlichen Testdatensatz Decision Index v0.2.1 48,57 Punkte; laut Liquid AI liegt es damit vor allen Modellen unter 10B.
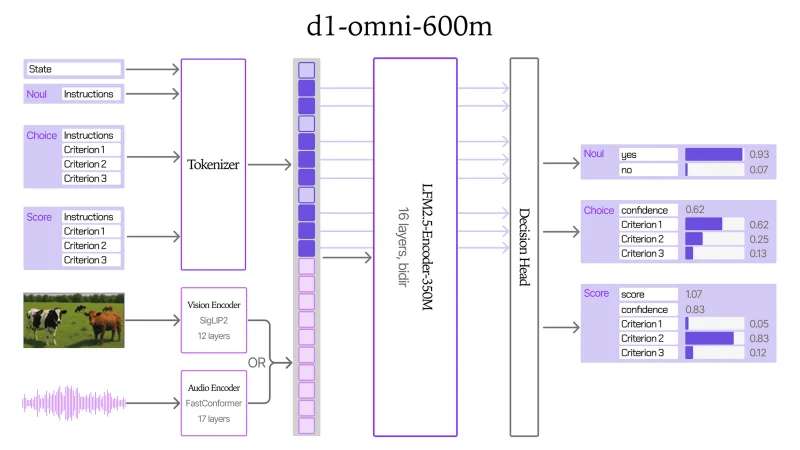
d1-omni-600M besitzt 587 Millionen Parameter und basiert auf dem trainierten bidirektionalen Encoder LFM2.5-Encoder-350M. Das Modell unterstützt die Kombination von Text mit Bild oder Text mit Spracheingabe und ist der erste experimentelle multimodale Entscheidungsmodell-Checkpoint von Liquid AI.
Zur Inferenzgeschwindigkeit: d1-3B benötigt auf einer NVIDIA RTX 4090 für die Beantwortung einer einzelnen Frage 8 Millisekunden, die Verarbeitung eines 384-Pixel-Bildes dauert 102 Millisekunden. Auf dem Jetson AGX Thor dauert eine einzelne Frage 16 Millisekunden; auf dem Jetson Orin Nano sind es 50 Millisekunden.
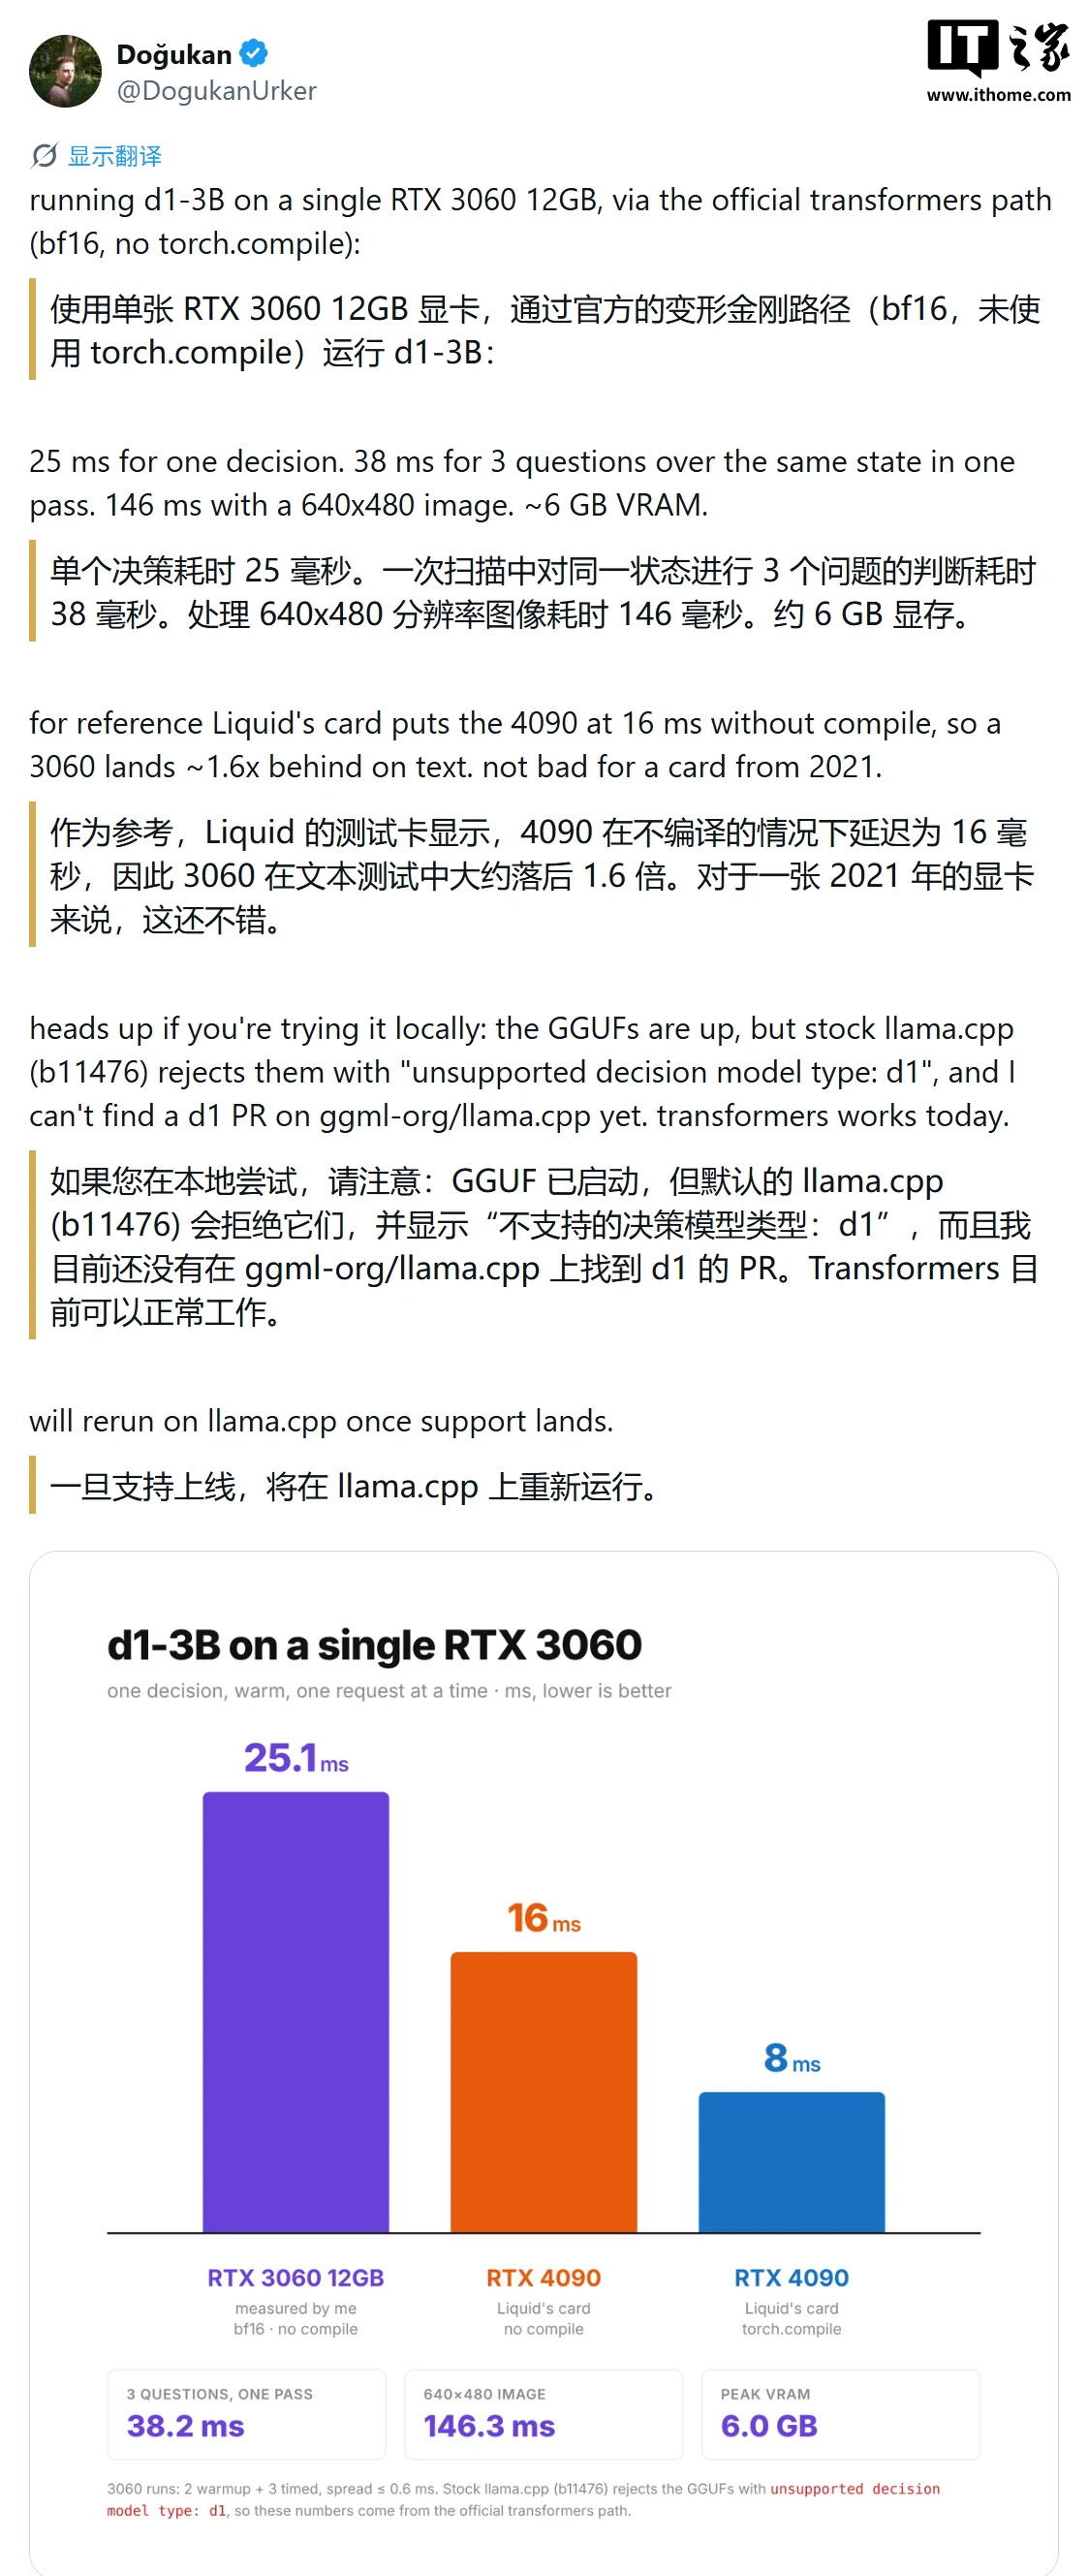
Nutzertests zeigen, dass d1-3B auf einer GeForce RTX 3060 mit 12 GB Videospeicher für ein einzelnes Urteil 25 Millisekunden benötigt, die Verarbeitung eines 640×480-Pixel-Bildes 146 Millisekunden dauert und die maximale Speichernutzung etwa 6 GB beträgt. Andere Nutzer berichten, dass das Modell auf einer RTX 3090 für ein einzelnes Urteil 8 Millisekunden benötigt.