
Wen Le, von Ao Fei Si
Quantenbit | Öffentliches Konto QbitAI
Die göttlich-teuflische Dualität von DeepSeek wurde vom Byte-Seed-Team erwischt.
Dieselbe Aufgabe, nichts geändert, nur ein paar unwichtige Zeichen davor eingefügt – und das Modell kann sie plötzlich nicht mehr lösen???
Und das ist kein gelegentlicher Aussetzer.
Die Seed-Forscher fanden heraus, dass die Leistung von DeepSeek-V4 je nach Eingabeposition der Information,alle 4 Token periodisch schwankt。
Was heißt das? Ob sich das Modell eine Sache merken kann, hängt offenbar davon ab, wo diese Sache in der Eingabe steht??
Zwei Token mehr davor, und die Antwort kann von falsch zu richtig werden; zwei weitere, und sie wird wieder zurückgeändert.
Na toll, jetzt achten Modelle beim Beantworten auch noch auf die Position.
In einem Langkontext-Retrievaltest mit 128K stellten die Forscher fest, dass dieselbe Information nur ihre Position wechselte, und die Retrievalgenauigkeit der DeepSeek-V4-Modellekann um bis zu 40,2 Prozentpunkte auseinanderliegen。
Das Team fand heraus, dass dieses Problem mit einer Langkontext-Optimierungstechnik von DeepSeek-V4 zusammenhängt –
Blockweise KV-Cache-Kompression。
Diese Technik sollte eigentlich dem Modell das Verarbeiten langer Texte speichersparender und effizienter ermöglichen.
Nach der Kompression wurde das Modell jedoch mal göttlich, mal teuflisch (doge).
Zwei Token mehr, und DeepSeek antwortet plötzlich richtig
Die Byte-Seed-Forscher begannen mit einem Experiment an DeepSeeps eigenem Code.
Testobjekt warDeepSeek-V4-Flash-Base。
Sie entnahmen aus DeepSeek-V4s offiziellem Inferenzcode eine FP8-Quantisierungsfunktion und ließen das Modell das letzte Token vervollständigen.
Die richtige Antwort der Aufgabe wäre 8, da dieser Code eine FP8-bezogene Typumwandlung durchführen muss.
Aber das Modell hielt manchmal hartnäckig 32 für richtig.
Um herauszufinden, was da los ist, fügten die Forscher vor den Code einen rein dekorativen Docstring ein, der einige wiederholte Gleichheitszeichen enthielt.
Dann begannen sie, die Anzahl der Gleichheitszeichen zu variieren.
Der Code selbst blieb unverändert, die zu vervollständigende Stelle blieb unverändert, die richtige Antwort natürlich auch … die einzige Änderung war, dass davor diese paar Token ohne praktische Bedeutung standen.
Das Ergebnis: DeepSeeps Antwort sprang ständig hin und her.
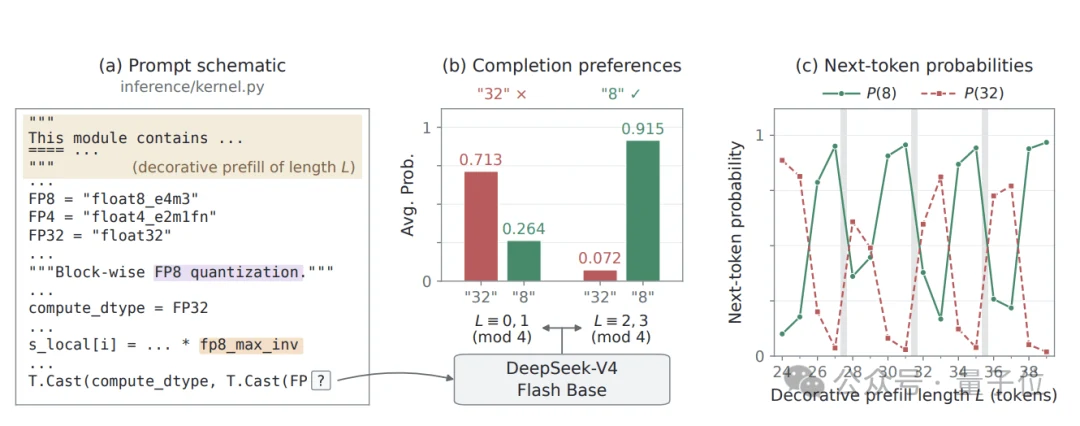
Wenn die Fülllänge an bestimmten Positionen lag, neigte das Modell eher zur falschen Antwort 32.
Rückte man ein bis zwei Token vor, neigte es wieder zur richtigen Antwort 8.
Schiebt man weiter, kommt die falsche Antwort zurück –
Der gesamte Vorgang wiederholt sich in einem Zyklus von 4 Token.。
Genauer gesagt: Bei den in der Studie getesteten 16 Füllängen neigte das Modell dazu, wenn der Rest bei Division der Länge durch 4 gleich 0 oder 1 war, die falsche Antwort 32 zu bevorzugen; bei einem Rest von 2 oder 3 bevorzugte es die richtige Antwort 8.
Die Forschenden ermittelten außerdem die Wahrscheinlichkeiten, die das Modell den beiden Kandidatenantworten zuordnete.
An einer Gruppe von Positionen erreichte die falsche Antwort 32 eine durchschnittliche Wahrscheinlichkeit von 71,3 %, während die richtige Antwort 8 nur auf 26,4 % kam.
Bei einer anderen Gruppe von Positionen kehrte sich das Bild genau um:
Die durchschnittliche Wahrscheinlichkeit der richtigen Antwort 8 stieg auf 91,5 %, während für die falsche Antwort 32 nur noch 7,2 % übrig blieben.
Das heißt, schon eine Längenveränderung der wenigen irrelevanten Zeichen davor genügt, damit das Modell bei ein und derselben Aufgabe zu völlig unterschiedlichen Urteilen kommt.
Das ist irgendwie schwer einzuordnen.
Programmierer:innen prüfen beim Debuggen von Code üblicherweise zuerst Logik, Variablen und Abhängigkeiten.
Inzwischen sollte man offenbar auch gleich mitprüfen, ob vorne nicht versehentlich zwei Gleichheitszeichen zu viel stehen.
Ein einzelnes Code-Completion-Beispiel reicht allerdings noch nicht aus, um zu zeigen, wie verbreitet das Problem ist.
Daher dehnte das Seed-Team die Tests weiter aus.
Sie wandten sich einer sehr klassischen Aufgabe im Bereich der Fähigkeit großer Modelle für lange Kontexte zu:dem „Needle in a Haystack“-Test (Nadel im Heuhaufen)。
Die Forschenden konstruierten einen Kontext von insgesamt 128K Token, der etwa16.000 Schlüssel-Wert-Paare enthielt,。
etwa K1 entspricht V1, K2 entspricht V2 …
Anschließend sollte das Modell den zu einem vorgegebenen Key gehörenden Value heraussuchen.
Während der Tests blieben die Schlüssel-Wert-Beziehungen unverändert, die Frage unverändert, und auch die Gesamtlänge des Kontexts blieb gleich.
Die Forschenden variierten gezieltdie Position der Zielinformation relativ zur Grenze des Komprimierungsfensters.。
Dabei zeigte sich, dass die Genauigkeitskurven der DeepSeek-V4-Reihe eine äußerst deutliche periodische Auf- und Ab-Bewegung aufwiesen.
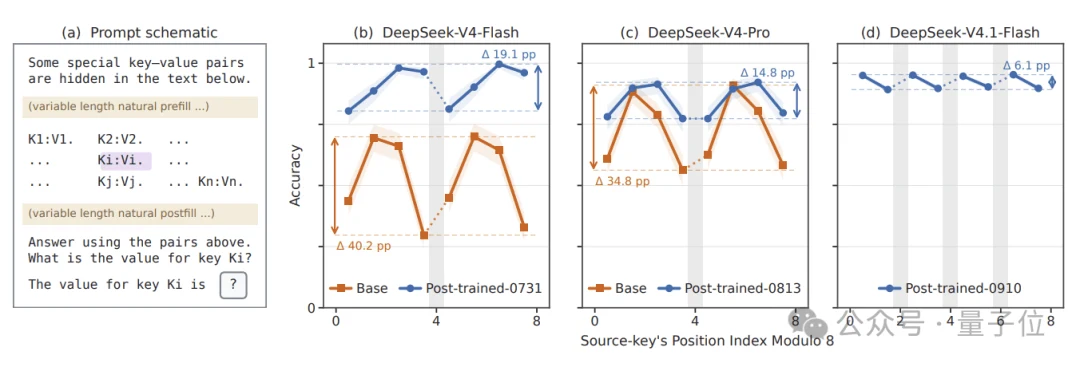
Bei DeepSeek-V4-Flash-Base betrug der maximale Genauigkeitsunterschied zwischen verschiedenen Positionen 40,2 Prozentpunkte,
bei DeepSeek-V4-Pro-Base immer noch 34,8 Prozentpunkte.
Nach demPost-Trainingbesserte sich die Lage.
Bei DeepSeek-V4-Flash-0731 verkleinerte sich die Differenz auf 19,1 Prozentpunkte, bei DeepSeek-V4-Pro-0813 auf 14,8 Prozentpunkte.
Und beim neueren DeepSeek-V4.1-Flash-0910 sank sie weiter auf 6,1 Prozentpunkte.
Die periodischen Unterschiede blieben jedoch bestehen.
Woher kommt diese Verschiedenartigkeit?
Bei genauerer Betrachtung beträgt die Schwankungsperiode bei DeepSeek-V4 4 Token, bei DeepSeek-V4.1 dagegen 2 Token.
Die Forschenden fanden heraus, dass diesexakt der KV-Cache-Komprimierungsschrittweite entspricht, die jedes der beiden Modellgenerationen jeweils verwendet.。
Na toll, selbst die Schwankungszyklen bei den Antwortleistungen passen zu den zugrunde liegenden Komprimierungskonfigurationen.
Liegt das Problem an der KV-Cache-Komprimierung?
Dann sprechen wir also über die KV-Cache-Komprimierung.
Wenn große Modelle lange Kontexte verarbeiten, müssen sie Key- und Value-Informationen für zahlreiche historische Token speichern, um sie für nachfolgende Aufmerksamkeitsberechnungen zu verwenden.
Je länger der Kontext, desto mehr Speicher- und Rechenaufwand verursacht dieser Cache-Teil.
Gerade bei langen Aufgaben mit oft mehreren Hunderttausend oder sogar Millionen von Token wird der KV-Cache schnell zum Engpass für die Inferenzeffizienz.
Daher setzte DeepSeek-V4 aufblockweise KV-Cache-Komprimierung。
Der Ansatz besteht darin, aufeinanderfolgende Token in einzelne Fenster aufzuteilen und die Informationen innerhalb eines Fensters in weniger Cache-Einträge zu komprimieren.
So muss das Modell nicht für jedes historische Token einen Cache in gleicher Größe vorhalten.
Das spart sowohl Speicher als auch Rechenkosten bei der Aufmerksamkeitsberechnung über lange Kontexte.
Doch das Seed-Team entdeckte, dass der Grund für DeepSeeks „göttlich-dämonische Dualität“ genau in diesem Blockungsversteckt sein könnte.
Angenommen, jeweils 4 Token bilden einen Komprimierungsschritt.
Dann kann es je nachdem, ob dieselbe Information an Position 1, 2, 3 oder 4 innerhalb des Fensters erscheint, unterschiedliche Bedingungen bei der Komprimierung geben.
Das Paper bezeichnet diese Position relativ zur Grenze des Komprimierungsfensters alsPhase。
Die Forscher fanden heraus, dassdas Modell beim Abrufen von Informationen je nach Phase systematische Unterschiede aufweist。
Sie nannten dieses PhänomenPhase Sensitivity, Phasenempfindlichkeit。
Als Veranschaulichung: Man übergibt dem Modell dasselbe Material:
Im ersten Layout fällt die Schlüsselzahl genau auf eine Position, die das Modell leicht behalten kann;
im zweiten Layout wurden nur vorne ein paar Zeichen hinzugefügt, wodurch sich die Position der Schlüsselzahl relativ zum Komprimierungsfenster ändert.
Es ist dasselbe Material, aber ob das Modell die Zahl später wiederfinden kann, kann sich deutlich unterscheiden.
Außerdem lässt sich dieses Problem nicht einfach darauf zurückführen, dass „die Information gerade zwischen zwei Fenstern zerschnitten wurde“.
Die Forscher fanden heraus, dass selbst wenn Key und Value beide im selben Komprimierungsfenster liegen, die Abrufgenauigkeit je nach Position stark variieren kann.
Das zeigt, dass das Problem auch damit zusammenhängt, wie das Modell Informationen in den komprimierten Cache schreibt und sie später daraus wieder liest.
Um dies weiter zu bestätigen, trainierte das Seed-Team kurzerhand selbst eine Reihe von Modellen von Grund auf.
Sie verwendeten dieQwen3-0.6B-Architekturals Grundlage, konstruierten mehrere KV-Cache-Komprimierungsschemata und setzten als Kontrolle ein Modell mit vollständiger Aufmerksamkeit ohne blockweise Komprimierung ein.
Gezielt wurde nur der Komprimierungsmechanismus verändert, um zu sehen, ob die periodischen Schwankungen damit einhergingen.
Das Ergebnis:Alle getesteten Modelle mit blockweiser Komprimierung zeigten periodische Schwankungen, die dem Komprimierungsschritt entsprachen。
Umgekehrt zeigte das Voll-Aufmerksamkeits-Basismodell keine vergleichbare Periodizität.
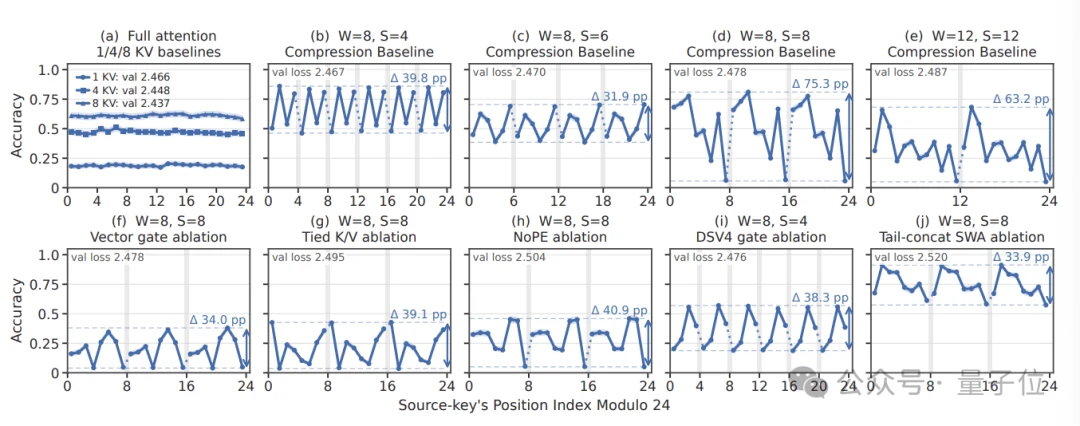
Die Forscher variierten zudem separat die Fenstergröße und die Komprimierungsschrittweite und stellten fest, dass die Periode hauptsächlich der Komprimierungsschrittweite folgt.
Bei einer Schrittweite von 4 schwankte die Leistung mit einer Periode von etwa 4 Token;
bei einer Schrittweite von 6 wurde die Periode ebenfalls zu etwa 6 Token;
Bei einer Schrittlänge von 8 zeigt sich dasselbe;
……
Selbst wenn man RoPE-Positionskodierung nicht verwendet oder die lernbaren Kompressionsgewichte durch einen einfachen Durchschnitt ersetzt, bleibt dieses Phänomen bestehen.
Mit anderen Worten: Das Problem wird nicht allein durch eine bestimmte Positionskodierung oder ein bestimmtes Spezialmodul verursacht.
Das Design der blockweisen Kompression selbst kann periodische Schwächen beim Abrufen mit sich bringen.
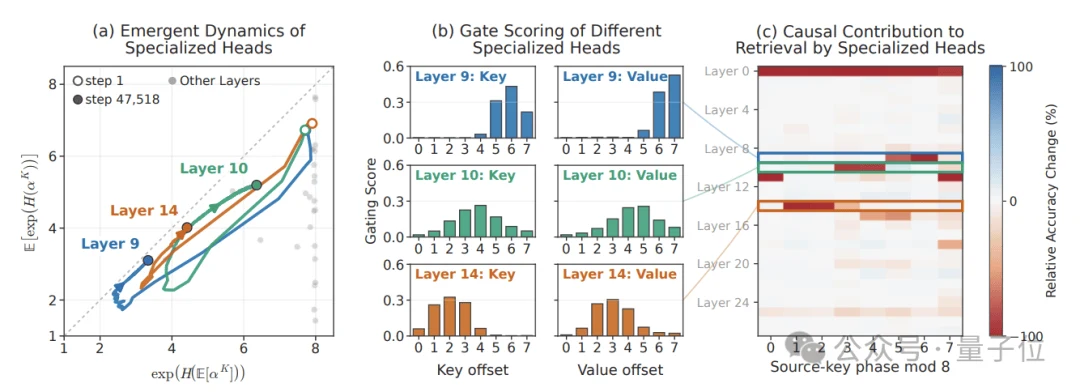
Das Seed-Team griff weiterhin in die Aufmerksamkeitsköpfe ein und beobachtete, wie sich die Abruffähigkeit des Modells in den verschiedenen Phasen verändert, nachdem unterschiedliche Komponenten entfernt wurden.
Dabei zeigte sich, dass verschiedene Aufmerksamkeitsköpfe unterschiedlich zu den einzelnen Phasen beitragen.
Manche Köpfe sind besser darin, Informationen an bestimmten Positionen zu verarbeiten, während andere Köpfe an anderen Positionen eine größere Rolle spielen.
Die Forscher bezeichnen dies als Phase Specialization, also Phasenspezialisierung.
Das bedeutet, dass im Inneren des Modells offenbar eine Art Arbeitsteilung entsteht: verschiedene Aufmerksamkeitskomponenten entwickeln eine Vorliebe für unterschiedliche Positionen innerhalb des Kompressionsfensters.
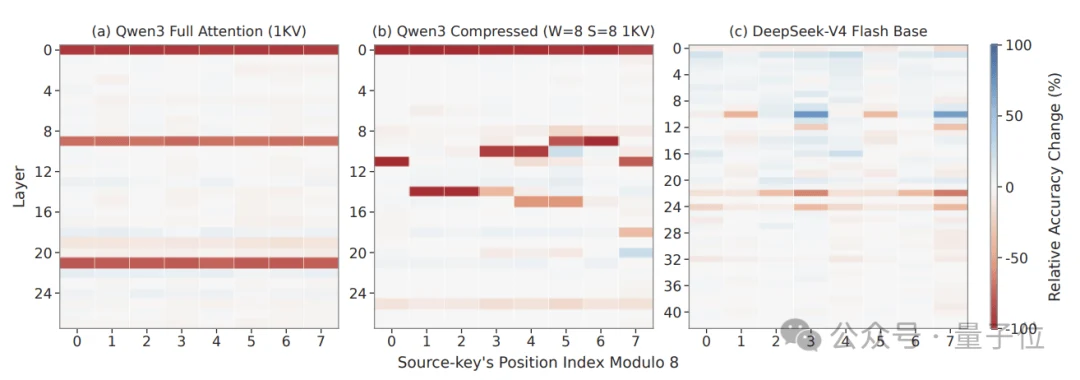
Diese Arbeitsteilung kann dem Modell bei der Informationsabrufung helfen, kann aber auch dazu führen, dass bestimmte Positionen zu vergleichsweise schwachen Stellen werden.
Die Arbeit analysiert den Trainingsprozess zudem anhand eines vereinfachten theoretischen Modells und stellt fest, dass der Gradientenfluss die Kompressionsmodule dazu bringen kann, stabile Positionspräferenzen auszubilden.
Das erklärt auch, warum diese Periodizität kein simples zufälliges Rauschen ist. Sie ist möglicherweise ein natürlicheres Ergebnis davon, wie das Modell beim Lernen des Informationskomprimierens vorgeht.
Allerdings lassen sich solche Probleme nicht unbedingt direkt aus gewöhnlichen Benchmarks ablesen, da herkömmliche Evaluationen in der Regel eine Vielzahl von Testergebnissen zu einem Durchschnittswert zusammenfassen.
Angenommen, das Modell schneidet bei bestimmten Positionen sehr gut ab, bei anderen deutlich schlechter – dann kann der am Ende berechnete Durchschnitt trotzdem gut aussehen.
Daher schlägt das Seed-Team vor, dass man bei der Bewertung von Modellen mit blockweisem KV-Cache-Komprimierung nicht nur die gesamthafte Abrufgenauigkeit betrachten darf, sondern dieselbe Information auch in unterschiedlichen Kompressionsphasen testen und jeweils gesondert messen muss.
Doch selbst wenn es diese positionsbedingten Leistungsschwankungen gibt: Angesichts der Speicher- und Rechenkosten bei langen Kontexten bleibt Komprimierung nach wie vor sehr praktisch wertvoll.
Aber nach der Cache-Einsparung behandelt das Modell Informationen an verschiedenen Positionen möglicherweise nicht mehr gleich.
Allerdings zeigen die diesjährigen Experimentergebnisse, dass Post-Training und Architekturiterationen diese Lücke tatsächlich deutlich verkleinern können.
Paper-Adresse: https://arxiv.org/pdf/2609.36322