
Yishui von Ao Fei Si
Quantenbit | WeChat-Konto QbitAI
Währenddessen Videospiele spielen und sich dabei selbst aufrüsten?
Na toll, Huawei hat seiner KI mit diesem Zug direkt beigebracht, „beim Spielen stärker zu werden“?!
In einer aktuellen Studie hat das Huawei Noah’s Ark Lab gemeinsam mit UCL und anderen Teams ein KI-Agentensystem namensMemento 3vorgestellt –
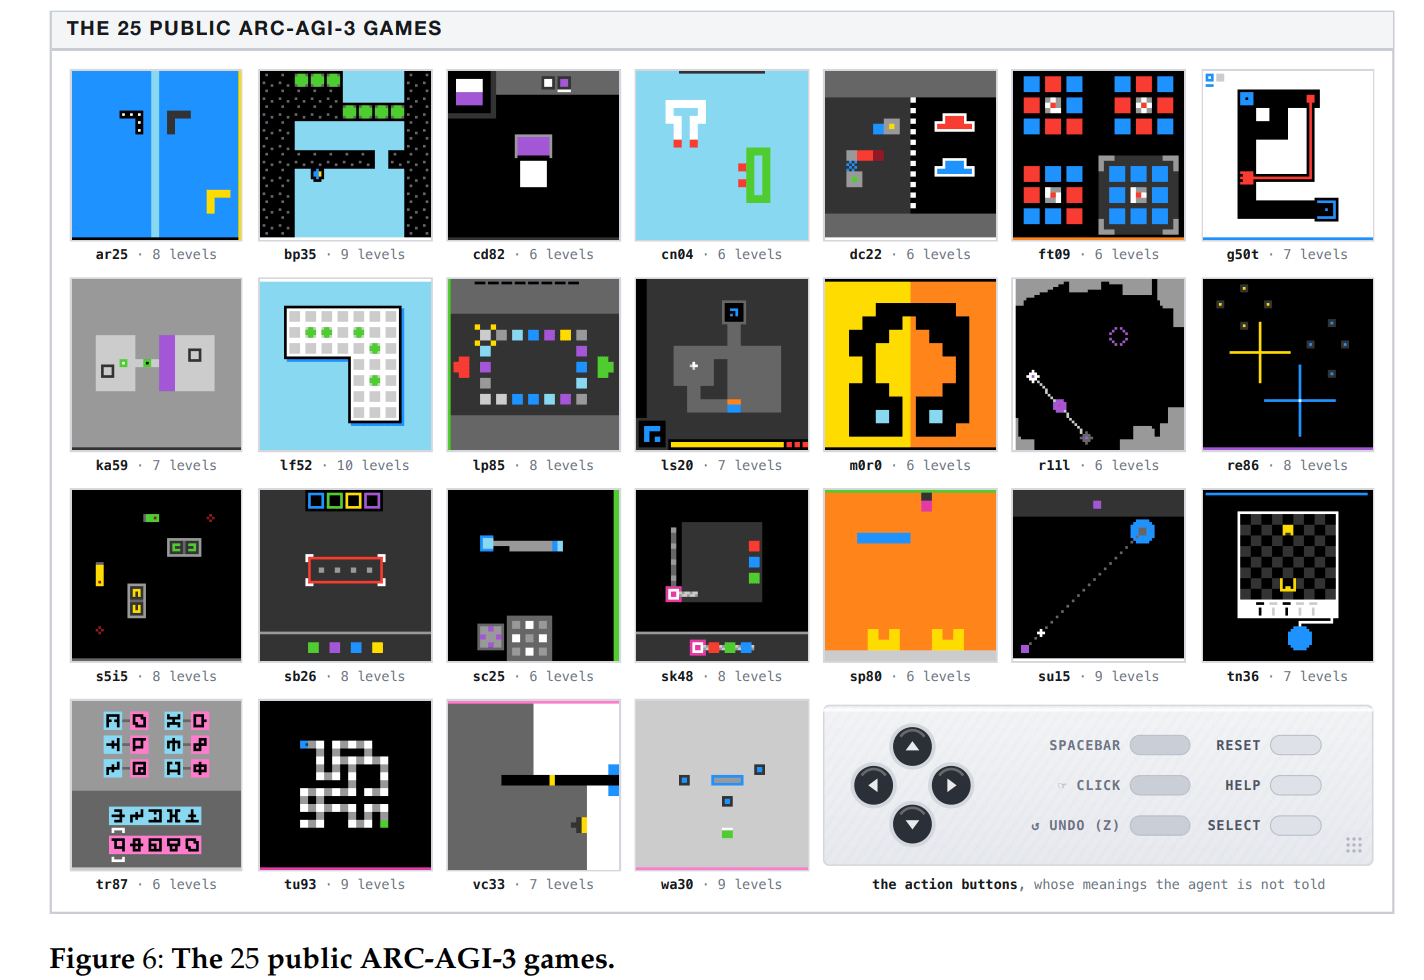
das sämtliche 25 Spiele mit 183 Leveln aus dem öffentlichen ARC-AGI-3-Satz komplett durchgespielt hat.
Und das nicht etwa durch blindes Ausprobieren und stures Durchklettern.
Ein Mensch braucht für denselben Satz an Leveln 17135 Bedienvorgänge.
Memento 3 benötigte dafür nur 7518,also etwa 56 % weniger Operationen als der Mensch, und erreichte am Ende eine volle RHAE-Punktzahl von 100(Relative Human Action Efficiency, relative menschliche Handlungseffizienz).
Noch absurder ist:Dieses System basiert auf Claude Opus 5 als Basismodell, hat während des gesamten Ablaufs keine Modellgewichte aktualisiert und kein Finetuning für die Spiele erhalten。
Es hat einfach selbst angefangen zu spielen, die Regeln selbst ergrübelt, selbst Code geschrieben, und bei Fehlern reflektiert und korrigiert es nach.
Und dann … schaffte es den Durchlauf mit voller Punktzahl.
Zum Vergleich: Claude Opus 5 erreicht im offiziellen Standard-Testframework des ARC Prize im Schnitt nur etwa 40,7 RHAE-Punkte.
Mit demselben Basismodell, aber einem anderen Agentensystem, stieg die Punktzahl also direkt um 59,3 Punkte.
Das ist noch nicht alles.
Diese Methode eignet sich nicht nur für Rätselspiele: Das Forschungsteam ließ sie auch das Atari-Klassikerspiel Pong (Tischtennis) spielen.
Dadurch entwickelte die KI selbst eine Steuerungsstrategie und schlug danach, ohne weitere Inferenzanfragen an das große Modell, den Gegner in drei aufeinanderfolgenden Runden jeweils mit 21:0.
Warte mal – ohne dass das große Modell an den weiteren Operationen beteiligt ist, kann das Spiel so flüssig gespielt werden?!
Der Schlüssel steckt bereits im Titel dieser Forschungsarbeit:
Model-Based Recursive Self-Improvement, rekursive Selbstverbesserung auf Basis eines Weltmodells。
Huawei-KI schafft 25 Spiele komplett, mit 56 % weniger Bedienvorgängen als der Mensch
Zunächst einmal: Was hat es mit diesen 25 Spielen auf sich?
Sie stammen aus dem von ARC Prize herausgegebenen ARC-AGI-3; wer KI-Benchmarks verfolgt, kennt die ARC-Serie vermutlich bereits.
Aber diese Generation hat eine sehr deutliche Änderung:
Es geht nicht mehr nur um das übliche Aufgaben-Stellen-und-Lösen: Diesmal wird die KI direkt in eine ihr unbekannte Spielwelt geworfen.。
Die Regeln muss die KI selbst erraten; das Ziel muss die KI selbst finden; welche Effekte eine Aktion hat, muss die KI selbst ausprobieren.
KI: Also läuft bei mir hier alles, was?~
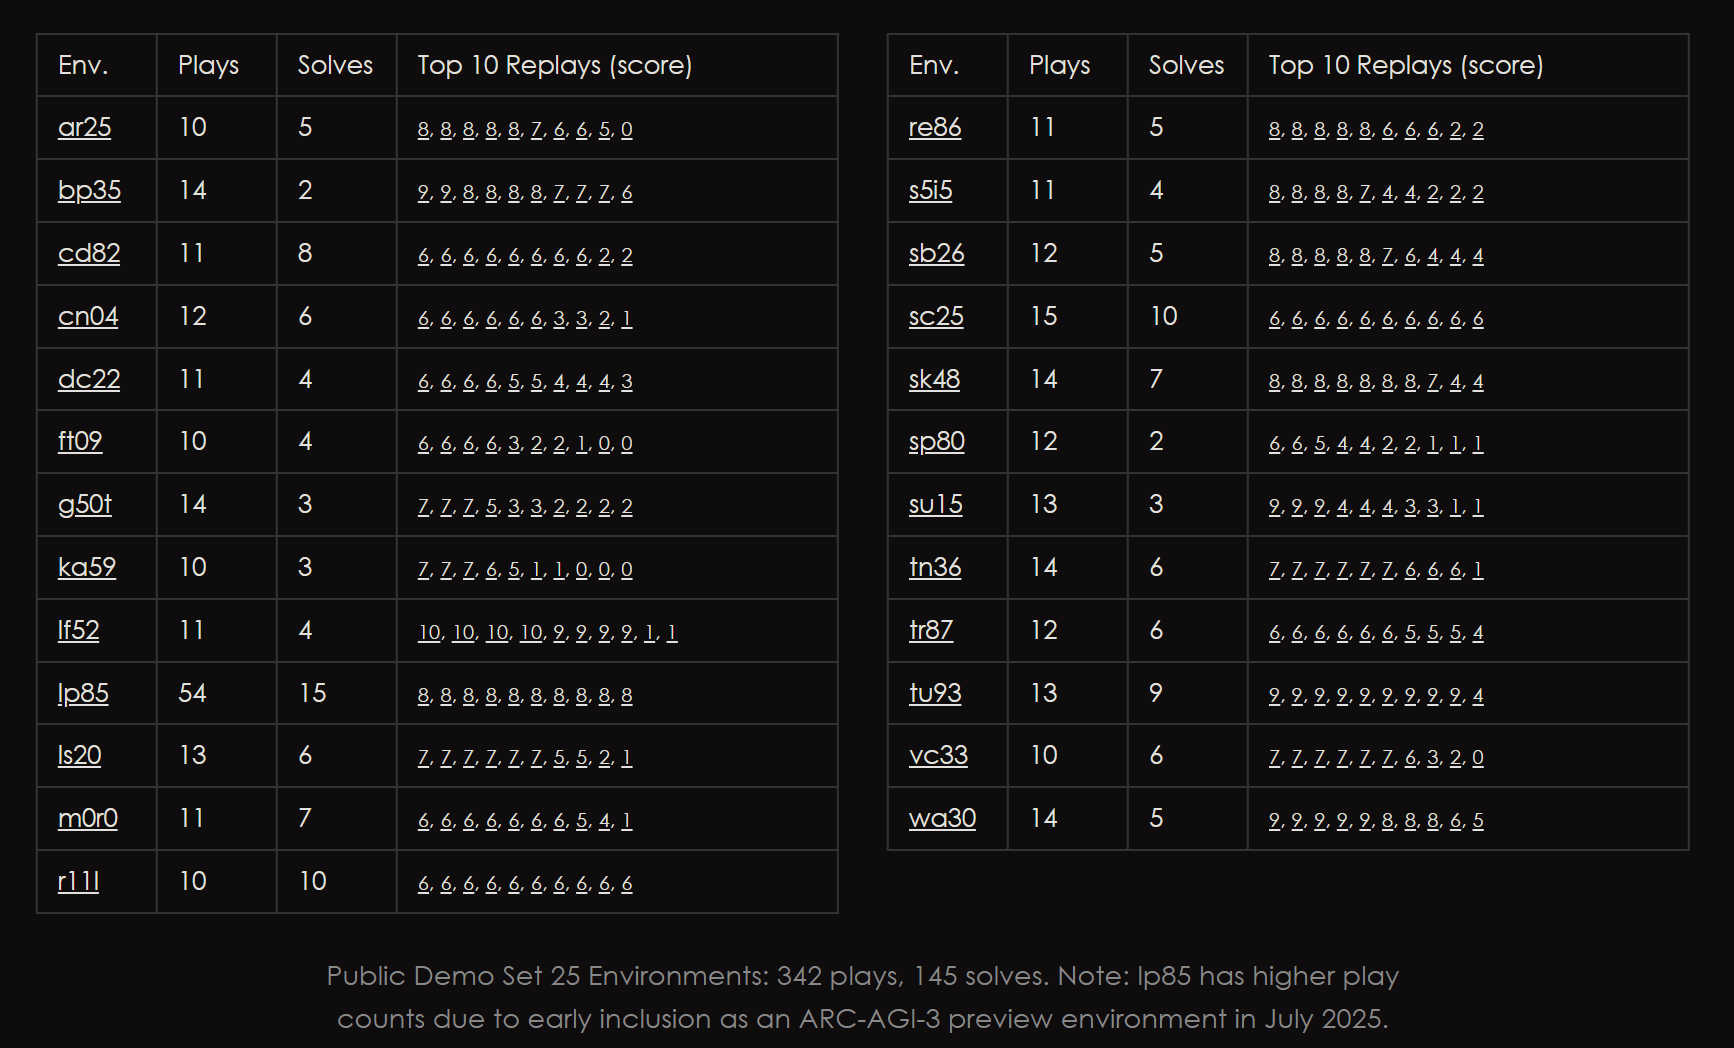
Diese 25 öffentlich zugänglichen Spiele umfassen insgesamt 183 Level, die Grafik besteht meist aus simplen Pixeln, Blöcken, Farben und Formen.
Auf den ersten Blick sieht es fast wie eine Sammlung kleiner Spiele aus Jahrzehnten zuvor aus.
Aber lasst euch nicht von diesem schlichten Grafikstil täuschen.
Für KI ist das Bedienen nicht das Schwierigste – das Lästige ist, dass sie überhaupt nicht weiß, wie diese Welt funktioniert.
Was passiert, wenn man einen besonderen Boden betritt? Eine Tür lässt sich nicht öffnen – stimmt die Farbe nicht überein oder passt die Form nicht?
Noch ärgerlicher: In späteren Leveln können neue Regeln auftauchen, die die gesamte zuvor erarbeitete Erfahrung über den Haufen werfen.
Nicht nur die KI – auch menschliche Spieler bleiben hängen。
Die Testdaten des ARC Prize zeigen: In einem Denkspiel namens r11l, bei dem man ein Amöbe bewegen und ihre Farbe ändern muss, haben alle 10 Teilnehmer das Spiel geschafft; bei einem anderen Rätselspiel namens tr87, das das Entschlüsseln von Symbolen verlangt, schafften nur 6 von 12 Teilnehmern den Erfolg.
Noch vor der Huawei-KI lieferten sich die verschiedenen Forschungsteams bereits einen heftigen Wettbewerb:
Das von der Princeton University vorgestellte Continual Harness schaffte nur 3 Spiele und erreichte 20.5 Punkte.
DreamTeam, an dem Forscher von Nvidia mitentwickelt haben, schnitt etwas besser ab: 6 Spiele geschafft, 38.1 Punkte.
Etwas weiter oben: OPINE-World des unabhängigen Forschers David Courtis und NOOA des Nvidia-Teams erreichten 78.4 bzw. 85.1 Punkte.
Am stärksten war baseline1 des unabhängigen Entwicklers Sergey Rodionov: Es schaffte nicht nur alle 25 Spiele, sondern erreichte auch 99 Punkte – nur 1 Punkt von der vollen Punktzahl entfernt.
Doch das Huawei-Team hat sich diesmal direkt auch diesen letzten 1 Punkt gesichert。
Memento 3 schaffte nicht nur alle 25 Spiele und 183 Level mit 100 Punkten, sondern drückte auch die Gesamtzahl der Operationen auf 7518 – 829 weniger als baseline1 mit 8347.
Es hat nicht nur durchgespielt, sondern mit weniger Schritten durchgespielt.
Wie ist das möglich??
Ohne Training großer Modelle: Die KI steigt Level auf, indem sie sich selbst einen Lösungsleitfaden schreibt
Beim Durchsehen des Papers: Die Kernmethode von Memento 3 heißtCode as Model (Code als Modell)。
Das klingt etwas abstrakt, bedeutet aber im Grunde, dass die KI beim Spielen zwei Dinge für sich vorbereitet:
einen ständig aktualisierten Spielleitfaden sowie einen Satz Code, der den Spielablauf simulieren kann.
- Rulebook (Regelhandbuch): Ein Markdown-Dokument, das die Regeln festhält, die die KI im Spiel herausgefunden hat – etwa welche Operation welche Effekte auslöst, wie man ein Level schafft und welche Regeln noch unverstanden sind.
- Executable World Model (ausführbares Weltmodell): Die KI schreibt die von ihr zusammengefassten Regeln direkt als lauffähigen Python-Code – im Grunde baut sie sich selbst einen vereinfachten Spielsimulator.
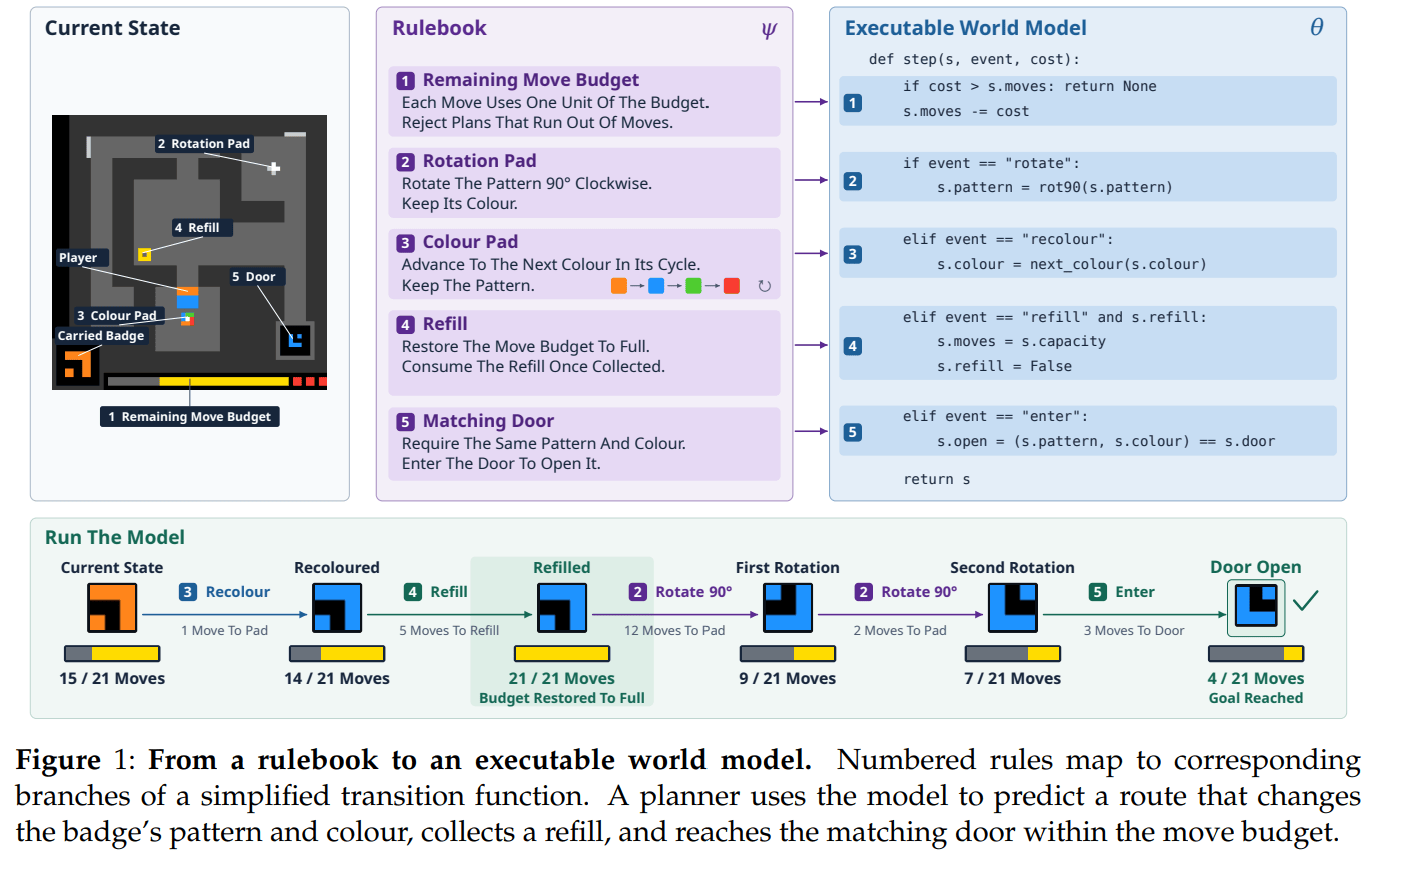
Mit diesen beiden Dingen kann die KI zunächst in ihrem selbstgebauten Simulator verschiedene Wege durchspielen, bevor sie den nächsten Schritt entscheidet.
Aber da stellt sich die Frage: Was, wenn die anfänglich verstandenen Spielregeln schlicht falsch sind?
Keine Sorge,Memento 3 schreibt sich nicht nur selbst den Leitfaden, sondern kann bei einem Fehler auch selbst alles umwerfen und neu beginnen。
Das Paper zeigt ein Beispiel.
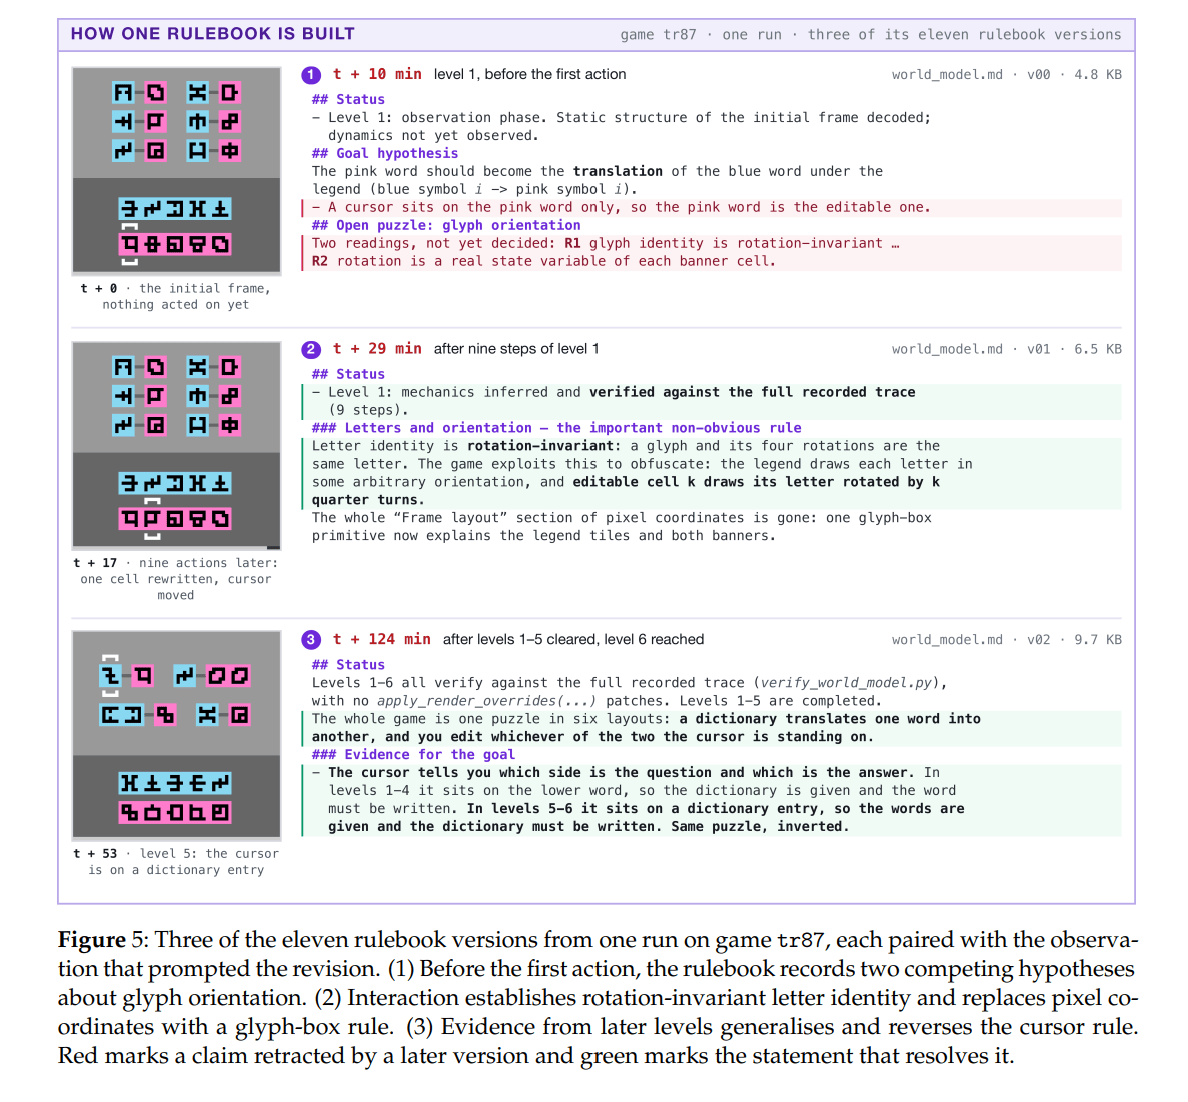
In einem Rätselspiel stößt die KI auf einen besonderen Boden und nimmt zunächst an, dass sich das vom Charakter getragene Muster beim Betreten je nach Eintretensrichtung spiegelverkehrt umkehrt.
Erst als sie es wirklich ausprobiert, merkt sie: Das Muster wird nicht gespiegelt, sondern um 90 Grad im Uhrzeigersinn gedreht – unabhängig von der Eintretensrichtung.
Daraufhin ändert die KI ihr Regelhandbuch, und der entsprechende Python-Code wird ebenfalls aktualisiert.
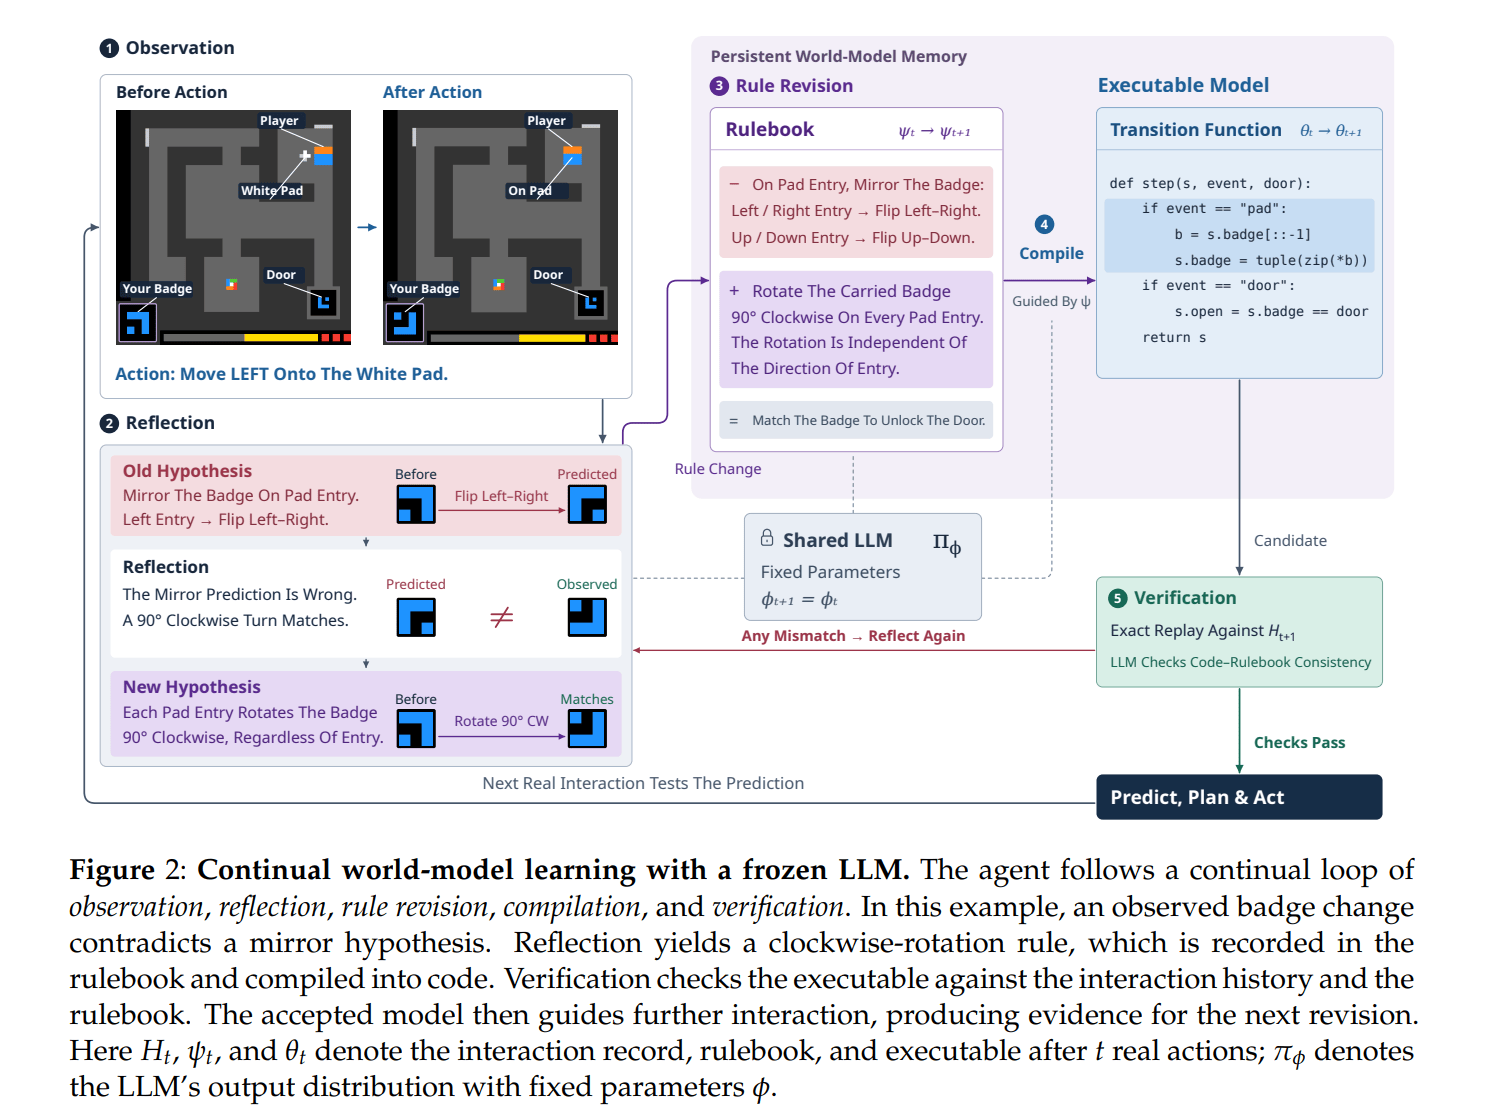
Allerdings muss nach jeder Änderung geprüft werden.
Das System simuliert die vorherigen Operationen erneut und vergleicht die 64×64-Spielbilder Feld für Feld, um zu bestätigen, dass der Code die echten Ergebnisse genau reproduziert.
Stimmt es nicht überein, wird weiter geändert.
So erkundet die KI, korrigiert Fehler und die Regeln werden mit jeder Änderung genauer.
Und die zuvor gewonnenen Erfahrungen können auch in spätere Level übertragen werden.。
Zum Beispiel wusste die KI beim Symbol-Entschlüsselungsspiel tr87 zunächst nicht, ob die Ausrichtung der Symbole die Bedeutung beeinflusst, und stellte später fest, dass Symbole in verschiedenen Richtungen möglicherweise denselben Buchstaben darstellen.
Als neue Level auftauchten, widerlegte sie auch ihr bisheriges Verständnis der Cursor-Position.
Im Laufe des gesamten Spiels wurde dasselbe Regelhandbuch in 11 Versionen überarbeitet.
Zur besseren Nachverfolgbarkeit führte das Forschungsteam sogar eine Git-Versionsverwaltung ein.
Jede Änderung an den Regeln und am Code wurde aufgezeichnet; wenn ein Fehler entdeckt wurde, konnte man ältere Versionen durchsehen und bei Bedarf direkt wiederherstellen.
Na so was – beim Spielen wird auch noch nebenbei ein Code-Repository gepflegt.
Genau das ist die vom Forschungsteam sogenannte rekursive Selbstverbesserung (RSI).
Die Parameter des großen Modells müssen nicht verändert werden: Die KI kann sich durch kontinuierliches Sammeln von Erfahrung sowie Anpassen von Regeln und Code selbst immer geübter im Spielen machen.
Und diese Methode ist tatsächlich durch Daten belegt.
Das Forschungsteam führte in drei Spielen KontrollExperimente durch:
Mit erhaltenem Regelhandbuch brauchte die KI insgesamt 617 Operationen; ohne das Regelhandbuch, nur mit dem Code-Weltmodell, waren es 677.
Mit diesem Leitfaden wurden die Operationen um etwa 9 % reduziert, und die Ausführungsrunden des Agenten verringerten sich um etwa 18 %.。
Doch das Forschungsteam gab sich damit noch nicht zufrieden.
Wenn ein Weltmodell der KI Umwege erspart, was passiert dann mit zwei gleichzeitig?
Daher ließen sie die KI zwei Weltmodelle gleichzeitig pflegen, die sich die Aufzeichnungen der Spieloperationen teilen, aber jeweils unterschiedliche Regelhypothesen durchspielen.
Das Ergebnis: Im Spiel wa30 brauchte das einzelne Weltmodell 899 Operationen zum Durchspielen, während es mit dem doppelten Weltmodell direkt auf 597 sank.
Die Anzahl der Operationen wurde erneut um etwa 34 % reduziert.。
Diese Verbesserung wurde allerdings bisher nur bei wa30 verifiziert und lässt sich nicht direkt auf andere Spiele übertragen.
Aber zumindest bewies Memento 3 in diesen Experimenten eine Sache:
Ohne erneutes Training des großen Modells kann die KI durch fortwährende Korrektur ihres Weltverständnisses immer stärker werden.
Beim Spielstand von 21:0 musste die KI das große Modell nicht einmal mehr aufrufen
Kann diese Methode also nur zum Spielen von Rätselspielen dienen?
Das Forschungsteam beschloss, den Schwierigkeitsgrad zu erhöhen und Memento 3 direkt das klassische Arcade-Spiel Atari Pong (Tischtennis) bestreiten zu lassen.
Anders als bei den bisherigen Rätselspielen bewegt und springt der Ball hier ständig: Die KI muss nicht nur die Spielregeln erfassen, sondern auch die Flugbahn des Balls in Echtzeit beurteilen und den Schläger steuern, um den Ball zu treffen.
Bei diesem Versuch kam tatsächlich etwas Neues heraus.。
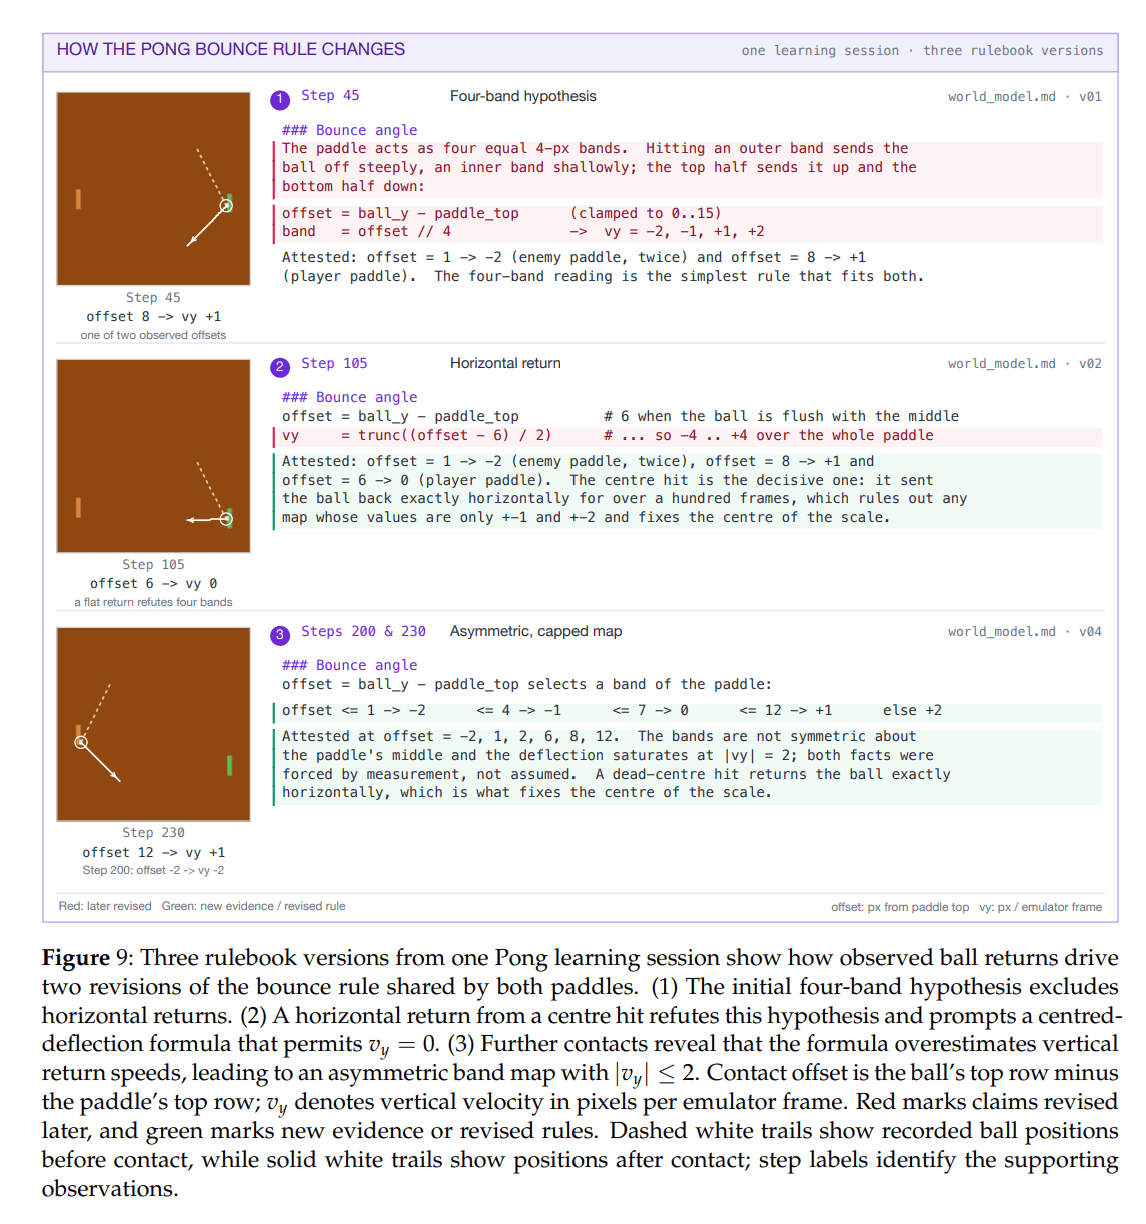
Anfangs kannte die KI die Abprallgesetze des Balls ebenfalls nicht und musste beim Spielen nach und nach heraustasten.
Sie nahm zunächst an, dass der Schläger in vier Zonen unterteilt ist und der Ball je nach Trefferposition in die entsprechende Richtung abprallt.
Doch beim Spielen trat plötzlich ein horizontaler Abprall auf.
Huch? Das passte nicht zu den zuvor zusammengefassten Regeln.
Daher analysierte die KI die Kollisionsposition neu und passte die Abprallformel an; als später neue Abweichungen in der Flugbahn auftraten, korrigierte sie weiter und leitete allmählich Bewegungsgesetze ab, die den tatsächlichen Gegebenheiten besser entsprachen.
Als die Steuerungsstrategie ausgereift war, ließ das Forschungsteam das Programm schließlich ganz allein antreten.
Claude Opus 5 wurde nicht mehr aufgerufen, und die Regeln wurden nicht mehr aktualisiert.
Das Ergebnis:Drei verschiedene Anfänge – alle endeten mit 21:0。
Unglaublich: Vorhin suchte man noch nach dem richtigen Empfang des Balls, kurz darauf wurde der Gegner zu Null abgeschossen???
Und Achtung: Das große Sprachmodell musste zu diesem Zeitpunkt gar nicht mehr selbst antreten.
Es war nur für die anfängliche Erarbeitung der Regeln und die Zusammenfassung der Spielstrategie zuständig; sobald die Strategie erlernt war, wurde sie direkt an Code zur Ausführung übergeben.
Zum Vergleich: Wenn man kein Weltmodell verwendet und das große Sprachmodell nur anhand des aktuellen Bildschirmbildes den nächsten Schritt entscheiden lässt, liegt der Endstand nur bei -19 – kaum besser als die -20.7 durch zufälliges Tastenwirrwarr.
Bei diesem Vergleich wird der Unterschied deutlich.
Statt das große Sprachmodell jeden Schritt neu überlegen zu lassen, sollte man es zunächst lernen lassen, wie das Spiel funktioniert, und die Spielweise dann an ein Programm übergeben。
Und die Effizienz ist ebenfalls beachtlich.
Laut den Angaben der Arbeit benötigte Memento 3 nur etwa9500 Spielframes, um diese Kontrollstrategie zu erlernen.
Zum Vergleich: Einige traditionelle Reinforcement-Learning-Methoden benötigen oft mehrere Hunderttausend oder sogar Hunderte Millionen Frames an Trainingsdaten.
Natürlich bedeutet das nicht, dass Memento 3 keine Kosten verursacht.
Schließlich arbeitet es im Hintergrund mit Claude Opus 5, bei dem die Inferenzstärke Extra-High aktiviert ist – beim Explorieren, Generieren von Code und Verifizieren werden erhebliche Mengen an Tokens und Rechenleistung verbraucht.
Außerdem konzentrieren sich die bisherigen Experimente hauptsächlich auf Spielumgebungen mit relativ klaren Regeln; ob diese Methode auch in einer komplexeren und veränderlicheren realen Welt funktioniert, bleibt noch zu überprüfen.
Dennoch zeigt diese Forschung eine bemerkenswerte Richtung auf:
Rekursive Selbstverbesserung (RSI) erfordert nicht zwangsläufig Änderungen an den untersten Modellgewichten. Durch den Aufbau eines überprüfbaren, ausführbaren und rücksetzbaren externen Weltmodells können auch generalistische große Modelle mit eingefrorenen Parametern sich in unbekannten Domänen selbst iterieren und sich schnell weiterentwickeln.
Adresse der Arbeit:
https://arxiv.org/abs/2610.11794
Referenzlinks:
https://x.com/ScarletKc/status/2109169173540884935