IT之家 Bericht vom 12. Oktober: Alibaba Qianwen veröffentlicht heute offiziell QwenGyre, eine Online-Enforcement-Learning-Framework für langfristige intelligente Aufgaben.
Laut offiziellen Angaben führt das intelligente System bei komplexen Aufgaben, deren Ausführung oft mehrere Stunden dauert, Hunderte von interdependenten Interaktionen zwischen dem Modell und der Umgebung durch, und verarbeitet insgesamt Millionen von Tokens. QwenGyre ermöglicht durch elastische Planung und Trajektoriebehandlung diese sehr lange Aufgaben als effektive Trainingsquellen und bringt zugleich Verbesserungen in der Fähigkeit und Effizienz mit sich.
QwenGyre kann die GPU in mehrere Berechnungseinheiten aufteilen. Nach Abschluss einer Aufgabe wechseln die freien Einheiten direkt in den Trainingsprozess, genauso wie bei der Abstimmung innerhalb des Projektteams – wer zuerst seine Aufgabe erledigt hat, wird zuerst zur Beratung eingesetzt. Die noch laufenden Aufgaben werden völlig ungestört bleiben; Fortschritt und Zustand bleiben erhalten, und sogar die vorher berechneten Caches werden vollständig entfernt, sodass nichts von vorne beginnen muss. Die neu freien Einheiten treten direkt in den Trainingszyklus ein, wer schneller rechnet, arbeitet mehr. Schließlich sammeln die Kern-Einheiten die Ergebnisse zusammen und führen eine Parameteraktualisierung durch.
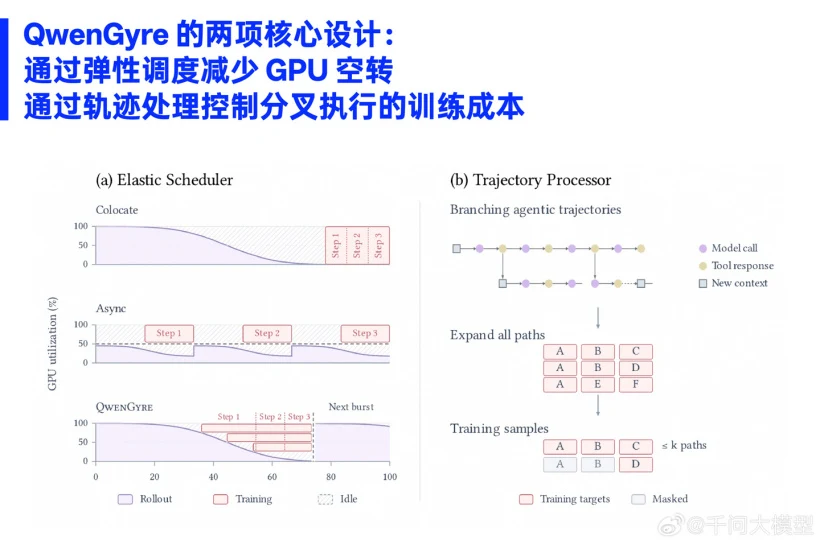
IT Home hat bemerkt, dass QwenGyre durch Token-in-Token-out das echte Kontextverhältnis jedes Ausgabeabschnitts dokumentieren kann. Es organisiert die Pfade in einem Baumstruktur nach gemeinsamen Präfixen und entfaltet nur die ausgewählten Pfade zu Trainingsbeispielen. Gleichzeitig können auch Aufgaben, die mit Zeitlimit abgeschlossen wurden, aber nicht vollständig sind, durch Partial Scoring nützliche Rückmeldungen liefern, ohne dass jede Anstrengung verschwendet wird.
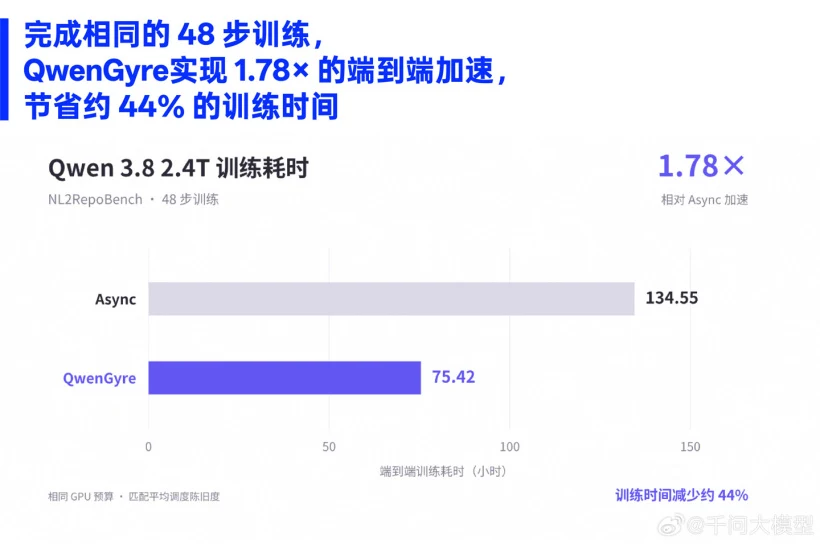
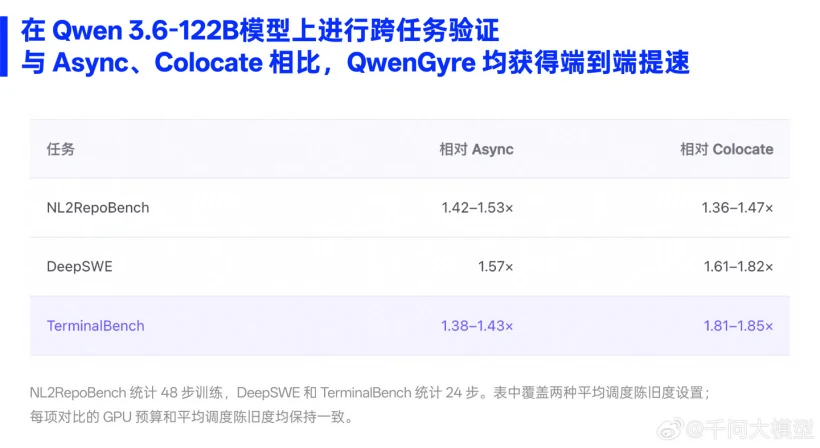
Was die Leistung angeht, führt das Unternehmen in den Online-Stärkungslernen mit NL2RepoBench eine Trainingsaufgabe durch, bei der jeweils etwa 700.000 Tokens pro Rollout verwendet werden. Nach 48 Training-Schritten stieg die Durchführungsrate des Modells von 52,5% auf 58,5%. Unter demselben GPU-Budget erreicht QwenGyre eine End-to-End-Verdopplung von 1,78× gegenüber Async, und die Trainingspunkte sind ähnlich wie bei Async und Colocate. In der Übergreifenden Validierung auf Qwen3.6-122B erzielten alle drei Aufgabenklassen – NL2RepoBench, DeepSWE und TerminalBench – eine End-to-End-Verdopplung.