Einführung von QwenGyre – bringt elastischen RL in die Training von Agenten mit extrem langem Horizont (XLong). ✨
Es startet mit zwei Kernkonzepten: 🥳
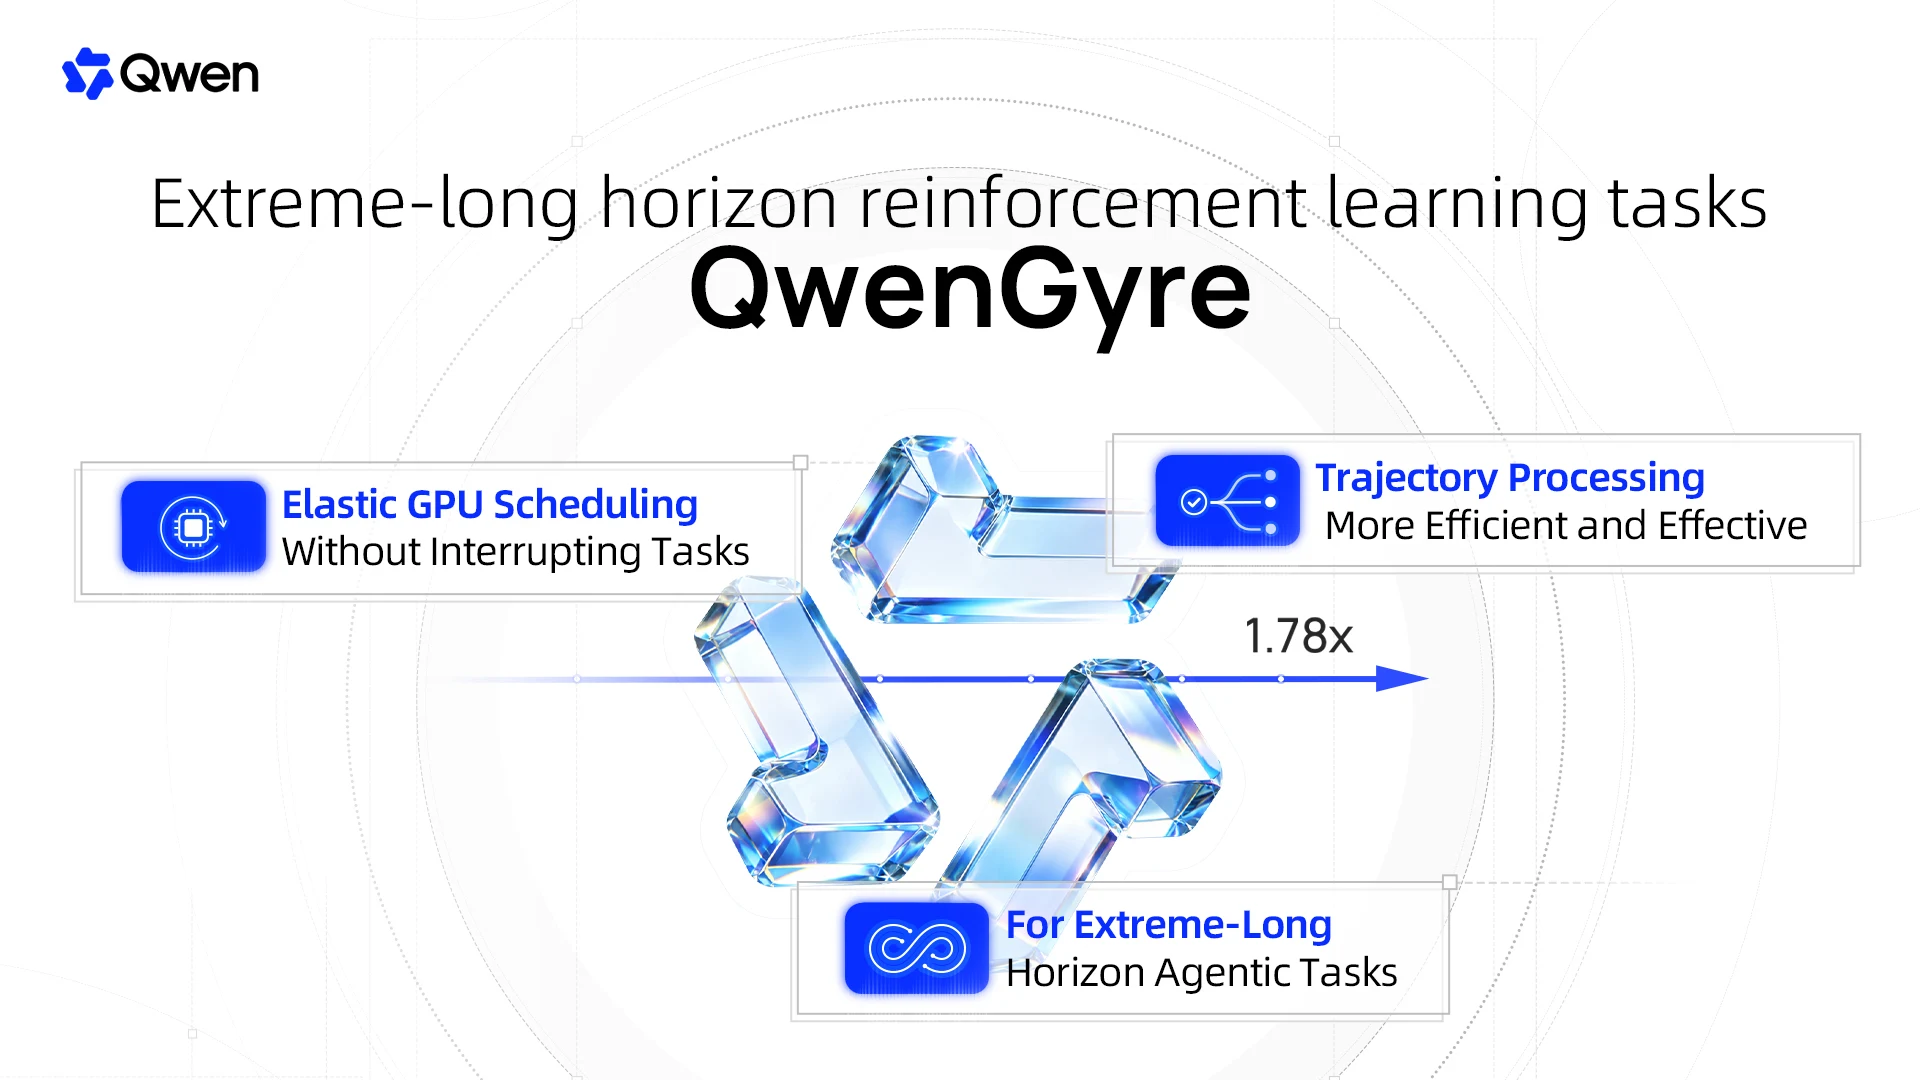
- Elastic Scheduler: verschiebt GPUs zwischen Rollout und Training, sobald die Nachfrage ändert – die Live-Exekutionen werden nie unterbrochen. Geschwindigkeitssteigerung bis zu 1,85× gegenüber Colocate, 1,78× gegenüber Async.
- Trajectory Processor: wandelt abzweigende Ausführungen (Compaction, Sub-Agenten, Wiederholungen) in prefix-geteilte Trajektäume mit begrenzten, entwurzelten Trainingsbeispielen um. Ein Teil der Fortschritte nach Timeout werden trotzdem bewertet.
Skaliert auf Qwen3.8-2.4T-A95B mit ~700K Tokens pro Rollout – QwenGyre verbessert NL2RepoBench in 48 Schritten von 52,5 % auf 58,5 %, und verkürzt die End-to-End-Trainingszeit gegenüber Async um etwa 44 %.
🔗 Lesen Sie das Paper:
https://arxiv.org/abs/2609.33848