
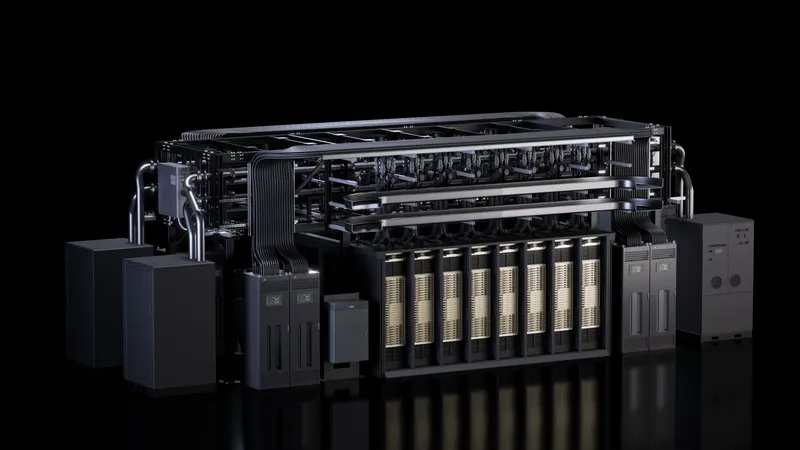
Wenn die KI-Fabriken von Megawatt zu Gigawatt wachsen, erfordert deren Aufbau mehr als nur fortschrittliche Computing-Technologie. Offene Standards helfen der Industrie, die KI-Infrastruktur schneller, effizienter und zuverlässiger zu skalieren.
Bei der Globalen Konferenz des Open Compute Project (OCP) im San Jose McEnery Convention Center kündigte NVIDIA neue Partnerschaften und Beiträge an, die dazu dienen, eine gemeinsame Grundlage für die Infrastruktur der nächsten Generation von KI zu schaffen.
NVIDIA lieferte wichtige NVIDIA Vera Rubin-Rack- und Compute-Tray-Designs an OCP über die offene NVIDIA MGX-Architektur, sodass Systembauer eine gemeinsame Grundlage für die Entwicklung der nächsten Generation von AI-Fabriken haben.
Zusammen umfassen diese Bemühungen die AI-Fabrik selbst, das Netzwerk, das sie versorgt, sowie die Rack-Skalararchitektur im Zentrum des modernen beschleunigten Computing.
NVIDIA und Partner veröffentlichen Fortschritte in der offenen Architektur
Bei der OCP-Veranstaltung haben NVIDIA und Partner einige Ankündigungen gemacht:
- NVIDIA und Großrechenzentren haben offene Standards für Next-Generation-AI-Fabriken veröffentlicht, einschließlich Designstandards für AI-Fabriken und Resilienz von Grids.
- NVIDIA hat neue Open-Source-Softwarekomponenten für die NVIDIA DSX AI Factory veröffentlicht.
- Meta und NVIDIA verbessern die offene AI-Netzwerkinfrastruktur mit dem NVIDIA Spectrum-X Ethernet SuperNIC und den Innovationen von Spectrum-6.
- Visionbay hat ein 800V DC AI-Fabrikendesign für die Vera Rubin-Ära vorgestellt.
- NVIDIA und Cisco haben das Ultra-Dense Small Form Factor Pluggable (USFP)-Standard angekündigt – das erste Modul der Branche für Netzwerke auf Basis von 400 Gb/s.
- NVIDIA und Google haben die Unterstützung für Falcon Transport auf zukünftigen NVIDIA ConnectX-10 SuperNICs und BlueField DPUs angekündigt.
Vor einem vollen Publikum sprach Ian Buck, Vizepräsident für hyperskalierbares und hochleistungsfähiges Computing bei NVIDIA, darüber, wie die offene Infrastruktur zu einem entscheidenden Bestandteil der Skalierung von AI-Fabriken weltweit wird.
Die Nachrichten bei OCP zeigen, wie die extreme Codesign-Methode von NVIDIA in Kombination mit offenen Standards die Implementierung beschleunigt, die Energieeffizienz verbessert und eine höhere Leistung pro Watt ermöglicht.
Vera Rubin AI Factories voranschreiten durch die Beiträge des MGX Rack beim OCP
NVIDIA hat sich mit Branchenführern zusammengetan, um durch die Open DC-Initiative von OCP zum Referenzdesign eines dritten Generationen-MGX-AI-Datacenter-Systems beizutragen.
In Kombination mit offenen Flüssigkeitskühltechnologien wie MQD und MQDB ermöglicht diese Anstrengung es, bewährte Designs für künstliche Intelligenz in Industriestandards zu verwandeln, die andere übernehmen, herstellen und skalieren können.
Für die NVIDIA Vera Rubin AI-Fabriken erweitert die aktualisierte MGX 1.2-Spezifikation die offene Architektur für AI-Fabriken um Rack-skaliertes blind-mate Flüssigkeitskühlen, interoperable Rack-skaliertes Interkonnektionsinfrastruktur und einen flüssigkühlten 5.000A-Busbar, der für Hochleistungs-AI-Systeme konzipiert ist. Sie fügt außerdem native 19-Zoll-Einrichtungunterstützung und Designs mit höherer Dichte von Racks hinzu.
MGX 1.2 erweitert die Modularität weiter durch konfigurierbare I/O-Bays, fanlose, flüssigkühltätige Rechenplatten, standardisierte Strom- und Kühlanschlüsse sowie eine gemeinsame Infrastruktur, die es Partnern im Ökosystem ermöglicht, interoperable beschleunigte Computing-Plattformen zu entwickeln. Es verbessert die Montage-, Test- und Wartungszeiten, um die Herstellung und den Feldservice zu optimieren und so eine schnellere sowie effizientere Errichtung der Infrastruktur zu ermöglichen. Die Architektur unterstützt Rack-Deploiements bis zu 250kW, während sie die Verfügbarkeit, den Deploiement-Prozess und die Wiederverwendung der Infrastruktur vereinfacht.
Die Designspecifikation des Vera-CPU-Racks erweitert die offene Architektur von NVIDIA MGX über den Bereich des beschleunigten Computings hinaus und bietet eine speziell konzipierte Plattform für die wachsende agentische AI-Era. Während der Vera Rubin NVL72 als Grundlage für großskalige Training und Inferenz dient, ist das NVIDIA Vera-CPU-Rack so konzipiert, dass es Tool-Kommunikation, Orchestrierung und Sandboxed-Execution unterstützt, wodurch AI-Agenten in Echtzeit mit Anwendungen, Daten und Dienstleistungen interagieren können.
Basierend auf der dritten Generation der NVIDIA MGX-Rack-Architektur verwendet das Vera-CPU-Rack dieselben Designprinzipien im Rack-Bereich, die Rechenleistung, Netzwerk, Stromversorgung und Kühlung in eine gemeinsame modulare Plattform zusammenfassen. Dieser Ansatz ermöglicht es Partnern, spezialisierte Infrastruktur zu implementieren, während sie von einem gemeinsamen Ökosystem, vereinfachter Integration und einer konsistenten Grundlage für next-generation AI-Fabriken profitieren.
NVIDIA startet neue Open-Source-Software-Komponenten für die DSX AI Factory
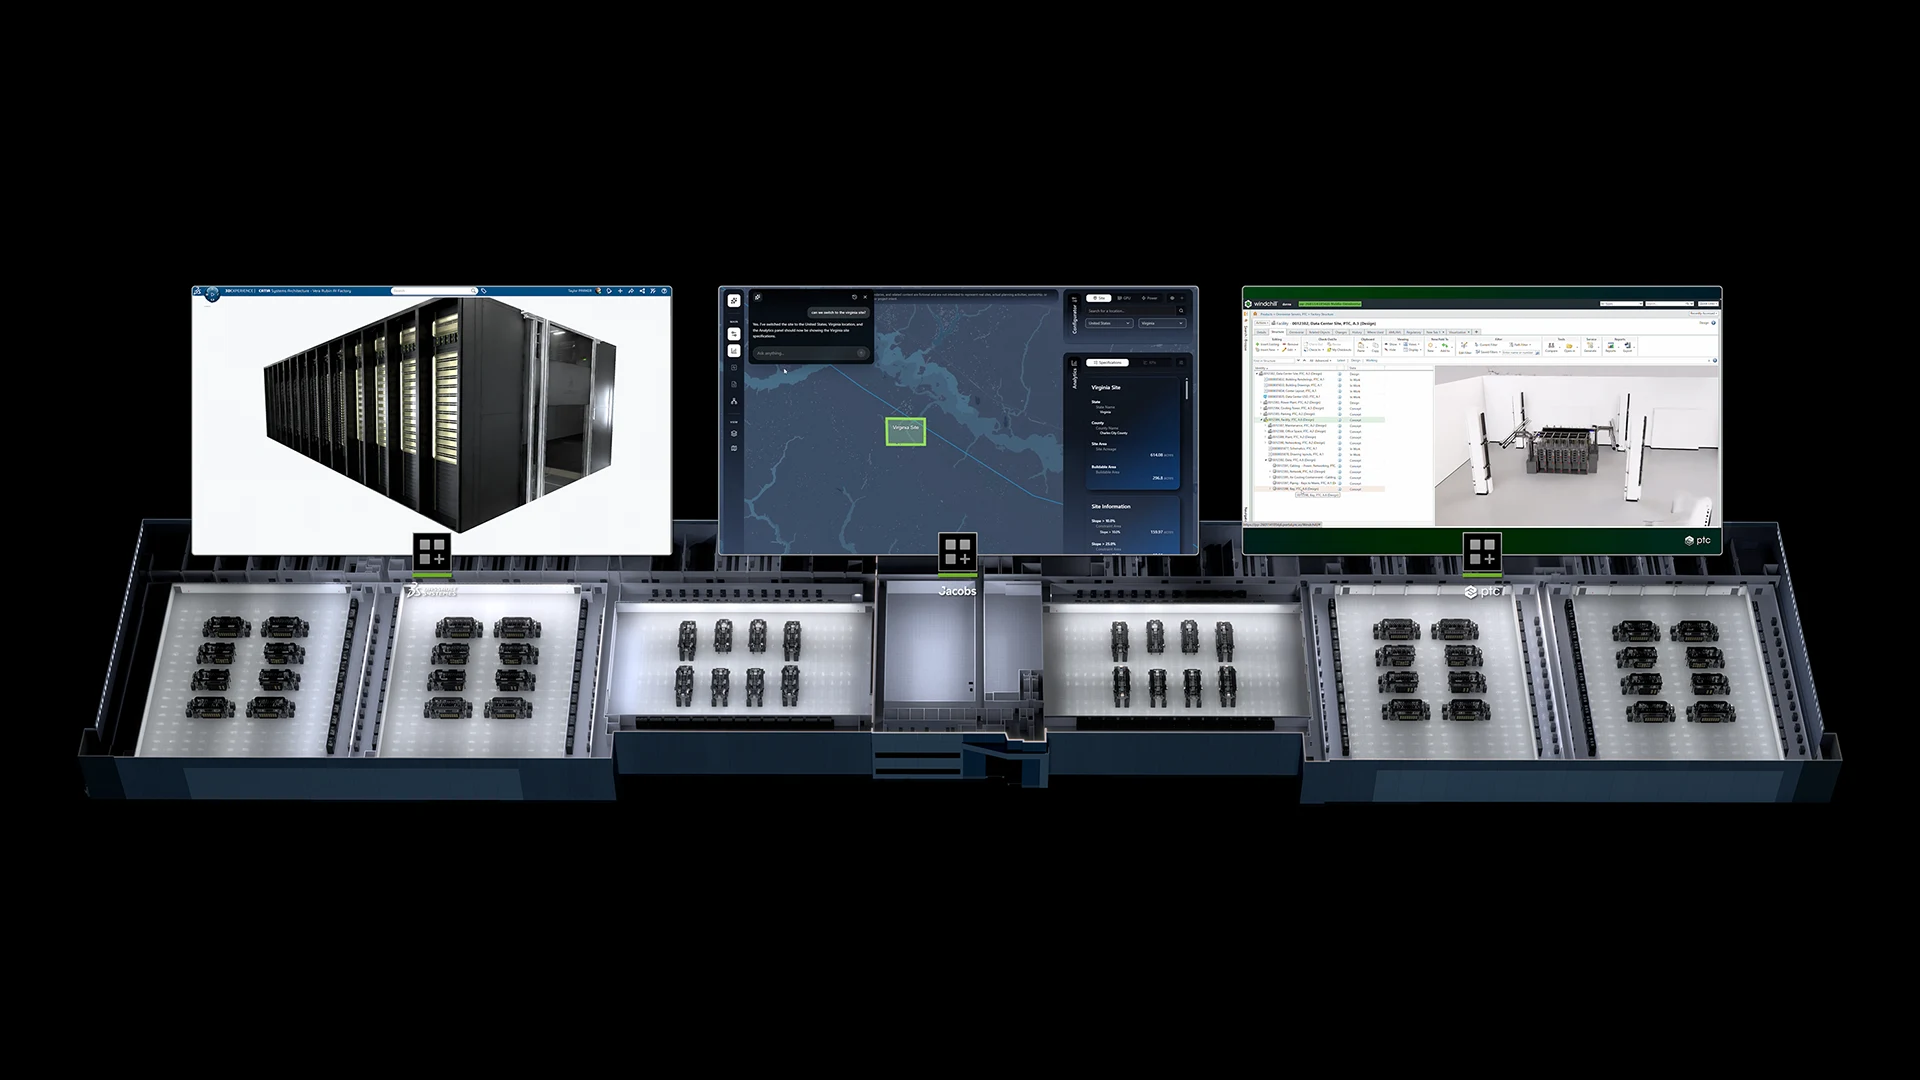
NVIDIA DSX AI-Factory-Plattform führt ein extremes Codesign durch, um Computing, Netzwerk, Stromversorgung, Kühlung, Infrastruktur und Software zu vereinen, wodurch die AI-Fabriken als ein einheitliches optimiertes System funktionieren können und die AI-Leistung innerhalb der verfügbaren Infrastrukturanforderungen maximiert wird. Im Zentrum dieses zusammenhängenden Systems ist das DSX OS, eine offene Betriebsschicht, die die DSX-Architektur in koordinierte, wiederholbare Operationen auf großer Skala umwandelt.
Bei OCP erweiterte NVIDIA das DSX OS mit Open-Source-Komponenten für die Konfiguration von Netzwerken, die Validierung von Clustern, die Verwaltung von Racks und die Bereitstellung von Bare-Metal-Infrastruktur:
- NVIDIA Config Manager: Automatisiert die Konfiguration von Switchs auf Skalierbarem Niveau, sodass Kunden Netzwerkeinheiten einer AI-Fabrik mit konstantem Status durchführen, validieren und pflegen können, ohne jegliche manuelle Einmischung/
- NVIDIA Cluster Readiness Engine: Hilft dabei, kostspielige Job-Crashes zu vermeiden, indem GPU-Clusters mit echten Arbeitslasten simuliert werden, um die Hardware vor dem Beginn des Trainings in guter Verfassung zu halten.
- NVIDIA Rack Management Service: Bietet eine Hardwareabstraktion und Betriebslösungen für Racks, die Racks als erste-Klasse Einheiten behandelt, um die Firmwareverwaltung in der AI-Fabrik auf größere Skalierbarkeit zu bringen.
- Cluster API Provider für den NVIDIA Infrastructure Controller: Beschleunigt die Bereitstellung auf Bare-Metal-Systemen und die Einrichtung von Tenants, sodass Roh-AI-Hardware in wenigen Stunden statt Tagen zu produktionsfähigen Clustern werden kann.
Aus der Erfahrung von NVIDIA bei der Betrieb von NVIDIA DGX Cloud entwickelt ermöglichen diese Open-Source-Komponenten den Cloud-Anbietern und Softwarepartnern, die Fähigkeiten einer AI-Fabrik direkt in ihre multi-tenant Plattformen zu integrieren.
Entwickler können die DSX AI Factory Github-Seite besuchen, um sowohl die neuen als auch die bestehenden Open-Source-Softwarekomponenten der NVIDIA DSX AI Factory-Plattform zu erkunden und dazu beizutragen.
NVIDIA und Hyperscaler veröffentlichen offene Standards für Next-Generation AI-Fabriken
Um die AI-Infrastruktur weltweit skalierbar zu machen, braucht sie mehr als nur fortschrittliches Hardware – es braucht eine gemeinsame Grundlage, auf der die gesamte Industrie aufbauen kann.
Bei OCP hat NVIDIA sich mit AMD, Google und Meta zusammengetan, um eine neue offene Spezifikation zu veröffentlichen, die diese Grundlage bildet. Die Open Data Center Specification v0.7 definiert einen einheitlichen Entwurf für den Entwurf von Fabriken für künftige KI-Systeme – von der Energiearchitektur über die Kühlinfrastruktur bis hin zum physischen Aufbau.
Die OCP Grid Resilience Specification, veröffentlicht von Google, Meta, Microsoft und NVIDIA, legt fest, wie die großflächige AI-Infrastruktur während Störungen des Netzwerksystems verhalten soll: Sie muss verbunden bleiben, automatisch reagieren und innerhalb weniger als zwei Sekunden wieder nahezu vollständig betrieben werden können.
Mit diesen Standards jetzt offen haben die Hersteller weltweit ein gemeinsames Ziel, anzustreben. Gerätehersteller, Colocation-Anbieter und Data-Center-Operatoren können damit beginnen, das Infrastrukturlevel zu entwerfen, herzustellen und bereitzustellen, das die in der Welt entstehenden AI-Fabriken antreibt – ohne auf spezifische Anforderungen einzelner Kunden zu warten.
Da es mit dem NVIDIA DSX-Referenzdesign kompatibel ist, bieten diese Spezifikationen eine validierte, einsetzbare Implementierung beider Spezifikationen – von der Anlageplanung und der Stromarchitektur bis hin zum Softwaremodul, das die Netzsignalen in Echtzeit überwacht und darauf reagiert. Für Betreiber, die Vera Rubin AI-Fabriken errichten, gibt es nun eine direkte Verbindung vom offenen Gemeinschaftsstandard zum laufenden System.
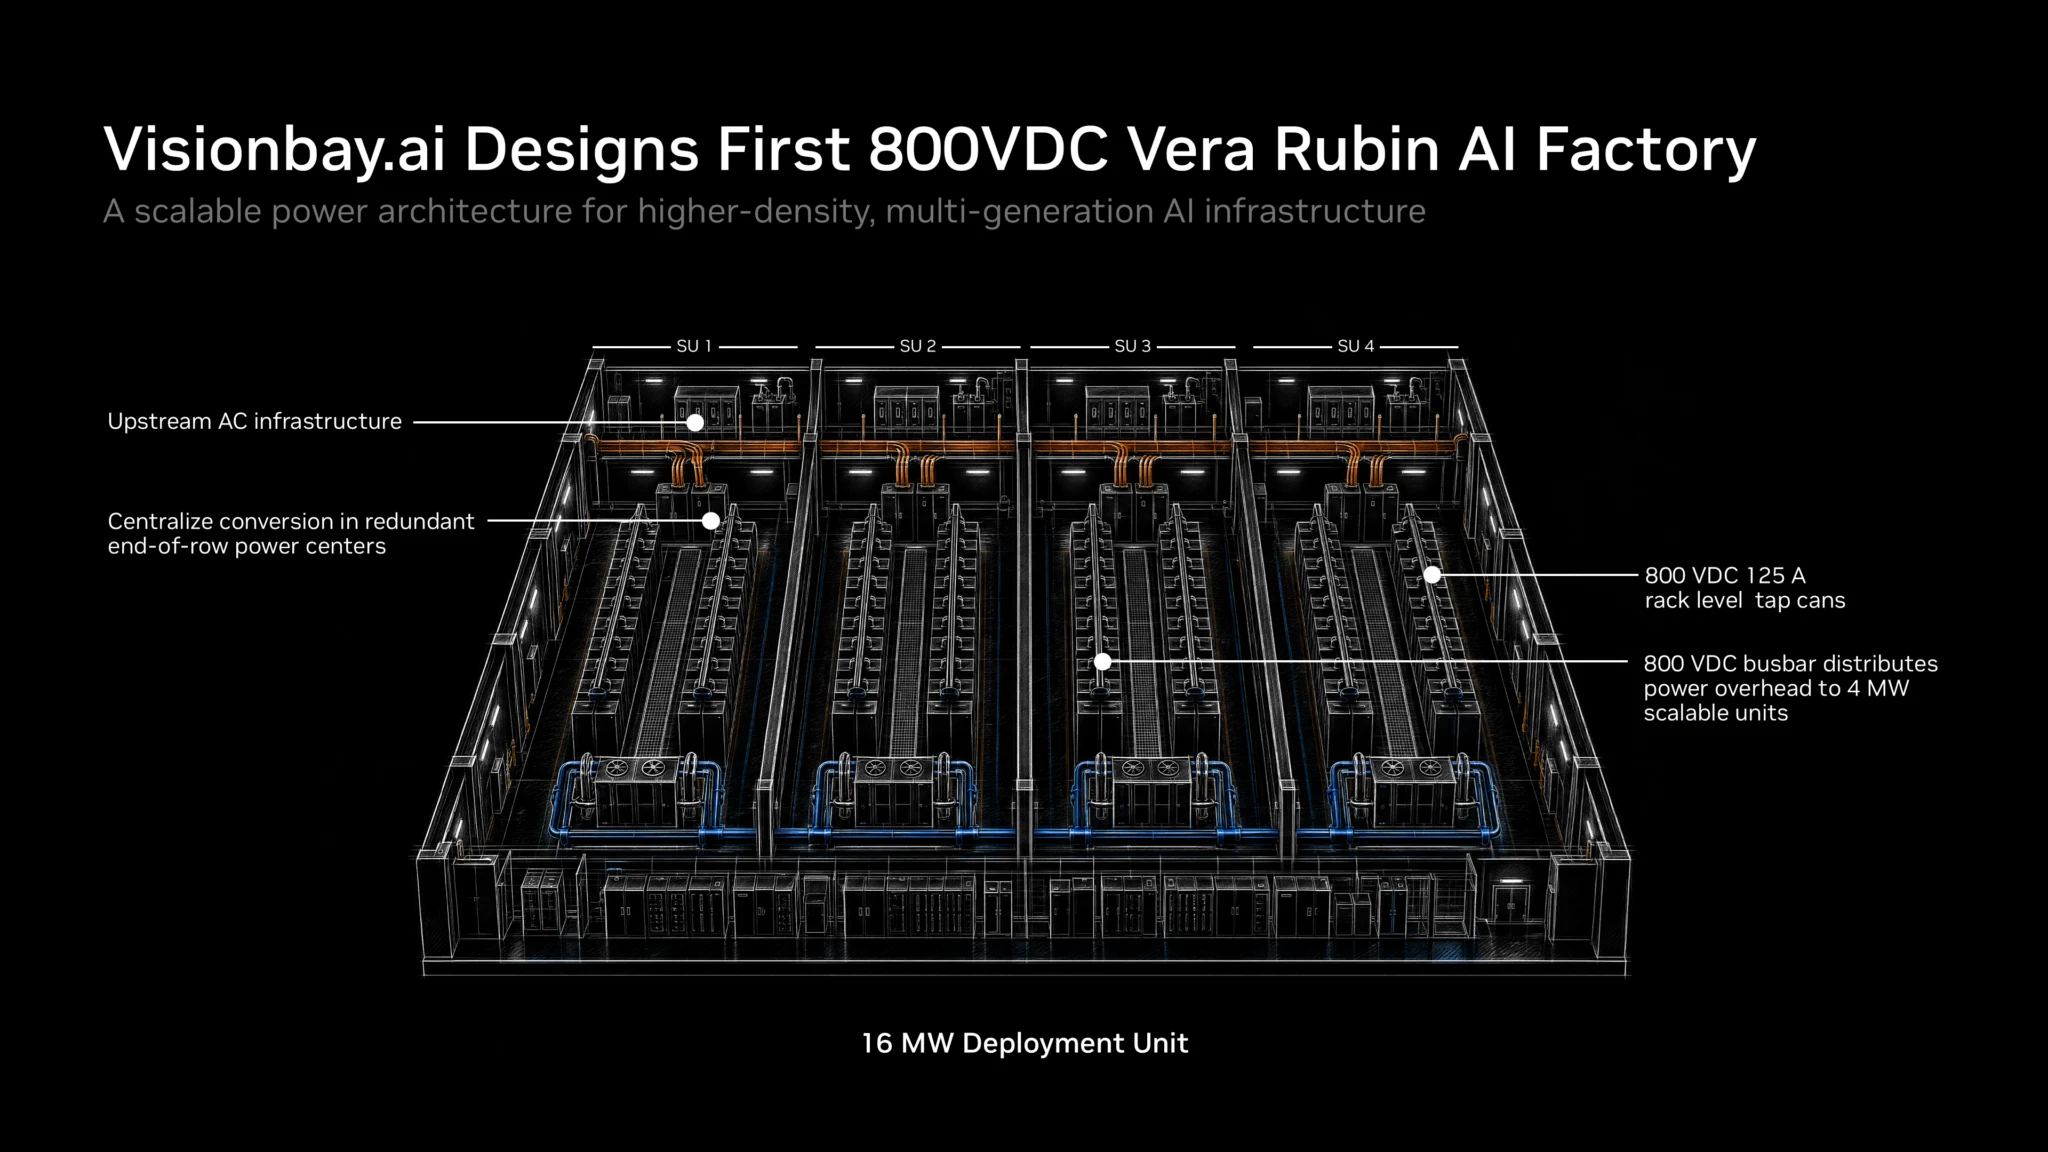
Visionbay.ai entwirft eine 800VDC AI-Fabrik für die Vera Rubin Ära
Wenn die KI-Fabriken größer und leistungsfähiger werden, steht eine Herausforderung vor ihnen allen: Die Bereitstellung ausreichender Energie für die beschleunigten Rechensysteme, die die nächste Generation von KI ermöglichen.
Bei der OCP präsentierte Visionbay Pläne für K-1, eine neuartige AI-Fabrikplattform, die auf der 800 VDC-Architektur basiert und mit zukünftigen NVIDIA Vera Rubin-Implementierungen in Betracht gezogen wird. Das Projekt kombiniert NVIDIOS 800 VDC-Referenzarchitektur mit Energie- und thermischen Technologien von Vertiv, um eine skalierbare Grundlage für eine hochdichte AI-Infrastruktur zu schaffen.
Das Design adressiert eine wachsende Branchenherausforderung. Da die Arbeitslasten für die Trainierung, Inferenz und Rechenschaftsleistungen von KI zunehmen, steigen auch die Leistungsdichten in den Racks weiter an. Die traditionelle niedrigspannige Stromverteilung wird immer schwieriger zu skalieren, was mehr Kupfer, mehr Kabel und mehr Stromumwandlungsausrüstung erfordert.
Durch die Anwendung der 800 VDC-Architektur von NVIDIA schafft das K-1 einen Weg zu einer höheren Dichte der AI-Infrastruktur, während die Flexibilität für bestehende Implementierungen erhalten bleibt. Anstatt eine vollständige Umstellung am ersten Tag zu erfordern, ist die Plattform so konzipiert, dass die Verteilung von 800 VDC schrittweise eingeleitet wird, wo sie den größten Nutzen bringt, und hilft den Betreibern, sich auf zukünftige Generationen des beschleunigten Computing vorzubereiten, ohne eine umfassende Umgestaltung der Anlagen zu erfordern.
Die Architektur ist nach dem Prinzip von Cluster-Ebene-Energiezentren gestaltet, die die AC-zu-DC-Umwandlung zentralisieren und 800 VDC näher an die Rechenressourcen verteilen. Dieser Ansatz vereinfacht die Energiezufuhr nach unten, unterstützt eine modulare Erweiterung und schafft wiederholbare Bausteine für die zukünftige Wachstumsphase der AI-Fabrik.
K-1 spiegelt auch die Systemebene-Designphilosophie hinter den NVIDIA AI-Fabriken wider, bei der Leistung, Kühlung und Rechenleistung gemeinsam entwickelt werden. Mit Unterstützung für eine flüssigkühelte Infrastruktur, skalierbare Stromverteilung und zukünftige Vera Rubin-Klasse-Implementierungen zeigt das Projekt, wie Ökosystem-Partner die Architektur der NVIDIA AI-Fabrik in eine einsetzbare Infrastruktur umwandeln, die für die nächste Ära des beschleunigten Rechnens geeignet ist.
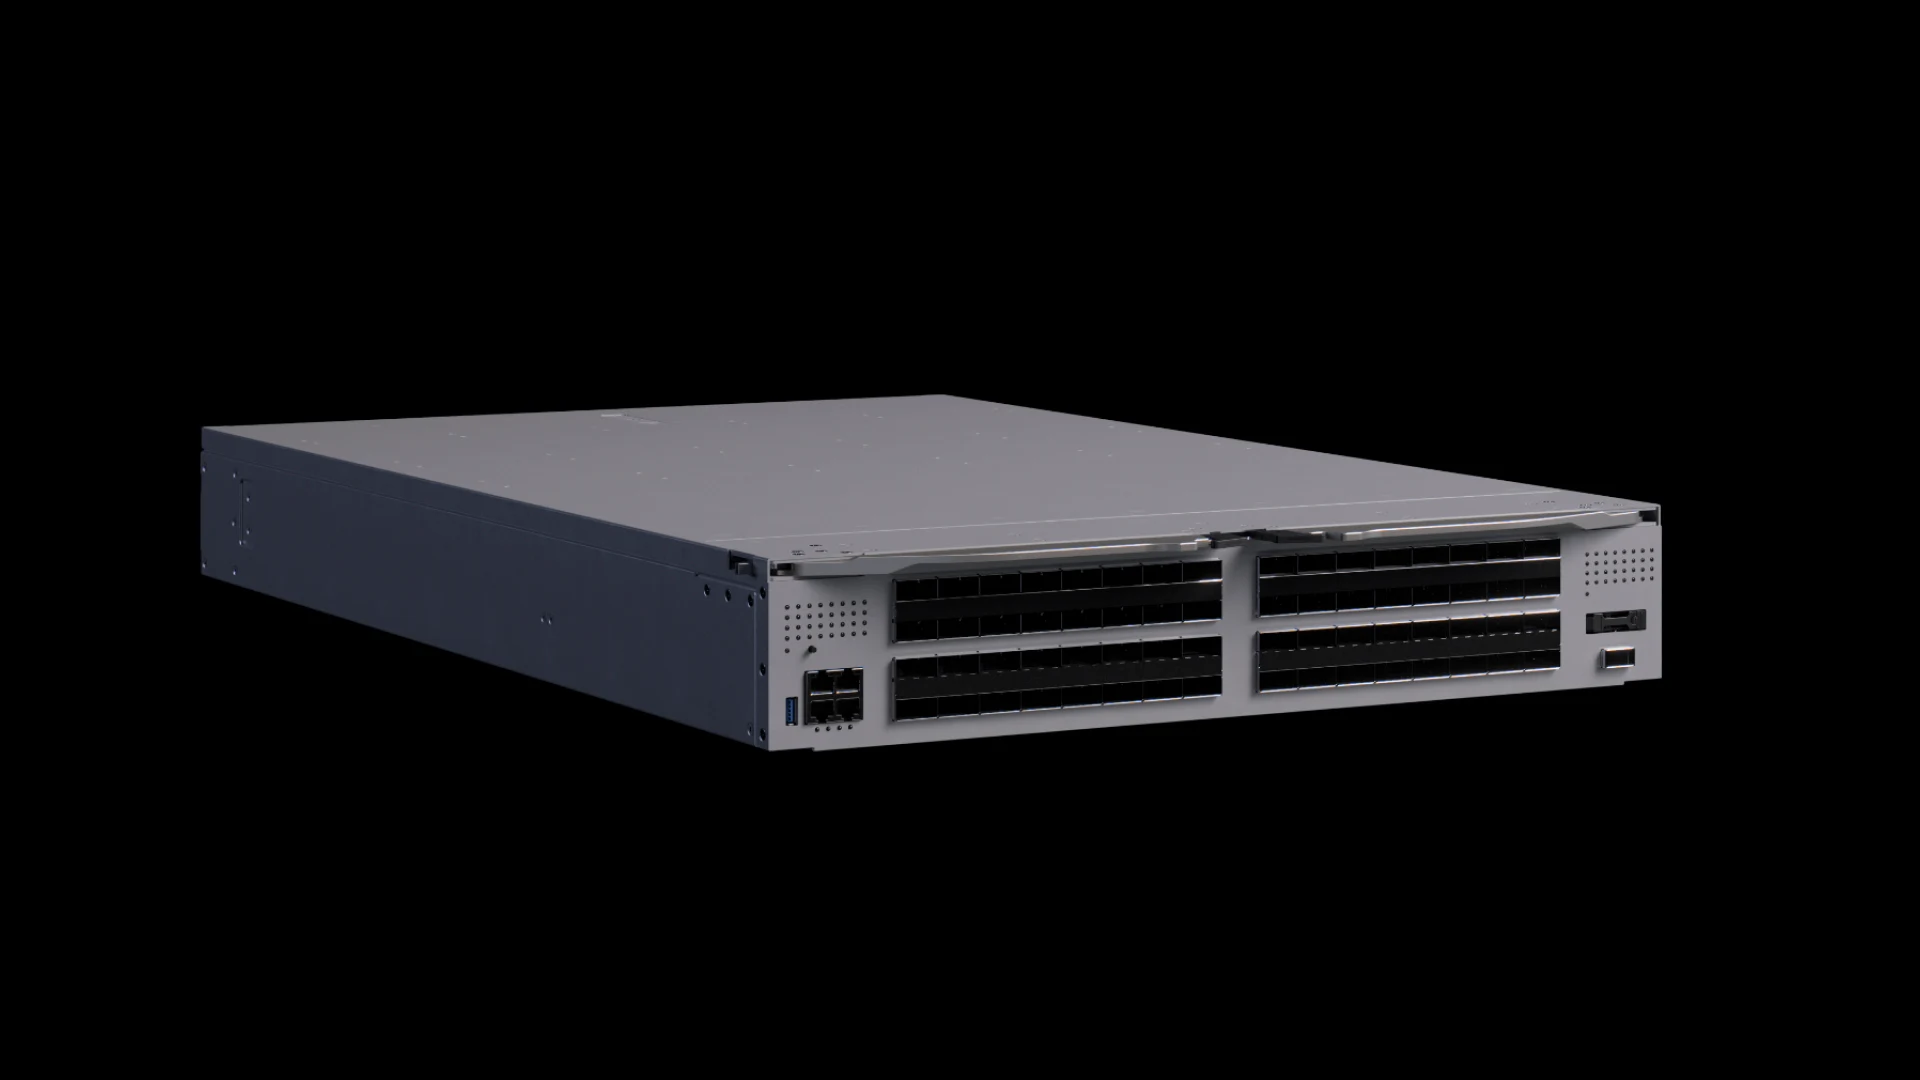
Meta und NVIDIA Advance AI Networking mit Spectrum-6 und Multiplane-Technologie
Bei der Veranstaltung gaben Meta und NVIDIA bekannt, dass Meta die NVIDIA Spectrum-6 102,4 Tb/s Ethernet-Schalter einsetzen wird, um auf offener Netzwerkinfrastruktur größere, leistungsstarke NVIDIA Vera Rubin AI-Fabriken zu errichten.
Das Spectrum-6 bietet die doppelte Schaltkapazität und die Bandbreite pro Leitung des Spectrum-4 sowie eine verlustfreie Ethernet-AI-Fabrik mit 200 Gbps pro Leitung, mit einer hohen effektiven Bandbreite und Isolierung der Leistung, sodass das Traffic eines Jobs nicht den des anderen beeinträchtigt.
Metas Switch basierend auf Spectrum-6, N-IceCube, passt in den IcePack, Metas 100T, flüssigkühlten Rack. N-IceCube nutzt das Facebook Open Switching System (FBOSS), Metas Open-Source-Netzwerkbetriebssystem, das dazu beiträgt, dass OCP eine effiziente Netzwerkinfrastruktur auf hyperskaler Ebene unterstützt.
FBOSS wird auf der Switch Abstraction Interface basieren, einem OCP-Standard, den NVIDIA unterstützt hat, und bietet eine unabhängige Methode zur Steuerung von Switch-Hardware. Gemeinsam unterstützen diese Technologien Agentic-AI-Fabriken mit mehr als 100.000 GPUs, die massive mixture-of-experts-Modelle trainieren und bereitstellen.
Die Ankündigung markiert den nächsten Schritt in einer Kooperation, die die Erfahrung von Meta im Betrieb von KI-Infrastrukturen auf hyperskalischem Niveau mit Nvidias Netzwerktechologie verbindet.
Im Kern dieser Zusammenarbeit liegt die Spectrum-X Multiplane-Technologie, die durch die Spectrum-6-Schalter und die ConnectX-9 SuperNICs ermöglicht wird. Multiplane verteilt den GPU-Verkehr in Hardware auf bis zu acht unabhängige Netzwerkpläne, sodass AI-Fabriken mit mehr als 100.000 GPUs skalieren können, ohne eine größere Anzahl an Schaltern und niedrigere Infrastrukturkosten erforderlich zu haben. Mehrere Wege zwischen GPUs verbessern die Netzwerkinfrastruktur und die Resilienz: Wenn ein Komponenten fehlt, wird der Verkehr auf die verbleibenden Pläne umgeleitet, sodass die GPUs weiterhin produktiv sind und AI-Anwendungen laufen, auch bei reduzierter Bandbreite.
Meta und NVIDIA arbeiteten zusammen, um diese Resilienz durch die Bereitstellungserfahrung und die schnelle technische Iteration zu stärken. Die Teams bestätigten die Verbesserungen in aufbereiteten und Cloud-Umgebungen.
„Wir sind begeistert von unserer engen Partnerschaft mit NVIDIA, die es ermöglicht, Multiplan-Fabriken operativ skalierbar und leistungsfähig zu machen – eine wichtige Voraussetzung sowohl für unsere eigenen Infrastrukturbautungen als auch für unsere gemeinsamen Cloud-Partner“, sagte Omar Baldonado, Senior Director für Data Center und AI-Netzwerke bei Meta. „Die Erweiterung von FBOSS auf Spectrum-ASICs bedeutet, dass wir denselben Softwarestack über alle unsere Fabriken anwenden können. Meta’s neuer Spectrum-basierter Switch, N-IceCube, bringt diese Funktion in Icepack – unseren flüssigkühlen 102,4T-Netzwerkrahmen für Skalierung, der die kommenden Generationen von Acceleratoren in unserer Flotte verbindet.“
Zusammen entwickeln Meta und NVIDIA eine Architektur sowie ein Betriebshandbuch, das andere AI-Infrastrukturdienstleister übernehmen können. Dadurch werden die Lehren aus anspruchsvollen Produktionslasten in skalierbarere, widerstandsfähigere und effizientere AI-Fabriken umgewandelt.
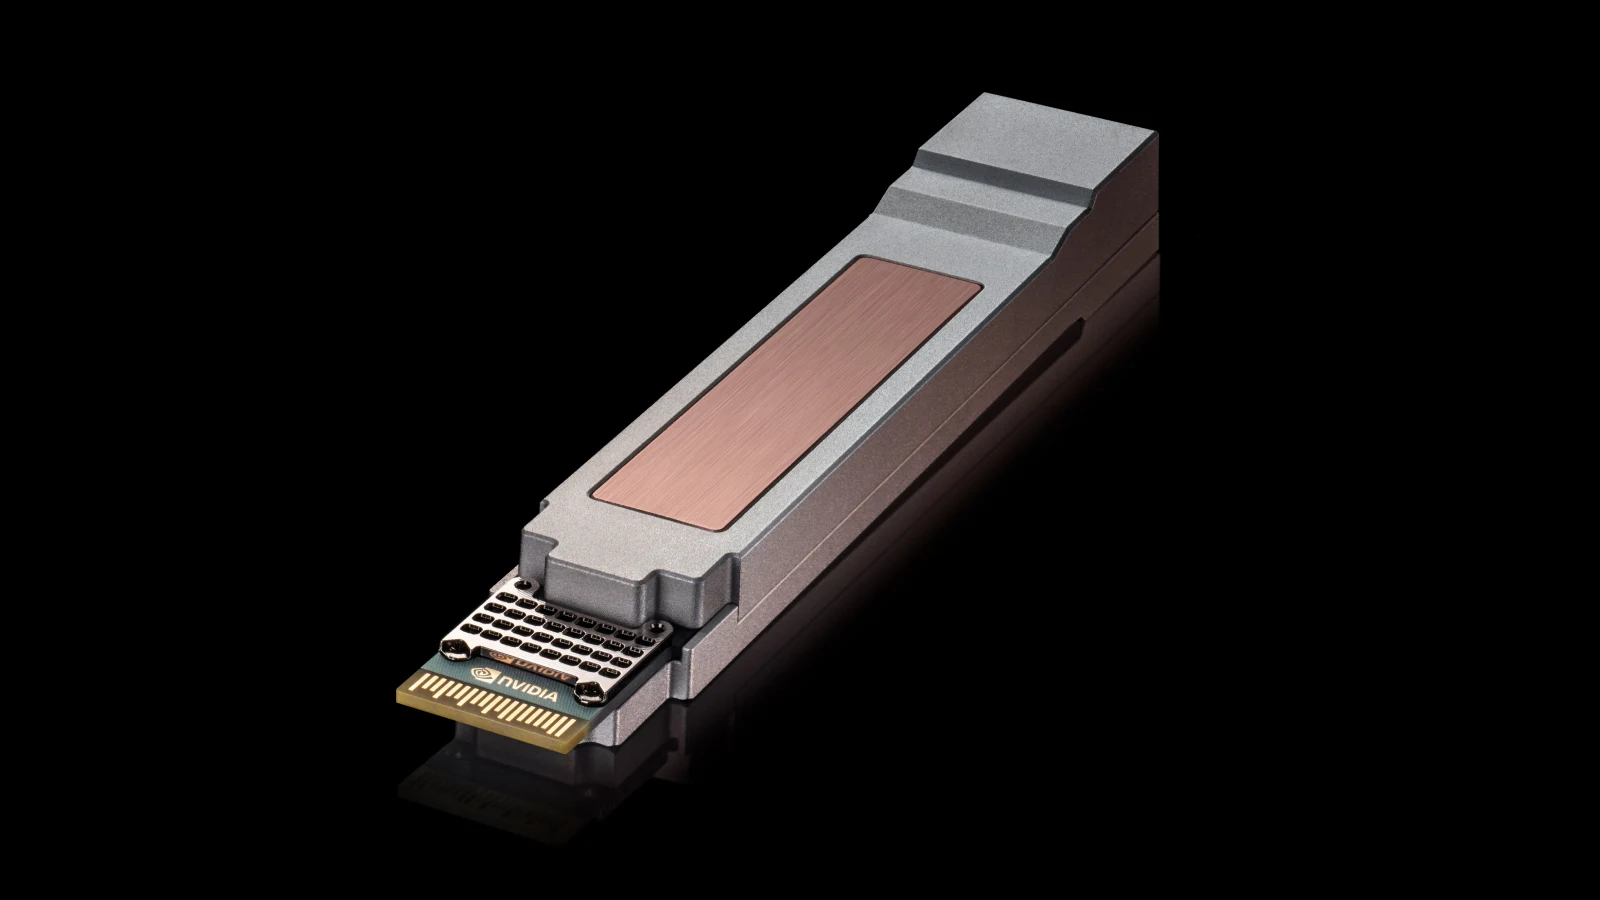
Mit USFP, NVIDIA und Cisco erneuern sie platzbaren Optiken für die Skalierung von AI-Fabriken
Da die KI-Fabriken wachsen, um größere Modelle und eine steigende Anforderung an die Inferenz zu unterstützen, muss jeder Komponente der Infrastruktur-Stack mehr Leistung, Effizienz und Einfachheit bieten – sogar die Netzwerkverbindung selbst.
Bei OCP haben NVIDIA und Cisco Pläne für USFP bekanntgegeben, ein neuer optischer, platzierbarer Transceiver-Modulformfaktor, der dazu dient, die Hersteller von KI-Fabriken die Erstellung von nächste Generationen-KI-Technologien zu erleichtern, während gleichzeitig die Bandbreitendichte und die Energieeffizienz verbessert werden.
Mit etwa dem gleichen Platzbedarf wie das weit verbreitete OSFP-Formfaktor mit 200 Gbit/s pro Leitung wird der USFP einen Weg zu einer Netzwerkinfrastruktur mit 400 Gbit/s pro Leitung bieten und das auf Transceiver basierte Einsatzmodell, das bereits in Generationen von Data-Center-Netzwerken bewährt wurde, erweitern. Durch die Integration von 16 vollduplex-Leitungen mit der Planung, auf 32 Leitungen zu erweitern, wird der USFP eine viermal höhere Bandbreitendichte als die traditionellen 200 Gbit/s-pro-Leitung-platzbaren Optiken bieten.
Das Ergebnis ist die Möglichkeit, mehr Rechenressourcen zu verbinden, ohne Netzwerk-Ebenen hinzuzufügen, die Latenz, Stromverbrauch und Komplexität erhöhen könnten.
Das neue Formfaktor ist für die Anforderungen an Größe und Effizienz der nächsten Generation von AI-Fabriken entwickelt. Es unterstützt höhere Bandbreiten und bewahrt gleichzeitig die Flexibilität und Servicefähigkeit, die es ermöglichen, Pluggable-Optiken als Standard in modernen Datenzentren zu verwenden. Zudem wird eine etwa 1,3-fache höhere Energieeffizienz erreicht, wodurch Betreiber mehr Daten mit weniger Energie transportieren können.
Um das offene Ökosystem zu fördern, arbeiten NVIDIA und Cisco mit TE Connectivity und Amphenol an Käfigen, Verbindern und Modulen. Es ist geplant, USFP durch einen von der Gemeinschaft geleiteten, mehrquerschnittlichen Ansatz voranzubringen. Gemeinsam bauen die Unternehmen die Grundlage für eine skalierbarere, effizientere und interoperablere AI-Fabriknetzwerksysteme.
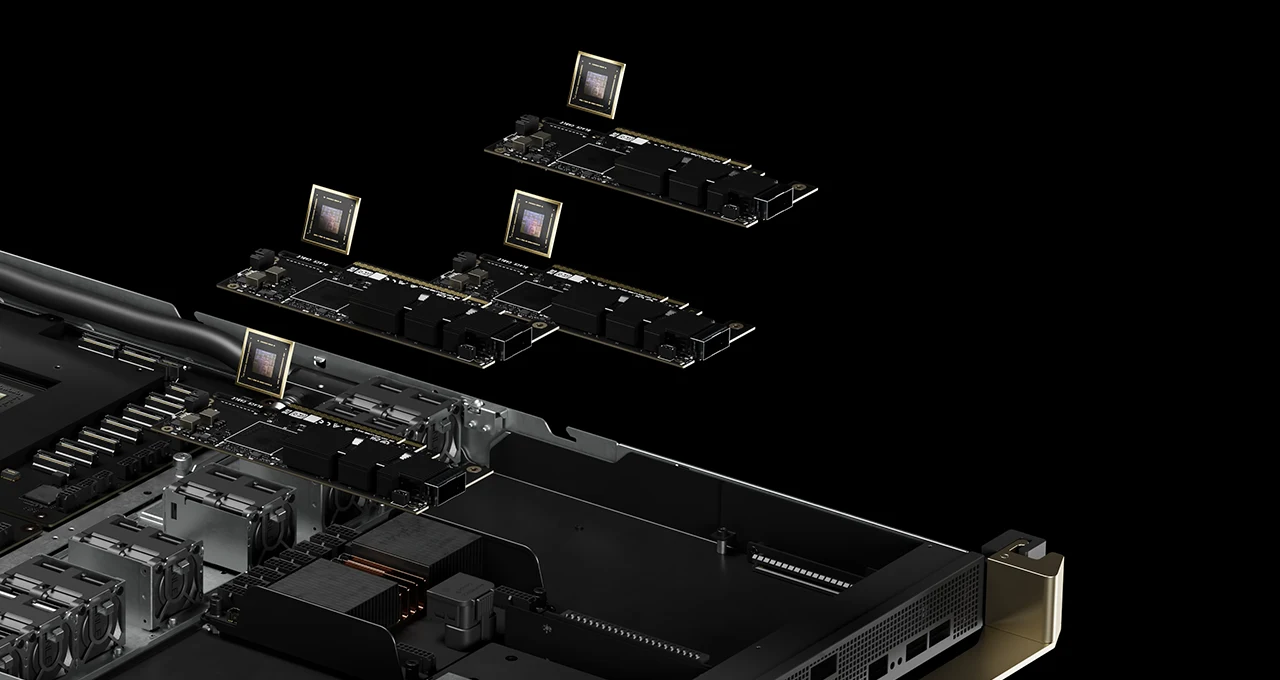
Google Falcon Transport unterstützt NVIDIA ConnectX-10 für interoperable KI-Netzwerke
NVIDIA und Google haben außerdem die Unterstützung für Falcon Transport bei zukünftigen NVIDIA ConnectX-10 SuperNICs und BlueField DPUs angekündigt, um die NetzwerkEffizienz für großskalige AI-Infrastrukturen zu verbessern.
Falcon ist ein Transportprotokoll, das dazu gedacht ist, Daten zuverlässig über Ethernet-Netzwerke zu übertragen, wodurch sonst bei Konflikten Pakete verloren gehen könnten. Es unterstützt AI- und Speicherlasten durch Multipath-Load-Balancing, programmierbaren Konfliktkontrollmechanismen, Hardware-Verlustwiederherstellung und Sicherheit pro-Verbindung.
Diese Zusammenarbeit kombiniert die Hardware-Ausführung von NVIDIA mit dem DOCA-Softwaremodul, um Falcon zu implementieren und das NVIDIA-Netzwerk auf das Transportsystem des Google-Data Centers auszuweiten. Die NVIDIA- und Google-NICs können über ein gemeinsames Transportsystem kommunizieren, während die Anwendungen die standardmäßigen RDMA-Programmierschnittstellen beibehalten.
Durch die Verteilung des Traffic auf verschiedene Pfade, die Anpassung an die Congestion, die Wiederherstellung von verlorenen Paketen und die Sicherung der Verbindungen hilft Falcon den Arbeitslasten, das verfügbare Bandbreite besser zu nutzen und ein vorhersagbares Performanceniveau bei der Skalierung der Ethernet-Netzwerke zu erhalten.
Erfahren Sie mehr, indem Sie an der Teilnahme teilnehmenNVIDIA bei OCP.