
Von Mengyao aus dem凹非寺
QbitAI | Öffentlicher Account QbitAI
Unglaublich,ByteDancehat jetzt die KI-Generierung direkt zur Open World gemacht?!
Schau mal: Man gibt nur einen Satz ein, und die KI erzeugt aus dem Nichts ein Zimmer aus der Perspektive einer Miniatur-Figur~
Direkt danach können wir mit wilder Tastatur-Maus-Bedienung auf einem Papierflieger in der Cyber-Weltfrei fliegen– wohin auch immer wir wollen:
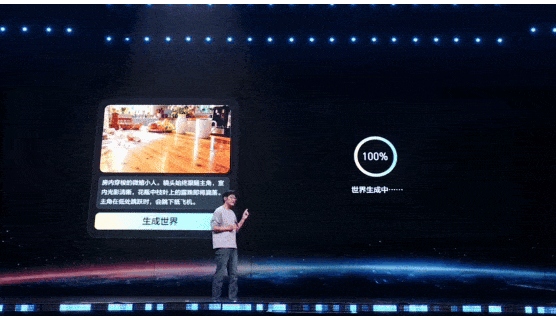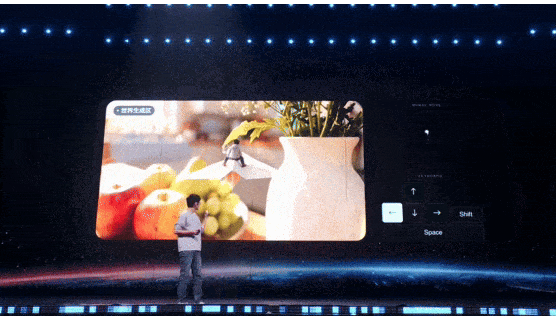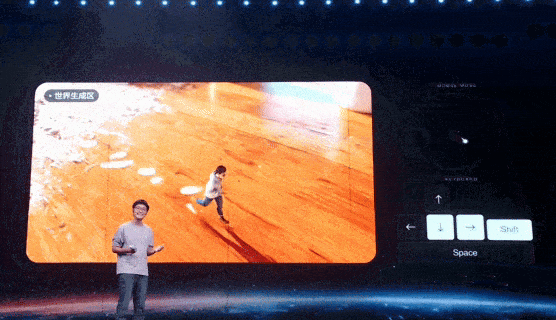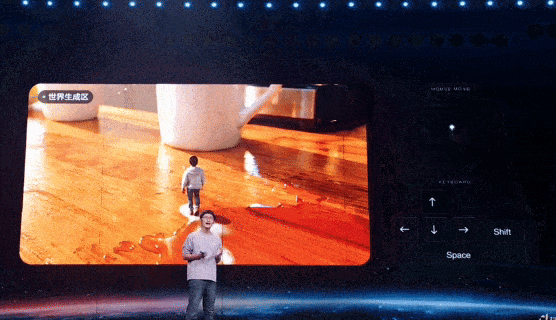
Damit nicht genug: In dieser von KI generierten Welt können wir sogar die Dinge vor unseren Augen nach Belieben erschaffen!
Du willst einen Löffel? Wir formen ihn einfach aus dem Nichts, und sogar…
wir können mit dem Löffelinteragierenund aus dem alltäglichen Besteck eine große Kletterarena machen——
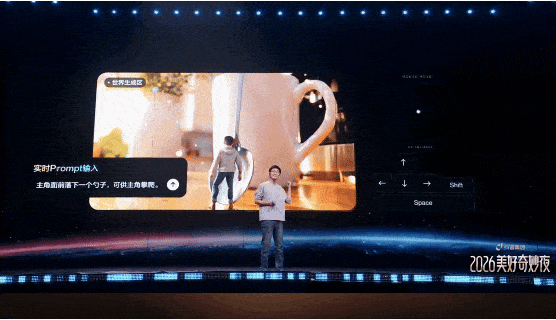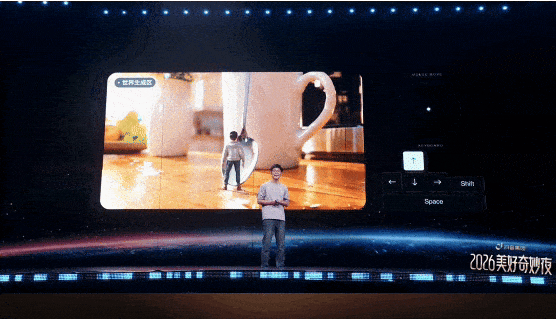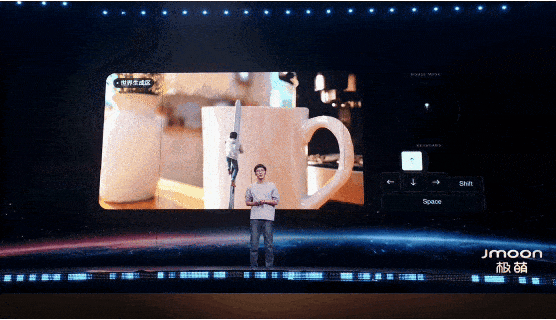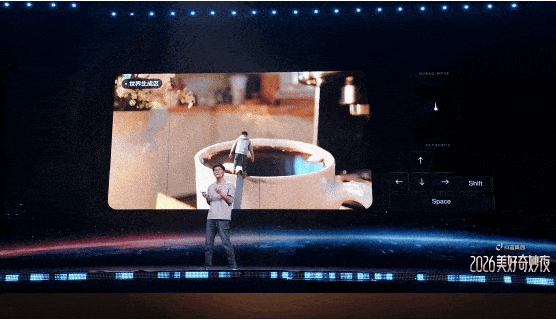
Natürlich kann diese Welt noch viel mehr.
Dank derbeliebigen Tür-Funktion können sogar zwei völlig zusammenhanglose Szenen direkt miteinander verbunden werden.
In der einen Sekunde noch im Zimmer, in der nächsten öffnet man die Tür und steht im Weltraum?!
Diese so magische Szene gab es gerade bei der gerade zu Ende gegangenenTechnologiesendung „2026 Wunderbare Nacht des Guten“ der Douyin Groupzu sehen; der Vorführende war Tim von 影视飓风 (MediaStorm).
Noch erwähnenswerter ist, dass hinter dieser Abfolge von Operationen, die man als cybernetische Weltschöpfung bezeichnen kann, genau dasWeltmodellsteht, das ByteDance die ganze Zeit still erforscht hat. (Schock.jpg)Zwar ist das Modell noch nicht offiziell veröffentlicht worden, doch aus der Präsentation vor Ort geht bereits hervor, dass esdreidimensionale Szenenerzeugung, freie Erkundung, Echtzeit-Interaktion, Objektbearbeitung
zeigt,.Sogar die Fähigkeit, zwischen verschiedenen Räumenfrei zu verbinden~
Diesmal nutzte Byte die Live-Präsentation in der Sendung, um dem hauseigenen World Model einen überraschenden„Erstauftritt“zu verschaffen – ein echtes Vorab-Zeigen der Muskeln.
Man kann schon ein bisschen nostalgisch werden: In den letzten Jahren, von Fei-Fei Lis World Labs über Googles DeepMind Genie bis zu Nvidias Cosmos.
Eine ganze Reihe von Tech-Riesen ist ebenfalls in den Markt eingestiegen und versucht, KI ein besseres Verständnis räumlicher Strukturen, die Simulation realer Gesetzmäßigkeiten und sogar die Vorhersage, wie sich die Umwelt durch menschliches Handeln verändert, beizubringen.
Heutzutage formt die KI die Welten aus Science-Fiction-Filmen in die Realität.
Vom Zeichnen einer Welt bis dazu, eine ganze Welt zum „Leben“ zu erwecken
Ich vermute, die Leute, die in früheren Jahren als Erste mit AIGC experimentiert haben, hätten wohl kaum gedacht –
dass eines Tages KI-generierte Videos zu einer dreidimensionalen Cyber-Welt werden könnten, in die man hineingehen, die Interaktion unterstützt und die sich flexibel bearbeiten lässt.
Ich habe kurz nachgezählt: Seit Jahresbeginn bis jetzt habe ich etwa sechs bis sieben World-Model-Produkte selbst ausprobiert...
Was die beeindruckende Wirkung betrifft: nicht schlechter, als würde man am Vortag noch „Interstellar“ schauen und am nächsten Tag feststellen, dass man durch die Leinwand gehen und nebenbei ein Schwarzes Loch ins eigene Wohnzimmer transportieren kann.
Wie also kann KI von der Bild- und Videoerzeugung so reibungslos zum „Serverwechsel“ ins Weltenbauen übergehen?!
Diese Geschichte muss bei einer technischen Schwachstelle der traditionellen multimodalen Generierung beginnen. (doge)
Heutzutage haben World Models mehrere technische Lösungswege hervorgebracht – von abstrakter Zustandsvorhersage über physikalische Kausalmodellierung bis hin zu generativen 3D-Welten –, jeder mit seinem eigenen Schwerpunkt.
Worum es uns hier hauptsächlich gehen soll, ist ein Weg, der mit multimodaler Generierung und räumlicher Intelligenz zusammenhängt:
die KI die räumlichen Strukturen und Veränderungsgesetze der realen Welt lernen zu lassen, um dadurch eine dreidimensionale Welt zu generieren, zu rekonstruieren und zu simulieren, die kontinuierlich erkundet und in Echtzeit interaktiv erlebt werden kann.
Wichtig anzumerken ist, dass es hier zwei Schlüsselbegriffe gibt:räumliche StruktursowieVeränderungsgesetze。
Und diese beiden Fähigkeiten treffen genau auf eine grundlegende Herausforderung, die die visuelle Generierungstechnologie in den vergangenen Jahren noch nicht vollständig gelöst hat.
△KI-generiert
2024 veröffentlichte OpenAI Sora, und die beeindruckenden generierten Videos versetzten das gesamte Netz samt Sam Altman in staunende Benommenheit.
Aber verglichen mit den damals überall übertragenden Videos lohnt es sich heute eher, die technischen Berichte, die OpenAI im selben Zeitraum veröffentlicht hat, genauer zu betrachten –
„Video generation models as world simulators“, wörtlich übersetzt heißt das:„Videogenerierungsmodelle als Weltsimulatoren“。
Damals stellte OpenAI fest, dass Videogenerierungsmodelle mit zunehmender Größe eine gewisse dreidimensionale Konsistenz und Objektpersistenz entwickeln und sogar einfache Umweltinteraktionen simulieren können.
Das Peinliche daran ist jedoch: Ein Modell, das realistische Weltbilder erzeugen kann, hat möglicherweise trotzdem Schwierigkeiten mit selbst den grundlegendsten „physikalischen Beziehungen“.
So kann Sora beispielsweise eine Szene generieren, in der eine Person auf einem Laufband rennt – Figur, Licht und Schatten sowie Kameraführung sehen durchaus überzeugend aus.
Doch bei genauerem Hinsehen entspricht das Bewegungsverhältnis zwischen der Person und dem Laufband keineswegs unbedingt der physikalischen Logik der Realität – das Bild wirkt sehr realistisch, die physikalischen Gesetze bleiben aber eher dem Zufall überlassen??
△Bildquelle: Offizielle OpenAI-Website
Hinter all dem verbirgt sich eigentlich ein recht grundlegendes Problem traditioneller visueller Generierungstechnologien.
In den vergangenen Jahren haben führende Bild- und Videomodelle – ob Diffusionsmodelle oder auf Transformer basierende Generierungsarchitekturen – hauptsächlich darauf gesetzt, aus riesigen Mengen visueller Datenstatistische Musterzu lernen, um Bilder zu erzeugen, die den Eingabebedingungen entsprechen.
Diese Methode war äußerst erfolgreich und kann mittlerweile sogar implizit einen Teil der dreidimensionalen Geometrie, Objektbeziehungen und physikalischen Gesetze erlernen.
Aberräumlich-zeitliche Kontinuität im visuellen Eindruck entspricht nicht notwendigerweise einem stabilen, durch externe Aktionen beeinflussbaren Weltzustand——
Ein Beispiel: Ein Glas in einem Video durchgehend mit gleichem Aussehen darzustellen, ist für heutige Generierungsmodelle bereits relativ einfach.
Doch wenn es aufgehoben, abgestellt oder gar vom Tischrand geschoben wird, muss das Modell kontinuierlich räumliche Positionen, Objektbeziehungen und Zustandsänderungen verfolgen sowie physikalische Folgen wie Kollisionen und Stürze vorhersagen.
Mit anderen Worten: Zwischen der Generierung eines physikalisch plausiblen Videos und der zuverlässigen Vorhersage von durch Aktionen verursachten Umweltveränderungen liegt noch immer das Problem der Weltzustandsmodellierung.
Und genau hier liegen die Stärken von Weltmodellen.
Im Juni dieses Jahres veröffentlichte das Team von Fei-Fei Li einen Artikel mit dem Titel „A Functional Taxonomy of World Models“.
Der Artikel unterteilt Weltmodelle aus funktionaler Sicht in drei Typen und liefert damit eine klarere Erklärung dafür, welche „echten Fähigkeiten“ Weltmodelle tatsächlich besitzen –
- Renderer: verantwortlich dafür, wie die Weltaussieht, Ausgabe menschenorientierter visueller Bilder, Kernziel sind Bildrealismus und visuelle Ausdruckskraft.
- Simulator: verantwortlich dafür, wie die Welttatsächlichbeschaffen ist, Aufrechterhaltung szenerienkonformer Zustände gemäß Geometrie und physikalischer Kausalität.
- Planer: verantwortlich dafür, wie ein Agent als Nächsteshandeltund gibt auf Grundlage des aktuellen Weltzustands und der festgelegten Ziele sinnvolle Aktionen aus.
Der interessante Aspekt dieser Einteilung liegt darin, dass sie genau erklärt, warum wir uns trotz der Tatsache, dass KI bereits Videos erzeugen kann, die zum Verwechseln echt aussehen, trotzdem so viel Mühe mit der Erforschung von Weltmodellen geben.
Von der Erzeugung fotorealistischer visueller Szenen über die Aufrechterhaltung physikalisch konsistenter Umgebungszustände bis hin zur Unterstützung autonomer Entscheidungen und Handlungen von Agenten –
Die dahinterstehenden Fähigkeiten zur räumlichen Repräsentation, dynamischen Vorhersage und Handlungsplanung sind genau die technischen Herausforderungen, die traditionelle multimodale Generierungsmodelle noch nicht ausreichend gelöst haben.
Doch heute werden diese in den Papieren beschriebenen, ziemlich unerreichbar erscheinenden Konzepte von Weltmodellen bereits Stück für Stück von der KI „zusammengebastelt“.
△ Bildquelle: Artikel „A Functional Taxonomy of World Models“
Nehmen wir zum BeispielDouyin Group „Die wundersame Nacht des Guten 2026“Zum Beispiel jene Cyber-Schöpfungsaktion in einer Technologie-Sendung, die auf einem KI-Modell von ByteDance basierte.
Bilder allein anhand eines Satzes zu generieren, ist heutzutage längst nichts Besonderes mehr.
Doch wenn man tatsächlich in diese KI-generierte Szene eintritt, in der man sich frei bewegen kann, muss das Modell nicht mehr nur das vorliegende Bild erzeugen, sondern die räumliche Struktur der gesamten Szene aufrechterhalten.
Unabhängig davon, in welche Richtung sich eine Person bewegt oder aus welchem Blickwinkel sie die Szene betrachtet, müssen das Gelände, die Objekte und deren relative Positionen in der Szene eine ausreichende geometrische Konsistenz bewahren.
Was dahintersteckt, ist genau das der WeltmodelleRäumliche Repräsentationsfähigkeitund auch die Grundlage dafür, dass eine KI-generierte Szene wiederholtes Erkunden wirklich standhält.
Wenn man einen Löffel möchte, kann die KI ihn aus dem Nichts generieren – und der Löffel kann sogar daran entlanggeklettert werden, mit Echtzeit-Bewegungsinteraktion.
Diese scheinbar einfachen Handgriffe bergen dahinter die WeltmodelleSofortige Generierung, Umweltzustandsmodellierung und dynamische Prognosefähigkeiten——
Das Modell muss auf Basis der Nutzeraktionen Objekte und räumliche Beziehungen in der Szene in Echtzeit aktualisieren, kontinuierlich die durch Handlungen ausgelösten Umweltveränderungen vorhersagen und die Konsistenz der Zustände vor und nach der Aktion wahren.
Sogar der Raum selbst lässt sich nach Belieben umgestalten: Zeichnet man ein „Doko-Demo-Tür“-Portal, kann man einen realen Raum direkt mit dem Weltall verbinden.
An diesem Punkt haben die Fähigkeiten des Weltmodells eine weitere Ebene erreicht —3D-Szenenrekonstruktion, räumlich kontrollierte Bearbeitung und Modellierung von kontinuierlicher Konsistenz über Szenen hinweg.
Das Modell kann die ursprüngliche räumliche Struktur einer Szene bewahren und zugleich die geometrischen Beziehungen verschiedener Szenen dynamisch neu ordnen, wodurch kontinuierliche Erkundung über Szenengrenzen hinweg und Echtzeit-Interaktion unterstützt werden:
Von der Aufrechterhaltung der räumlichen Struktur über die Reaktion auf Echtzeit-Interaktionen bis hin zur Unterstützung von Szenenbearbeitung und der Neukomposition über Räume hinweg – die Fähigkeiten des ByteDance-KI-Modells zielen alle auf das Kernmerkmal eines Weltmodells:
KI erzeugt nicht mehr nur Inhalte; sie erzeugt eine digitale Welt, die fortbestehen, sich fortwährend verändern und kontinuierlich interagieren kann.
In den vergangenen Jahren haben große Sprachmodelle die Fähigkeit der KI, Sprache und Wissen zu verarbeiten, stetig erweitert, während multimodale Modelle die Generierungsfähigkeit auf Bilder, Klänge und Videos ausgedehnt haben.
Heute beginnt die KI mit der Entwicklung von Weltmodellen, sich zunehmend mit räumlichen Strukturen, Umgebungszuständen und deren Entwicklungsgesetzen zu befassen.
Die technologische Entwicklung generativer KI verlagert sich damit von der Frage, wie realistisch ein Bild aussieht, hin zur Frage, ob eine generierte Umgebung fortbestehen, auf Interaktionen reagieren und sogar den Ablauf der realen Welt simulieren kann.
Weltmodelle ermöglichen es der KI, in der virtuellen Welt „echte Fähigkeiten“ zu entwickeln
Wenn Weltmodelle dem Menschen lediglich erlauben würden, in der Cyberwelt herumzuerkunden, wäre das gewissermaßen eine Verschwendung ihres Potenzials.
Betrachtet man sie im größeren industriellen Kontext, so besitzen sie noch einen weiteren, fantasievolleren Wert:
Maschinen können in der virtuellen Welt in großem Maßstab trainiert werden, wiederholt Fehler machen und die dabei erlernten Fähigkeiten in die Realität übertragen.
Schließlich leidet die Entwicklung physischer KI wie Robotik und autonomes Fahren seit Langem unter realen Einschränkungen wie hohen Kosten für die Erhebung echter Daten, langen Trial-and-Error-Zyklen sowie der Tatsache, dass gefährliche und extreme Szenarien kaum reproduzierbar sind.
Weltmodelle bieten hierfür einen neuen Weg: die Umwandlung realer Umgebungen in virtuelle Trainingsfelder, die generierbar, steuerbar und wiederholt überprüfbar sind.
Von der Generierung seltener Trainingsdaten bis zur Simulation komplexer Umgebungen und der Überprüfung von Handlungsstrategien – ein Teil der Trainingsprozesse, der bisher von realen Umgebungen abhing, dürfte künftig in die virtuelle Welt verlagert werden.
Dadurch erstrecken sich Weltmodelle zunehmend von der Inhaltsgenerierung auf das Training und die Validierung physischer KI und werden zu einer wichtigen technologischen Forschungsrichtung in Bereichen wie Robotik und autonomem Fahren.
△ KI-generiert
Beginnen wir mit dem Thema „Trainingsdaten“.
Für physische KI-Systeme wie das autonome Fahren gilt: Je wichtiger ein Extremszenario ist, desto knapper sind meist die Trainingsdaten dafür.
Beispielsweise seltene, aber risikoreiche Szenarien wie plötzliche Unfälle oder extremes Wetter begegnet man selbst bei langen Fahrstrecken vielleicht nur wenige Male – und genau solche Szenarien kann ein Weltmodelle bedarfsgerecht generieren und wiederholt simulieren.
Anlässlich der Technologieveranstaltung „2026 奇妙夜“ (Night of Wonders) der ByteDance-Gruppe zeigten sie eine solche Demo für autonomes Fahren:
Ein Krankenwagen fährt plötzlich heran, Fußgänger überqueren die Straße, ein Polizist regelt den Verkehr vor Ort.
Verschiedene komplexe Verkehrssituationen wurden in eine von KI generierte virtuelle Straße übertragen, in der das Fahrzeug simuliert fahren und auf unerwartete Situationen reagieren kann; zudem lässt sich das Fahrverhalten über Mehrkamera-Wiedergaben analysieren.
Lange-Tail-Szenarien, für deren Sammlung man früher auf umfangreiche echte Straßentests angewiesen war, lassen sich heute mit Weltmodellen in Serie generieren und für das wiederholte Training und die Validierung autonomer Fahrsysteme nutzen.
Neben den Trainingsdaten zeigt sich der industrielle Wert von Weltmodellen auch in einem weiteren entscheidenden Aspekt:der Steigerung der Effizienz von Training und Validierung physischer KI.
Bekanntlich müssen echte Roboter bei jedem Training Aktionen ausführen und auf Rückmeldungen warten; nach Fehlschlägen kann zudem ein manueller Zurücksetzen nötig sein und es besteht das Risiko von Hardwarebeschädigungen.
In der dreidimensionalen Welt however lässt sich der ursprünglich zeitaufwendige Trial-and-Error-Prozess in wiederholbare und parallelisierbare Simulationsexperimente umwandeln.
Die Demonstration eines Haushaltsroboters bei der Wissenschaftsshow 《2026 美好奇妙夜》 des Douyin-Konzerns spiegelt einen ähnlichen Ansatz wider.
In von KI generierten virtuellen Haushaltsumgebungen können Roboter haushaltsbezogene Operationen wie Greifen, Transportieren und Platzieren von Gegenständen üben und ihre Bewegungsstrategien an ständig wechselnde Objektpositionen und Raumlayouts anpassen, um Aufgaben zu erfüllen.
Selbst wenn eine Operation fehlschlägt, lässt sich das Problem in der virtuellen Umgebung schnell reproduzieren, die Strategie anpassen und wiederholt trainieren und validieren.
Im Vergleich zu wiederholten Operationen und manuellem Zurücksetzen in der Realität gibt der Weltmodell-Ansatz Robotern die Möglichkeit, in verschiedenen Szenarien parallel Fehler zu machen und daraus zu lernen– zu geringeren Kosten und mit höherem Geschwindigkeit die Fähigkeit zu erwerben, mit realen Umgebungen umzugehen.~
Blickt man auf die gesamte Branche, so haben die Technologieriesen bereits in unterschiedliche Richtungen damit begonnen, die industrielle Umsetzung von Weltmodellen zu erforschen.
Im März dieses Jahreskombinierte Nvidiadas Cosmos-Weltmodell mit der Isaac-Simulationsplattform, damit Roboter in virtuellen Umgebungen Daten generieren und wiederholt trainieren können.
Diese industrielle Simulationslösung dürfte die Kosten vom Training bis zur tatsächlichen Implementierung von Robotern deutlich senken.
△Bildquelle: Offizielle Nvidia-Website
Erwähnenswert ist zudem, dass dieser Trend sogar den Chiphersteller aus der upstream-Lieferkette mit hineingezogen hat.
Gerade erst im vergangenen Monat 9 (September),kündigte AMD an, für 8,2 Milliarden US-Dollar Fei-Fei Lis World Labs zu übernehmen, um frühzeitig auf den Rechenbedarf von Weltmodellen einzugehen und den Weg für die Entwicklung der nächsten Chipgeneration zu ebnen.
Vom virtuellen Training von Robotern über Industriesimulationen bis hin zum persönlichen Einstieg der Chiphersteller.
Der industrielle Wettbewerb um Weltmodelle erstreckt sich entlang der gesamten Wertschöpfungskette – von der Modellfähigkeit über praktische Anwendungen bis hin hinunter zu den zugrunde liegenden Rechenarchitekturen.
Weltmodelle im globalen Wettlauf: Die technologischen Grundlagen chinesischer Anbieter beginnen sich auszuzahlen
Weltmodelle sind wirklich im Trend, aber hinter dem Hype zeichnet sich allmählich ein ziemlich interessantes Branchenphänomen ab.
Anbieter im In- und Ausland erforschen alle, wie sich räumlich stabile, in Echtzeit interagierbare dreidimensionale Welten aufbauen lassen, doch die technologischen Grundlagen, Entwicklungsschwerpunkte und Anwendungswege der einzelnen Unternehmen unterscheiden sich erheblich –
die technischen Ziele nähern sich allmählich an, doch die Umsetzungswege sind jeweils unterschiedlich.
Am Beispiel des Auslands: Google DeepMinds Genie und Fei-Fei Lis World Labs erforschen beide universelle Weltmodell-Fähigkeiten mit Schwerpunkt auf räumlichen Strukturen, dynamischer Umgebungsmodellierung und interaktiver Szenengenerierung.
Nvidias Cosmos hingegen liegt näher an den praktischen Anforderungen des Physical AI, verbindet Weltmodelle mit Robotersimulation und synthetischer Datengenerierung und versucht, virtuelles Training und reale Anwendungen miteinander zu verknüpfen.
Diese mehreren Wege haben jeweils unterschiedliche Schwerpunkte, zielen aber letztlich alle auf ein gemeinsames Ziel ab:dass die von KI generierten virtuellen Umgebungen nach und nach die Fähigkeit erhalten, die reale Welt zu simulieren.
Wenden wir nun den Blick nach China.
Ein beachtenswerter Vorteil ist, dass die in den vergangenen Jahren von chinesischen Anbieternim Bereich Bild- und Videogenerierung angesammelten technologischen Fähigkeiten der Weltmodell-Entwicklung einen anderen, durchaus wettbewerbsfähigen Entwicklungsweg eröffnet haben.
Im Juli dieses Jahreserweiterte Seedance 2.5die Dauer einer einzelnen Videogenerierung auf 30 Sekunden und stärkte zudem die multimodale Referenzsteuerung sowie die Fähigkeiten für Kamerabewegung und fortlaufende Erzählung.
Das im gleichen Zeitraum veröffentlichte BildgenerierungsmodellSeedream 5.0 Pro...und stärkt damit zusätzlich das räumliche Positionsverständnis, die strukturelle Konsistenz und die präzise interaktive Bearbeitung.
Der Nutzer umkreist eine Stelle auf dem Bild oder zeichnet sogar ein paar freihändige Striche, und das Modell kann den angegebenen Bereich gezielt verändern – wahrhaftig: malen, wo man es ändern will.
Von der Konsistenz der räumlichen Struktur über die dynamische Kontinuität über lange Zeiträume bis hin zur präzisen Reaktion auf externe Eingriffe – all das sind genau die technischen Probleme, an denen der Aufbau einer interaktiven dreidimensionalen Welt nicht vorbeikommt.
Die Technologien, die inländische Anbieter in den vergangenen Jahren im Bereich visuelle Generierung und kontrollierbare Bearbeitung angesammelt haben, beginnen nun ebenfalls, ihr Potenzial in Richtung allgemeiner Weltmodelle zu entfalten.
Im Jahr 1895 brachten die Brüder Lumière einen in den Bahnhof einfahrenden Zug auf die Leinwand.
Die Menschen damals konnten wohl kaum ahnen, dass diese neue Erfindung in den darauffolgenden mehr als hundert Jahren die Art und Weise, wie die Menschheit die Welt aufzeichnet und darstellt, vollständig verändern würde.
Mehr als ein Jahrhundert später, mit dem Aufkommen der Computergrafik und der Virtual-Reality-Technologie, begann die Menschheit zu versuchen, vom Betrachten der Welt auf dem Bildschirm zum immersiven Erleben und Erforschen digitaler Welten überzugehen.
Heute sorgt das Auftreten von Weltmodellen dafür, dass diese über mehr als hundert Jahre andauernde technologische Entwicklung eine neue Wende nimmt –
Maschinen beginnen, die räumlichen Strukturen und Funktionsgesetze der realen Welt zu erlernen, und versuchen, virtuelle Umgebungen zu erzeugen, die kontinuierliche Erkundung, Echtzeit-Interaktion und sogar die Simulation der Realität ermöglichen.
Vor mehr als hundert Jahren lernte die Menschheit, die Welt mit Bildern festzuhalten.
Mehr als hundert Jahre später beginnen wir zu versuchen, aus Bildern eine Welt zu machen, in die man persönlich eintreten und die man sogar verändern kann.
Mehr als hundert Jahre sind vergangen, und diesmal versuchen wir endlich, in die Bilder einzutreten, die wir selbst erschaffen haben.