IT之家 Nachricht vom 13. Oktober: Der YouTube-Kanal Jun Yamog veröffentlichte gestern (12. Oktober) ein Video, in dem getestet wurde, wie sich 4 Tesla-V100-Karten auf einer NVLink-Trägerplatte verhalten; im Qwen3.8-Flash-Next-Benchmarkwar die Verarbeitungsgeschwindigkeit langer Prompts um 230 % schneller als die des M5 Ultra und um 40 % schneller als die von 2 DGX Spark.
Ein Blick von IT之家 auf öffentliche Quellen zeigt: Die Tesla V100 ist eine von Nvidia im Jahr 2017 vorgestellte Datacenter-GPU auf Basis der Volta-Architektur, die häufig für KI-Training und -Inferenz eingesetzt wird. Ihre 32-GB-Version ist mit HBM2-Videospeicher ausgestattet, und die Speicherbandbreite von 900GB/s ermöglicht das schnelle Auslesen großer Modellparameter und Daten.
NVLink ist Nvidias GPU-Hochgeschwindigkeits-Interconnect-Technologie, mit der Daten direkt zwischen mehreren GPUs übertragen werden. Im Vergleich zur Kommunikation über PCIe kann NVLink Interconnect-Engpässe reduzieren und wird häufig in Multi-GPU-Servern und KI-Compute-Clustern verwendet.
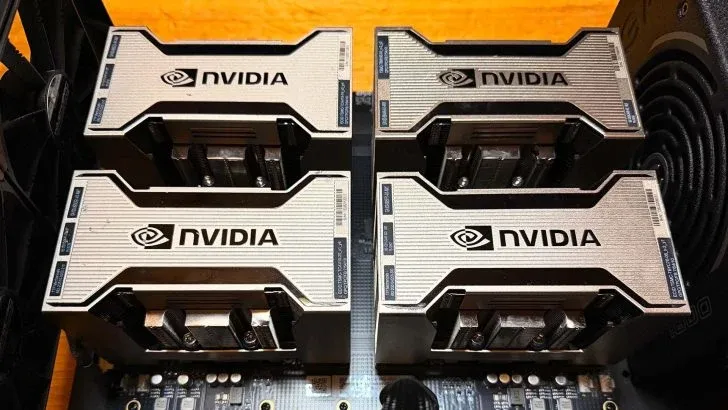
Die NVLink-Trägerplatte bietet eine Bandbreite von 300GB/s und ist mit 6 NVLink-2.0-Verbindungen ausgestattet. Um 4 einzelne GPUs aufzunehmen, modifizierte der Tester NVIDIA-A100-Kühler, sodass diese die Abwärme von rund 300W pro V100 abführen können, und verband die Platte über PCIe-x8-Schnittstellen.
Der Kanalbetreiber testete mit einem 4-bit-quantisierten Qwen3.8-Flash-Next-Modell; zu den Vergleichsobjekten gehörten 2 DGX Spark mit 128GB LPDDR5X Unified Memory sowie ein Mac Studio mit M5-Ultra-Chip.
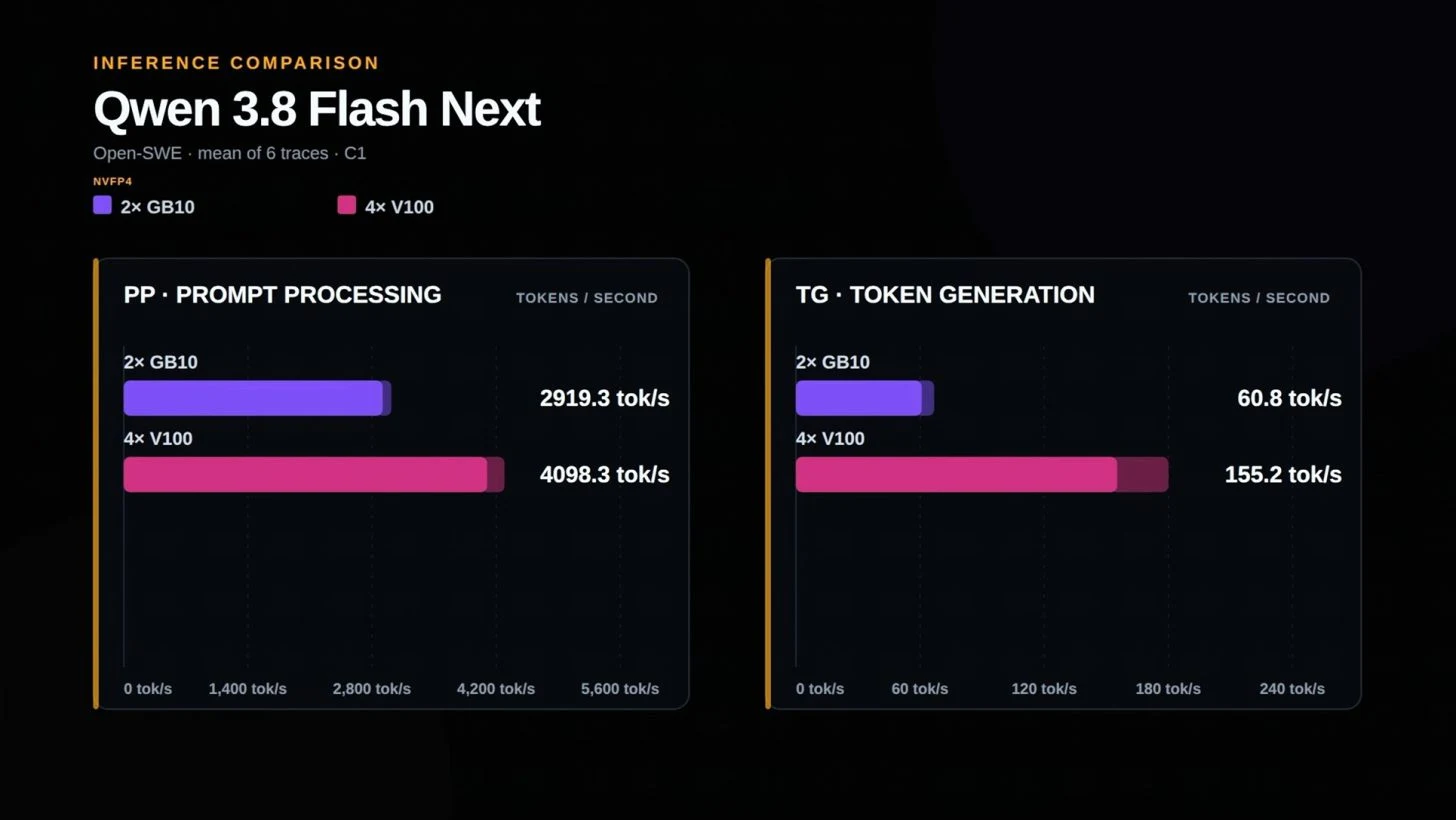
Im Test zur Verarbeitung langer Prompts war der 4-V100-Cluster 40 % schneller als das DGX-Spark-Cluster und 230 % schneller als der M5 Ultra. Der Tester wies darauf hin, dass der große Abstand zum Apple Silicon teilweise an mangelnder Softwareoptimierung liegen könnte.
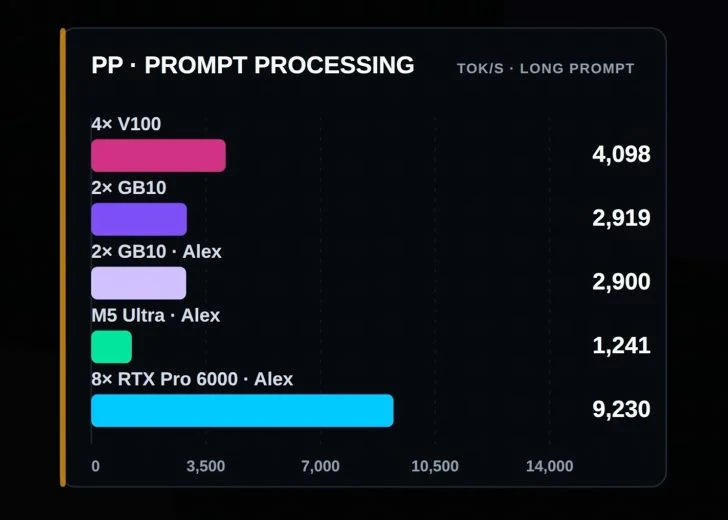
Im Test zur Verarbeitung kurzer Prompts behielt der V100-Cluster einen Geschwindigkeitsvorteil von 40 % gegenüber der DGX Spark und war 163 % schneller als der M5 Ultra. Dieses Ergebnis zeigt, dass ältere Datacenter-GPUs bei bestimmten Inferenz-Workloads weiterhin eine hohe Durchsatzfähigkeit besitzen.
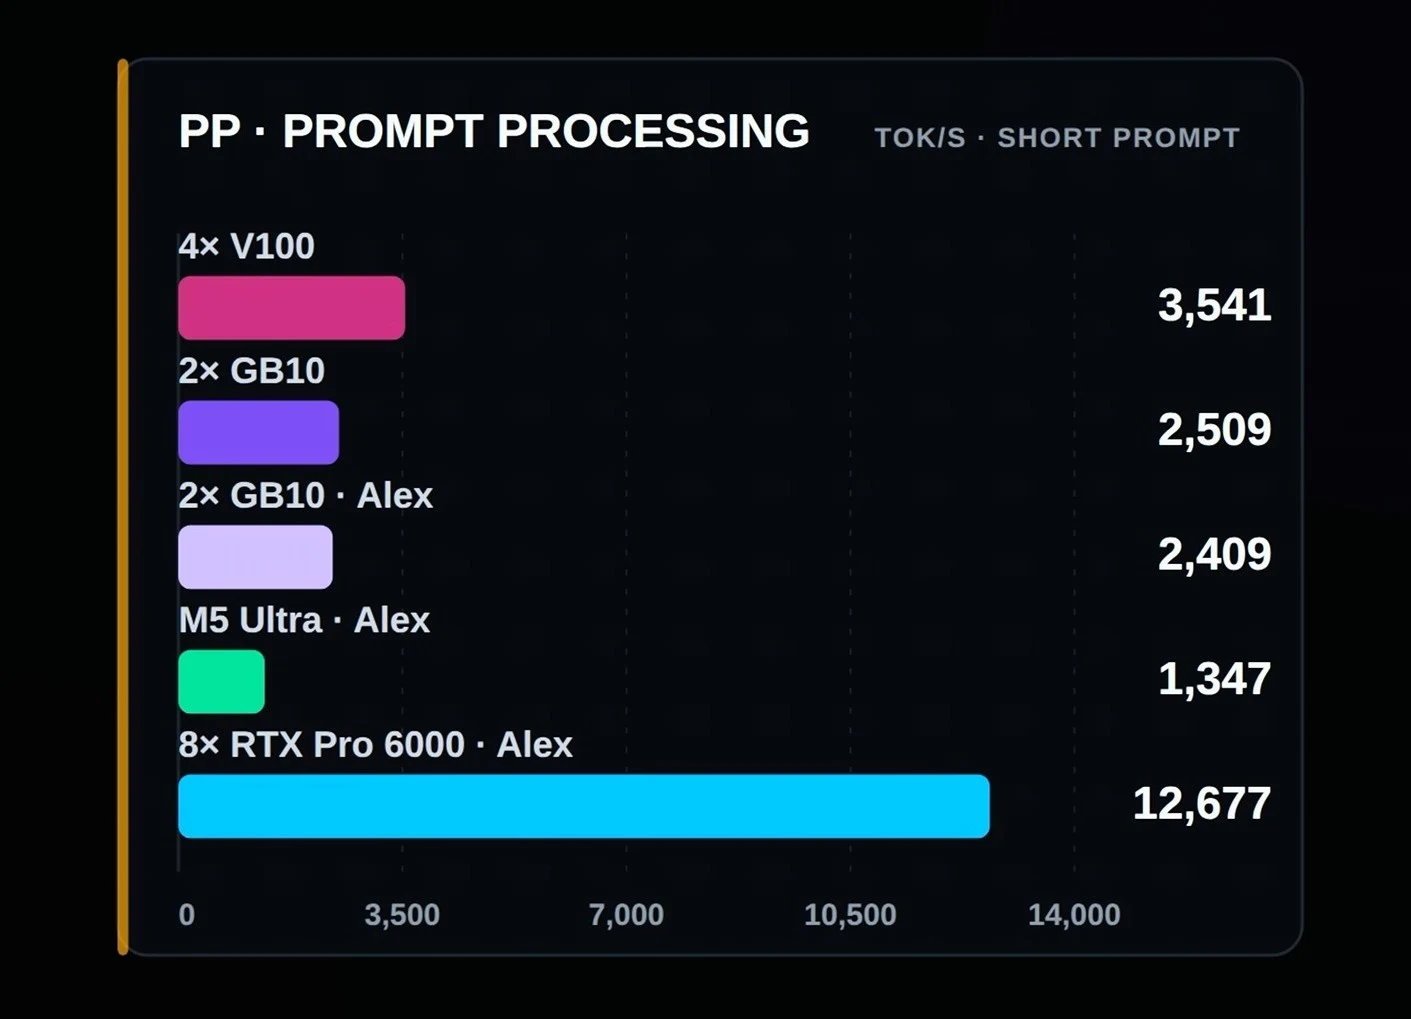
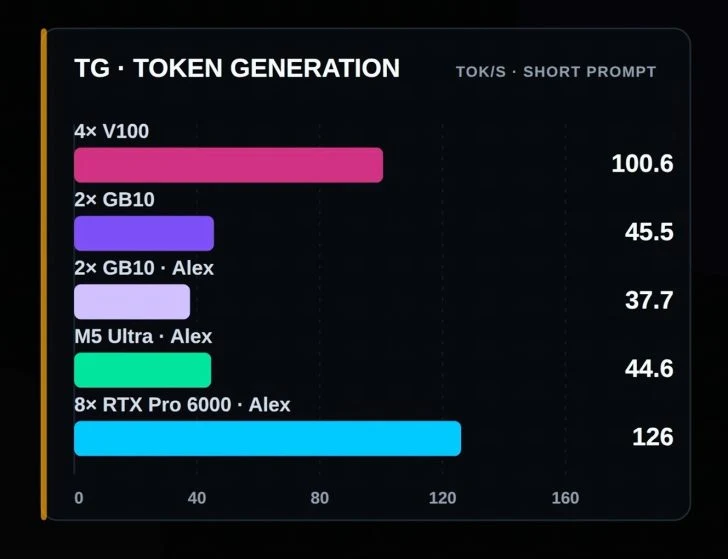
Im Test zur Token-Generierung bei kurzen Prompts erreichten die 4 V100 100.6 tok/s und waren damit 121 % schneller als 2 DGX Spark; der M5 Ultra erreichte 44.5 tok/s.