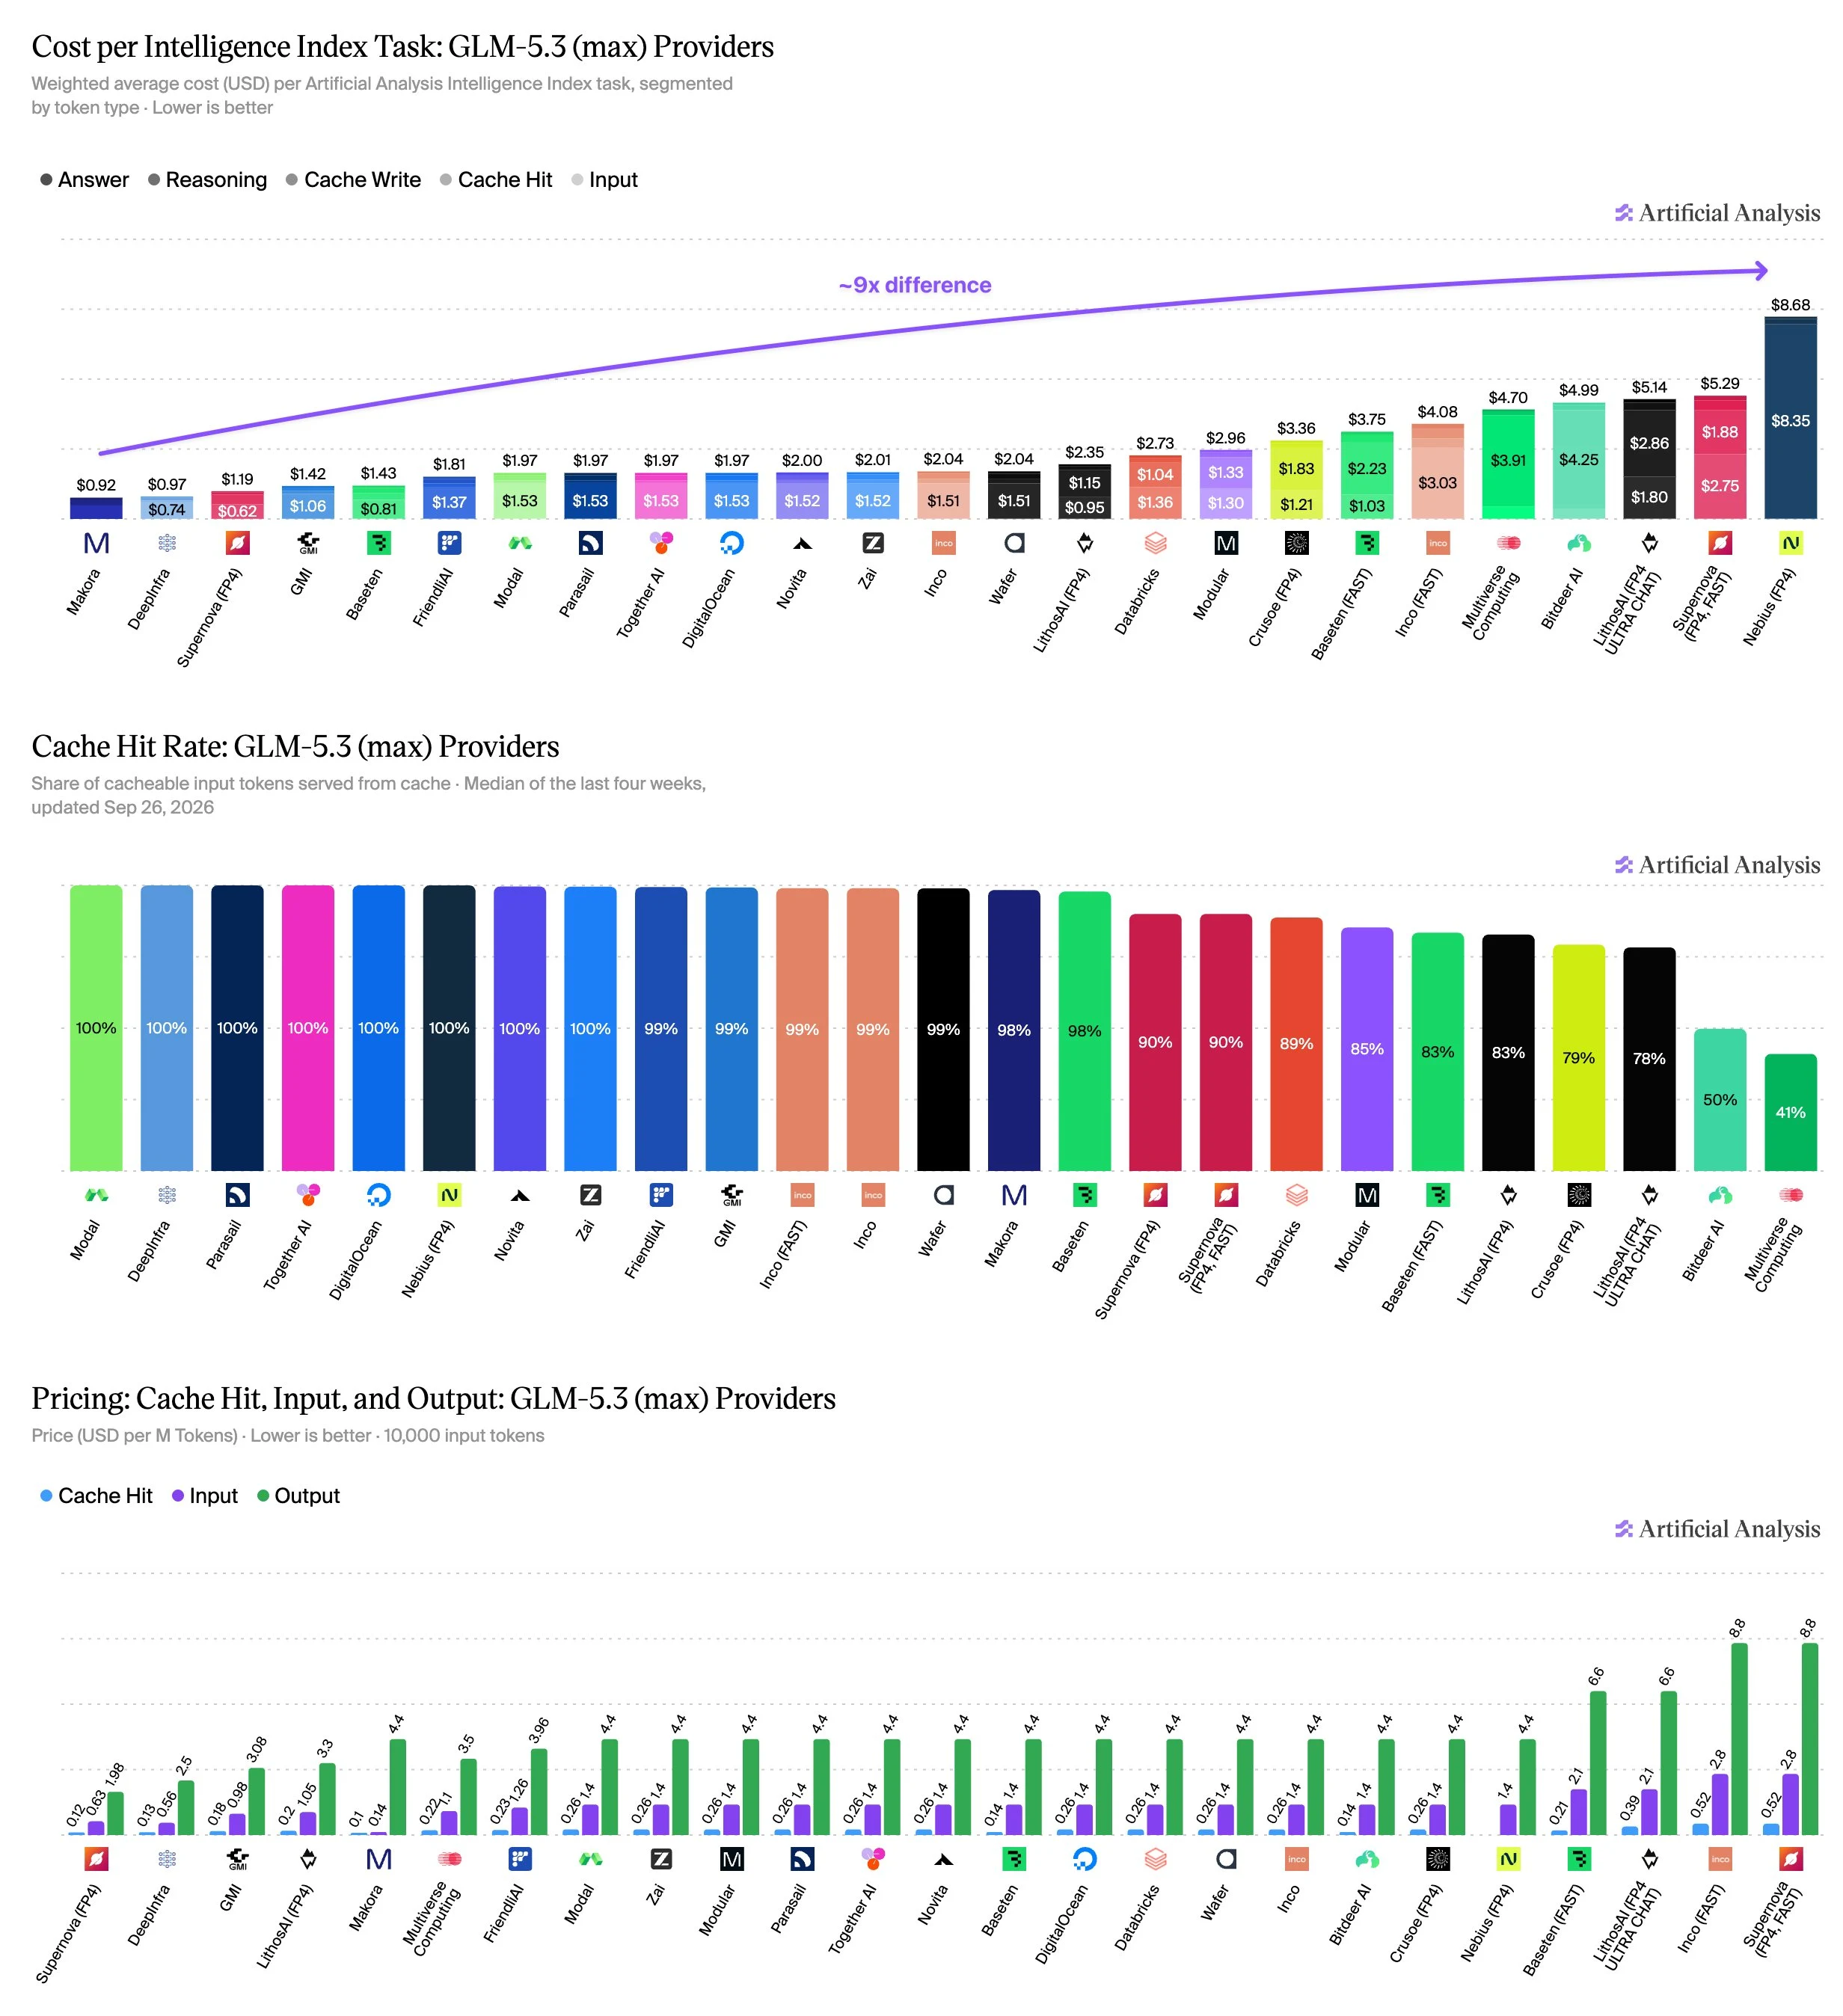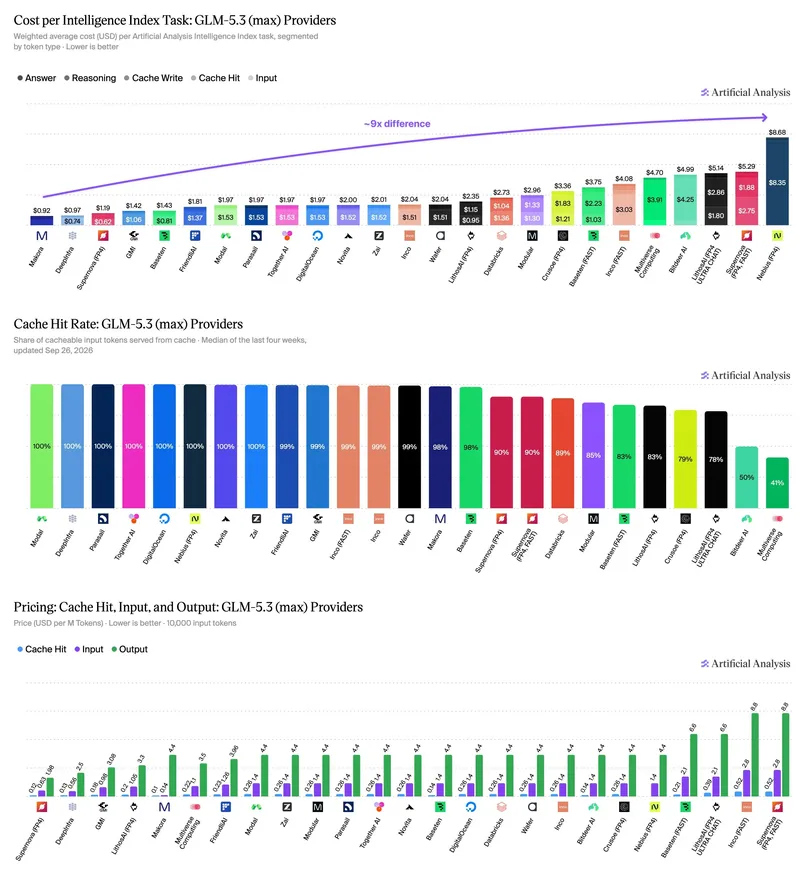
Die Cache-Hit-Raten und der Kosten pro Aufgabe durch den Anbieter sind jetzt auf Artificial Analysis verfügbar: Die Kosten pro Aufgabe für GLM-5.3 (max) variieren ~9-mal zwischen den Anbietern, was durch eine Kombination aus Cache-Hit-Rate und Token-Preis entsteht
Die Agentenlasten senden jeden Turn den gesamten Gesprächsverlauf erneut, sodass die meisten Eingabe-Token cachenbar sind. Die Caching-Preise und die Caching-Hit-Raten bilden den Großteil des Unterschieds im Kosten pro Aufgabe. Wir verwenden bereits gemessene Caching-Hit-Raten, um die Kosten pro Aufgabe zu berechnen, und veröffentlichen sie nun für jeden Model-Endpunkt, den wir überwachen.
Was neu:
➤ Die Cache-Hit-Raten sind nun für alle first-party- und third-party-Endpunkte sichtbar, indem mehrere Agenten-Codeaufgaben ausgeführt und die aus dem Nutzungsantwort jedes Anbieters gelesenen Cached-Token verwendet werden. Die Cache-Hit-Rate ist der Anteil der cachebaren Eingabestoken, die aus dem Cache bereitgestellt werden.
➤ Der Kosten pro Aufgabe ist nun für die Anbieter für offene Gewichtsmodelle verfügbar und wird aus den Eingaben, Ausgaben, Cache-Hit- und Cache-Writeschlägen jedes Anbieters berechnet, unter Berücksichtigung der gemessenen Cache-Hit-Rate. Um bei einem bestimmten Modell eine Standardisierung zwischen den Anbietern zu erreichen, verwenden wir die gleichen Eingaben, Ausgaben und cachebaren Tokenzahlen aus dem Intelligence Index des Modells.
Wichtige Erkenntnisse:
➤ Der Kosten pro Aufgabe auf GLM-5.3 (max) variiert zwischen den Anbietern um das 9-fache – von $0,92 bei Makora bis zu $8,68 bei Nebius. Beide bieten nahezu alle kachelbaren Eingaben aus dem Cache an (98 % und 100 %) und erheben denselben Ausgabepreis an ($4,40 pro 1 Mio. Tokens), daher entsteht der Unterschied durch die Eingabepreise: Makora kostet $0,10 pro 1 Mio. kacheltes Eingabetoken, während Nebius auf seinen shared Serverless Endpunkten keinen Rabatt für kacheltes Eingabe erhält und alle Eingaben zu dem vollen Preis von $1,40 berechnet.
➤ Die Cache-Hit-Rate liegt bei 41 % bis 100 % bei 21 Anbietern (25 Endpunkten). 15 Endpunkte erreichen 98 % oder mehr, und acht erreichen 100 %: Modal, DeepInfra, Parasail, Together AI, DigitalOcean, Nebius, Novita und die erste-Party-API von Z AI. Multiverse Computing hat die niedrigste Rate von 41 %, gefolgt von Bitdeer mit 50 %.