
Yunzhong, berichtend von Afeisi
QbitAI | Öffentlicher WeChat-Account QbitAI
Ein Agent soll den Wochenbericht schreiben oder Vorschläge analysieren – das ist für viele bereits Alltag. Doch bei jedem Start müssen Nutzer erst Unterlagen heraussuchen und den Hintergrund erklären, und auch der Agent muss mehrere Schritte wie Suchen, Lesen und Ordnen durchlaufen, bevor er die Aufgabe wirklich beginnen kann.Wechselt die Aufgabe, muss dieser Ablauf erneut von vorn beginnen.Das wiederholte Verarbeiten bereits vorhandener Unterlagen kostet nicht nur Zeit, sondern erhöht auch den token-Verbrauch. Je mehr Unterlagen und je länger die Schritte, desto eher werden Informationen übersehen oder Abweichungen entstehen, was die Genauigkeit der Aufgabenerledigung beeinträchtigt.
Um diese Probleme zu lösen,WorkSwarm unterstützt den persönlichen Wissensraum erstmals nativ。
Der „persönliche Wissensraum“ sammelt Inhalte automatisch auf Grundlage mehrerer vom Nutzer konfigurierter Quellen und ordnet die Unterlagen – durch Regelverarbeitung, hybride Regel- und Großmodellverarbeitung oder Agentenverarbeitung – zumit Verzeichnis, Verknüpfungen und Quellenangaben versehenempersönlichen Wissen, das dem Agenten in Form progressiver Offenlegung zur Verfügung gestellt wird.
WorkSwarm wandelt persönliche Unterlagen in langfristig wiederverwendbares persönliches Wissen um und realisiert damit„einmal erfassen, wiederholt nutzen“, wodurch der Agent relevante Informationen leichter findet und besser nutzt, die Genauigkeit der Aufgabenerledigung steigt und zugleich die Vorbereitungszeit und der token-Verbrauch sinken.
openJiuwen persönlicher Wissensraum: automatisches Erfassen personalisierten Wissens aus mehreren Quellen, bedarfsgerechte Nutzung durch Büro-Agenten
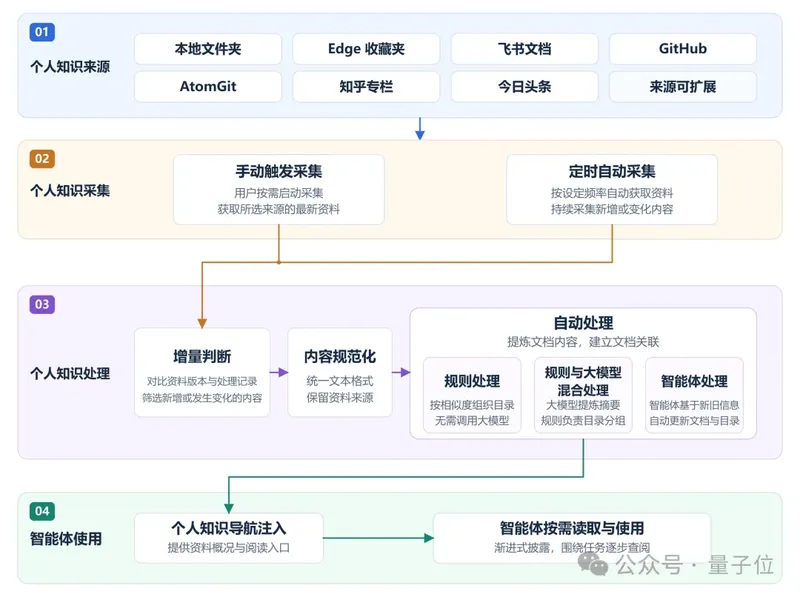
Der persönliche Wissensraum umfasst die vier Ebenen Quelle, Erfassung, Verarbeitung und Nutzung und wandelt die im Alltag angesammelten persönlichen Unterlagen des Nutzers in dauerhaft wiederverwendbares Aufgabenhintergrundwissen um.
 △ Vier-Ebenen-Ablauf des persönlichen Wissensraums: zeigt die Konfiguration mehrerer Quellen, manuelle und zeitgesteuerte Erfassung, drei Verarbeitungsarten sowie die bedarfsgerechte Nutzung durch den Agenten
Der Nutzer wählt zunächst die Quellen und den Erfassungsumfang seines persönlichen Wissens aus; das System ruft die Inhalte bedarfsgesteuert oder zeitgesteuert ab. Die erfassten Unterlagen durchlaufen eine Formatvereinheitlichung und Inkrementprüfung, um die in dieser Runde zu verarbeitenden neuen Inhalte und Änderungen zu identifizieren; anschließend werden sie je nach Konfiguration per Regeln, hybrider Regel- und Großmodellverarbeitung oder durch Agenten zu Themenverzeichnissen und Markdown-Seiten geordnet, wobei Dokumentverknüpfungen und Quellenangaben gepflegt werden. Nach bestandener Prüfung von Verzeichnisstruktur und Quellenverweisen steht das Ordnungsergebnis dem Nutzer zur Einsicht zur Verfügung.
Wenn der Nutzer die Aufgabenverwendung aktiviert, stellt das System dem Agenten eine Übersicht des persönlichen Wissens und Lesezugänge bereit; der Agent liest dann schrittweise die relevanten Seiten rund um die aktuelle Fragestellung, sodass vorhandenes Wissen zum Hintergrund der Aufgabenerledigung wird.
Konfiguration und Erfassung des persönlichen Wissensraums: freie Wahl der Wissensquellen, Unterstützung manueller/zeitgesteuerter inkrementeller Erfassung
Nachdem der Nutzer den persönlichen Wissensraum auf der Seite „Wissen“ in den „Einstellungen“ aktiviert hat, kann er Quellen wielokale Ordner, Edge-Lesezeichen, Zhihu-Kolumnen, Toutiao, Feishu-Dokumente, GitHub und AtomGithinzufügen. Die verschiedenen Quellen lassen sich separat konfigurieren; der Nutzer entscheidet selbst, welche persönlichen Unterlagen in den persönlichen Wissensraum aufgenommen werden.
Nach Abschluss der Konfiguration kann der Nutzer die Erfassungmanuell auslösenund den persönlichen Wissensraum aktiv aktualisieren oder einezeitgesteuerte automatische Erfassungeinrichten, die Inhalte kontinuierlich in der festgelegten Frequenz abruft. Das System identifiziert anhand von Quellenkennung, Version und Erfassungsfortschritt neue oder veränderte Unterlagen und verarbeitet diese in Verbindung mit dem vorhandenen persönlichen Wissen.
Die Quellenverwaltungsseite zeigt Erfassungsfortschritt und letzten Status; Nutzer können die Update-Frequenz anpassen, die Ergebnisse der aktuellen Runde einsehen oder eine laufende Erfassung stoppen.
Aktivieren Sie den persönlichen Wissensraum auf der Seite „Wissen“ in den „Einstellungen“ und wechseln Sie dann auf der Seite „Wissen“ zur „Quellenverwaltung“. Das Video zeigt am Beispiel von Toutiao das Hinzufügen eines Autorenprofil-Links, das manuelle Starten der Erfassung und die Ansicht des Laufstatus der Quelle.
Persönliche Wissensverarbeitung: Drei Sortiermethoden, um verstreute Materialien in wiederverwendbares Wissen zu verwandeln
Die Struktur von Webseiten, Dokumenten und Code unterscheidet sich voneinander, und Inhalte zum selben Thema können über mehrere Quellen verstreut sein. Der persönliche Wissensraum vereinheitlicht zunächst die Formate der Materialien, destilliert dann die Inhalte und ordnet sie nach Themen in Verzeichnisse und Seiten, damit intelligente Agenten zuerst einen Überblick erhalten und anschließend schrittweise die relevanten Inhalte lesen können, wobei die Links und Quellenangaben der Originaldokumente erhalten bleiben.
Nachdem neue Daten erfasst wurden, ergänzt und aktualisiert das System das vorhandene persönliche Wissen, sodass sich das Wissen kontinuierlich in denselben reinen Textdateien ansammelt.
Auf der Seite „Wissen“ in den „Einstellungen“ können Nutzer je nach Eigenschaften des Materials und ihren Organisationsbedürfnissen eine der folgenden drei Verarbeitungsmethoden auswählen:
- Regelverarbeitung:Mithilfe von BM25-Termgewichtungen und Ähnlichkeitsvergleichs des Inhalts werden relevante Seiten nach Themen gruppiert, und die Verknüpfungen zwischen Verzeichnis und Seiten werden gepflegt – ganz ohne den Aufruf generativer Modelle.
- Hybride Verarbeitung durch Regeln und große Modelle:Zunächst extrahiert ein großes Modell Titel, Zusammenfassung und Schlüsselwörter aus den neuen Materialien, anschließend übernehmen Regeln die thematische Gruppierung und die Verzeichnisorganisation, und zuletzt erzeugt das große Modell Verzeichnistitel und Einführungen, um das Verständnis und Nachschlagen zu erleichtern.
- Verarbeitung durch Agenten:Der Agent analysiert die Beziehung der neuen Materialien zum bestehenden persönlichen Wissen, aktualisiert oder führt bestehende Themenseiten vorrangig zusammen, fügt bei Bedarf neue Dokumente hinzu und pflegt gleichzeitig die Verzeichnisbeschreibungen sowie Querverweise zwischen den Dokumenten.
Bei den beiden letztgenannten Verfahren können die Nutzer das Modell konfigurieren, das für die Ordnung der Materialien verwendet wird. Nach Abschluss der Ordnung prüft das System die Verzeichnisstruktur und die Quellenangaben; Inhalte, die die Prüfung bestehen, stehen dem Nutzer zum Nachschlagen und dem Agenten zur Nutzung zur Verfügung.
Die Nutzer können relevante Inhalte außerdem über den Dateibaum, den Graphen oder die Suche finden, Dokumente öffnen und den Fließtext lesen und über die Kennzeichnung „Quellen“ die ursprünglichen Materialien zurückverfolgen.
Nach Abschluss der Erfassung wurden bereits zu „jev“ relevante Inhalte erfasst. Die Nutzer können auf der Seite „Wissen“ nach jev suchen, rechts den aufbereiteten Fließtext lesen oder über den Graphen die relevanten Knoten und deren Verknüpfungen anzeigen.
Bedarfsgerechte Nutzung: Progressive Offenlegung, damit der Agent mit vorhandenem Wissen an die Arbeit geht
Nachdem die Materialien zu persönlichem Wissen aufbereitet wurden, können die Nutzer über das „+“-Menü im Aufgaben-Eingabebereich den Agenten mit dem persönlichen Wissensraum verbinden. Nach Erhalt der Nutzereingabe verschafft sich der Agent zunächst einen Überblick über die Materialien des persönlichen Wissensraums und die Einstiegspunkte zum Lesen, um den Umfang des vorhandenen Wissens kennenzulernen, und konsultiert dann entlang des Verzeichnisses und der Dokumentenverknüpfungen schrittweise die für die aktuelle Aufgabe benötigten Hintergrundinformationen.
Diese Form der progressiven Offenlegung ähnelt der Übernahme einer Aufgabe, bei der man zuerst das Inhaltsverzeichnis und die Projektvorstellung ansieht und anschließend die relevanten Dokumente durchblättert, sodass jede Aufgabe das vorhandene Wissen bedarfsgerecht einliest.
Sammlung und Aufgabenverwendung können getrennt gesteuert werden. Nutzer können das System kontinuierlich Material sammeln und ordnen und die Nutzung durch den Agenten bei Bedarf einschalten. Nach dem Deaktivieren der Aufgabenverwendung kann das Material weiterhin gesammelt werden, und Nutzer können vorhandene Dokumente direkt durchsehen und durchsuchen.
Die Nutzer entscheiden, welche Materialien in den persönlichen Wissensraum aufgenommen werden und wann der Agent sie verwenden darf. Beim Start einer Aufgabe muss man sich nur auf das aktuelle Problem konzentrieren; das bereits angesammelte Wissen liefert dem Agenten den Hintergrund zum Verstehen und Erledigen der Aufgabe.
Nach dem Aktivieren des persönlichen Wissensraums gibt man „介绍一下jev“ ein und sendet es. WorkSwarm durchsucht daraufhin die Jev-Dokumente im persönlichen Wissensraum und erstellt eine Einführung, die Kernmechanismen, Anwendungsfälle und mehr umfasst.
Wirkungsvergleich: Höhere Aufgabenbestehensquote, geringere Aufgabenzeit und geringerer token-Verbrauch
Nach der Aktivierung des persönlichen Wissensraums kann der Agent zuerst den Umfang der vorhandenen Materialien erfassen und dann relevante Dokumente auffinden und lesen, wodurch das wiederholte Suchen und Ordnen von Rohmaterial während der Aufgabe reduziert wird.
Das Team führte zunächst 2 Vergleichstests durch, um zu beobachten, wie sich diese Änderung auf Aufgabenerfolg, Dauer und token-Verbrauch auswirkt.
Der Vergleich zeigt: Mit dem persönlichen Wissensraum kann WorkSwarm Kundenakten, Projektmaterialien und Arbeitspläne kombinieren, um konkrete Projektzusammenfassungen und nächste Schritte zu erstellen; ohne das entsprechende persönliche Wissensuchte der Agentmehrfach vergeblich nach dem Projekthintergrund und konnte zunächst nur einen allgemeinen Meeting-Vorbereitungsrahmen liefern und den Nutzer um Ergänzungen bitten.
Der Vergleich zeigt: Nach dem Aktivieren des persönlichen Wissensraums kann WorkSwarm das aus Quellen wie dem Browser-Lesezeichenordner des Nutzers, Zhihu-Kolumnen usw. angesammelte Wissen nutzen und Aufgaben schneller erledigen.
Darüber hinaus erstellte das openJiuwen-Team einen eigenen Testsatz mit 25 Fragen, der auf Materialien aus sieben Quelltypen basiert – lokale Papierе, Browser-Lesezeichen, Feishu-Dokumente, GitHub, AtomGit, Zhihu und Toutiao – und Szenarien wie Einzelquellen-Recherche, übergreifende Quellensynthese, Wiederverwendung bei Themenwechsel, fehlende Fakten und irrelevante Aufgaben abdeckt, wobei für jede Frage vorab Abnahmepunkte festgelegt wurden. Die Testergebnisse zeigen, dass nach Aktivierung des persönlichen Wissensraums:
- die Aufgabenbestehensquote um 32% stieg. Der persönliche Wissensraum erleichtert dem Agenten das Auffinden benötigter Materialien und die Beantwortung unter Kombination personalisierter Informationen aus verschiedenen Quellen, wodurch Fälle reduziert werden, in denen Aufgaben wegen nicht gefundener Materialien oder übersehener Informationen nicht abgeschlossen werden konnten.
- die Gesamtdauer der Aufgaben um 76.2% sank. Die Materialien wurden vorab gesammelt und geordnet, sodass relevante Dokumente während der Aufgabe direkt eingesehen werden können, was die Schritte des temporären Suchens, Lesens und Ordnens von Rohmaterial reduziert.
- der gesamte token-Verbrauch in der Aufgabenphase um 84.1% sank. Das geordnete Wissen kann in verschiedenen Aufgaben wiederverwendet werden; der Agent liest die relevanten Inhalte bedarfsorientiert zur Aufgabe, was den token-Verbrauch durch wiederholtes Ordnen von Rohmaterial und Übergeben irrelevanter Inhalte reduziert.
In diesem Experiment wurde ein agentenbasierter Ansatz verwendet; obwohl auch die Vorverarbeitungsphase token verbraucht, lassen sich diese Kosten durch die Wahl eines für die Materialordnung geeigneten, günstigeren Modells kontrollieren und durch die wiederholte Verwendung der Ordnungsergebnisse in mehreren Aufgaben schrittweise amortisieren.
Fazit
Der openJiuwen-persönliche Wissensraum ordnet verstreute persönliche Materialien in dauerhaft wiederverwendbares Wissen. Nutzer wählen die Quellen selbst, das System sammelt und aktualisiert kontinuierlich, sodass Materialien bequem einsehbar sind und vom Agenten bedarfsgerecht gelesen werden können, um verschiedenen Aufgaben Hintergrund zu liefern.
Künftig plant der openJiuwen-persönliche Wissensraum, anhand der Nutzungsspuren der Nutzer Arbeitsziele und Wissenslücken zu erkennen und aktiv Materialien zu ergänzen, damit sich der Wissensaufbau enger an tatsächlichen Bedürfnissen orientiert und der Büro-Agent im Gebrauch den Nutzer immer besser versteht.
Der persönliche Wissensraum macht die angesammelten Materialien zum Ausgangspunkt der nächsten Agent-Kollaboration.
Der persönliche Wissensraum ist in WorkSwarm live gegangen; interessierte Nutzer können ihn mit einem Klick auf der offiziellen Website herunterladen und sofort ausprobieren:
WorkSwarm-Website: https://openjiuwen.com/workswarm
GitHub: https://github.com/openJiuwen-ai/jiuwenswarm
AtomGit: https://atomgit.com/openJiuwen/
*Dieser Artikel wurde von QbitAI mit Genehmigung veröffentlicht; die Ansichten liegen allein beim ursprünglichen Autor.