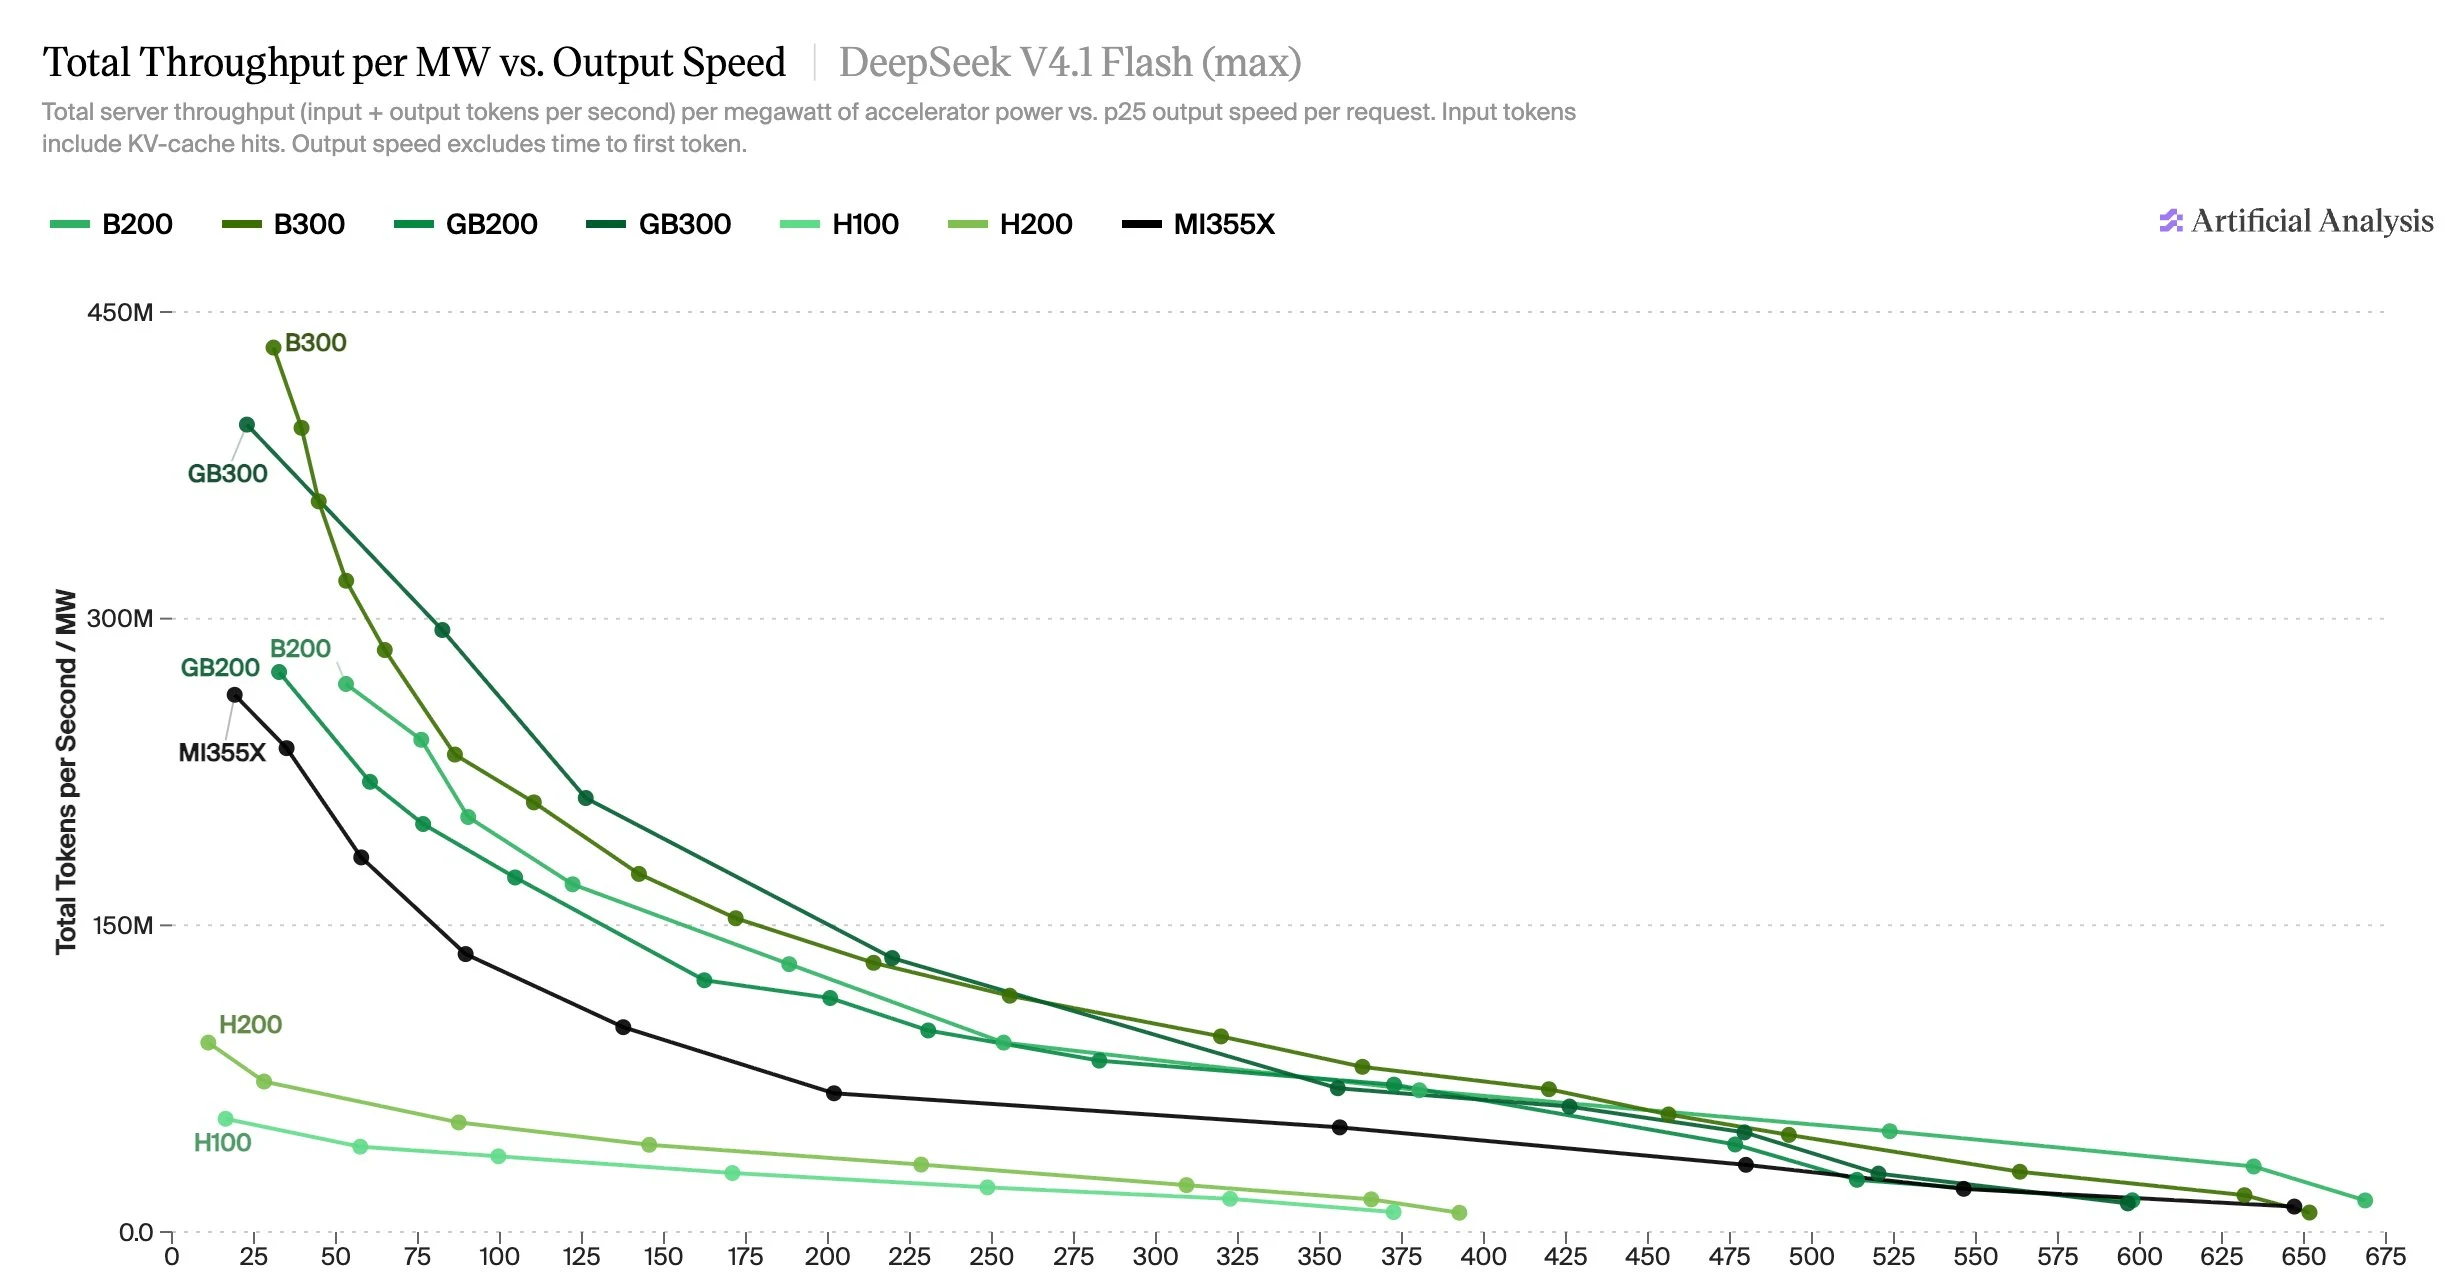
Wir haben DeepSeek V4.1 Flash zu AA-AgentPerf hinzugefügt, mit Ergebnissen für NVIDIA- und AMD-Hardware. Bei 100 Tokens pro User erreicht die NVIDIA GB300 den ersten Platz mit einem Durchsatz von bis zu 261 Mio. Tokens pro Sekunde pro MW.
AA-AgentPerf ist unser Benchmark für die Leistung von Agenten. Er wiederholt echte Agenten-Kodier-Sitzungen, einschließlich Prompt-Caching und Tool-Call-Verzögerungen, um eine realistische Messung der Inferenzleistung in den täglichen Agenten-Arbeitslasten zu bieten. Wir messen den Gesamtsystemdurchsatz pro Megawatt Laufzeitleistung sowie die Ausgabsgeschwindigkeit pro Agent bei unterschiedlichen Konkurrenzen, um den Kompromiss zwischen Systemnutzung und individuellem Benutzer-Erlebnis zu zeigen.
DeepSeek V4.1 Flash tritt heute in die Leaderboard ein. Dadurch werden vier besondere Modelle in die Leaderboard aufgenommen – darunter DeepSeek V4 Pro 0813, Kimi K3 und GLM-5.2/5.3. Wir entwickeln die besonderen Modelle weiter, je nachdem, wie beliebt neue offene Gewichtsmodelle werden. Für die wichtigsten zukünftigen Veröffentlichungen werden auch Ergebnisse vom „Tag 0“ angezeigt.
Hintergrund zu DeepSeek v4.1 Flash:
➤ Er erzielt 39 Punkte im Artificial Analysis Intelligence Index, wobei er vor DeepSeek’ früherem V4 Pro 0813 mit 36 Punkten liegt, und etwa ein Drittel der Parameter hat (552B ‘Rückgrat’ und 16B aktiv, gegenüber 1,6T und 49B).
➤ Es ist auf einer neuen Architektur basiert, mit einem kausaler Encoder-Decoder-Design, der 8B Parameter pro Eingabestandteil und 16B Parameter pro Ausgabestandteil aktiviert. Es verwendet zusätzlich 196B Parameter des Engram-N-Gram-Memors, der in der Host-Memory stehen kann anstatt auf dem Akku, sowie komprimierte, dünne Aufmerksamkeit, die etwa ein Viertel des KV-Caches des früheren V4-Flash-Modells pro Token erfordert.
➤ Dadurch ist die Bereitstellung viel effizienter, da die Gewichte auf weniger GPUs passen und der kleinere KV-Cache mehr gleichzeitige Agenten pro GPU ermöglicht.
Anfängliche Ergebnisse von AA-AgentPerf für DeepSeek V4.1 Flash:
➤ V4.1 Flash funktioniert bereits mit nur 2 GPUs, sodass Rack-Systeme im Vergleich zu 8-GPU-Single-Node-Systemen wie B300 weniger Vorteile haben. Der Vorsprung liegt bei etwa 20% gegenüber dem Rack-System GB300 NVL72 über den gesamten Bereich, und es ist an beiden Enden vorteilhaft.
➤ Bei 100 Toks/ Sekunde pro Benutzer führt GB300 mit ~261 Mio. Tokens/ Sekunde pro MW vor B300 (~220 Mio.), B200 (~193 Mio.), GB200 (~178 Mio.) und MI355X (~128 Mio.).
➤ Jeder Blackwell-System und der MI355X können eine Ausgabestärke von etwa 600 bis 670 tok/s für einen einzelnen Agenten erreichen (d.h. bei einer Batchgröße von eins), im Gegensatz zu 372 bis 392 tok/s auf H100 und H200
➤ V4.1 Flash ist sowohl intelligenter als V4 Pro 0813 als auch viel günstiger für die Bereitstellung, und er liefert im Vergleich zu seinem größeren Cousin eine Durchsatzrate von ~1,3x (GB300) bis ~6,2x (B200) pro MW bei 100 tok/s pro Nutzer.