
Die Auswahl des richtigen Modells für eine bestimmte Anwendung erfordert eine praktische Methode, um es mit repräsentativen Eingaben zu testen. Amazon SageMaker JumpStart bietet Zugang zu einem umfangreichen Katalog bereits vorgetrainierter Modelle. In diesem Artikel zeigen wir, wie man ein verfügbares Modell aus SageMaker JumpStart deployt, einen leichten und wiederholbaren Leistungstest mit dem SageMaker Python SDK durchführt und das Endpunkt nach Abschluss des Tests löscht. Für unterstützte Modelle und verfügbare Kapazitäten bietet diese Arbeitsweise einen wiederholbaren Bewertungspfad, obwohl die Einrichtungszeit je nach Modell, Instanztyp, Quoten und AWS-Region variiert.
Im Jahr 2026 führten SageMaker JumpStart zwei Verbesserungen ein, die die Entdeckung und Bereitstellung von Modellen vereinfachen. Im Bereich Model Hub der Amazon SageMaker AI-Konsole können Sie den SageMaker JumpStart-Katalog durchsuchen, Beispiel-Notebooks ansehen und diese direkt in SageMaker Studio öffnen. Die vorbereiteten Endpunkt-Deployment-Möglichkeiten bieten benannte Konfigurationen, die auf Prioritäten wie niedrige Kosten, geringe Latenzzeit oder allgemeine Workloads für eine Reihe von generativen AI-Modellen optimiert sind, einschließlich Neuron-optimierter Konfigurationen. Darüber hinaus kann man nun mit der neuen Deep-Link-Integration in einem einzigen Klick von der Model-Entdeckung auf Hugging Face bis zur SageMaker AI-Deployment gehen.
Lösungsüberblick
Unser Ansatz verwendet einen wiederverwendbaren Python-Skript, der drei Schritte ausführt:
- Entdecken und veröffentlichen Sie ein Modell über SageMaker JumpStart.
- Führen Sie spezifische Model-Mustreiche aus und messen Sie die Latenzzeit, den ungefähren Ausgabenlängen sowie die Generierungsrate für einzelne Anfragen.
- Bereinigen Sie den Endpunkt.
Dieses Muster funktioniert für viele kompatible SageMaker JumpStart-Modelle, obwohl die Payload-Formate, die erforderlichen Instanztypen, die Anforderungen des Endnutzergrundstücksvertrags (EULA) und die Antwort-Schemata möglicherweise spezifische Anpassungen des Modells erfordern.
Voraussetzungen
- Ein AWS-Konto mit SageMaker AI-Berechtigungen.
- Python 3+ mit dem SageMaker Python SDK v3 installiert (
pip install "sagemaker>=3,<4"). - Genügend GPU-Instanzquoten für das Modell, das Sie testen möchten, oder eine Quotenerhöhung anfordern.
Schritt 1.a: Erforschen der verfügbaren Modelle
UI-Pfad zur Suche nach Modellen in SageMaker JumpStart:
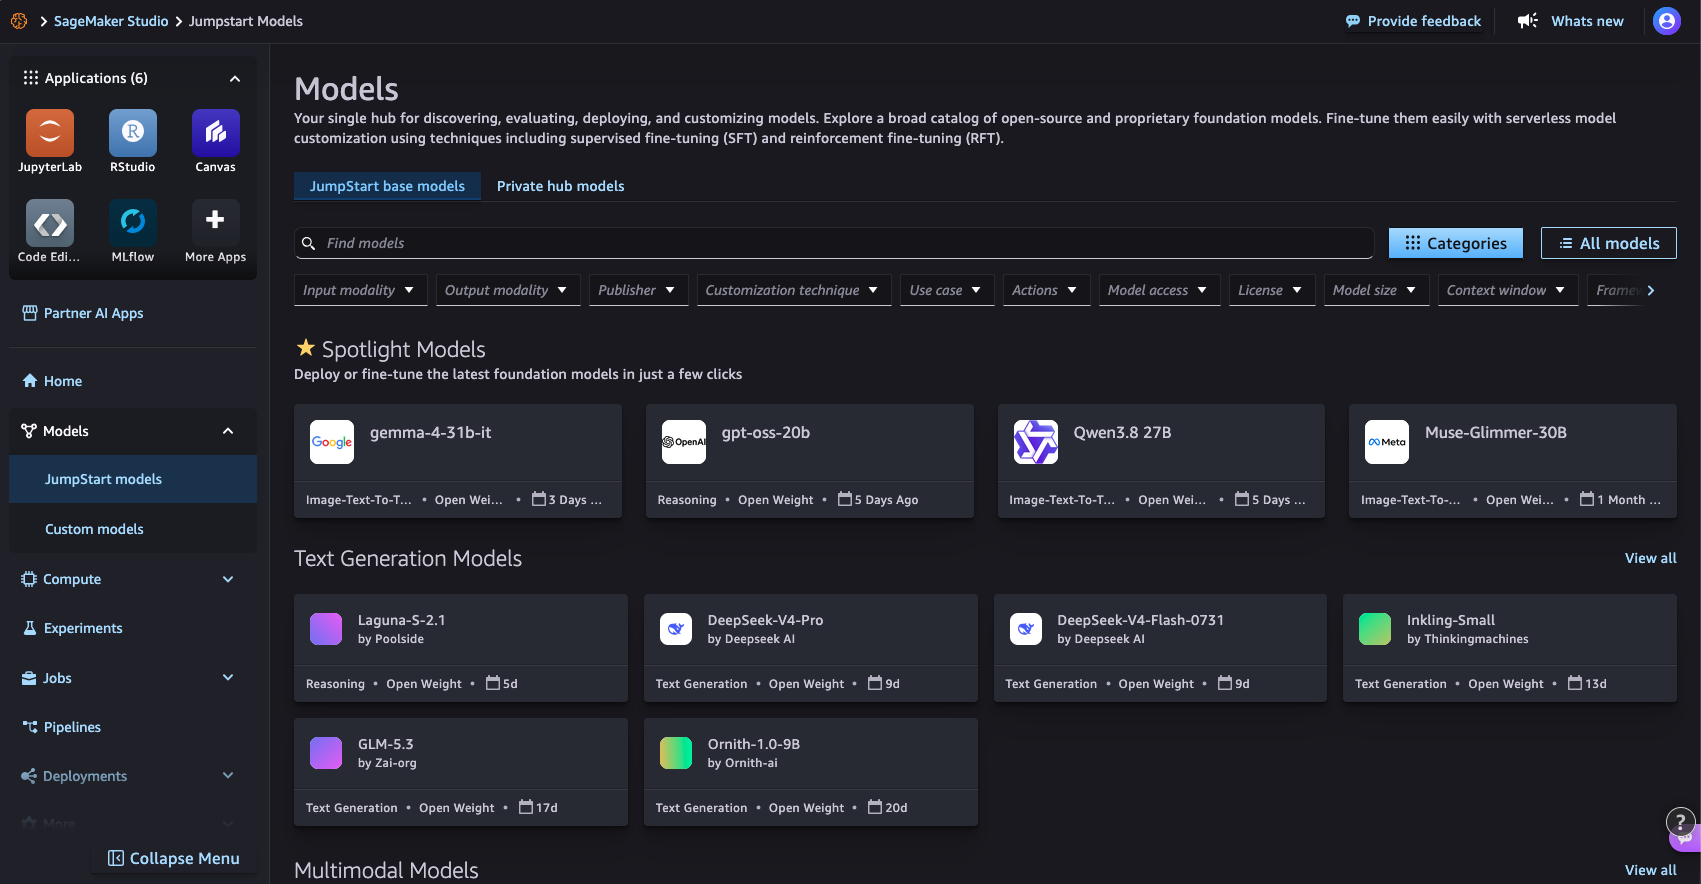
Abbildung 1: Durchsuchen des Modellkatalogs auf der SageMaker JumpStart Models-Seite in SageMaker Studio
Code-Pfad mit dem SageMaker Python SDK:
from sagemaker.core.jumpstart.notebook_utils import (
    list_jumpstart_models,
)

REGION = "us-east-1"

models = list_jumpstart_models(
    filter="task == textgeneration",
    region=REGION,
    list_versions=True,
)

print(f"Found {len(models)} text generation models")

for model_id, model_version in models[:10]:
    print(
        f" - {model_id} "
        f"(version {model_version})"
    )
Oder suchen Sie nach dem Modellnamen:
from sagemaker.core.jumpstart.notebook_utils import list_jumpstart_models

ids = list_jumpstart_models(
    filter="model_id contains qwen",
    region=REGION,
    list_versions=True,
)

print(f"{len(ids)} models matched in {REGION}\n")

for model_id, version in ids:
    print(f"{model_id:<55} v{version}")
Schritt 1.b: Deplizieren des Modells
UI-Pfad zur Verteilung von Modellen aus SageMaker JumpStart:
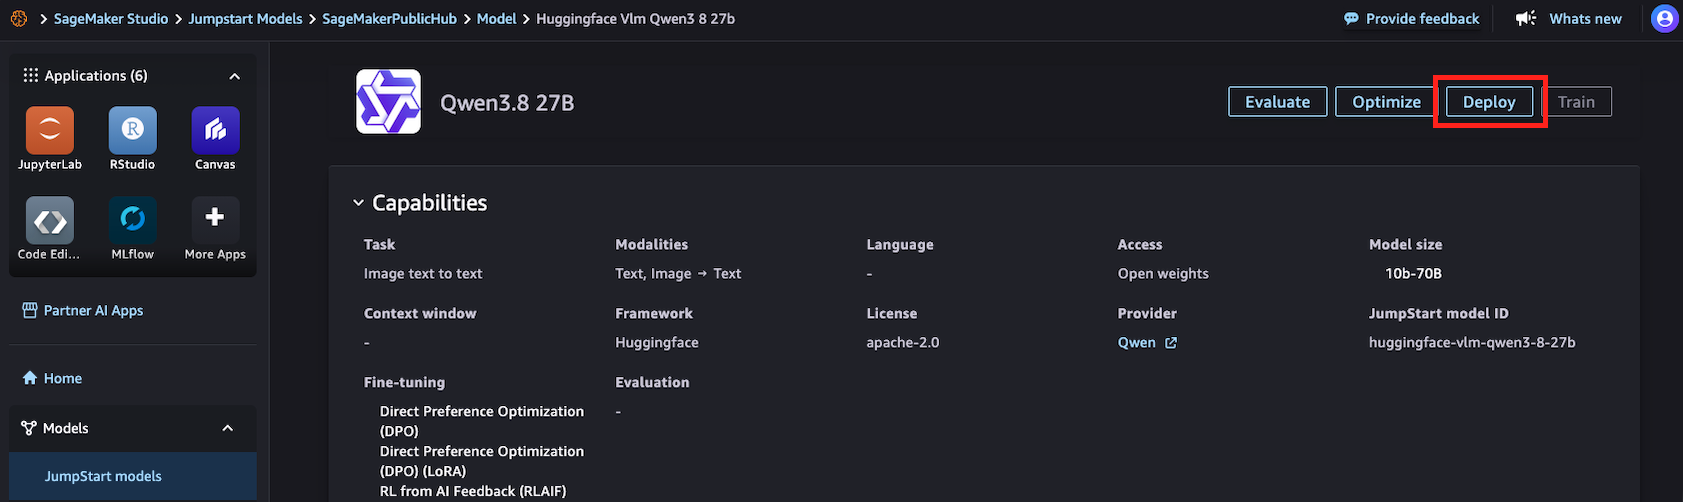
Abbildung 2: Einsetzen eines Modells von der Detailseite des SageMaker JumpStart in SageMaker Studio
Code-Pfad mit dem SageMaker Python SDK:
import time

from sagemaker.core.jumpstart.accessors import JumpStartModelsAccessor
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.core.training.configs import Compute
from sagemaker.serve import ModelBuilder

MODEL_ID = "huggingface-vlm-qwen3-5-27b"
MODEL_VERSION = "1.13.0"
REGION = "us-east-1"
ACCEPT_EULA = False  # Set True only after reviewing the model terms

def get_field(value, name, default=None):
    if isinstance(value, dict):
        return value.get(name, default)
    return getattr(value, name, default)

# Resolve the JumpStart-recommended deployment configuration.
specs = JumpStartModelsAccessor().get_model_specs(
    region=REGION,
    model_id=MODEL_ID,
    version=MODEL_VERSION,
)

if isinstance(specs, list):
    if not specs:
        raise ValueError(
            f"No JumpStart specification found for {MODEL_ID}"
        )
    specs = specs[0]

recommended_instance_type = get_field(
    specs,
    "default_inference_instance_type",
)

if not recommended_instance_type:
    raise ValueError(
        f"No recommended instance type found for {MODEL_ID}"
    )

print(f"Model: {MODEL_ID}")
print(f"Region: {REGION}")
print(f"Recommended instance: {recommended_instance_type}")

start = time.time()

jumpstart_config = JumpStartConfig(
    model_id=MODEL_ID,
    model_version=MODEL_VERSION,
    accept_eula=ACCEPT_EULA,
)

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    compute=Compute(
        instance_type=recommended_instance_type,
        instance_count=1,
    ),
)

model = model_builder.build()
endpoint = model_builder.deploy()
deploy_time = time.time() - start

print(f"Deployed in {deploy_time:.1f} seconds")
print(f"Endpoint: {endpoint.endpoint_name}")
Schritt 2: Führen Sie die Beispielanweisungen aus und messen Sie die Leistung
from sagemaker.core.payloads import retrieve_all_examples
import json
import time

MODEL_ID = "huggingface-vlm-qwen3-5-27b"
MODEL_VERSION = "1.13.0"
REGION = "us-east-1"

example_payloads = retrieve_all_examples(
    region=REGION,
    model_id=MODEL_ID,
    model_version=MODEL_VERSION,
    serialize=True,
)

#you can re-create the endpoint pointer using the endpoint name:
#from sagemaker.core.resources import Endpoint
#endpoint = Endpoint.get(endpoint_name="<your_endpoint_name>",region=REGION)

def read_response_body(result):
    body = result.body
    if hasattr(body, "read"):
        body = body.read()
    if isinstance(body, bytes):
        body = body.decode("utf-8")
    if isinstance(body, str):
        try:
            return json.loads(body)
        except json.JSONDecodeError:
            return body
    return body

def extract_output(response):
    """Handle common JumpStart text-generation response formats."""
    if isinstance(response, list):
        response = response[0] if response else ""
    if isinstance(response, dict):
        choices = response.get("choices")
        if choices:
            choice = choices[0]
            message = choice.get("message")
            if isinstance(message, dict):
                return message.get("content", "")
            return choice.get("text", "")
        for field in (
            "generated_text",
            "output_text",
            "text",
        ):
            if field in response:
                return response[field]
    return response

results = []

for payload in example_payloads or []:
    start = time.perf_counter()
    result = endpoint.invoke(
        body=payload.body,
        content_type=payload.content_type,
        accept=payload.accept,
    )
    latency = time.perf_counter() - start
    response = read_response_body(result)
    output = extract_output(response)
    if not isinstance(output, str):
        output = json.dumps(output, indent=2)
    # This is an estimate based on whitespace-separated words.
    output_words = len(output.split())
    results.append(
        {
            "request_preview": payload.body[:50],
            "latency_s": round(latency, 2),
            "estimated_output_words": output_words,
            "words_per_second": round(
                output_words / latency,
                1,
            ) if latency > 0 else 0,
        }
    )
    print("Input:\n", payload.body, end="\n\n")
    print("Output:\n", output, end="\n\n")
    print(
        f"Latency: {latency:.2f} seconds\n"
        f"Estimated output words: {output_words}\n"
        f"Estimated single-request output generation rate: "
        f"{output_words / latency:.1f} words/second\n"
    )
    print("-" * 80)

print("\nSummary:")
for result in results:
    print(result)
Ergebnis:
Input:
{"max_tokens": 256, "messages": [{"content": "What is deep learning?", "role": "user"}], "model": "/opt/ml/model"}
Output:
Here's a thinking process that leads to the explanation of deep learning:
1. **Deconstruct the Request:**
* **Question:** "What is deep learning?"
* **Intent:** The user wants a clear, comprehensive, yet accessible definition and overview of deep learning.
* **Target Audience:** Likely someone looking for a general understanding, possibly a student, tech
enthusiast, or professional exploring the field. The tone should be informative, structured, and
not overly jargon-heavy (though key terms need explanation).
2. **Initial Brainstorming & Key Concepts:**
* What is it? A subset of machine learning, which is a subset of AI.
* Core mechanism: Artificial Neural Networks (ANNs).
* "Deep" means many layers (hidden layers).
* How does it work? Learning representations from data (feature learning).
* Key applications: Image recognition, NLP, speech, self-driving cars.
* Why is it popular now? Big data, GPU power, better algorithms.
* Pros/Cons: High accuracy vs. black box, data hunger.
3. **Structuring the Answer:**
Latency: 9.07 seconds
Estimated output words: 153
Estimated single-request output generation rate: 16.9 words/second
--------------------------------------------------------------------------------
Summary:
{'request_preview': '{"max_tokens": 256, "messages": {"content": "What', 'latency_s': 9.07, 'estimated_output_words': 153, 'words_per_second': 16.9}
Schritt 3: Aufräumen
print(f"Deleting endpoint: {endpoint.endpoint_name}")
endpoint.delete()
endpoint.wait_for_delete()
print("Endpoint deleted")
Schlussfolgerung
Dieses Muster funktioniert für viele verfügbare SageMaker JumpStart-Modelle, aber das Payload-Format, der erforderliche Instance-Typ, das EULA und die Antwort-Parsing erfordern möglicherweise spezifische Anpassungen des Models. Durch die Verwendung konsistenter Testanfragen und die Messung von Latenz, Durchsatz und Ausgabekualität zwischen den Modellen können Sie die Optionen vergleichen und das richtige Modell für Ihre Arbeitslast auswählen.
Probieren Sie diese Vorgehensweise mit verschiedenen Modellen von Amazon SageMaker JumpStart aus, um den richtigen Ausgleich zwischen Qualität, Geschwindigkeit und Kosten für Ihre Anwendungen zu finden.
Referenzen
- SageMaker Python SDK Dokumentation
- Benchmark und Optimieren von SageMaker JumpStart-Deployment (Blogartikel)
- Von Hugging Face zu SageMaker Studio in einem Klick (Blogbeitrag)
- Amazon SageMaker JumpStart