
Ein Team im Finanzdienstleistungsbereich verbringt jede Woche erhebliche Zeit damit, manuell Kundenpräsentationen in PowerPoint aus Quartalsberichten, Compliance-Dokumenten und Marktanalysen zu erstellen. Jede Präsentation erfordert das Lesen von Hunderten von Seiten, das Extrahieren wichtiger Datenpunkte, das Strukturieren von Folien und das Erstellen unterstützender Visualisierungen. Dieser Beitrag führt Sie durch den Aufbau eines KI-Agentensystems mit Amazon Bedrock AgentCore , das diesen Workflow automatisiert und in unseren internen Tests in weniger als 90 Sekunden abschließt. Dieser Ansatz verkürzt die Zeit zur Erstellung von Präsentationen und fundiert gleichzeitig die Inhalte in den Quelldokumenten. Die Lösung stellt einen Supervisor-Agenten auf der AgentCore Runtime bereit, einer Funktion von Amazon Bedrock AgentCore, und verwendet das Strands Agents -Framework, um Tools zur Dokumenterstellung und Zusammenfassung zu orchestrieren. Anthropic Claude Sonnet 4.6 (verfügbar auf Amazon Bedrock) übernimmt die Inhaltserstellung, Amazon Titan Text Embeddings v2 ermöglicht die Vektorsuche, und Stability AI Stable Image Inpaint (verfügbar auf Amazon Bedrock) generiert Folienbilder. Dieser Beitrag enthält ein öffentliches Repository mit den Code-Assets.
Übersicht über die Lösung
Die Lösung stellt einen einzelnen Supervisor-Agenten auf der Amazon Bedrock AgentCore Runtime bereit, der anhand von Benutzeranfragen zwischen Tools zur Dokumenterstellung und Zusammenfassung auswählt. Eine Retrieval Augmented Generation (RAG)-Pipeline nutzt Amazon OpenSearch Serverless für die Vektorspeicherung und semantische Suche über multimodale Inhalte hinweg.
Die Lösung umfasst eine REST-API, die mit .NET 8 Minimal-APIs erstellt wurde, sodass Sie sich über Standard-HTTP-Aufrufe in bestehende Unternehmensanwendungen integrieren können. AWS Lambda bietet serverlose Rechenleistung, einschließlich containerisierter Funktionen für die PowerPoint-Generierung. Die Lösung sichert die Implementierung ab mit Amazon Virtual Private Cloud (Amazon VPC) -Isolation, AWS Key Management Service (AWS KMS) -Verschlüsselung und AWS Identity and Access Management (IAM) -Zugriffskontrolle nach dem Least-Privilege-Prinzip.
Zentrale Konzepte
Dieser Abschnitt behandelt die AgentCore Runtime, RAG und Sicherheitsschutzmechanismen für Inhalte im Hinblick auf ihre Anwendung in dieser Lösung.
Agentenorchestrierung mit Amazon Bedrock AgentCore
Ein einzelner KI-Agent, der Dokumente aus großen Wissensbasen generiert, muss Inhalte abrufen, Gliederungen strukturieren, Texte erzeugen, Bilder erstellen und Dateien zusammenstellen. Anstatt diese konkurrierenden Verantwortlichkeiten in einer monolithischen Funktion zu implementieren, verwendet die Lösung eine toolbasierte Architektur, bei der ein Supervisor-Agent Anfragen an spezialisierte Tools weiterleitet.
Die Amazon Bedrock AgentCore Runtime bietet eine Plattform zum Erstellen, Verbinden und Optimieren von Agenten in großem Maßstab, mit jedem Framework und Modell. Der Agentencode läuft in einem isolierten Container mit Sitzungsverwaltung, integrierter Identität und Observability. Die Lösung verwendet das Strands Agents Framework (ein Open-Source-SDK zum Erstellen von KI-Agenten), um die Supervisor-Logik zu implementieren.
Der Supervisor-Agent stellt zwei Tools bereit:
- generate_pptx: Erstellt PowerPoint-Präsentationen durch Aufruf der PPTX Generator Lambda-Funktion, die Inhalte aus der Wissensbasis abruft, Folien-Gliederungen generiert, KI-Bilder erstellt und das endgültige Dokument zusammenstellt.
- generate_summary: Extrahiert und synthetisiert Informationen aus der Wissensbasis mithilfe von RAG, um präzise, fundierte Antworten zu liefern.
Der Agent bestimmt, ob eine Anfrage die Dokumenterstellung, die Inhaltszusammenfassung oder beides erfordert, und ruft dann das entsprechende Tool auf. Sie können neue Funktionen hinzufügen, indem Sie neue Tools im Agentencode definieren, ohne bestehende zu ändern.
Retrieval Augmented Generation (RAG) für Unternehmenswissen
RAG begegnet einer grundlegenden Herausforderung in KI-Systemen: der Bereitstellung präziser, aktueller Informationen, die in Unternehmensdaten fundiert sind, anstatt sich ausschließlich auf die Trainingsdaten des Modells zu verlassen. Die Implementierung verwendet Amazon Bedrock Knowledge Bases, die Vektorsuche mit großen Sprachmodellen (LLMs) kombinieren, um vor der Antwortgenerierung relevanten Kontext abzurufen.
Die RAG-Pipeline funktioniert wie folgt:
- Sie laden Unternehmensdokumente hoch zu Amazon Simple Storage Service (Amazon S3).
- Das System zerlegt und parst Dokumente in Chunks und wendet eine besondere Verarbeitung für multimodale Inhalte an, darunter Tabellen, Diagramme und Bilder.
- Amazon Titan Text Embeddings v2 wandelt jeden Chunk in hochdimensionale Vektoren um, die die semantische Bedeutung erfassen.
- Amazon OpenSearch Serverless speichert die Vektoren und erstellt dadurch eine durchsuchbare Vektordatenbank.
- Zum Zeitpunkt einer Abfrage wandelt das System die Anfrage des Benutzers in ein Embedding um und führt eine Ähnlichkeitssuche durch, um relevante Dokument-Chunks abzurufen.
- Die abgerufenen Chunks liefern dem Sprachmodell Kontext, das Antworten generiert, die auf dem Quellmaterial basieren.
Dieser Ansatz soll dazu beitragen, halluzinierte Inhalte zu reduzieren, indem generierte Dokumente in Quellinformationen aus der Unternehmenswissensbasis verankert werden.
Hinweis: Die Datenebene der Amazon OpenSearch Serverless Collection muss öffentlich zugänglich bleiben, da Amazon Bedrock Knowledge Bases von der AWS-verwalteten Infrastruktur aus auf Amazon OpenSearch Serverless zugreift und nicht über kundeneigene VPC-Endpunkte. IAM-Datenzugriffsrichtlinien schützen die Collection, und VPC-only-Zugriff schränkt das Amazon OpenSearch Serverless Dashboard ein.
Amazon Bedrock Guardrails für Inhaltssicherheit
Enterprise-KI-Anwendungen erfordern Inhaltsmoderation, um organisatorische Standards und Compliance-Anforderungen zu erfüllen. Amazon Bedrock Guardrails bietet integrierte Inhaltsfilterung und Sicherheitsmechanismen, die durchgehend in die Dokumentenerstellung-Pipeline eingebunden sind.
Guardrails wirken in mehreren Phasen:
- Eingabeverarbeitung: Filtert Benutzeranfragen, um umgekehrungsbezogene Probleme und unangemessene Inhalte zu verhindern.
- Ausgabegenerierung: Überwacht Modellausgaben, um die Einhaltung von Inhaltsrichtlinien zu prüfen.
- Verarbeitung personenbezogener Daten (PII): Erkennt und anonymisiert oder blockiert PII.
Die Implementierung erstellt benutzerdefinierte Guardrails über das AWS Cloud Development Kit (AWS CDK), konfiguriert mit spezifischen Richtlinien, die auf die Unternehmensdokumentenerstellung zugeschnitten sind. Der Agent wendet die Guardrails auf der Ebene des Modellaufrufs an und gewährleistet so eine konsistente Inhaltssicherheit ohne manuelle Konfiguration für jede Bereitstellung.
Lösungsarchitektur
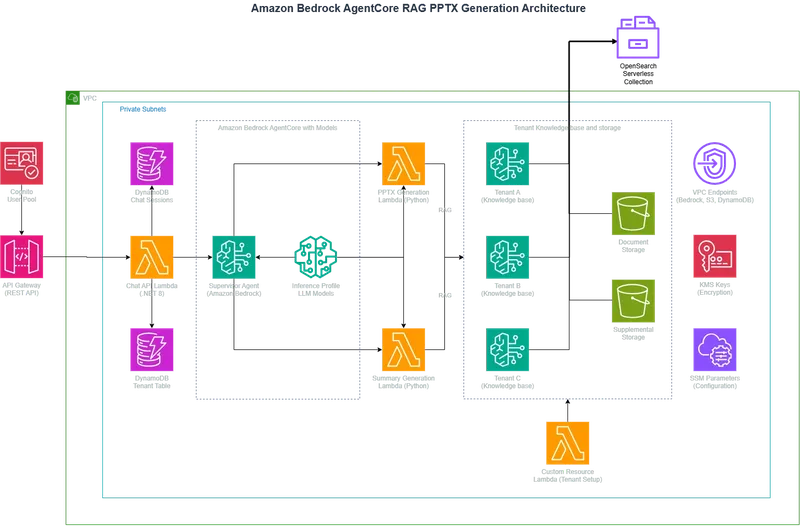
Das folgende Diagramm veranschaulicht das agentenbasierte Dokumentenerstellungssystem.
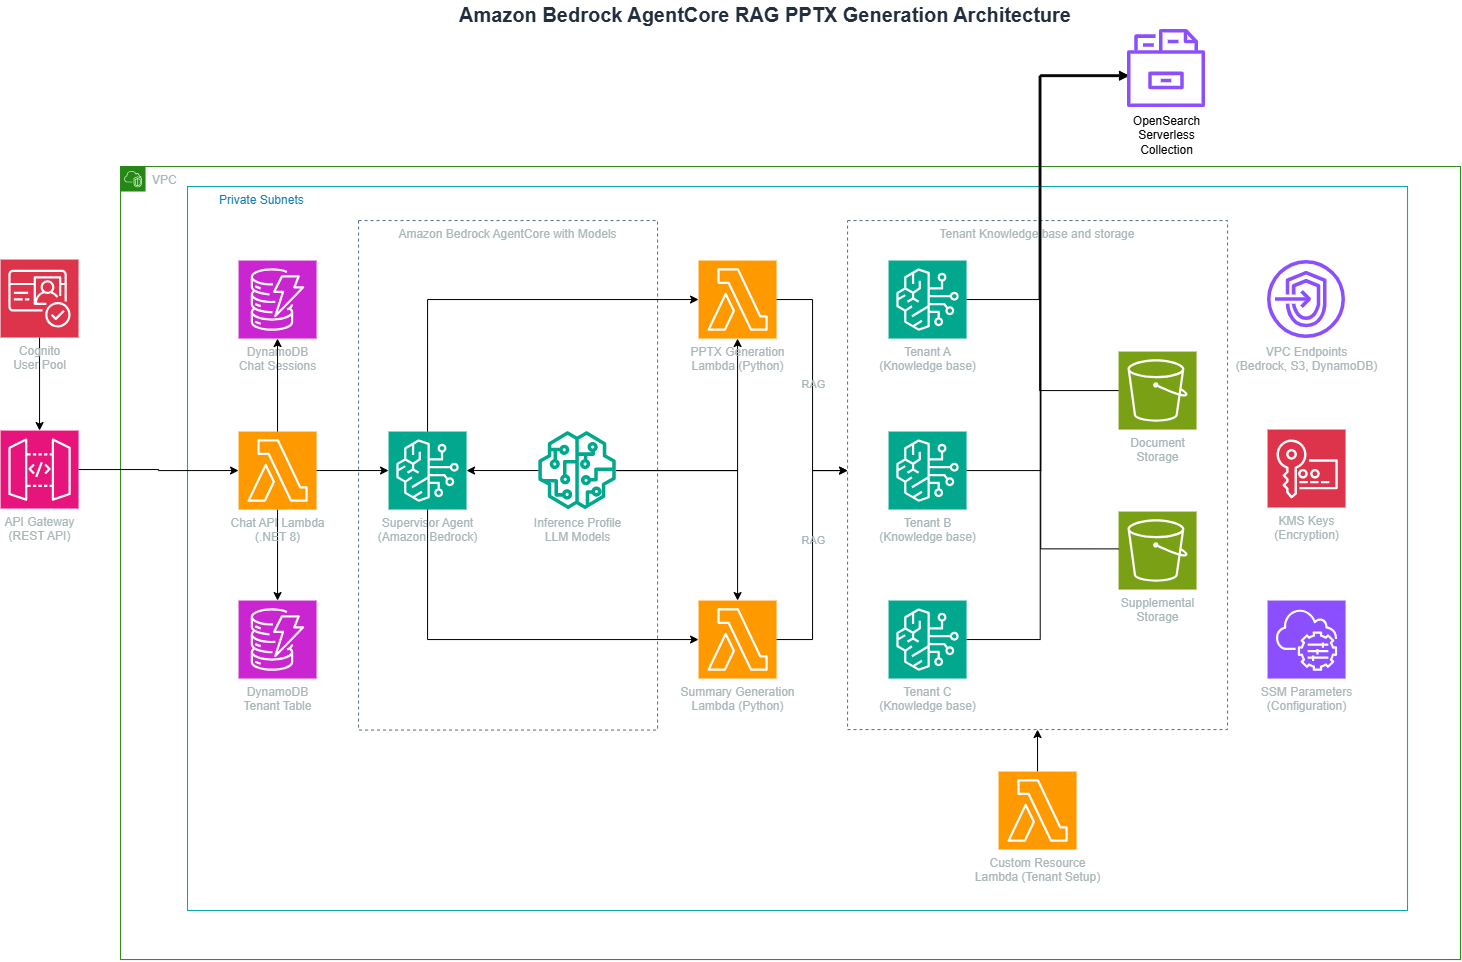
Abbildung 1: Architektur des Amazon Bedrock AgentCore RAG-Präsentationserstellungssystems
Der Datenfluss beginnt mit Benutzeranfragen, die über das Amazon API Gatewayeingehen und an eine .NET-basierte Chat-API weitergeleitet werden, die auf AWS Lambdaausgeführt wird. Die API verwaltet den Konversationsstatus in Amazon DynamoDB. Anschließend ruft sie den Supervisor-Agenten auf, der auf der Amazon Bedrock AgentCore Runtime gehostet wird.
Der Supervisor-Agent analysiert die Anfrage und wählt das geeignete Werkzeug aus. Für die Dokumentenerstellung ruft er die PPTX Generator Lambda-Funktion auf (eine containerisierte Python-Funktion). Für die Zusammenfassung ruft der Supervisor die Summary Generator Lambda-Funktion auf, die die Wissensbasis über die retrieve_and_generate API abfragt.
Das System verarbeitet Dokumente, die in Amazon S3 gespeichert sind, in Blöcke und erzeugt Einbettungen mithilfe von Amazon Titan Text Embeddings v2. Amazon OpenSearch Serverless indiziert die Einbettungen für eine schnelle semantische Suche. Wenn Werkzeuge die Wissensbasis abfragen, ruft Amazon OpenSearch Serverless relevante Blöcke ab, die anschließend als Kontext an Anthropic Claude Sonnet 4.6 (auf Amazon Bedrock) übergeben werden, um fundierte Antworten zu generieren.
Das System speichert generierte Dokumente in Amazon S3 und gibt Presigned URLs für einen sicheren Download zurück. Zu den Sicherheitsmaßnahmen gehören:
- AWS WAF mit verwalteten Regelsätzen und IP-basiertem Ratenlimiting auf Amazon API Gateway.
- Amazon Cognito mit dem Plus-Funktionsplan und dem erweiterten Sicherheitsmodus für Bedrohungsschutz.
- Amazon Bedrock Guardrails, bereitgestellt über AWS CDK für konsistente Inhaltsfilterung.
- Amazon DynamoDB mit Point-in-Time-Recovery, Löschschutz und AWS-KMS-Verschlüsselung durch den Kunden verwaltet.
- Amazon S3-Buckets mit Versioning, Server-Zugriffsprotokollierung und Blockierung öffentlichen Zugriffs.
- AWS X-Ray Tracing auf Lambda-Funktionen für verteiltes Debugging.
- Eingabevalidierung mit regex-basierter Überprüfung von Tenant-ID und Session-ID.
- Tenant-Isolation durch AWS Security Token Service (AWS STS) Rollenübernahme pro Tenant.
Voraussetzungen
Vor der Bereitstellung benötigen Sie die folgenden Tools und Zugriffe, die in Ihrer Umgebung konfiguriert sein müssen:
- AWS-Umgebung:
- Ein aktives AWS-Konto mit Berechtigungen für die Bereitstellung von Infrastruktur.
- AWS Command Line Interface (AWS CLI), konfiguriert mit Anmeldeinformationen.
- IAM-Rolle mit geeigneten Service-Zugriffsrichtlinien.
- Entwicklungstools:
- .NET SDK 8 mit global installiertem Amazon.Lambda.Tools.
- Python 3.12 oder höher für AWS CDK und Lambda-Funktionen.
- Node.js und AWS CDK CLI für die Infrastruktur-Bereitstellung.
- Docker oder Finch zum Erstellen von Container-Images (ARM64-Unterstützung erforderlich).
- Zugriff auf AWS-Services:
- Amazon Bedrock mit Modellzugriff für Anthropic Claude Sonnet 4.6, Amazon Titan Text Embeddings v2 und Stability AI Stable Image Inpaint (verfügbar über Amazon Bedrock). Informationen zur Modellverfügbarkeit nach Region finden Sie unter Supported models by AWS Region in Amazon Bedrock.
- In Ihrem Konto aktivierter Zugriff auf Amazon Bedrock AgentCore.
- Das Timeout der Regional-REST-API-Integration von Amazon API Gateway ist auf mindestens 300 Sekunden konfiguriert. Der Standardwert beträgt 29 Sekunden. Weitere Informationen finden Sie unter API Gateway quotas.
- Ein vorhandenes Amazon VPC mit privaten Subnetzen.
- Ein Amazon S3-Bucket für Bereitstellungsartefakte.
Richten Sie die Lösung ein
Der Einrichtungsprozess umfasst das Konfigurieren der Bereitstellungsparameter und das Initialisieren der AWS CDK-Umgebung.
- Klonen Sie das Repository und wechseln Sie in das Projektverzeichnis:
git clone https://github.com/aws-samples/sample-generating-powerpoint-presentations-with-amazon-bedrock.git - Erstellen Sie die Konfigurationsdatei
pipeline-params.iniim Stammverzeichnis des Repositorys:environment=dev awscliprofile= ContainerRegistry=lambda-pptx-gen AgentContainerRegistry=agentcore-supervisor BucketDev=<amzn-s3-demo-bucket> VpcId=<your-vpc-id> ParsingInferenceProfileId=us.anthropic.claude-haiku-4-5-20251001-v1:0 AgentInferenceProfileId=us.anthropic.claude-sonnet-4-6 EmbeddingModelId=amazon.titan-embed-text-v2:0 ImageGenerationModelId=stability.stable-image-inpaint-v1:0 PPTXGenImageTag=latest AgentImageTag=latestSetzen Sie
awscliprofileauf den Namen Ihres AWS-CLI-Profils oder lassen Sie das Feld leer, um Anmeldeinformationen aus Umgebungsvariablen zu verwenden. - Bootstrap von AWS CDK durchführen (einmalig pro Konto und Region):
cdk bootstrapDadurch wird der AWS CloudFormation -Stack CDKToolkit erstellt, der für AWS CDK-Bereitstellungen erforderlich ist.
- Machen Sie die Build-Skripte ausführbar:
chmod +x ./pipeline-build.sh
chmod +x ./pipeline-deploy.sh
chmod +x ./deploy-agentcore.sh
Build und Bereitstellung
Die Bereitstellung besteht aus drei Phasen: dem Erstellen der Artefakte, dem Bereitstellen der Infrastruktur und dem Bereitstellen des AgentCore-Runtime-Agenten.
Build-Phase
Die Build-Phase kompiliert den Anwendungscode und paketiert die Deployment-Artefakte. Führen Sie das Build-Skript aus:
./pipeline-build.shDies kompiliert die .NET-Projekte (Chat API) und paketiert sie als Lambda-Deployment-Pakete. Es erstellt das PPTX Generator-Container-Image mit Docker oder Finch und authentifiziert sich bei Amazon Elastic Container Registry (Amazon ECR). Anschließend pusht es das Container-Image und speichert die Build-Artefakte im asset-output Verzeichnis.
Phase der Infrastruktur-Bereitstellung
Die Infrastruktur-Bereitstellung erstellt AWS-Ressourcen und konfiguriert Service-Integrationen. Führen Sie das Deployment-Skript aus:
./pipeline-deploy.shDas Deployment erstellt vier AWS CloudFormation-Stacks in Abhängigkeitsreihenfolge:
- VPCEndpointsStack: Konfiguriert Amazon VPC-Endpunkte für AWS-Services einschließlich Amazon Bedrock AgentCore.
- OpensearchStack: Stellt eine Amazon OpenSearch Serverless Collection für Vektorspeicher bereit.
- AgentCoreStack: Erstellt Guardrails und Lambda-Funktionen sowie IAM-Rollen und speichert die Konfiguration im AWS Systems Manager Parameter Store.
- ChatApiStack: Stellt Amazon API Gateway und die Chat API Lambda bereit.
AgentCore Runtime-Deployment
Nachdem die Infrastruktur-Stacks bereitgestellt wurden, deployen Sie den Supervisor-Agenten in der AgentCore Runtime:
./deploy-agentcore.shDieses Skript erstellt das Supervisor-Agenten-Container-Image (ARM64), pusht es zu Amazon ECR, erstellt die AgentCore Runtime und den Endpunkt und aktualisiert den Systems Manager Parameter mit dem Amazon Resource Name (ARN) des Endpunkts. Die Chat API verweist auf diese Endpunkt-ARN, um Anfragen an den Agenten weiterzuleiten.
Nach dem Deployment umfassen die AWS CloudFormation-Outputs die Amazon API Gateway-Endpunkt-URL und Ressourcen-Bezeichner.
Konfiguration
Die Lösung bietet mehrere Konfigurationspunkte:
Agenten-Anweisungen
Bearbeiten agent/app.py um den System-Prompt und das Verhalten des Supervisor-Agenten anzupassen. Der Agent verwendet Strands Agents mit zwei in definierten Tools agent/tools.py:
- generate_pptx: Ruft die PPTX Generator Lambda zur Dokumenterstellung auf.
- generate_summary: Ruft die Summary Generator Lambda für Wissensdatenbank-Abfragen auf.
Modellauswahl
In pipeline-params.ini, passen Sie die Modell-Identifikatoren an:
ParsingInferenceProfileId: Modell für das Parsen von Wissensdatenbank-Dokumenten (Anthropic Claude Haiku 4.5 wird aus Kostengründen empfohlen).AgentInferenceProfileId: Modell für Agenten-Reasoning (Anthropic Claude Sonnet 4.6 empfohlen).EmbeddingModelId: Embedding-Modell für die Vektorsuche (Amazon Titan Text Embeddings v2).ImageGenerationModelId: Modell für die Erstellung von Folienbildern (Stability AI Stable Image Inpaint).
Mit Inference-Profilen anstelle direkter Modell-IDs greifen Anfragen auf einen größeren Multi-Region-Kapazitätspool zu, was den Durchsatz erhöht und hilft, eine konsistente Leistung unter Last aufrechtzuerhalten.
Lambda-Konfiguration
Passen Sie die Compute-Ressourcen in den Stack-Dateien an:
- Chat API: 128 MB Speicher, 29 Sekunden Timeout, 100 reservierte Concurrency (in
api.py). - PPTX Generator: 900 MB Speicher, 300 Sekunden Timeout, 50 reservierte Concurrency (in
pptx_gen.py). - Summary Generator: 512 MB Speicher, 300 Sekunden Timeout, 50 reservierte Concurrency (in
sum_gen.py).
Ergebnisse
In internen Tests mit einem 90-seitigen Amazon 2024 Annual Report -PDF erzeugte die Lösung die folgenden Leistungskennzahlen:
- Zeit für die Präsentationserstellung: 70–90 Sekunden End-to-End (einschließlich Wissensdatenbank-Abruf, Inhaltserstellung, Bilderstellung und Dateizusammenstellung).
- Anzahl der Folien: Sechs Folien mit den Formaten Titel, Aufzählungspunkte, Bild+Text, nur Bild und Kernaussage.
- Bilderzeugung: Zwei KI-generierte Bilder pro Präsentation unter Verwendung von Stability AI Stable Image Inpaint.
- Kosten pro Generierung: Etwa 0,04 US-Dollar an Modell-Aufrufkosten zum Zeitpunkt der Erstellung in us-east-1 (Text- und Bilderzeugung, wobei die Bilderzeugung den Großteil der Kosten ausmacht).
- Aufnahme in die Wissensbasis: Weniger als 2 Minuten für ein einzelnes 1,3 MB großes PDF-Dokument.
PowerPoint-Präsentationen
Die folgenden Abbildungen zeigen Beispielfolien aus einer generierten Präsentation.
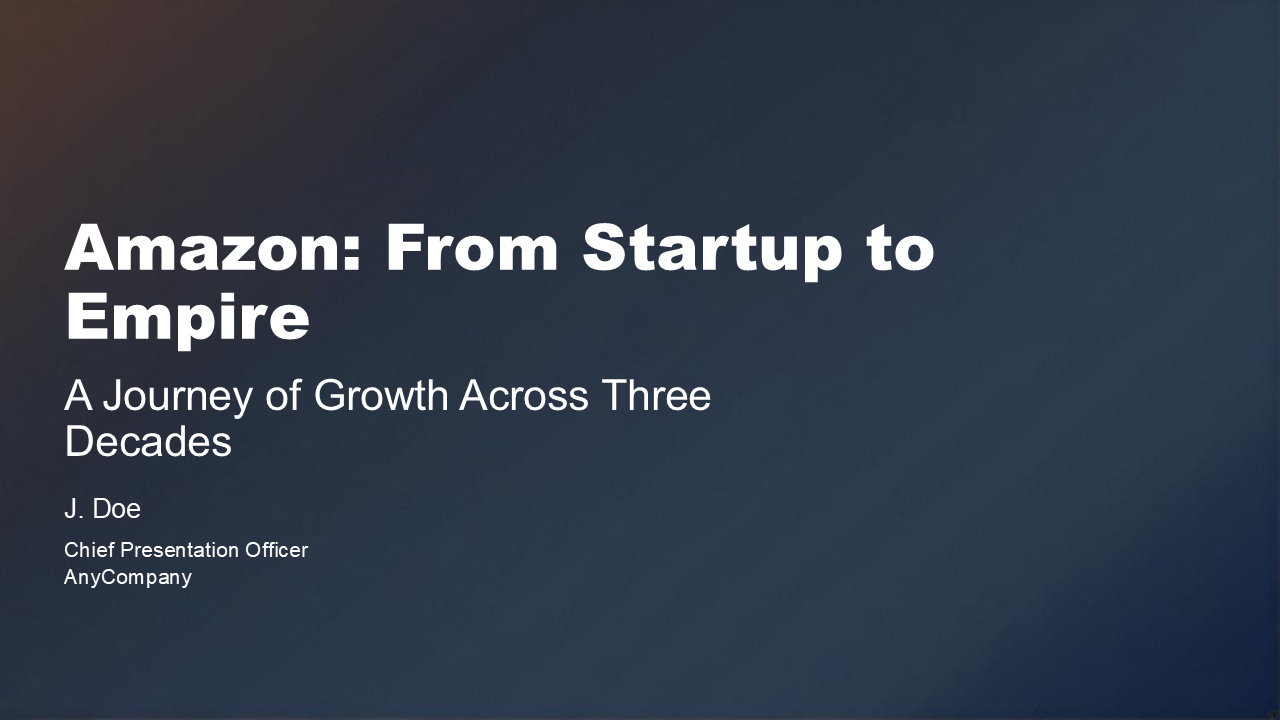
Abbildung 2: Generierte Titelfolie mit anpassbarem Branding
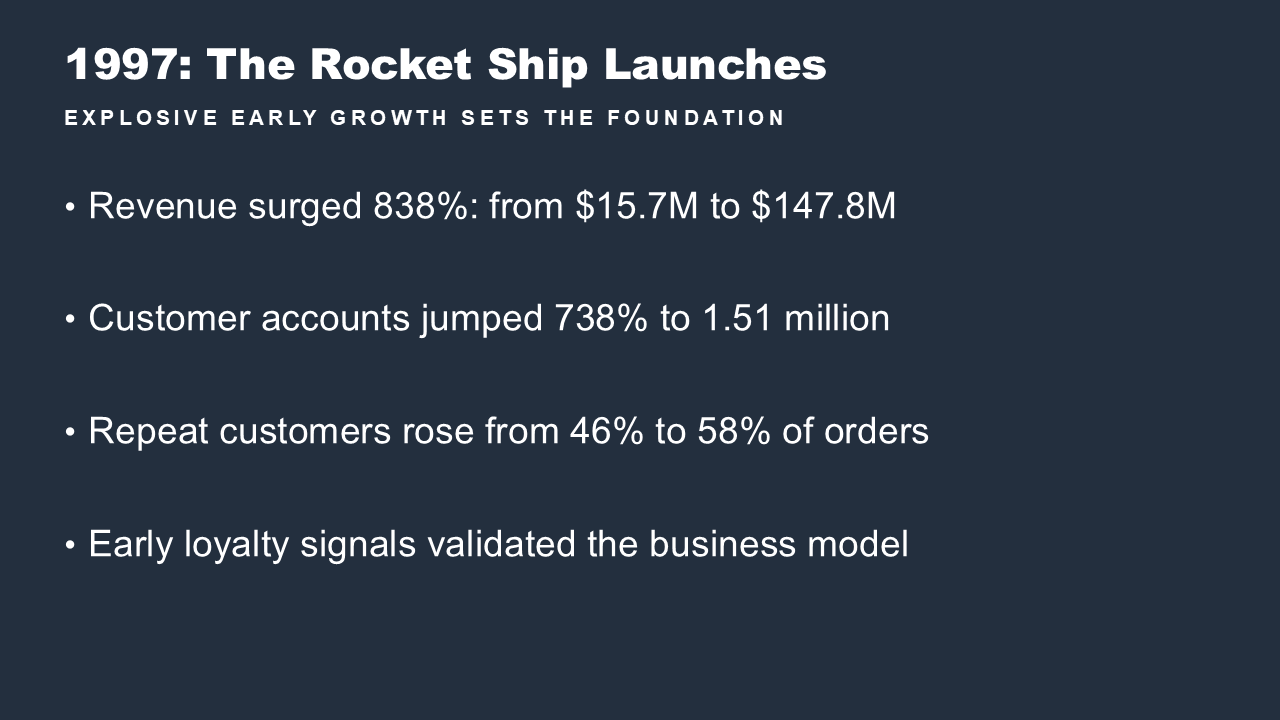
Abbildung 3: Generierte Inhaltsfolie mit Aufzählungspunkten
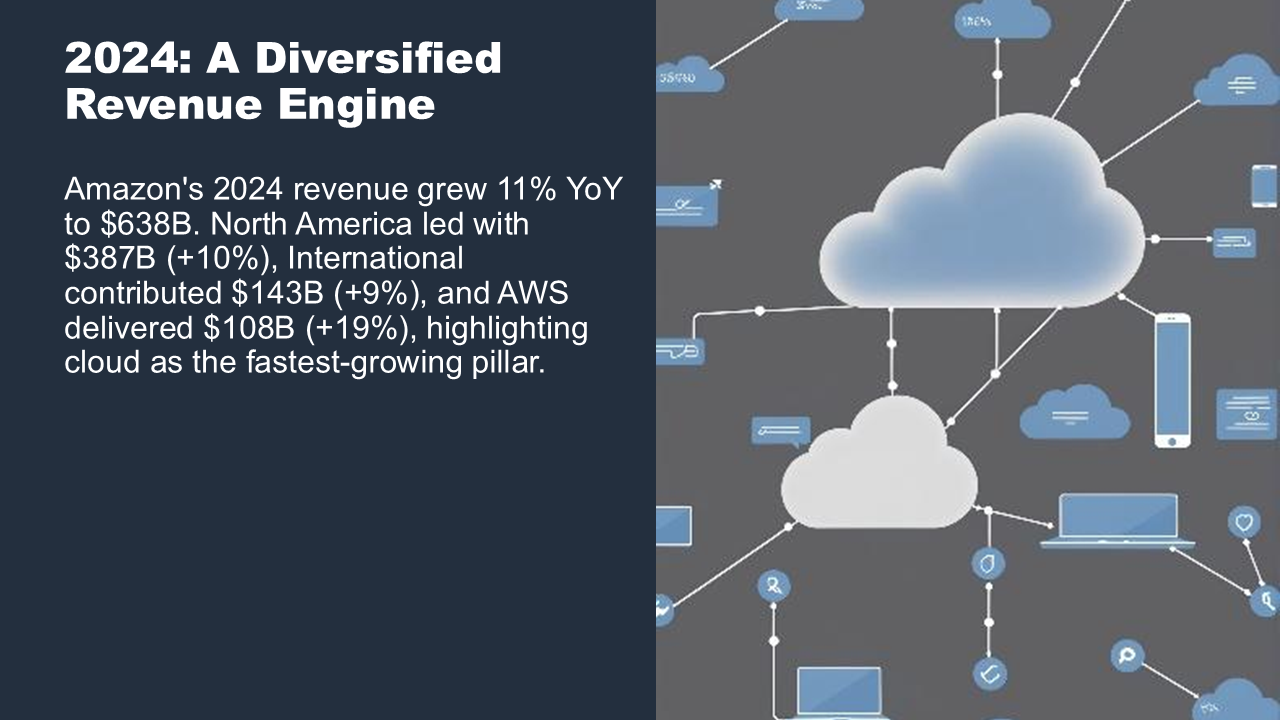
Abbildung 4: Generierte Folie, die Text mit einem KI-generierten Bild kombiniert
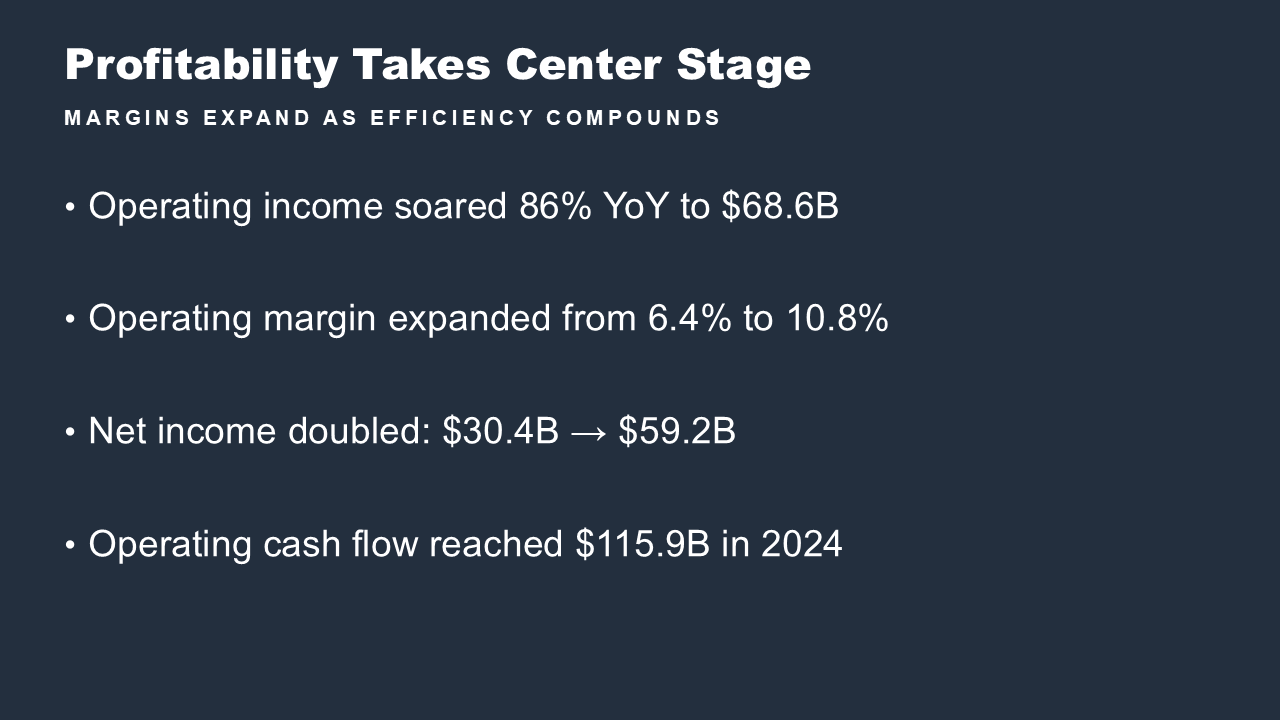
Abbildung 5: Generierte Inhaltsfolie mit einer Zusammenfassung der Rentabilitätskennzahlen
Abbildung 6: Generierte Folie nur mit Bild und einer KI-generierten Grafik
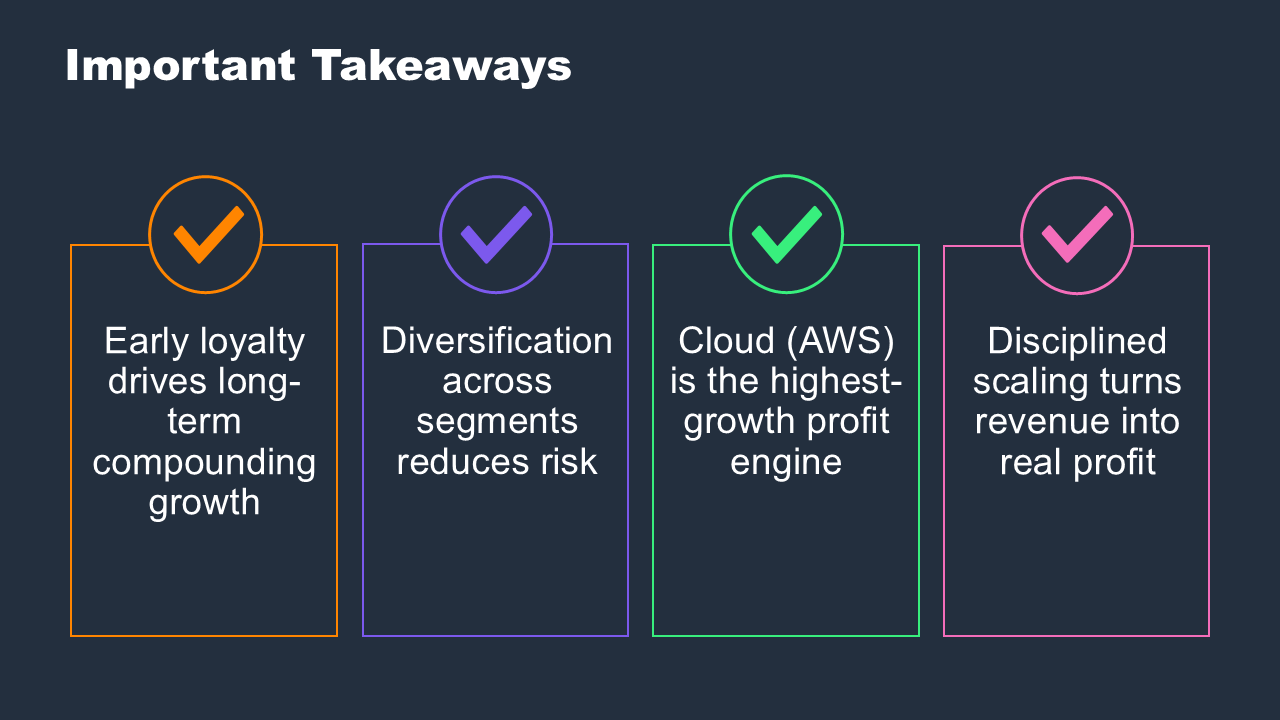
Abbildung 7: Generierte Key-Takeaways-Folie
Generierte Präsentationen umfassen:
- Titelfolien mit anpassbarem Branding.
- Inhaltsfolien mit Aufzählungspunkten und strukturiertem Text.
- Bildfolien mit KI-generierten Visualisierungen von Stability AI Stable Image Inpaint (auf Amazon Bedrock).
- Sprechernotizen mit Präsentationshinweisen.
- Konsistentes Formatierung basierend auf Unternehmensvorlagen.
Zusammenfassungen
Der Wissensbasis bereitgestellte Zusammenfassungsausgaben umfassen:
- Prägnante Synthese der Inhalte der Wissensbasis.
- Nachverfolgung von Quellenverweisen zu den Ursprungsdokumenten.
- Strukturierte Formatierung mit hervorgehobenen Kernpunkten.
API-Antworten
Die Chat-API gibt zurück:
- Streaming-Antworten für Echtzeit-Feedback der Nutzer. Da interne Tests zeigten, dass die Präsentationserstellung 70–90 Sekunden dauert (und damit das standardmäßige 29-Sekunden-Integrations-Timeout von Amazon API Gateway überschreitet), verwendet die Chat-API ein asynchrones Aufrufmuster. Verwenden Sie Streaming oder Polling, um das Endergebnis zu erhalten, anstatt auf einen synchronen REST-Aufruf zu warten.
- Beibehaltung des Konversationskontexts über mehrere Gesprächsrunden hinweg.
- Amazon S3 presigned URLs für Dokumentdownloads (5-minütige Ablaufzeit).
Generierte Inhalte werden vor der Auslieferung einer Amazon Bedrock Guardrails-Validierung unterzogen, um die Einhaltung von Inhaltsrichtlinien zu überprüfen.
Aufräumen
Um laufende Kosten zu vermeiden, löschen Sie die bereitgestellten Ressourcen:
- Löschen Sie die AgentCore-Runtime und den Endpunkt:
aws bedrock-agentcore-control delete-agent-runtime-endpoint \ --agent-runtime-id <runtime-id> \ --agent-runtime-endpoint-id <endpoint-id> aws bedrock-agentcore-control delete-agent-runtime \ --agent-runtime-id <runtime-id> - Deaktivieren Sie den Amazon DynamoDB-Löschutz (erforderlich vor dem Löschen des Stacks):
aws dynamodb update-table --table-name chat-sessions-dev --no-deletion-protection-enabled aws dynamodb update-table --table-name tenant-table-dev --no-deletion-protection-enabled - Löschen Sie AWS CloudFormation-Stacks in umgekehrter Abhängigkeitsreihenfolge:
aws cloudformation delete-stack --stack-name ChatApiStack aws cloudformation delete-stack --stack-name AgentCoreStack aws cloudformation delete-stack --stack-name OpensearchStack aws cloudformation delete-stack --stack-name VPCEndpointsStack - Leeren Sie Amazon S3-Buckets vor dem Löschen (AWS CloudFormation kann nicht leere Buckets nicht löschen):
aws s3 rm s3://amzn-s3-demo-bucket --recursive - Löschen Sie Amazon ECR-Repositories mit Container-Images:
aws ecr delete-repository --repository-name lambda-pptx-gen --force aws ecr delete-repository --repository-name agentcore-supervisor --force - Löschen Sie Sub-Stacks von Mandanten-Wissensbasen (erstellt vom Mandanten-Provisionierer):
aws cloudformation delete-stack --stack-name bedrock-kb-<tenant-id>
Sicherheitsaspekte
Diese Lösung verwendet Lambda-Umgebungsvariablen für Konfigurationswerte wie Modell-IDs, Amazon-S3-Bucket-Namen und Guardrail-IDs. Dabei handelt es sich um Ressourcenkennungen, nicht um Geheimnisse. Für Produktionsbereitstellungen verwenden Sie AWS Secrets Manager für sensible Konfigurationswerte wie API-Schlüssel und Datenbankanmeldeinformationen.
Der AgentCore-Runtime-Agent läuft in einem isolierten Container mit Isolation auf Sitzungsebene. Jede Benutzersitzung arbeitet in einer dedizierten Umgebung, was hilft, eine datenkontamination über Sitzungen hinweg zu verhindern.
Fazit
In diesem Beitrag haben Sie ein KI-Agentensystem mit Amazon Bedrock AgentCore erstellt, das die unternehmerische Dokumentenerstellung automatisiert. Der auf der AgentCore Runtime bereitgestellte Supervisor-Agent leitet Anfragen an spezialisierte Tools zur Dokumenterstellung und Zusammenfassung weiter und verkürzte die Erstellung von Präsentationen in einem internen Test auf etwa 90 Sekunden.
Die RAG-Pipeline verankert generierte Inhalte in Quelldokumenten, und Amazon Bedrock Guardrails prüft die Inhaltskonformität. Sie können diese Architektur anpassen für die automatisierte Berichtserstellung im Finanzwesen, technische Dokumentation für Engineering-Teams oder Angebotserstellung für Vertriebsorganisationen.
Um loszulegen, klonen Sie das GitHub-Repository und folgen Sie den Einrichtungsanweisungen. Weitere Informationen zu den verwendeten Diensten finden Sie in der Amazon Bedrock AgentCore-Dokumentation, Strands Agents SDKsowie im AWS CDK Developer Guide.