
Einführung von OpenCompute
Von Walker Hildebrand, Sherry Bai – 14. Oktober 2026 – 7 Minuten Lesen
Produkt
Teilen
In einer Welt, in der Agenten während des Schlafs arbeiten können, wie ermöglichen wir es ihnen, auf Ihrer Infrastruktur zu laufen?
Wenn der Agent in einem Chatfenster verbleibt, ist die Antwort einfach: er läuft auf dem Computer, den Sie für die Sitzung eingerichtet haben. Aber wenn Agenten Alarme untersuchen, asynchrone Anfragen beantworten, geplante Automatisierungen ausführen und während des Tages Probleme bearbeiten müssen, wird es zu aufgerufenem Rechenaufwand kommen. Sie brauchen nicht mehr nur einen Ort, an dem der Agent läuft. Sie benötigen eine Rechenflotte, die mit der Arbeit Schritt halten kann.
Heute stellen wir OpenCompute vor, das selbsthostierte Orchestrierungssystem von Factory für Agent-Sandboxes auf Ihrer gewählten Laufzeitumgebung, der jetzt in einer privaten Vorprobe ist.
OpenCompute bringt auf Anfrage verfügbare Bereitstellung und Lebenszyklusverwaltung für kundengeregelte Infrastruktur, die mit der Factory-Erfahrung in Umgebungen, Automatisierungen und Remote Control integriert ist. Ihre Agenten erhalten Computer, wenn sie sie benötigen. Sie bestimmen, wo diese Computer laufen.
Es basiert auf einer Überzeugung: Die Verwendung autonomer Softwareentwicklung sollte nicht bedeuten, dass man andere Personen die Schlüssel zur eigenen Infrastruktur übergeben muss.
Wie haben wir also etwas in sechs Wochen entwickelt, das es uns ermöglicht, es in zwei Tagen in einer maßgeschneiderten On-Premises-Umgebung einzusetzen?
Aufbauend auf der Fernsteuerung
Im April 2026 brachten wir Droid Computers auf den Markt: persistente Maschinen zur Orchestrierung von Droids. Kunden konnten einen Computer im Cloud-System von Factory erstellen oder ihre eigene Maschine über das Remote Control registrieren.
Die Remote-Control-Erfahrung ermöglicht die Integration mit Factory unabhängig von der Rechenschicht. Führen Sie Droid auf jedem Gerät aus, verbinden Sie es mit Factory und arbeiten Sie remote mit ihm. Das Gerät kann eine Arbeitsstation, eine Cloud-VM oder ein Server innerhalb eines privaten Netzwerks sein. Da der Agent-Execution-Loop auf diesem Gerät läuft, kann Droid in einem internen Umfeld mit privaten Repositories, Paketregister und Diensten arbeiten. Kunden müssen diese Systeme nicht öffentlich präsentieren, um sie einem Agent zur Verfügung zu stellen. Unsere Unterstützung für BYOK und selbsthostete Inferenz bietet zusätzliche Kontrolle über die Datensouveränität.
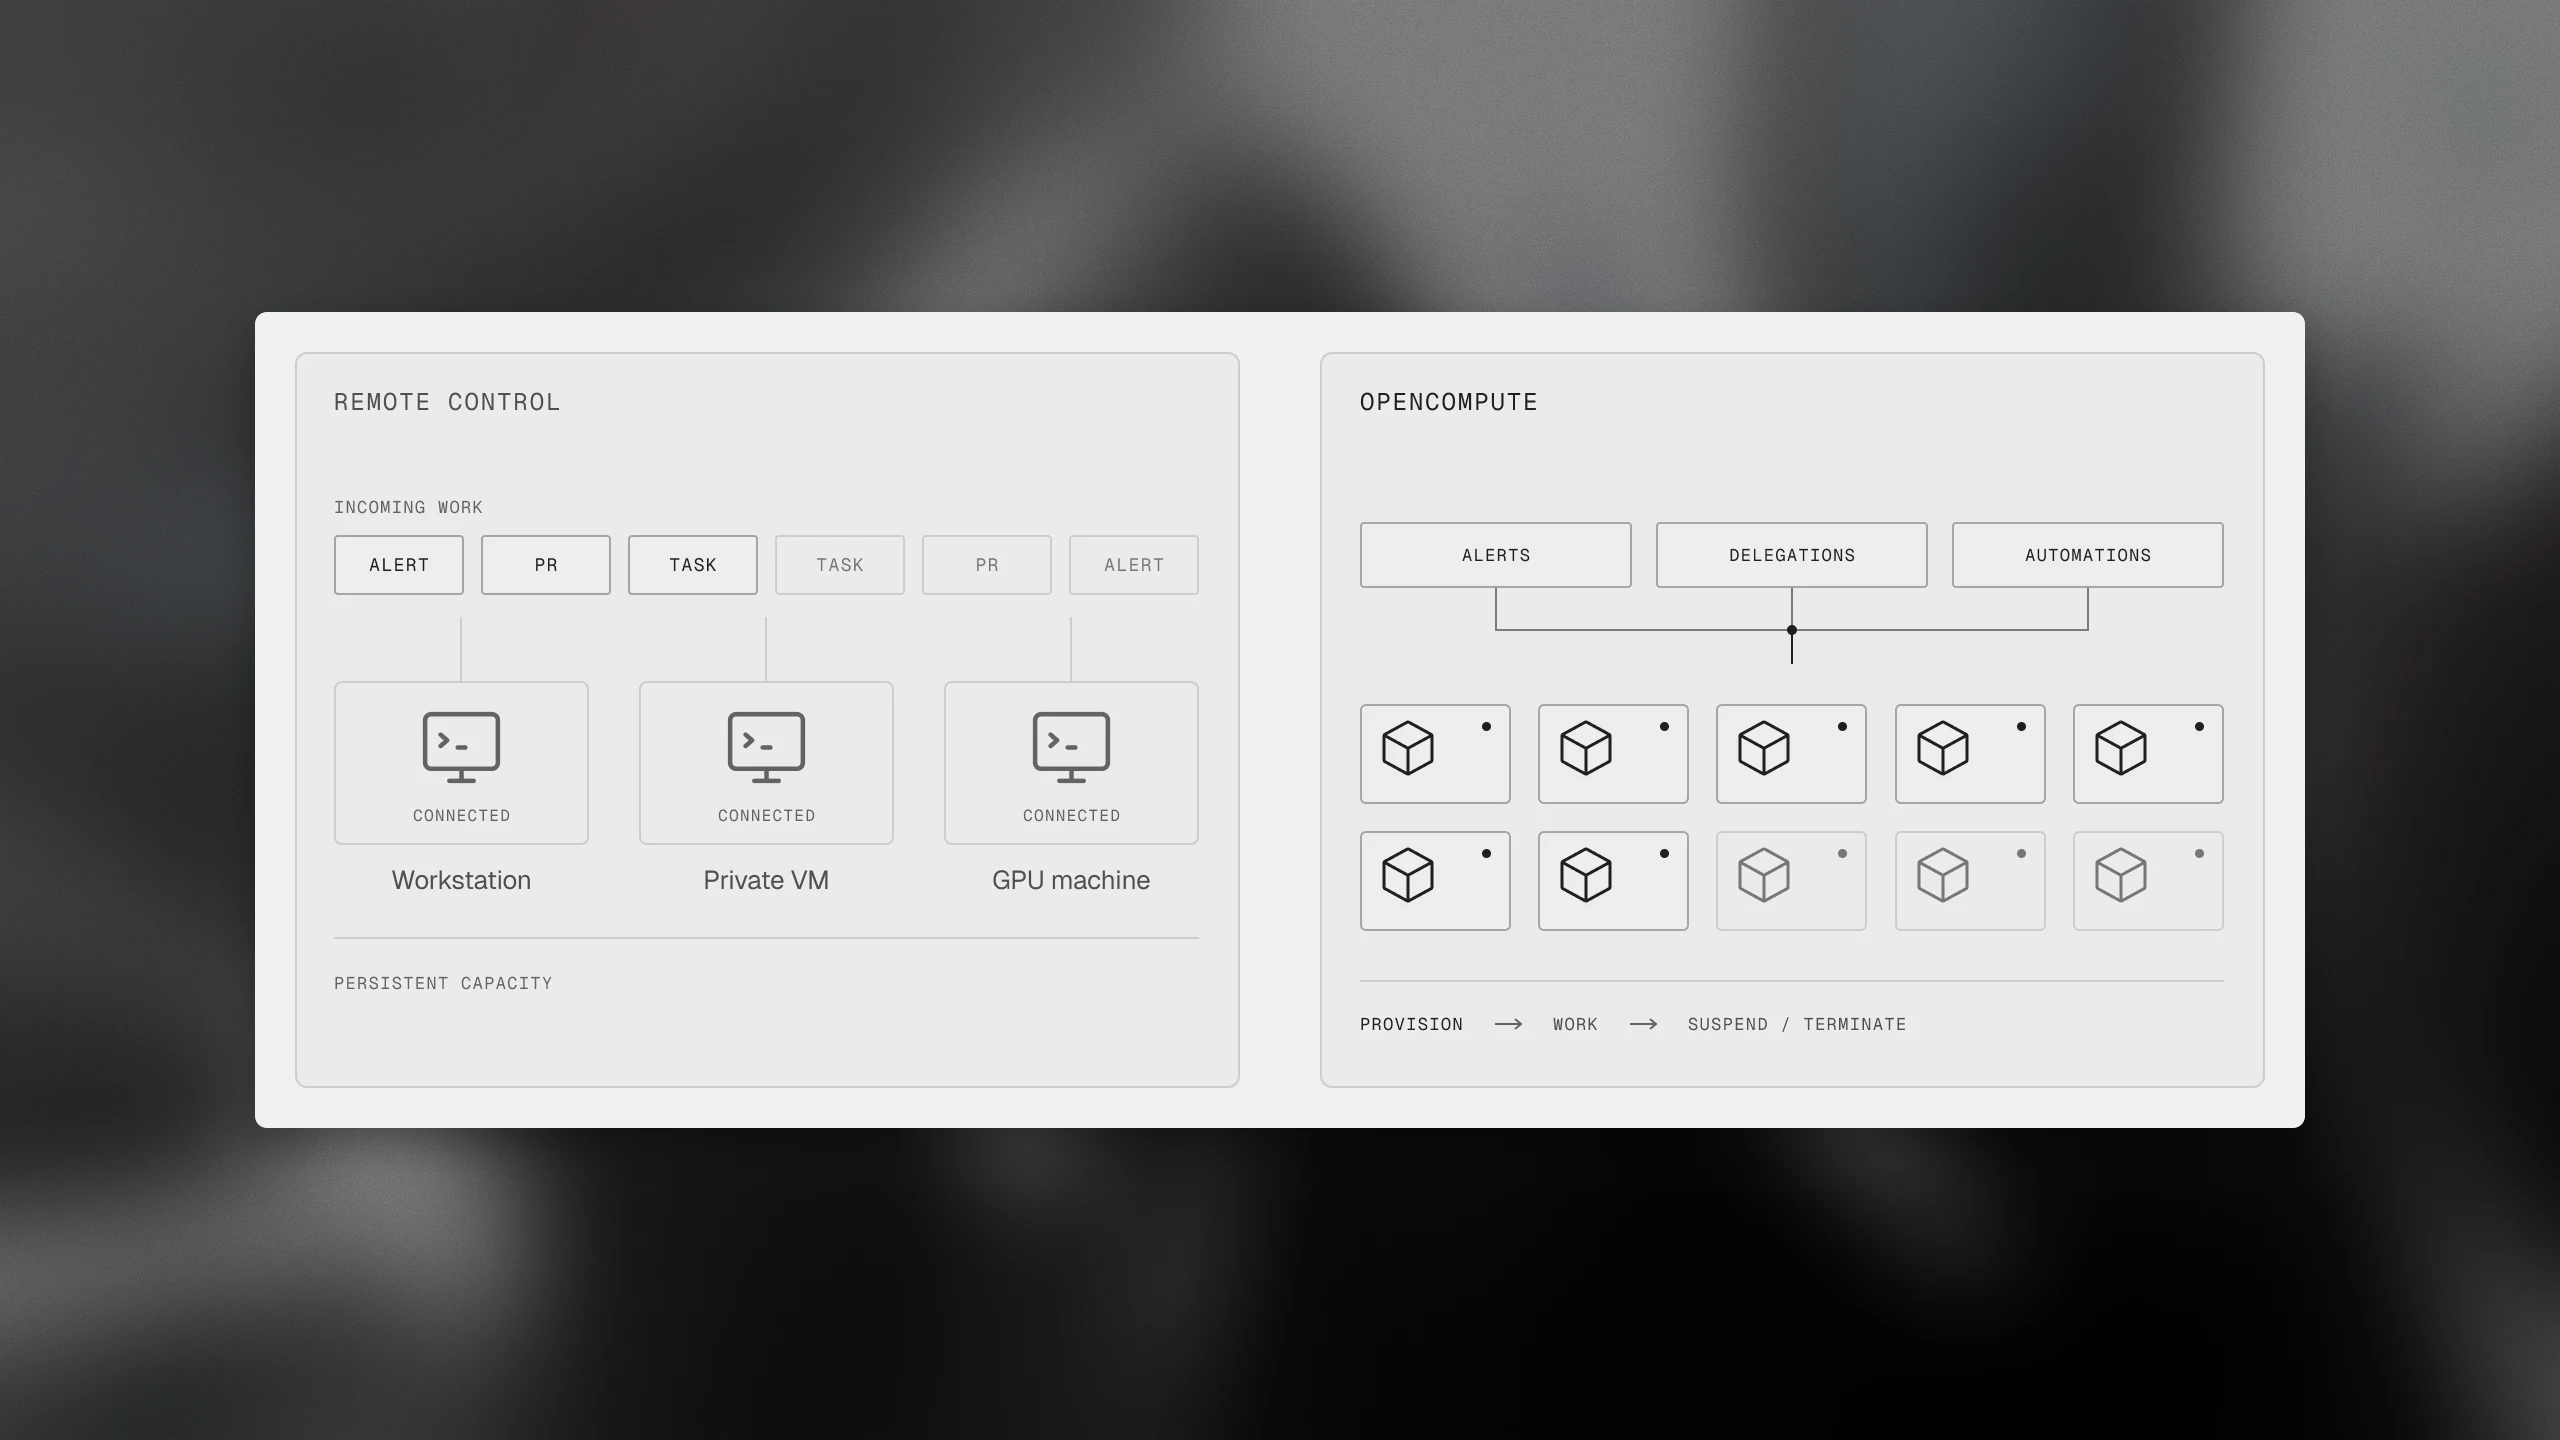
Die Fernsteuerung zeigte den Wert dieses Modells, und die gesamte Industrie hat in dieselbe Richtung gewechselt. Doch wir erkannten eine weitere klare Lücke: unsere Unternehmenskunden benötigten eine Lösung zur Verwaltung von Computernetzwerken, nicht einzelne Computer.
Eine Maschine ist keine Flotte
Remote Control eignet sich gut für eine persistierende Maschine, die für einen einzelnen Benutzer oder einen Dienst konfiguriert ist: eine konfigurierte Arbeitsstation, eine Entwicklungs-VM oder eine Box mit spezialisiertem Hardware. Es beantwortet die Frage: Wie bringe ich Agenten an den Ort, an dem sie am meisten benötigt werden?
Aber wir brauchten Rechenleistung, um die Anforderungen ganzer Organisationen zu erfüllen, indem wir interaktive Sitzungen unterstützen und gleichzeitig den Agenten ermöglichen, unabhängig zu arbeiten, wenn neue Aufgaben auftreten.
Eine Warnung sollte in der Lage sein, eine Untersuchung auszulösen, ohne dass jemand zuerst eine VM bereitstellt. Eine Welle von Slack-Delegationen sollte keine Gruppe daran hindern, die verfügbaren Maschinen zu zählen. Eine abgeschlossene Aufgabe sollte keine leeren Ressourcen unbegrenzt laufen lassen.
Unsere verwaltete Lösung hat bereits Teile dieses Lebenszyklus abgewickelt. Selbsthostierte Maschinen hatten keine gleiche native Integration für die Bereitstellung, Suspendierung und Wiederherstellung. Kunden konnten Droid dort ausführen, wo sie wollten, aber sie mussten das Flottenmanagement selbst übernehmen.
Sandboxes überall
Wir sahen eine große Vielfalt in der Cloud-Infrastruktur unserer Kunden. Einige wollten Agenten, die auf bestehenden Kubernetes-Clustern laufen, andere auf spezialisiertem Hardware, und wieder andere auf einer internen Plattform, von der ihre Entwickler bereits abhängig waren. Andere starteten eine neue MicroVM-Infrastruktur oder suchten nach einer Lösung.
Unser Mandat war nicht nur, Kunden mit Flotten von Sandboxen anzubieten. Wir mussten die Flottenverwaltung auf jede Infrastruktur anwenden. Wir mussten die Orchestrierung in die Umgebung der Kunden bringen, nicht jeden Kunde in unsere Umgebung holen.
Es gibt keine Mangel an Arbeiten, die in Sandbox-Umgebungen für Agenten durchgeführt werden. Drittanbieter-Sandbox-Plattformen für Cloud-Bereiche umfassen E2B, Daytona und Modal. Projekte wie das Kubernetes Agent Sandbox, Google’s Agent Substrate und AWS Lambda MicroVMs zeigen ebenfalls eine wachsende Nachfrage nach Lösungen für „Bring-your-own-cloud“ und „Bring-your-own-infrastructure“.
Jede Plattform führt unterschiedliche Kompromisse bezüglich Isolierung, Beständigkeit, Startgeschwindigkeit, Operative Einfachheit und Deployungsflexibilität ein. Ein Backend, der für kurzlebige Aufgaben geeignet ist, könnte nicht für einen dauerhaften Entwicklungsumfeld geeignet sein. Eine Dienstleistung, die gut für eine Startup funktioniert, könnte innerhalb des Netzwerks eines regulierten Unternehmens nicht verfügbar sein. Und die beste Option in sechs Monaten könnte sich von der besten Option heute unterscheiden.
Wir haben beschlossen, eine Schicht über der Recheninfrastruktur zu bauen. OpenCompute verwaltet das gemeinsame Lebenszyklusprotokoll: Ein Computer beantragen, ihn in den gewünschten Zustand bringen, seine Aktivitäten überwachen und ihn gemäß Richtlinien und den Fähigkeiten des Anbieters pausieren oder beenden. Der Anbieter verwaltet die Infrastrukturmethoden, die diese Operationen ermöglichen. Dadurch können wir von Verbesserungen im gesamten Ökosystem profitieren, ohne die Kunden dazu zwingen zu müssen, auf unsere Produktbasis zu warten.
Die Interfacedien erledigen die Arbeit
Die Entwicklung von OpenCompute war von Anfang an agent-nativ – mit einer Mission, um das Konzept zu beweisen. Unsere Aufgabe war es, die Grenzen zu definieren, das Verhalten anzugeben und die Korrektheit testbar zu machen. Die Droiden kümmerten sich anschließend unter menschlicher Leitung um den Rest.
Das machte das Interface-Design besonders wichtig. „Die Unterstützung für diesen Anbieter aufbauen“ ist eine offene Aufgabe. „Dieses Contract umsetzen und diese Konformitätstests erfüllen“ gibt dem Agenten ein begrenztes Problem und eine verifizierbare Definition des Erfolgs.
Die gleiche Trennung, die OpenCompute für Kunden flexibel machte, machte seine Entwicklung auch erleichtert. Ein neuer Treiber – die Integration mit jedem Anbieter – konnte sich auf den jeweiligen Anbieter konzentrieren, ohne die Flottenverwaltung neu schreiben zu müssen. Das gemeinsame Kontrollfläche-System konnte verbessert werden, ohne weitere Cloud-API zu erlernen.
Diese Vorgehensweise ermöglichte es uns, Integrationen zwischen AWS Lambda MicroVMs, Kubernetes, EC2, Agent Sandbox, Agent Substrate und anderen experimentellen Anbietern zu entwickeln und zu bewerten. Es handelte sich dabei nicht um identische Implementierungen oder gleichmäßig ausgereifte Backends. Genau das war der Sinn: Die Architektur konnte die Unterschiede aufnehmen, ohne jeden einzelnen als separates Produkt zu behandeln.
Sechs Wochen bis zur ersten Bereitstellung
Der klarste Test fand bei der Implementierung für unseren ersten Kunden statt. Der Kunde benötigte OpenCompute in einer maßgeschneiderten On-Premises-Umgebung mit einer internen Anbindung an den Anbieter. Kurz vor dem Abflug, um den Kunden zu treffen, begannen wir eine Mission, um mit den vorhandenen Informationen die erste Steuerung für die Umgebung zu erstellen.
Als wir landeten, war der Fahrer bereits einsatzbereit. Nach zwei Tagen vor Ort stellte der Kunde seine erste Sandbox über OpenCompute ein. Aus der Sicht des Benutzers sah es aus wie die Erstellung eines verwalteten Droid-Computers, doch die Sandbox lief im Kundendatenzentrum. Wir mussten keine neue Architektur für diesen Kunden entwickeln. Wir mussten lediglich seine Infrastruktur mit einer bereits definierten Schnittstelle verbinden.
Von dem frühen Prototyp bis zur ersten Kundenumsetzung: sechs Wochen.
Die erste Integration war nicht das Ende der Ingenieuraufgaben. Die Beharrlichkeit, die Wiederherstellung, die Deployment-Tools und die Sicherung der Operationen setzten danach weiterhin ein. Doch sie bestätigten die zentrale Annahme: Die Integration eines neuen Anbieters könnte ein Problem bei der Steuerung sein, nicht eine Neugestaltung der Plattform.
Überblick zur Architektur
OpenCompute ist ein selbsthostierter Dienst, der den Backend-Server des Unternehmens mit dem zugrunde liegenden Rechenplatz des Kunden verbindet.
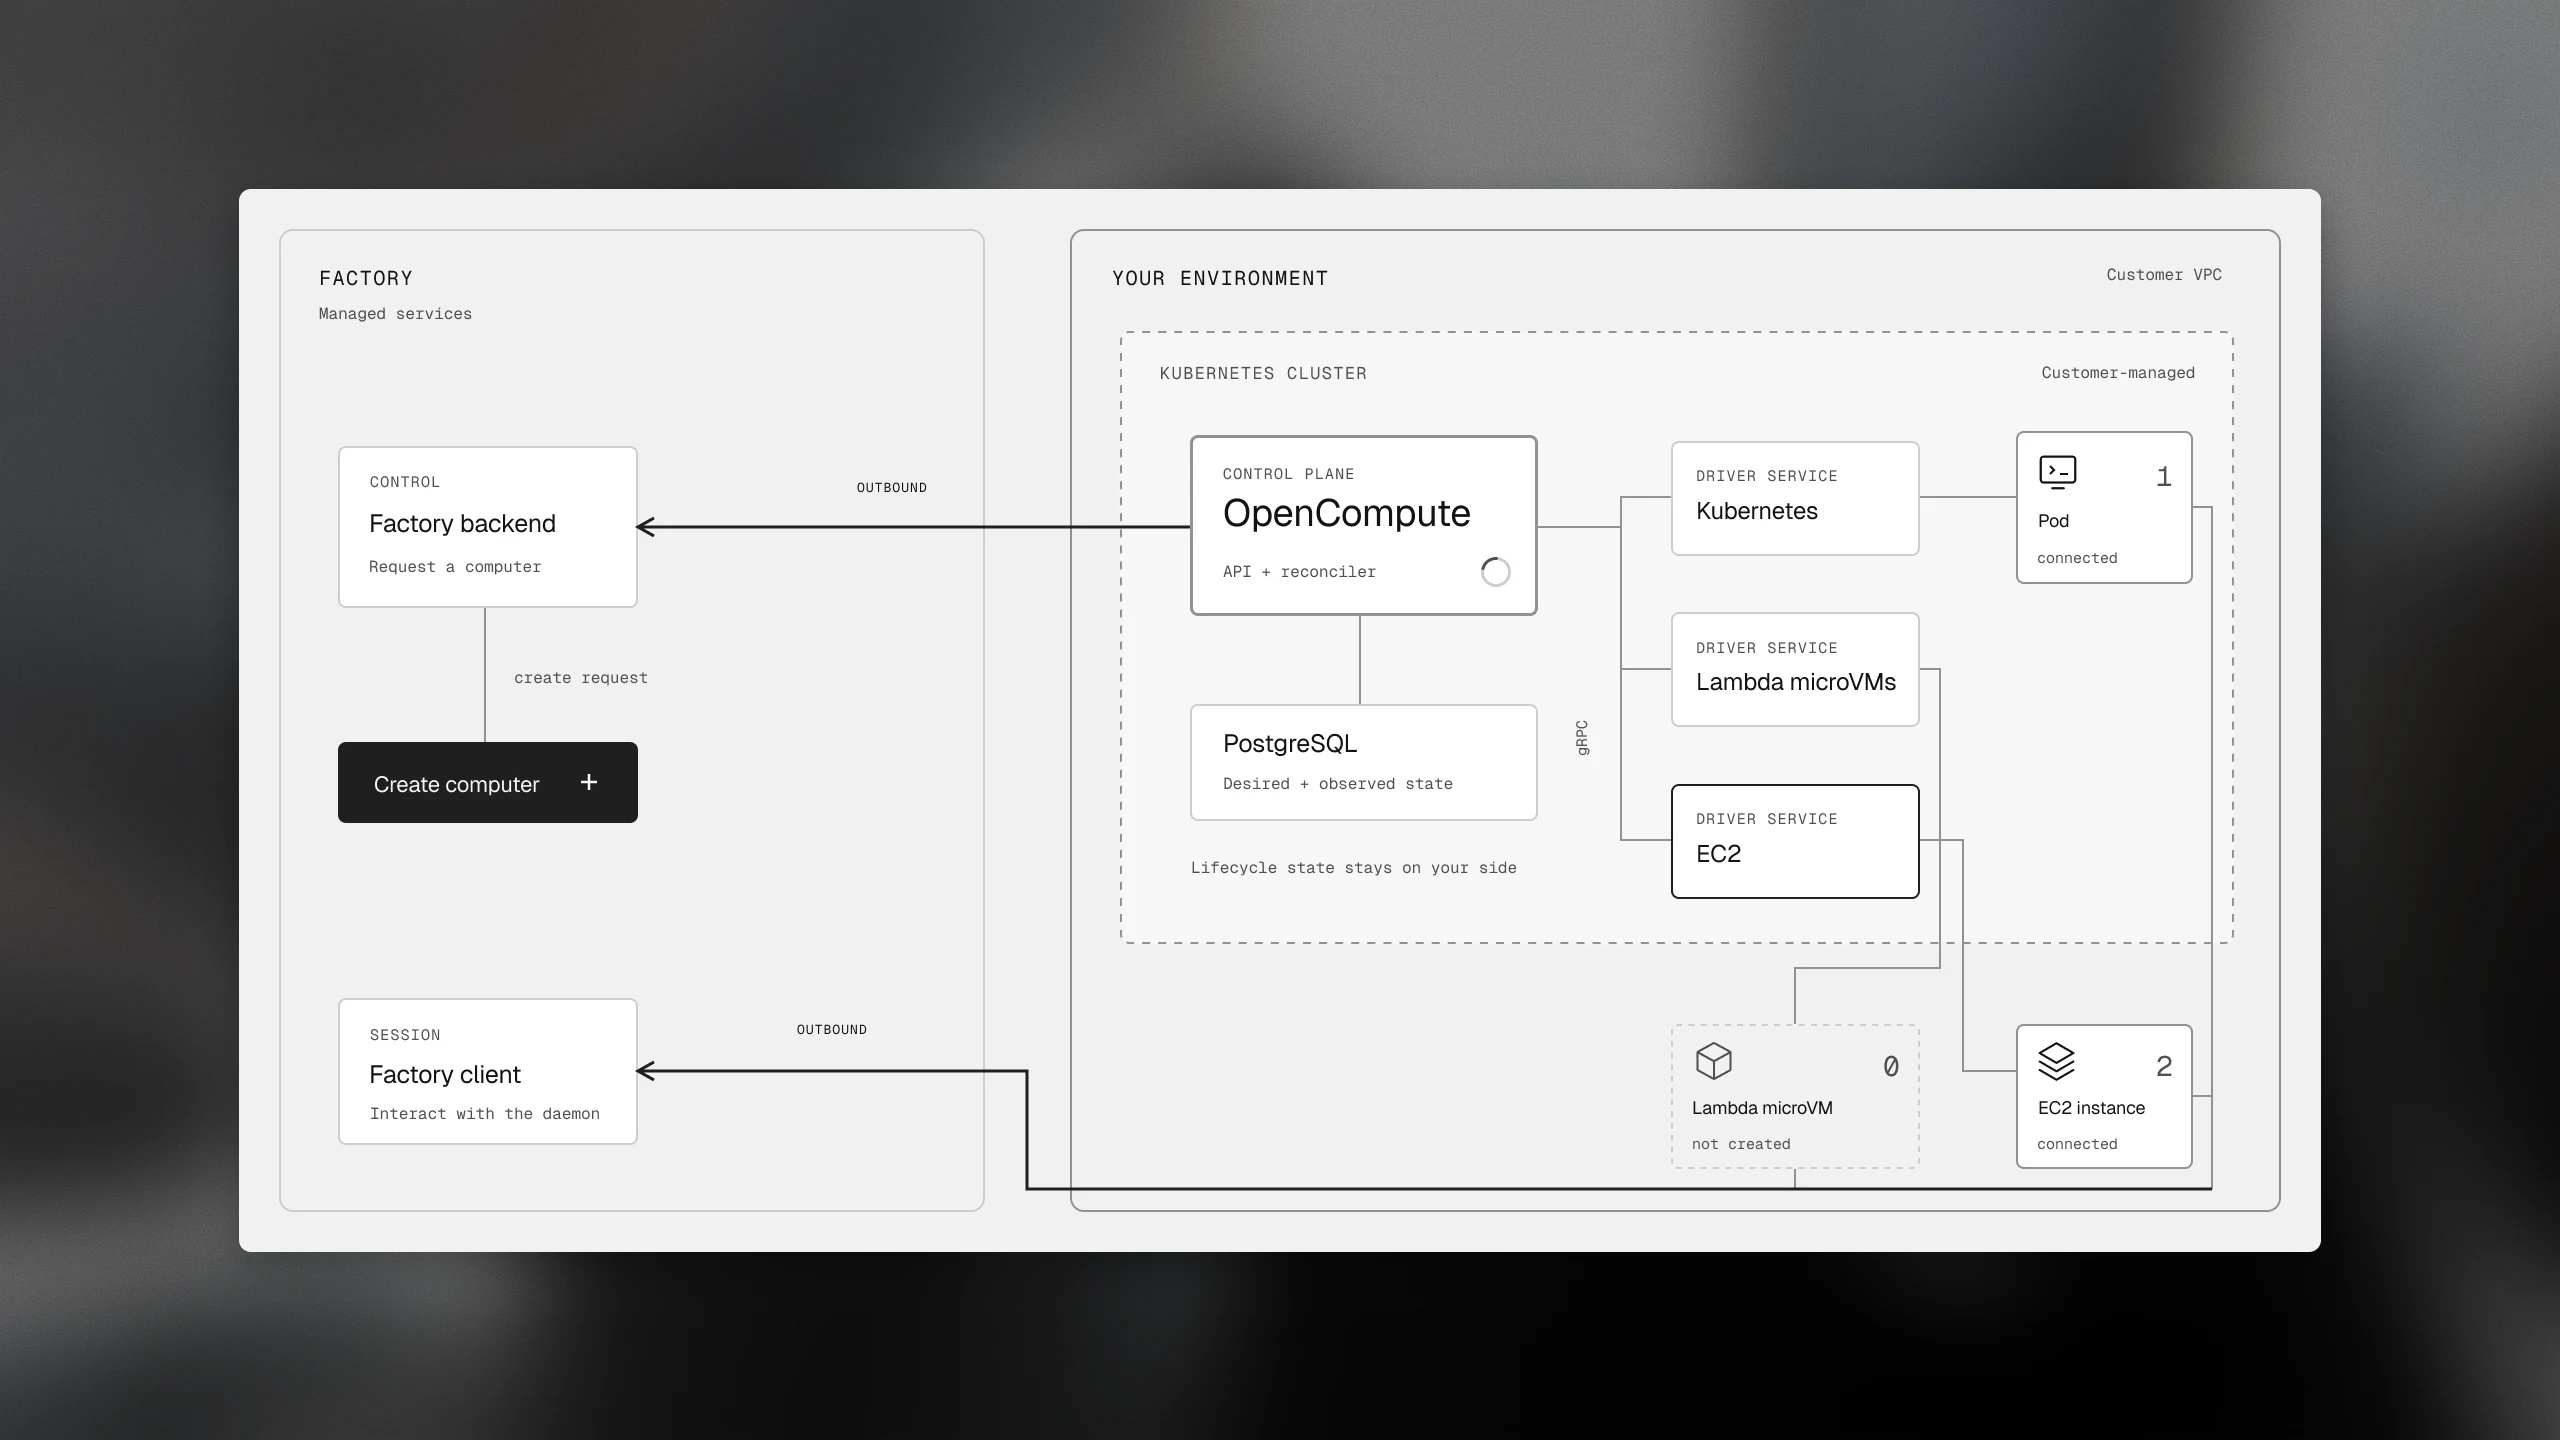
Verbinden nach außen, ausführen innen
OpenCompute läuft in Ihrer Umgebung und herstellt eine ausgehende, TLS-sichere WebSocket-Verbindung mit dem Factory. Das Factory sendet über diese Verbindung autorisierte Rechenanfragen. Sie müssen keinen öffentlichen OpenCompute-Endpunkt offenlegen oder ein Eingangs-Firewall-Port für das Factory öffnen.
Bei der Anmeldung registriert Ihre OpenCompute-Implementierung eine öffentliche Schlüsselkarte bei Factory. Bei der Verbindung beweist sie das Besitzrecht des entsprechenden privaten Schlüssels, indem sie einen neuen Challenge signiert. Der private Schlüssel bleibt in Ihrem Kontrolle und kann in einem unterstützten Cloud-KMS verbleiben.
Jeder von OpenCompute bereitgestellte Sandbox etabliert seine eigene Ausgangskonnektion zu Factory, genau wie heutige fernsteuerbare Computer. Die internen Repositories und Dienste können weiterhin privat bleiben. Droid erreicht sie aus innerhalb Ihres Netzwerks.
Eine Anmerkung zur Platzierung der Daten: Die Berechnung der Platzierung ist unabhängig von der Routing- und Speicherung von Sitzungen. Die vollständige lokale Speicherung der Sitzungsdaten hängt von Ihrer Inferenz- und Synchronisierungskonfiguration ab.
Erfassen den Intent, dann vergleichen
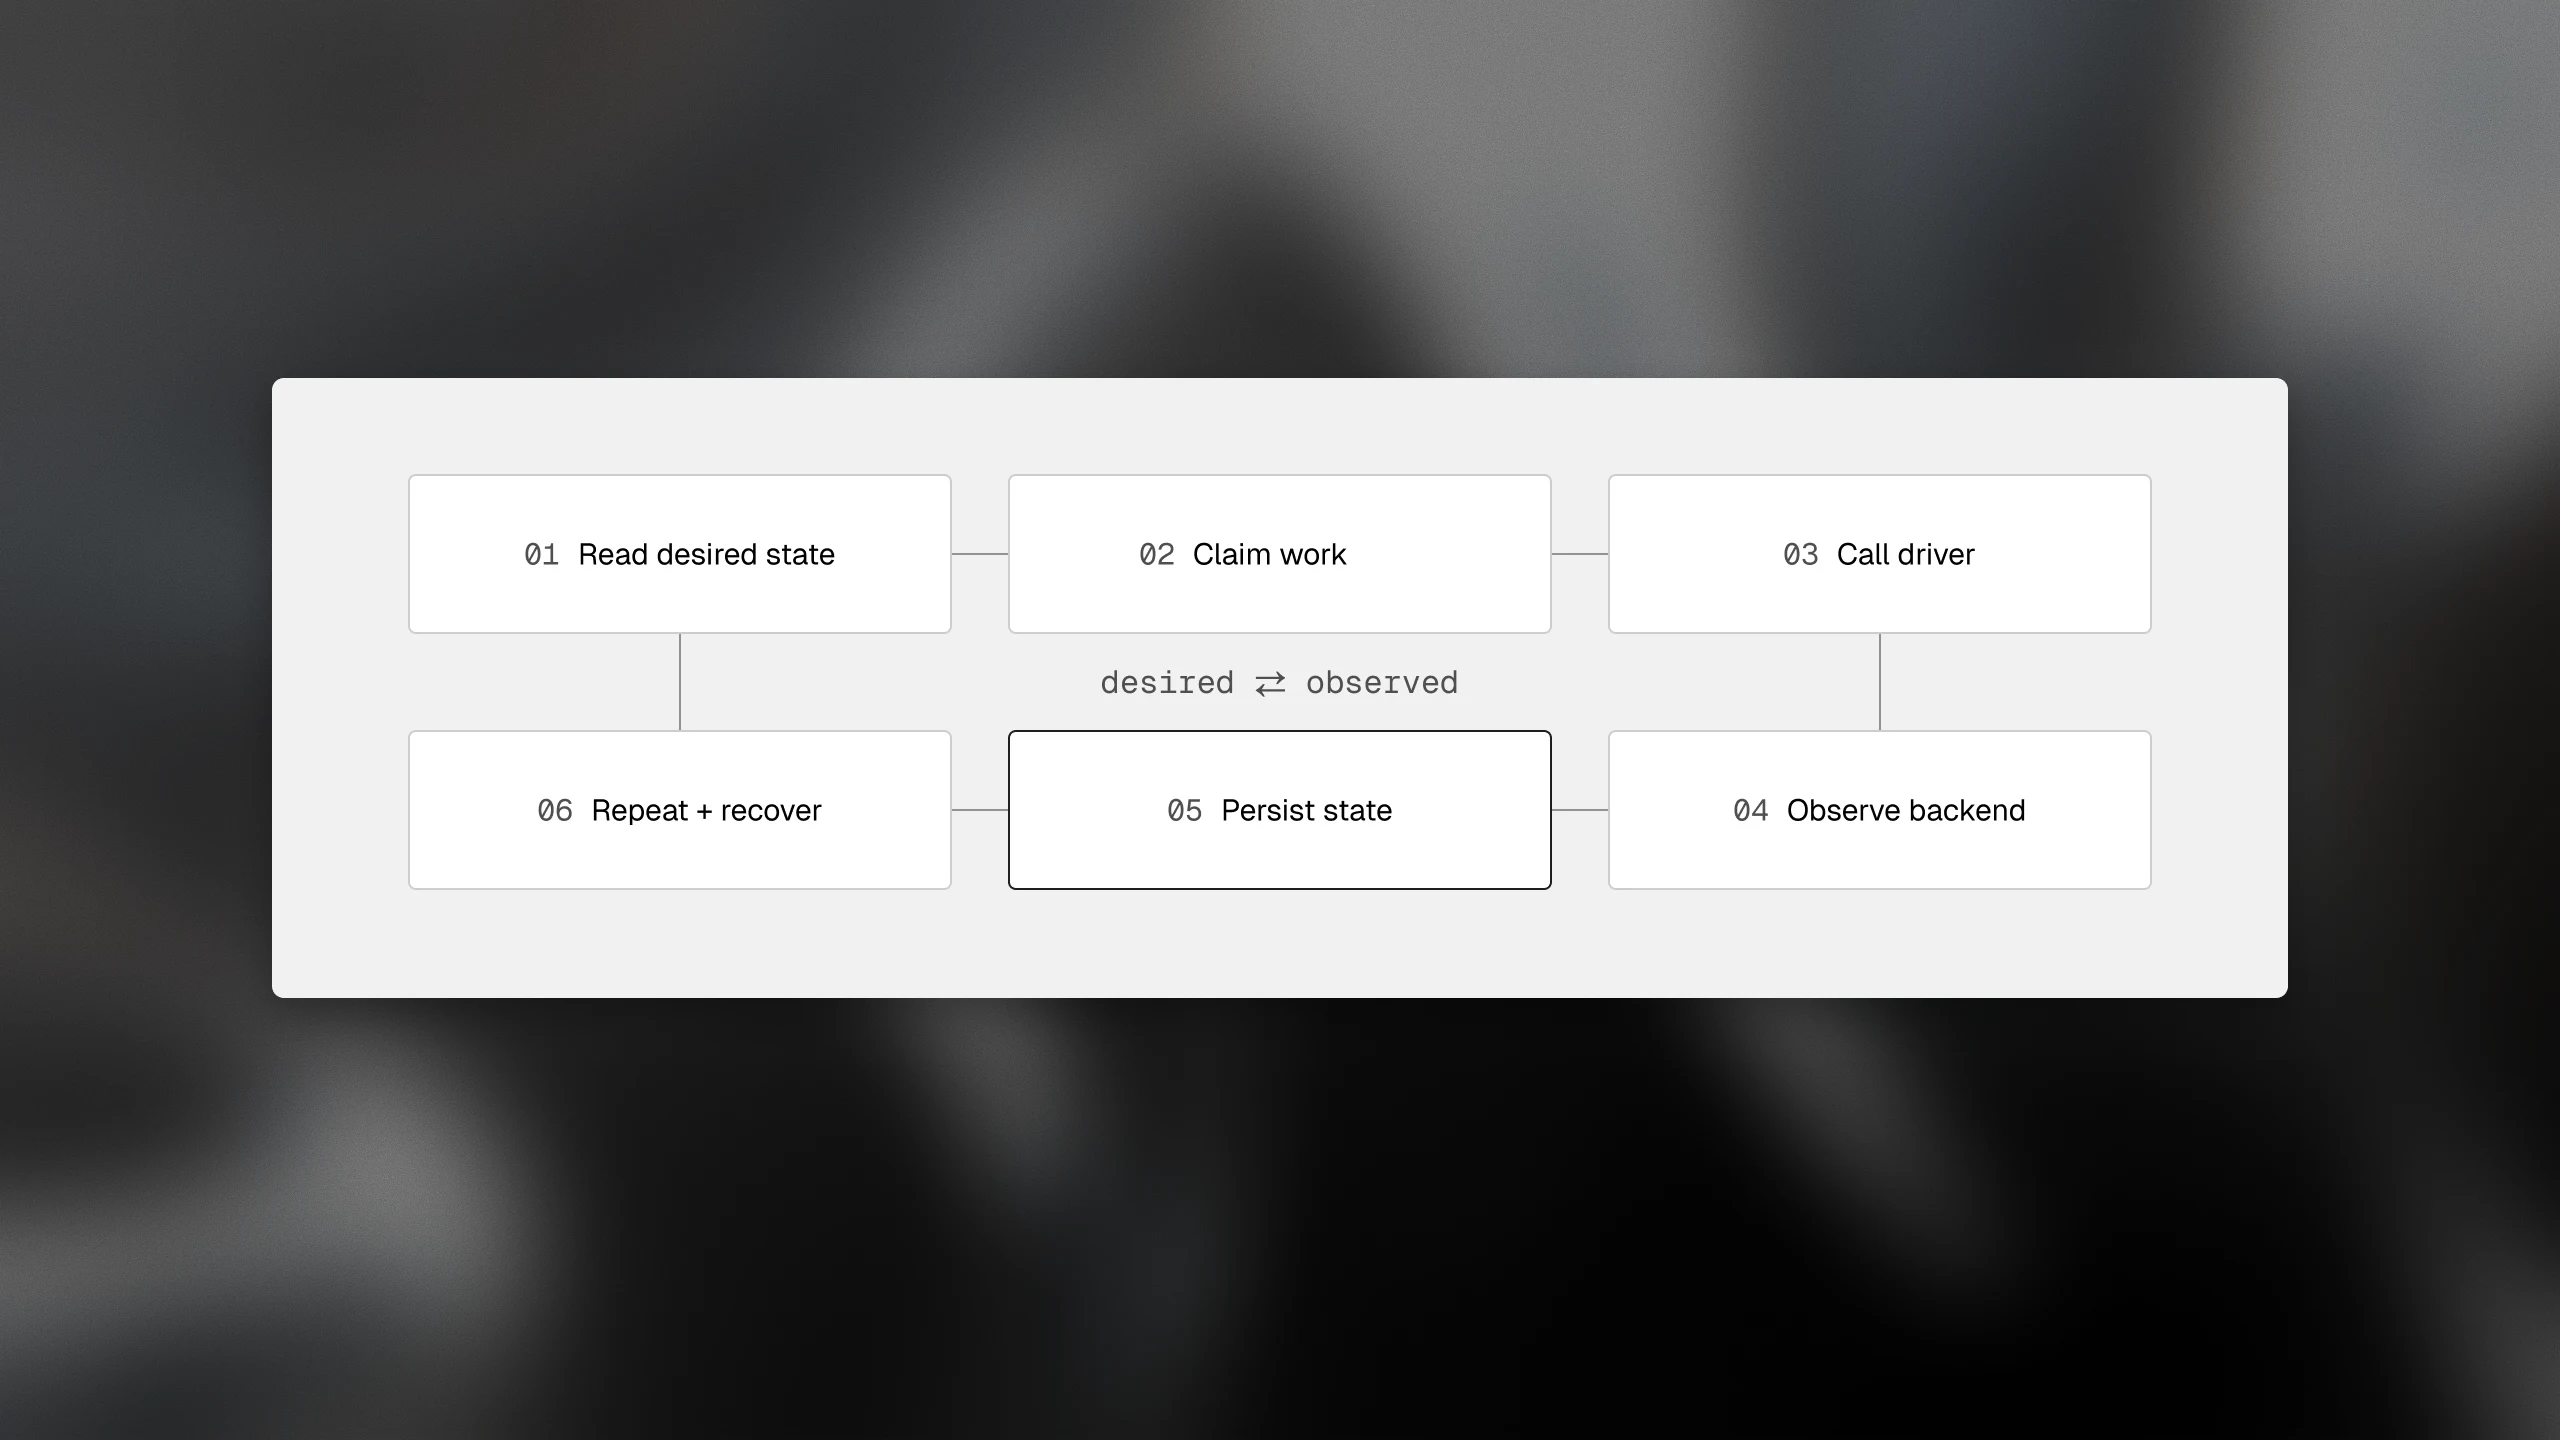
Die Bereitstellung ist keine einzige zuverlässige API-Anfrage, besonders wenn mit unbekannten Anbietern gearbeitet wird. Die Verbindungen verschwinden. Die Anbieter schalten die Leistung ab. Die Prozesse starten erneut nach Erfolg einer Anfrage, aber bevor die Antwort eintrifft. OpenCompute löst dieses Problem mit einem deklarativen Lebenszyklusmodell. Sein Go-Control-Plane speichert den gewünschten und beobachteten Computerzustand in einer Postgres-Datenbank, die in Ihrer Umgebung läuft. Ein Korrektionsmechanismus arbeitet kontinuierlich daran, den Computer in den gewünschten Zustand zu bringen.
Eine Computerumgebung speichert die Absicht dauerhaft, anstatt eine Anfrage bis zum Abschluss des Anbieters offen zu halten. Der Ausgleichsprozess handhabt die Bereitstellung und Überwachung, wiederholte, erholbare Fehler und führt die unterstützten Lebenszyklusübergänge durch. Da die Absicht dauerhaft ist, löscht ein Neustart des Kontrollplans nicht das unvollendete Arbeiten.
Computer werden aus unveränderlichen Builds gestartet, wodurch die Umgebungsvorbereitung von der Maschinenbildung getrennt wird. Der mit S3 kompatible Speicher speichert Build-Artefakte und Snapshot-Payloads. Aktivitätssignale und per-Computer-Lifecycle-Einstellungen leiten das Steuerfläche ab, wann ein Computer laufen soll und wann eine Lifecycle-Aktion ausgeführt werden soll.
Standardisieren das Verhalten, nicht die Infrastruktur
Jede Integration mit dem Anbieter läuft als ein separates gRPC-Driver. Der Driver übersetzt gängige Operationen in die natürlichen Mechanismen des Backends zur Erstellung, Beobachtung, Ausführung von Befehlen und zum Aufheben von Computern.
Das Verhalten des Anbieters bleibt außerhalb der Datenbank und der Rekonstruktionslogik des Control-Planes. Die Fahrer können die für ihren Backend geeigneten Übertragungs- und Laufzeitfunktionen verwenden, anstatt einen zwingenden Gast-Agenten zu verwenden.
Aber eine gemeinsame Schnittstelle ist nur nützlich, wenn sie ehrlich über die Unterschiede ist. Nicht jeder Backend kann einen Computer suspendieren, seinen Disk-Snapshot erstellen oder ihn forken. OpenCompute definiert daher ein erforderliches Core-Conformitätsprofil sowie optional Suspend, Snapshot und Fork-Profilen. Black-Box-Tests überprüfen das Verhalten, für das der Treiber vorgibt, dass es unterstützt wird. Ununterstützte Anfragen werden vor dem Ändern eines dauerhaften Zustands abgelehnt, anstatt sich Mitte des Bereitstellungsprozesses als Fehler zu zeigen.
Der Vertrag ist auch für den Anbieter neutral. Die Fabrik ist einer möglichen Kunden von OpenCompute, und die Treiber sind unabhängig von den spezifischen Funktionen der Fabrik. OpenCompute stellt seine eigene API, CLI und Verwaltungspanel bereit, da die Ebene, die Ihr Rechenverhalten verwaltet, unabhängig vom Produkt, das sie zuerst benötigt hat, nützlich sein sollte.
Was kommt als Nächstes
Wir planen, OpenCompute zu Open Source zu machen. Das Ziel ist nicht nur, die Implementierung zu veröffentlichen, sondern auch die Verträge, die Konformitätstests und das Driver-Modell so nutzbar zu machen, dass sie für Menschen nützlich sind, die Agent-Systeme entwickeln.
Wir betrachten es auch als Grundlage für die Zukunft von Factory. Interaktive Sitzungen, geplante Automatisierungen, Unfalluntersuchungen und delegierte Arbeit sollten nicht jeweils ihre eigene Infrastruktur erfordern. Sie sollten in der Lage sein, die benötigte Umgebung über denselben Lebenszyklus-Schicht anzufordern – egal ob Factory oder der Kunde sie betreibt.
Wir freuen uns, diese Grundlage in mehr Hände zu geben und zu sehen, welche Anbieter die Menschen als Nächstes wählen werden.
Die Zukunft der agentischen Arbeitslasten wird nicht auf einer Art von Maschine in dem Cloud-Netzwerk eines Unternehmens laufen. OpenCompute ist die Art und Weise, wie wir für diese Zukunft entwickeln möchten.
OpenCompute ist jetzt im privaten Vorverkauf verfügbar. Wenn Sie daran interessiert sind, OpenCompute auszuprobieren, kontaktieren Sie den Besitzer Ihres Accounts bei Factory.