
Jedes Unternehmen hat seine eigenen Workflows, Tools, Grenzfälle und Definitionen von Erfolg. (öffnet in einem neuen Fenster)Third Moment Research(öffnet in einem neuen Fenster) ist überzeugt, dass die besten Agenten bei genau dieser spezifischen Arbeit wirklich gut sein sollten und ihre Fähigkeiten mit zunehmender Nutzung verbessern sollten.
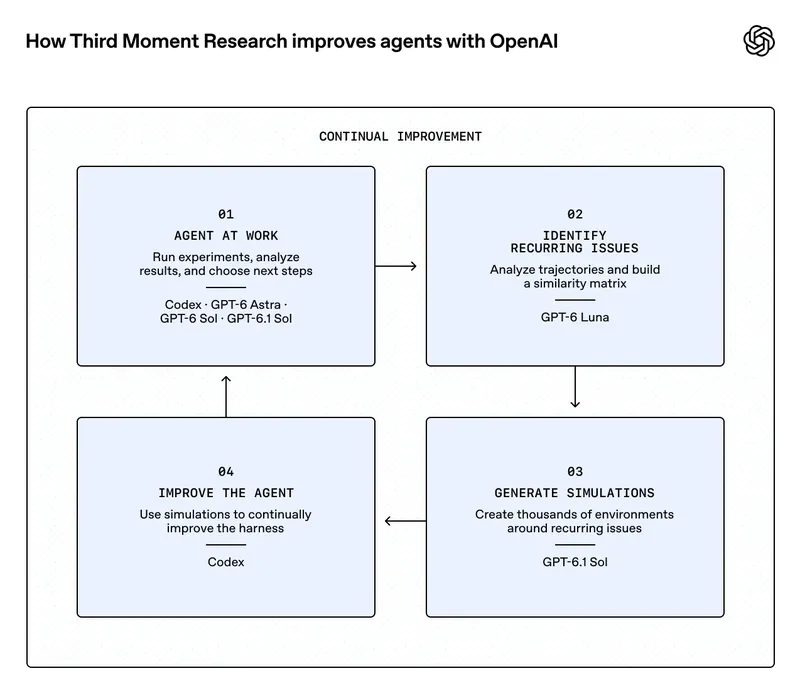
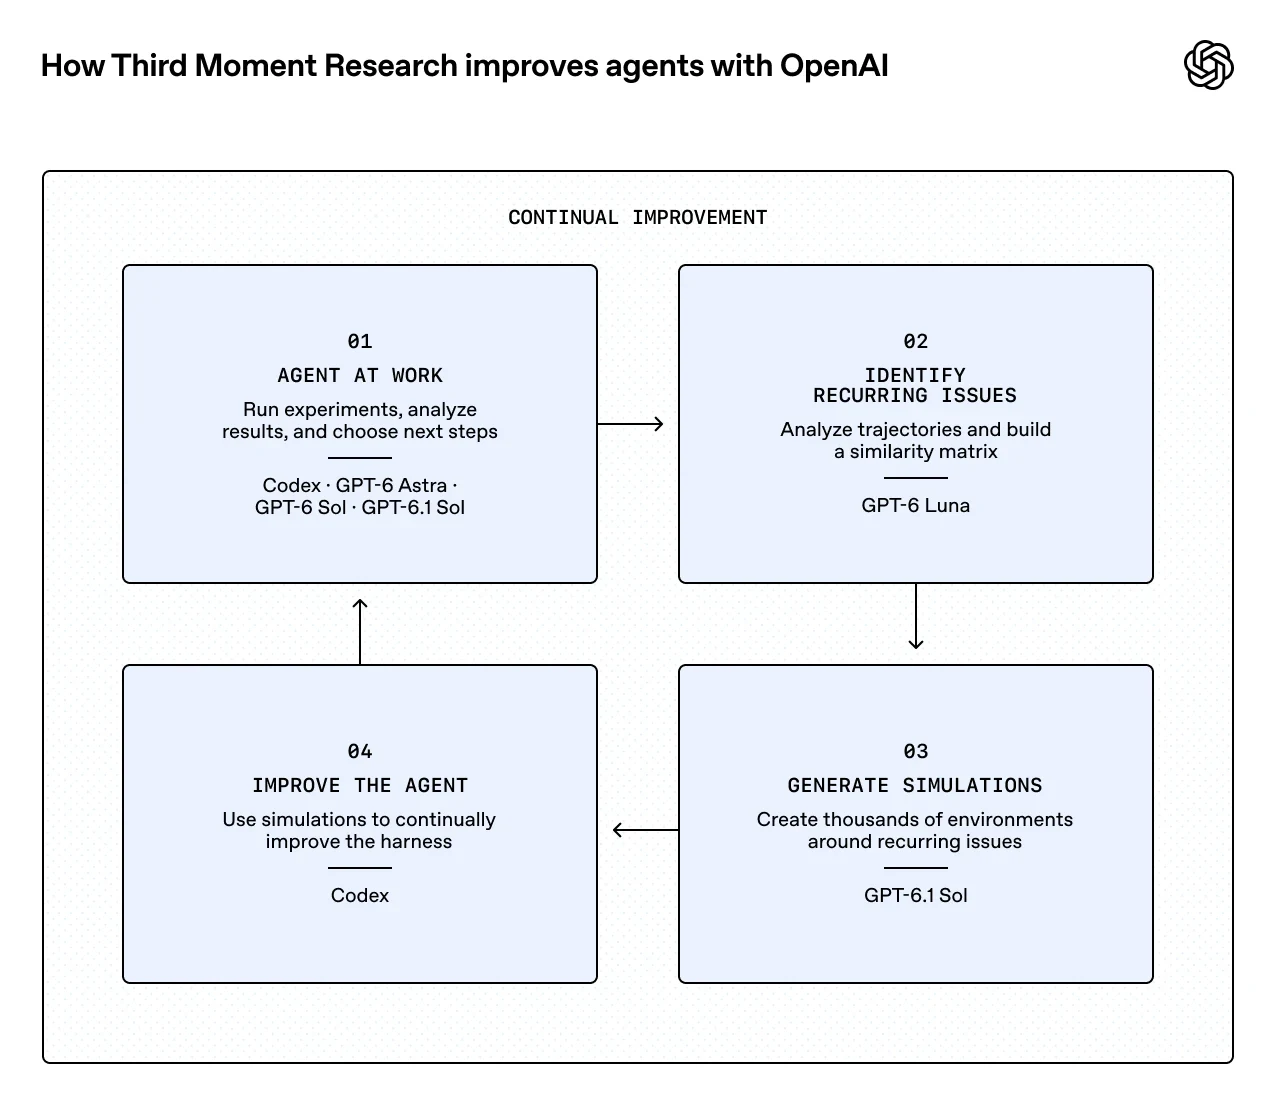
Das Unternehmen baut eine selbstverbessernde KI-Systemumgebung um diese Idee herum und nutzt OpenAIs neueste Modelle, um Agentenverhalten zu verstehen, wiederkehrende Schwächen zu identifizieren und automatisch Tausende synthetischer Szenarien rund um diese Probleme zu erstellen. Das Team nutzt diese Szenarien, um Agenten zu verbessern, und wiederholt den Prozess, wenn neue Probleme auftreten.
Codex, GPT‑6 Astra, GPT‑6 Sol und GPT‑6.1 Sol unterstützen die Forschungs- und Rechenarbeit des Systems und ermöglichen es Third Moment, 10,000 Agenten gleichzeitig bei Untersuchungen von 36-48 Stunden laufen zu lassen. Das Unternehmen nutzt Daybreak auch, um die Sicherheit der Umgebungen zu testen, in denen Agenten arbeiten.
„In einer einzigen Sitzung ist GPT-6.1 Sol in der Lage, über Tage hinweg Rechenzeit einen kohärenten Faden rechnergestützter Forschung aufrechtzuerhalten, ohne den roten Faden zu verlieren.“—Adam Khakhar, Mitgründer, Third Moment Research
Reduzierung von Laufzeit und Token-Verschwendung mit Codex
Eine der frühen Anwendungen von Third Moment liegt im Bereich der quantitativen Finanzen angesichts des klaren Erfolgsmessmaßstabs. Dieser Bereich bietet ein konkretes Umfeld, um zu untersuchen, wie Agenten arbeiten und wo sie Schwierigkeiten haben. Das Team verwendet Codex, um Probleme in der Forschungsumgebung zu finden und zu beheben.
In einem Fall verwendete es Codex mit GPT‑5.6, dem damals neuesten GPT-Modell, um Tausende aufgezeichneter Simulationstrajektorien (die Aktionen der Agenten und die Reaktionen der Umgebung) zusammen mit Zeitstempeln und der Codebasis zu analysieren.
Codex deckte einen Engpass auf: Das Backtesting einer Handelsstrategie über ein Jahr bestellgenauer US-Aktiendaten dauerte mehrere Stunden. Während des Wartens fragten Agenten wiederholt den Abschluss ab, verschwendeten Tokens und füllten ihren Kontext mit Statusabfragen.
Nach dem Profiling des Backtests und der Analyse seiner Eingaben und Nutzung identifizierte Codex eine Caching-Optimierung und eine Speicherpakettierungstechnik. Es experimentierte mit Lösungen und stellte die Korrektur in Produktion, wodurch sich der Backtest von etwa 3 Stunden auf etwa 3 bis 5 Minuten reduzierte. Dies verringerte den Token-Verbrauch und die Kontextverschmutzung und gab mehr vom Token-Budget der Agenten für weitere Experimente frei.
Agenten mit Codex und GPT‑6 bei der Aufgabe halten
Third Moment gibt jedem Agenten die Werkzeuge, Informationen und die Umgebung, die er für eine bestimmte Aufgabe benötigt. Für quantitative Forschung betreibt das Team das Standard-Codex-Harness in einer Docker-Umgebung. Die Agenten erhalten ein Terabyte Daten, Dokumentation und ein Forschungsrepository mit Modulen für Feature-Engineering, GPU-unterstütztes Modelltraining, Handelsstrategien und Simulation.
GPT‑6 Astra, GPT‑6 Sol und GPT‑6.1 Sol liefern das reasoning, während das Codex-Harness den Agenten Werkzeuge gibt, um zu handeln, Pläne zu erstellen, Ziele zu setzen, Subagenten zu erzeugen und den Kontext zu verdichten, während die Arbeit weitergeht.
Um bei Agenten das Abbrechen vor Fertigstellung einer Aufgabe zu vermeiden, behandelt Third Moment Codex als Subagent innerhalb eines äußeren Harness, der von GPT‑6 Sol oder GPT‑6.1 Sol angetrieben wird. Der äußere Harness untersucht die Trajektorie, wenn eine Aufgabe unvollendet bleibt, und entscheidet, ob ein erneuter Versuch unternommen, der Auftrag beendet oder an eine menschliche Prüfung eskaliert werden soll.
„Das Codex-Harness ist äußerst vielseitig und ermöglicht den Einsatz in vielen verschiedenen Bereichen.“—Adam Khakhar, Mitgründer, Third Moment Research
In dieser Forschungsumgebung arbeiten die Agenten daran, ein von Third Moments Ingenieuren entwickeltes Basishandelssystem zu verbessern. Sie testen Handelsstrategien an historischen Daten, bewerten, ob eine Verbesserung bedeutsam oder Rauschen ist, und nutzen jedes Ergebnis, um das nächste Experiment zu wählen. Laut Adam hat ihre Arbeit das Basishandelssystem verbessert.
Längere Forschung mit höherer Token-Effizienz aufrechterhalten
Vor GPT‑5.5 konnten Modelle laut Adam nur Experimente ausführen, die ein Nutzer vorgab. Mit GPT‑5.5 und GPT‑5.6 konnten Modelle, die mit dem Codex-Harness arbeiteten, Ergebnisse nutzen, um Folgeexperimente zu entwerfen. Jetzt können Agenten mit GPT‑6 Astra, GPT‑6 Sol und GPT‑6.1 Sol mit Subagenten die Ursachen durch Hunderte parallel laufender Experimente untersuchen.
Dieser Fortschritt hat Agenten geholfen, Forschungsrichtungen zu erkunden, die das Team nicht vorhergesehen hatte. In einer Sitzung identifizierte GPT‑6.1 Sol die Auswirkung von nicht angezeigten Trades auf einer Börse, wo diese Trades einen unerwartet großen Anteil des Volumens ausmachten. „Das war ein nicht offensichtliches Ergebnis, das unser Forschungsteam anfangs nicht in Betracht gezogen hatte“, sagt Adam.
Third Moment bewertet Modelle in den Bereichen Optimierung, Machine-Learning-Systeme und quantitative Forschung. Es testet Frontier-Releases auf ihren höchsten Reasoning-Einstellungen und bewertet ihre Fähigkeit, sich in Repositories zurechtzufinden, effizienten Code zu schreiben und eine Untersuchung aufrechtzuerhalten. Das aktuelle Testing umfasst auch GPT‑6 Luna.
„GPT-6.1 Sol ist derzeit unser am häufigsten genutztes Modell angesichts seiner Token-Effizienz. Es erledigt Aufgaben mit den wenigsten Tokens und liefert dabei eine Leistung ähnlich wie GPT-6 Astra.“—Jeffrey Yan, Mitgründer, Third Moment Research
Ein Benchmark fordert Agenten auf, die Update-Latenz eines Live-Scoreboard-Dienstes zu reduzieren und dabei seine Ausgaben zu erhalten. Das Team misst die Beschleunigung, indem es die durchschnittliche Laufzeit einer von Experten erstellten Lösung durch die der Modelllösung auf derselben Hardware unter Wahrung der Korrektheit teilt. GPT‑6 Astra erzielte laut Adam die größte Beschleunigung.
Für gezielte Arbeiten, einschließlich Prüfungen auf bestimmte Sicherheitsschwächen im Simulationssystem, verwendet das Team effizientere Modelle wie GPT‑5.6 Terra. Für tiefgehende Forschung glaubt Adam, dass stärkeres reasoning die höheren Kosten rechtfertigen kann: „Im Bereich des quantitativen Finance ist der Wert, ein interessantes Signal zu finden, extrem hoch.“
Sicherheitstests mit Daybreak automatisieren
Mit 10,000 autonom laufenden Agents benötigt Third Moment eine Möglichkeit, die Sicherheit seiner Forschungsumgebungen im großen Maßstab zu testen. Das Team nutzt die Daybreak-Cybersecurity-Plattform, um diese Tests zu automatisieren, bevor Simulationen starten.
Die Tests prüfen, ob ein Agent aus seiner Forschungsumgebung ausbrechen und auf das weitere Netzwerk zugreifen könnte. „Durch den Einsatz von Daybreak können wir die Agents selbst Penetrationstests an der Simulation durchführen lassen und deren Infrastruktur und Sicherheit testen“, sagt Adam.
„Ohne Daybreak könnten wir das nicht autonom in diesem Maßstab testen.“—Adam Khakhar, Mitgründer, Third Moment Research
Auf dem Weg zu Hunderttausenden kollaborierender Agents
Third Moments Ehrgeiz erstreckt sich auf die spezialisierte Arbeit, die Unternehmen jeden Tag leisten. Für einen Händler könnte das bedeuten, bessere Entscheidungen in der Lieferkette zu treffen, wenn der Lagerbestand knapp ist oder ein Lieferant sich verspätet. Für ein Engineering-Team könnte es bedeuten, Performance-Engpässe in einer großen Codebasis zu finden. Für ein dokumentenlastiges Unternehmen könnte es bedeuten, Stellen zu identifizieren, an denen Zusagen in einem Dokument nicht mit den in einem anderen festgehaltenen Ergebnissen übereinstimmen.
Aufbauend auf den Reasoning-Fähigkeiten von GPT‑6 Astra, GPT‑6 Sol und GPT‑6.1 Sol plant Third Moment, von einzelnen Untersuchungen zu Hunderttausenden kollaborierender Subagents zu expandieren. Seine Roadmap sieht Billionen von Token vor, die Ketten von Dutzenden abhängiger Experimente unterstützen – mit dem Ziel, diese Forschung zu nutzen, um Agents autonom zu verbessern, wenn neue Herausforderungen auftreten.
Für Adam würde dies den Menschen mehr Möglichkeiten geben zu gestalten, wie Agents lernen und arbeiten: „Menschen können sich in einer viel positionsstärkeren Lage befinden, in der sie darüber nachdenken können, wie man Forschung betreibt und die Forschung selbst optimiert, anstatt die Forschung tatsächlich durchzuführen.“