
IDC-Forschung zeigt, dass dokumentbezogene Herausforderungen Organisationen jährlich 19,732 US-Dollar pro Information Worker kosten und die Produktivität um 21.3 Prozent senken. Organisationen, die Rechnungen von Hunderten von Lieferanten erhalten, sehen sich häufig mit Layouts konfrontiert, die je nach Aussteller variieren und sich ohne Ankündigung ändern. Template-basierte Systeme erfordern in diesem Umfang ständige Wartung. Mitarbeitende können bis zu 30 Prozent ihrer Zeit mit dokumentbezogenen Aufgaben verbringen, und die Fehlerraten bei manueller Dateneingabe liegen zwischen 1–4 Prozent. Konventionelle Intelligent Document Processing (IDP)-Lösungen begegnen einem Teil dieser Belastung, erfordern jedoch umfangreiche Vorkonfiguration für jedes Dokumentformat und versagen, wenn Layouts je nach Anbieter variieren.
In diesem Beitrag erfahren Sie, wie Sie ein agentic IDP-System mit Amazon Bedrock AgentCore aufbauen, das Geschätsdokumente mit minimaler menschlicher Intervention klassifiziert, extrahiert, validiert und aus ihnen lernt. Amazon Bedrock AgentCore ist eine Plattform zum Aufbau, zur Verbindung und zur Optimierung von Agents im großen Maßstab, mit beliebigen Frameworks oder Modellen. Ihre Agents verarbeiten automatisch neue Dokumentformate, wie Lieferantenrechnungen, Bestellungen, Versicherungsansprüche und Kreditanträge. Am Ende dieses Beitrags können Sie:
- Ein Multi-Agent-IDP-System bereitstellen, oft in unter 20 Minuten.
- Neue Dokumenttypen ohne manuelle Template-Konfiguration verarbeiten.
- Agents sich selbst für jedes neue Dokumentformat trainieren lassen und das Gelernte wiederverwenden, sodass spätere Dokumente dieses Typs direkt zur Extraktion gelangen, ohne erneutes Training.
Herausforderungen bei regelbasierter Dokumentenverarbeitung
Viele IDP-Pipelines erfordern, dass Sie Templates, Extraktionsregeln und Validierungslogik für jedes Dokumentformat im Voraus definieren. Wenn ein neuer Anbieter eine Bestellung mit einem anderen Layout sendet, bricht die Pipeline. Daraus ergeben sich drei zentrale Herausforderungen:
- Template-Starrheit: Jedes neue Dokumentformat erfordert manuelle Konfiguration, und selbst geringfügige Layoutänderungen können zu Extraktionsfehlern führen.
- Kein Lernen: Dieselben Extraktionsfehler wiederholen sich bei ähnlichen Dokumenten, weil das System kein Wissen aus früheren Korrekturen speichert.
- Skalierungsaufwand: Jeder neue Anbieter oder jede Dokumentvariante vervielfacht den Wartungsaufwand, und Organisationen, die Dokumente von Hunderten von Quellen verarbeiten, sehen sich laufenden Betriebskosten gegenüber.
Ein agentic Ansatz begegnet diesen Herausforderungen. Statt statischer Templates analysieren AI-Agents jedes Dokument, generieren Extraktionsanweisungen, validieren Ergebnisse und lernen automatisch aus Korrekturen. Mit der Zeit baut Ihr System eine Wissensbasis von Dokumentformaten auf, sodass Sie ähnliche Dokumente mit minimaler zusätzlicher Konfiguration verarbeiten.
Lösungsübersicht
In dieser Lösung arbeiten acht spezialisierte Agents in zwei graphbasierten Workflows zusammen, die auf Amazon Bedrock AgentCore ausgeführt werden.
Das folgende Diagramm zeigt den mit Strands Agentsaufgebauten Multi-Agent-Workflow-Graph, ein Open-Source-SDK zum Bau von AI-Agents.
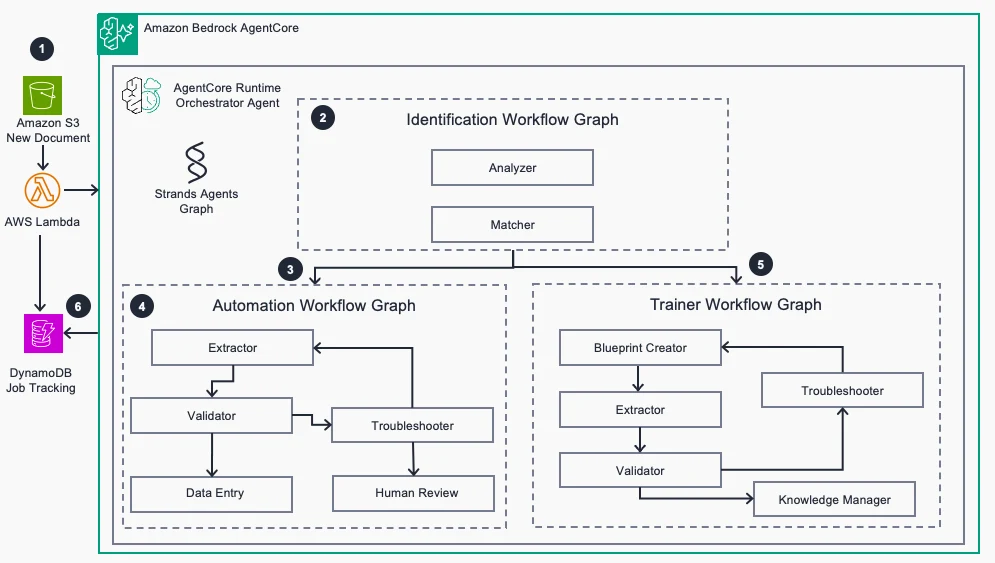
Abbildung 1: Multi-Agent-Orchestrierungs-Workflow-Graph
- Identifikations-Workflow: Der Analyzer-Agent extrahiert Text mit Amazon Textract und identifiziert den Dokumenttyp und den Absender. Der Matcher-Agent sucht mit Vektorähnlichkeit nach ähnlichen Dokumenten in Amazon S3 Vectors, eine Funktion von Amazon Simple Storage Service (Amazon S3).
- Trainings-Workflow (neue Dokumenttypen): Wenn keine Übereinstimmung gefunden wird, generiert der Instructions-Agent Extraktions-Prompts, der Extractor-Agent extrahiert strukturierte Daten, und der Validator-Agent prüft die Ergebnisse anhand von Schemata und Geschäftsregeln in Amazon Aurora DSQL. Schlägt die Validierung fehl, verfeinert der Instructions Fixer-Agent die Prompts und versucht es erneut. Bei Erfolg speichert der Save Instructions-Agent die Anweisungen zur Wiederverwendung.
- Automatisierungs-Workflow (bekannte Dokumenttypen): Wenn eine Übereinstimmung gefunden wird, verwendet der Extractor-Agent vorhandene Anweisungen. Schlägt die Validierung fehl, behebt der Troubleshooter-Agent die extrahierten Daten direkt, ohne die Anweisungen zu ändern.
Funktionsweise
Das folgende Diagramm zeigt die Infrastrukturarchitektur der Lösung.
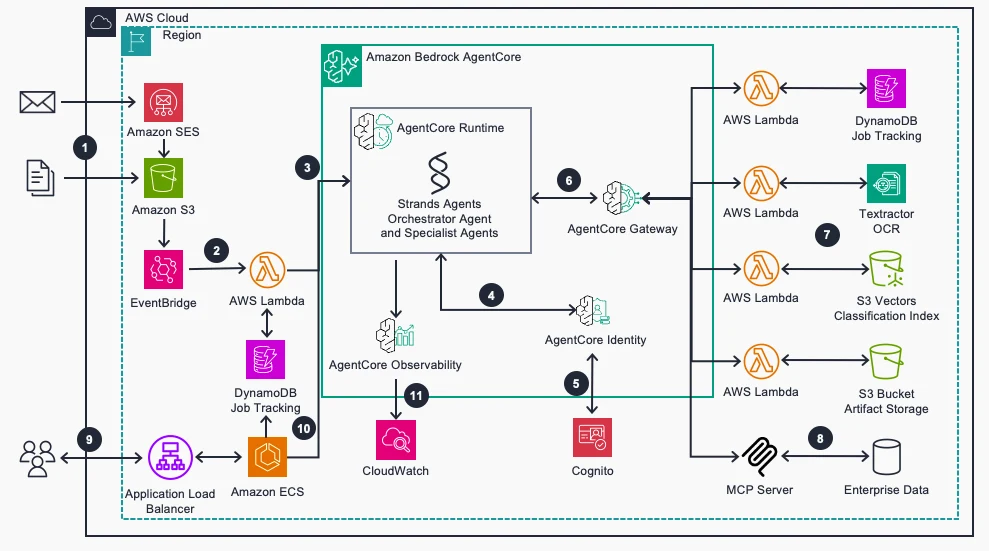
Abbildung 2: Agentic-IDP-Infrastrukturarchitektur auf AWS
- Geschäftsdokumente treffen in Amazon Simple Email Service (Amazon SES) ein oder werden direkt zu Amazon S3 hochgeladen.
- Amazon EventBridge löst eine AWS Lambda -Funktion aus, die einen Nachverfolgungs-Job in Amazon DynamoDB erstellt und AgentCore runtime aufruft, eine Funktion von Amazon Bedrock AgentCore.
- AgentCore runtime orchestriert die Dokumentenverarbeitung über Strands Agents.
- Ihre Agents greifen sicher über Machine-to-Machine-Anmeldeinformationen auf AWS-Ressourcen zu, die von AgentCore Identity verwaltet werden, einer Funktion von Amazon Bedrock AgentCore, und Amazon Cognito.
- Ihre Lambda-Funktionen werden durch die Model Context Protocol (MCP)-Schnittstelle des AgentCore Gateway, einer Funktion von Amazon Bedrock AgentCore, zu agentenkompatiblen Tools.
- Agents extrahieren Text mit Amazon Textract, klassifizieren Dokumente mithilfe von Vektor-Einbettungen in S3 Vectors und validieren Daten anhand von Geschäftsregeln in Aurora DSQL.
- Agents greifen über MCP-Server auf Unternehmensdaten zu, um extrahierte Inhalte anhand von Geschäftsregeln zu validieren.
- Sie überwachen den Status und beheben Probleme über ein Chat-fähiges Dashboard, das auf Amazon Elastic Container Service (Amazon ECS) gehostet wird.
- Sie erhalten Einblick in die Leistung der Agents durch AgentCore Observability, eine Funktion von Amazon Bedrock AgentCore, und Amazon CloudWatch -Telemetrie.
Lösung bereitstellen
Führen Sie die folgenden Schritte aus, um die Lösungsinfrastruktur und Web-UI in Ihrem AWS-Konto bereitzustellen.
Voraussetzungen
Um diese Lösung bereitzustellen, benötigen Sie:
- Ein AWS-Konto.
- Zugriff auf Amazon Bedrock mit aktivierten Amazon Nova- und Anthropic (Claude)-Modellen. Informationen zur Modellverfügbarkeit nach AWS-Region finden Sie unter Supported models by AWS Region in Amazon Bedrock.
- Zugriff auf Amazon Bedrock AgentCore (Runtime, Gateway, Identity), S3 Vectors und Amazon Aurora DSQL in einer unterstützten Region.
- AWS Cloud Development Kit (AWS CDK) v2 installiert.
- Docker installiert und ausgeführt (erforderlich zum Erstellen und Bereitstellen von Container-Images).
- Python 3.11+ und Node.js 18+.
- AWS Identity and Access Management (IAM)-Berechtigungen zum Erstellen von S3-Buckets, Lambda-Funktionen, DynamoDB-Tabellen, Cognito-Benutzerpools, Amazon Elastic Container Registry (Amazon ECR)-Repositorys und Amazon ECS-Services.
- Klonen Sie das Repository und richten Sie die Umgebung ein:
git clone https://github.com/aws-samples/agenticidp-guidance.git cd agenticidp-guidance uv venv source .venv/bin/activate uv pip install -r requirements.txt cd ui/orchestrator npm install cd ../.. - Deployen Sie die Stacks:
uv run deploy.py --admin-email your-email@example.com
Dies deployt sechs AWS CloudFormation -Stacks: Core (S3, Cognito, DynamoDB), Gateway (Lambda tools, AgentCore Gateway), Aurora (Amazon Aurora DSQL), Agent (AgentCore runtime, containers), UI Orchestrator (API endpoints) und Modern UI (React app auf Amazon CloudFront). Das Deployment dauert etwa 15–20 Minuten.
- Überprüfen Sie das Deployment, indem Sie prüfen, dass jeder Stack
CREATE_COMPLETEin der CloudFormation-Konsole anzeigt.
Dateien verarbeiten und Ergebnisse überprüfen
Nach dem Deployment erhalten Sie eine E-Mail mit der CloudFront-URL, dem Benutzernamen und einem temporären Passwort.
Dokument verarbeiten
- Melden Sie sich in der Web-UI an und wählen Sie Process Document.
- Laden Sie einen Beispiel-Auftrag aus
infrastructure/sample_data/purchase_orders/training/. - Das Dokument durchläuft den Agenten-Workflow:
- Der Analyzer-Agent extrahiert Text und identifiziert den Absender sowie den Dokumenttyp.
- Der Matcher-Agent sucht im Vektorspeicher nach ähnlichen Dokumenten.
- Bei einem neuen Dokumenttyp generiert der Trainings-Workflow Extraktionsanweisungen, extrahiert Daten, validiert sie und speichert die Anweisungen für die zukünftige Verwendung.
- Bei einem bekannten Dokumenttyp extrahiert der Automatisierungs-Workflow Daten anhand vorhandener Anweisungen und validiert sie.
- Überprüfen Sie die Ergebnisse im Tab Review Jobs and Instructions , um die extrahierten Daten, Validierungsergebnisse und generierten Anweisungen zu prüfen.
Beispiel: Ein neuer Dokumenttyp (Training-Workflow)
Angenommen, Sie laden die erste Bestellung eines neuen Händlers hoch, Two Wheel Store. Der Matcher-Agent durchsucht den Vector Store, findet kein ähnliches Dokument und leitet den Auftrag durch den Training-Workflow.
Der Analyzer-Agent verwendet Amazon Textract, um den Rohtext des Dokuments zu extrahieren:
# PURCHASE ORDER
FROM: Two Wheel Store
Order #: PO-2026-0102-2584
Date: 2026-01-02

## Items Ordered
AC-021  Advanced Computer     Qty: 1   $75.61
        Colors: cr4321        @ $75.61
...
SB-004  Folding Classic       Qty: 8   $9634.32
        Colors: cb8901 I Sizes: S     @ $1204.29

TOTAL: $14931.54
Der Instructions-Agent generiert Extraktions-Prompts aus dem Schema, und der Extractor-Agent erzeugt strukturiertes JSON:
{
  "po_number": "PO-2026-0102-2584",
  "retailer_name": "Two Wheel Store",
  "order_date": "2026-01-02T00:00:00Z",
  "line_items": [
    { "sku": "AC-021", "product_name": "Advanced Computer", "quantity": 1, "unit_price": 75.61, "line_total": 75.61 },
    { "sku": "SB-004", "product_name": "Folding Classic",   "quantity": 8, "unit_price": 1204.29, "line_total": 9634.32 }
  ],
  "order_total": 14931.54
}
Der Validator-Agent prüft das Ergebnis gegen das Schema und schlägt fehl:
validation_status: INVALID
error: 'SB-004' does not match '^AB-[A-Z]{2}-\d{3}$'
Das SKU-Format des Lieferanten (SB-004) stimmt nicht mit dem internen Format von Acme Bikes überein (AB-SB-004). Der Instructions Fixer-Agent diagnostiziert die Abweichung und fügt dem Extraktions-Prompt eine explizite SKU-Transformationsregel hinzu: Lieferanten-SKUs mit dem Präfix AB-versehen. Beim zweiten Durchlauf werden die sieben Positionen erfolgreich validiert, und der Save Instructions-Agent speichert den verfeinerten Prompt im Vector Store. End-to-End-Zeit für diesen ersten Durchlauf: 3 Minuten 49 Sekunden.
Beispiel: Ein bekannter Dokumenttyp (Automatisierungs-Workflow)
Wenn eine zweite Bestellung von Two Wheel Store eingeht, findet der Matcher-Agent die gespeicherten Anweisungen aus dem ersten Durchlauf mit einem Confidence-Score von 3.946 (Schwellenwert: 3.7) und leitet den Auftrag durch den Automatisierungs-Workflow:
- Der Extractor-Agent wendet die gespeicherten Anweisungen direkt an, sodass der Orchestrator die Prompt-Generierung überspringt. Die während des Trainings gelernte SKU-Transformationsregel wird automatisch angewendet (
EL-002→AB-EL-002,HB-071→AB-HB-071,PD-002→AB-PD-002). - Die drei Positionen werden beim ersten Durchlauf mit einem Bestellwert von $5,979.19 validiert.
- Die End-to-End-Verarbeitung ist in 1 Minute 30 Sekunden abgeschlossen, verglichen mit 3 Minuten 49 Sekunden beim ersten Durchlauf.
Interaktiven Chat nutzen
Das Dashboard enthält eine Chat-Oberfläche zur Fehlerbehebung:
- Fragen Sie
what tools do you haveum die verfügbaren Agent-Funktionen anzuzeigen. - Fragen Sie
list instructionsum die gespeicherten Extraktions-Anweisungen einzusehen. - Fragen Sie
what is the status of job XXXXum den Verarbeitungsfortschritt zu prüfen. - Fragen Sie
what went wrong with job XXXX, how can we update the instructions?um Fehler zu diagnostizieren.
Verstehen, wie die Genauigkeit im Laufe der Zeit verbessert wird
Das System verbessert sich im Laufe der Zeit durch zwei Feedback-Schleifen:
- Training-Schleife: Wenn der Instructions Fixer-Agent Extraktions-Prompts nach Validierungsfehlern verfeinert, werden die verbesserten Anweisungen gespeichert und für ähnliche Dokumente wiederverwendet.
- Verarbeitungs-Schleife: Wenn der Troubleshooter-Agent Extraktionsfehler behebt, liefert er eine detaillierte Analyse, die hilft, Muster in Formatvariationen von Dokumenten zu erkennen.
Verwenden Sie beim Wechseln von Modellen AgentCore Evaluations, eine Funktion von Amazon Bedrock AgentCore, um zu bestätigen, dass die Extraktionsqualität akzeptabel bleibt. Die Lösung verwendet bereits AgentCore Observability und verfügt somit über die erforderliche Instrumentierung.
Geschätzte Kosten
Sie zahlen nur für das, was Sie nutzen, da die Lösung auf serverless- und On-Demand-Ressourcen ohne Leerlaufkosten läuft. Bei einer Arbeitslast von 10 Trainingsdokumenten und 1,000 verarbeiteten Dokumenten pro Monat in US East (N. Virginia) betragen die geschätzten Kosten etwa $58 pro Monat. Die Inferenz des Foundation Model (FM) über Amazon Bedrock macht etwa 85 Prozent der Gesamtkosten aus, mit ungefähr $0.055 pro Dokument. Die tatsächlichen Kosten hängen stark von den Modellen ab, die jedem Agenten zugewiesen sind. Die Modellwahl ist zentralisiert in agents/orchestratorgraph/utils/config.py, sodass Sie kostengünstigere Modelle für einfachere Aufgaben und leistungsstärkere Modelle dort verwenden können, wo es nötig ist. Detaillierte Preisinformationen finden Sie auf der Amazon Bedrock pricing -Seite.
Passen Sie die Lösung an Ihren Anwendungsfall an
Sie erhalten einen Anwendungsfall zur Verarbeitung von Bestellungen mit einem synthetischen Datensatz eines Fahrradunternehmens, einem vorgefertigten JSON-Schema und einer Validierungs-Lambda-Funktion, die extrahierte Daten mit Produkt- und Lieferantendatensätzen in einer Mock-ERP-Datenbank abgleicht. Um Ihre eigenen Dokumente zu verarbeiten, müssen Sie die enthaltenen Schemas und die Validierungslogik durch Ihre eigenen ersetzen.
Definieren Sie Ihr Dokumentschema
Erstellen Sie ein JSON-Schema, das die Felder definiert, die Sie für jeden Dokumenttyp extrahieren möchten. Das Beispiel-Bestellschema in agents/orchestratorgraph/doc_schema/purchase_order_schema.json dient als Referenz. Ihr Schema sollte Feldnamen, Datentypen und ob jedes Feld explizit im Dokument angegeben oder aus dem Kontext abgeleitet ist, festlegen.
Erstellen Sie Ihren Validierungsprozess
Der enthaltene Validator prüft Bestelldaten gegen synthetische Lieferanten- und Produkttabellen in Aurora DSQL. Ihre Produktionsimplementierung erfordert einen Validierungsprozess, der auf Ihre Geschäftsregeln zugeschnitten ist. Zum Beispiel:
- Ein Rechnungsvalidator könnte Lieferanten-IDs gegen Ihr Kreditorensystem prüfen und überprüfen, ob die Positionssummen mit dem Rechnungsgesamtbetrag übereinstimmen.
- Ein Vertragsvalidator könnte überprüfen, ob das Dokument die erforderlichen Klauseln enthält und ob Daten und Parteienamen mit Ihren Datensätzen übereinstimmen.
- Ein Claims-Validator könnte Policennummern, Deckungsgrenzen und Angaben des Anspruchstellers gegen Ihr Policenverwaltungssystem prüfen.
Um einen neuen Validator hinzuzufügen, erstellen Sie eine Lambda-Funktion, die extrahiertes JSON akzeptiert und ein Pass/Fail-Ergebnis mit detaillierten Fehlermeldungen zurückgibt, und registrieren Sie sie dann als Tool im AgentCore Gateway. Siehe gateway/tools/po_validator_tool/ für das Implementierungsmuster.
Agent-Prompts aktualisieren
Die Agent-Prompts in agents/orchestratorgraph/prompts/ verwenden Terminologie für Bestellungen. Aktualisieren Sie diese Prompts, damit sie Ihre Dokumenttypen und Extraktionsanforderungen widerspiegeln. Der Orchestrator-Agent, der Validator-Agent und der Instructions-Agent enthalten jeweils dokumentspezifische Formulierungen, die Sie anpassen sollten.
Best Practices
Behalten Sie diese Empfehlungen im Hinterkopf, wenn Sie Ihr agentic IDP-System trainieren und betreiben.
- Mit repräsentativen Beispielen beginnen: Laden Sie während des Trainings 5–10 Dokumente pro Typ hoch, einschließlich Grenzfälle mit Formatvarianten, um zuverlässige Extraktionsanweisungen aufzubauen.
- Validierung durch Geschäftsregeln verwenden: Verbinden Sie Validatoren mit Ihren Referenzdaten (Lieferantenlisten, Produktkataloge) in Aurora DSQL, um Extraktionsfehler früh zu erkennen.
- Agentenleistung überwachen: Verwenden Sie AgentCore Observability und CloudWatch, um Ausführungspfade nachzuverfolgen, Engpässe zu identifizieren und die Extraktionsgenauigkeit im Zeitverlauf zu messen.
- Dokumenttypen schrittweise hinzufügen: Erstellen Sie für jeden neuen Dokumenttyp ein JSON-Schema und eine entsprechende Validierungs-Lambda-Funktion. Den Rest übernehmen die Agenten.
- Guardrails für die Produktion hinzufügen: Wenden Sie Amazon Bedrock Guardrails an, um Inhaltsfilterung und Grounding-Prüfungen für Agentenausgaben durchzusetzen. Dies ist besonders wichtig, wenn Sie sensible Dokumenttypen wie Versicherungsansprüche oder Kreditanträge verarbeiten.
- Die OWASP Top 10 für LLMs prüfen: Konsultieren Sie die OWASP Top 10 for LLMs and Generative AI Apps bezüglich Sicherheitsaspekten beim Erstellen von Anwendungen, die große Sprachmodelle (LLMs) verwenden.
Aufräumen
Wichtig: Exportieren Sie vor dem Bereinigen die Daten, die Sie behalten möchten. Das destroy.py -Skript löscht dauerhaft verarbeitete Dokumente (S3), den Auftragsverlauf (DynamoDB), Validierungsdaten (Aurora DSQL) und gelernte Extraktionsanweisungen (Vector Store).
Um laufende Kosten zu vermeiden, entfernen Sie die bereitgestellten Ressourcen:
uv run destroy.pyStellen Sie in der Konsole sicher, dass die sechs CloudFormation-Stacks gelöscht wurden: AgenticIDP-Core-Dev, AgenticIDP-Gateway-Dev, AgenticIDP-Aurora-Dev, AgenticIDP-Agent-Dev, AgenticIDP-UIOrchestr-Dev und AgenticIDP-ModernUI-Dev.
Fazit
In diesem Beitrag haben Sie gelernt, wie man ein selbstverbesserndes Dokumentenverarbeitungssystem mit Amazon Bedrock AgentCore erstellt, bei dem spezialisierte KI-Agenten zusammenarbeiten, um Geschäftsdokumente zu klassifizieren, zu extrahieren, zu validieren und daraus zu lernen. Dieser agentic-Ansatz passt sich automatisch an neue Dokumentformate an und verbessert die Genauigkeit im Zeitverlauf durch Feedback-Schleifen, wodurch manuelle Template-Konfiguration durch autonomes Lernen ersetzt wird.
Als nächste Schritte:
- Bereitstellen der Beispiellösung und testen Sie diese mit den mitgelieferten Bestellbeispielen.
- Fügen Sie Ihre eigenen Dokumenttypen hinzu, indem Sie JSON-Schemas und Validierungsregeln erstellen.
- Erfahren Sie, wie Sie extrahierte Daten mit nachgelagerten Systemen wie ERP, CRM oder Content-Management-Tools integrieren können.
Um mehr über die in diesem Beitrag verwendeten Dienste und Muster zu erfahren, konsultieren Sie die folgenden Ressourcen:
- Für einen Einblick in das in dieser Lösung verwendete Agent-Framework lesen Sie Strands Agents SDK: Ein technischer Deep Dive in Agenten-Architekturen und Observability.
- Um zu verstehen, wie das AgentCore Gateway APIs in agentenkompatible Tools umwandelt, lesen Sie Introducing Amazon Bedrock AgentCore Gateway: Transforming enterprise AI agent tool development.
- Für Hintergrundinformationen zum Model Context Protocol und zu dessen Integration in AWS-Services lesen Sie Unlocking the power of Model Context Protocol (MCP) on AWS.
- Um zu erfahren, wie Agents Kontext über Sitzungen hinweg beibehalten können, lesen Sie Amazon Bedrock AgentCore Memory: Building context-aware agents.
- Details zu den Funktionen von Amazon Bedrock AgentCore finden Sie in der Amazon Bedrock AgentCore documentation.
Für fachkundige Unterstützung bei der Entwicklung von Dokumentenverarbeitungslösungen, AWS Professional Services und AWS Partners helfen gerne weiter.