
vLLM ist eine Open-Source-Inferenz- und Serving-Engine für große Sprachmodelle (LLMs). Die LLM-Inferenz hat zwei unterschiedliche Phasen: Prefill, das den Eingabeprompt verarbeitet und den Key-Value-Cache (KV) aufbaut, und Decode, das diesen Cache nutzt, um die Ausgabe Token für Token zu generieren. Diese Phasen haben unterschiedliche Rechen-, Speicher- und Skalierungseigenschaften. Prefill-Decode-Disaggregation (P-D) führt diese Phasen auf separaten Engine-Instanzen aus, sodass jede Phase unabhängig skaliert und optimiert werden kann. Dies kann die Ressourcenauslastung, den Durchsatz und die Latenz unter Last verbessern. Allerdings erfordert dies auch die Übertragung des KV-Cache von der Prefill-Instanz zur Decode-Instanz, bevor die Token-Generierung beginnen kann, was eine effiziente KV-Übertragung für die Time-to-First-Token (TTFT) kritisch macht.
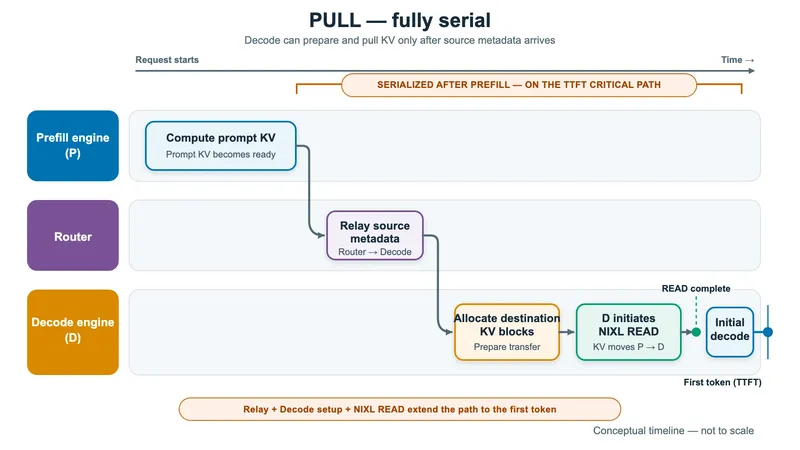
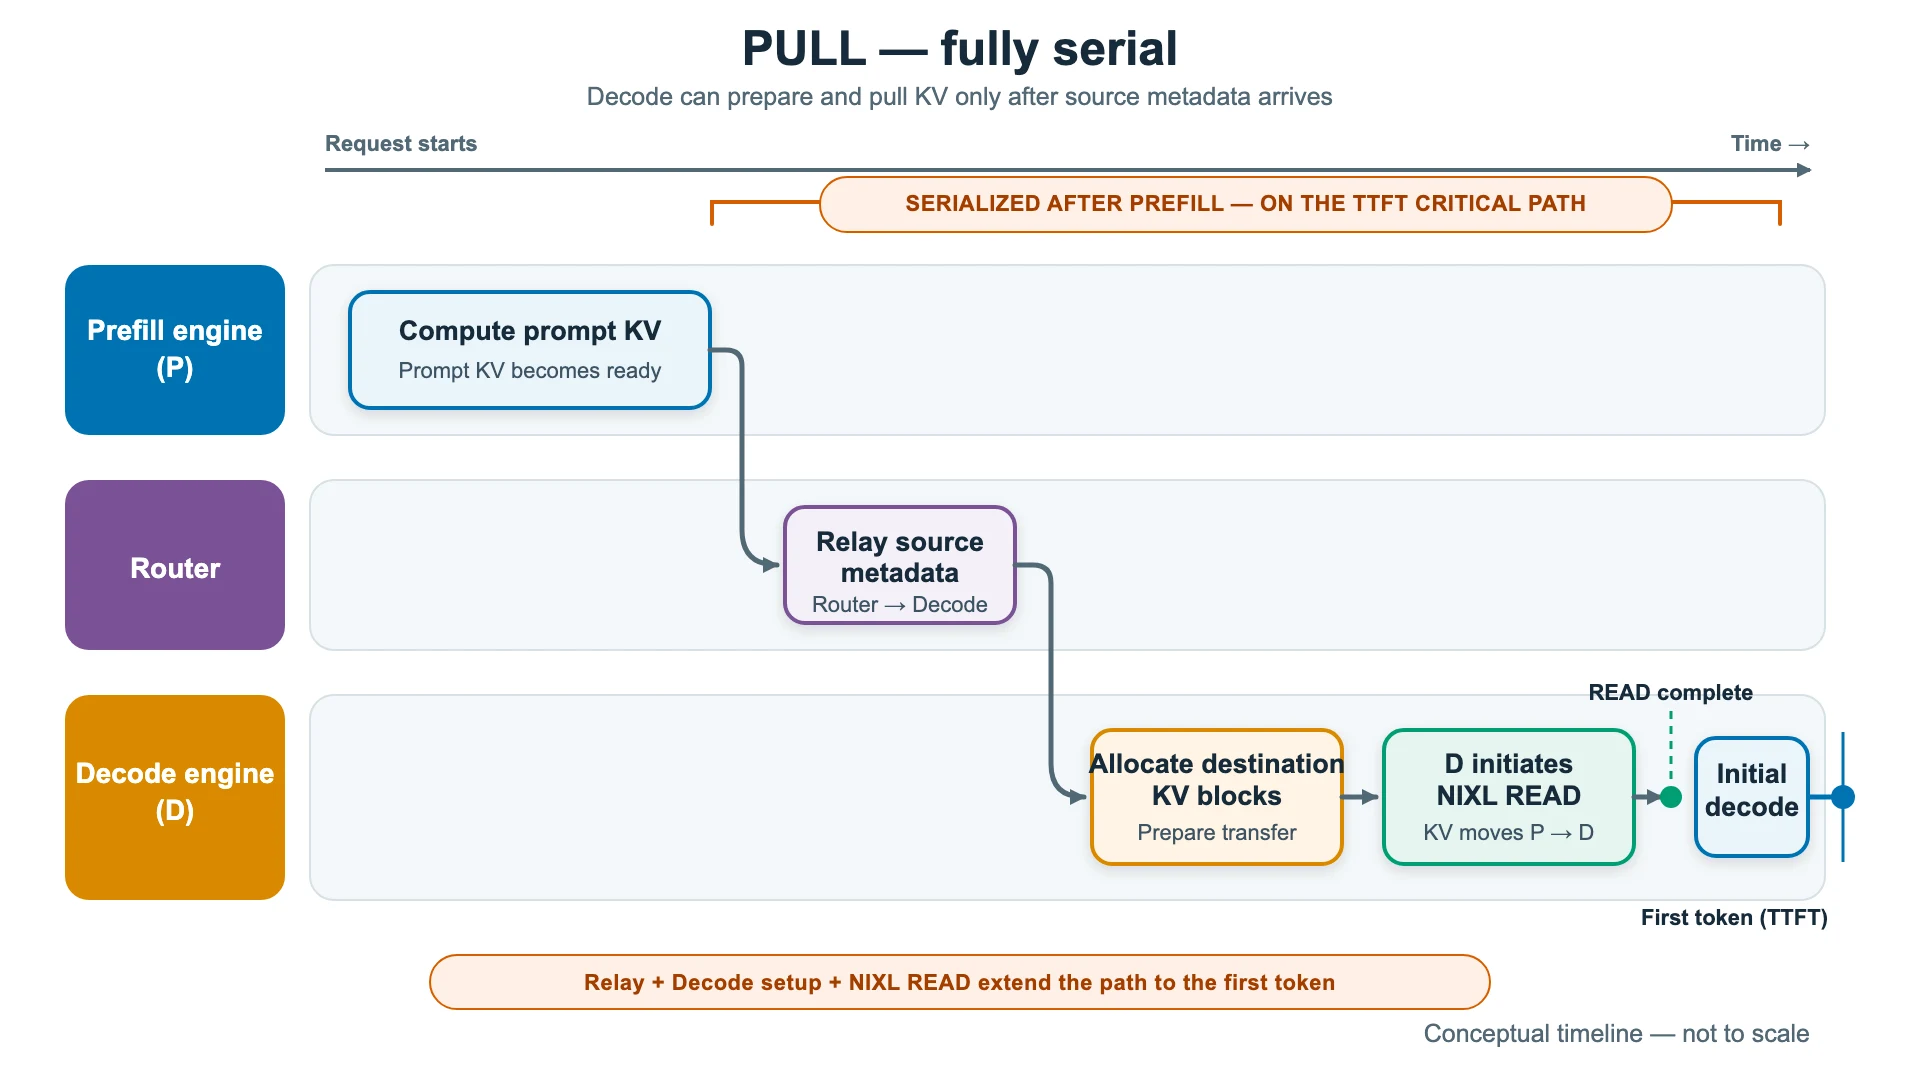
Eine der Möglichkeiten, wie vLLM diese Übertragung durchführt, ist der NVIDIA Inference Xfer Library (NIXL) Connector, der KV-Blöcke über RDMA-fähige Interconnects wie den AWS Elastic Fabric Adapter (AWS EFA, das RDMA-Netzwerk mit geringer Latenz, das serverübergreifend in AWS eingesetzt wird) überträgt. Auf unterstützten Instanztypenunterstützt AWS EFA GPUDirect RDMA und Neuron Direct RDMA, wodurch NIXL KV-Blöcke direkt zwischen GPU- oder Trainium-Gerätespeicher übertragen kann, ohne durch den Host-Speicher zu puffern. Der Standardmodus für den NIXL-Connector ist pull-basiert: Nachdem die Prefill-Instanz die Berechnung des Prompt-KV-Cache abgeschlossen hat, leitet der Router die Quell-Metadaten, einschließlich der Prefill-Block-IDs, an die Decode-Instanz weiter. Die Decode-Instanz ordnet dann Zielblöcke zu, bereitet den NIXL-Transfer vor und initiiert NIXL READ, um die KV-Blöcke von der Prefill-Instanz zu ziehen. Da diese Koordinations- und Einrichtungsschritte sequenziell nach dem Prefill und vor dem Beginn des Decodings erfolgen, verlängern sie den TTFT-kritischen Pfad, wie in der folgenden Zeitleiste dargestellt.
Dieser Beitrag stellt einen push-basierten NIXL-Connector vor, der die Koordinierung und Einrichtung der Übertragung nach dem Prefill vom kritischen Pfad verlagert. Für Kunden, die disaggregierte Prefill/Decode-Inferenz mit vLLM betreiben, kann dies die Anwendungsreaktionsfähigkeit durch Reduzierung von TTFT und TPOT verbessern, insbesondere bei hohen Anforderungsraten.
In unserem Benchmark auf einer 1P1D-Bereitstellung mit Amazon EC2 P5en-Instanzen, die mit EFA verbunden sind, lieferte der Push-Modus bis zu 3x besseres TTFT und bis zu 30% bessere Time-per-Output-Token (TPOT) im Vergleich zum Pull-Modus (siehe Abschnitt Performance-Daten ) für das Modell Qwen3-32B; die Ergebnisse hängen von Arbeitslast und Konfiguration ab.
Wir haben die Funktion auf AWS Trainium-Instanzclustern mit EFA entwickelt und validiert und anschließend als beschleunigeragnostische Funktion zu vLLM beigetragen. Die Ergebnisse hier stammen aus einem AWS p5en (GPU)-Cluster mit EFA und zeigen, dass die Gewinne auch auf GPUs übertragbar sind. Dieser Beitrag erklärt die push-basierte Architektur, den Transferablauf, das Threading-Modell, die Leistungsergebnisse und wie man den Benchmark reproduziert.
Push-basierte KV-Übertragung
Architekturübersicht
Die push-basierte Übertragung verbessert TTFT und Decode-Durchsatz aus zwei Gründen:
- Sie beseitigt die Serialisierung des Pull-Modells durch Überlappung der Arbeit von Produzent und Konsument. Die Decode-Instanz registriert ihre Zielblöcke im Voraus, während der Produzent noch KV berechnet. Die Übertragung beginnt dann, sobald die Blöcke des Produzenten bereit sind, und nicht erst nach einem Roundtrip zur Identifikator-Erkennung auf der Konsumentenseite, wodurch dieser Roundtrip vom Pfad zum ersten Token entfernt wird.
- Sie verlagert die Zeit für die Transfer-Einrichtung von der Decode-Instanz weg. Diese Einrichtung — das Vorbereiten der NIXL-Deskriptoren und das Absenden des Transfers — läuft auf der Prefill-Seite und in einem Hintergrundthread, sodass die Decode-Instanz diese Zyklen nicht während ihrer latenzkritischen Token-Generierungsphase verbraucht.
Der Nettoeffekt sind niedrigeres TTFT und höherer Output-Token-Durchsatz auf der Decode-Instanz.
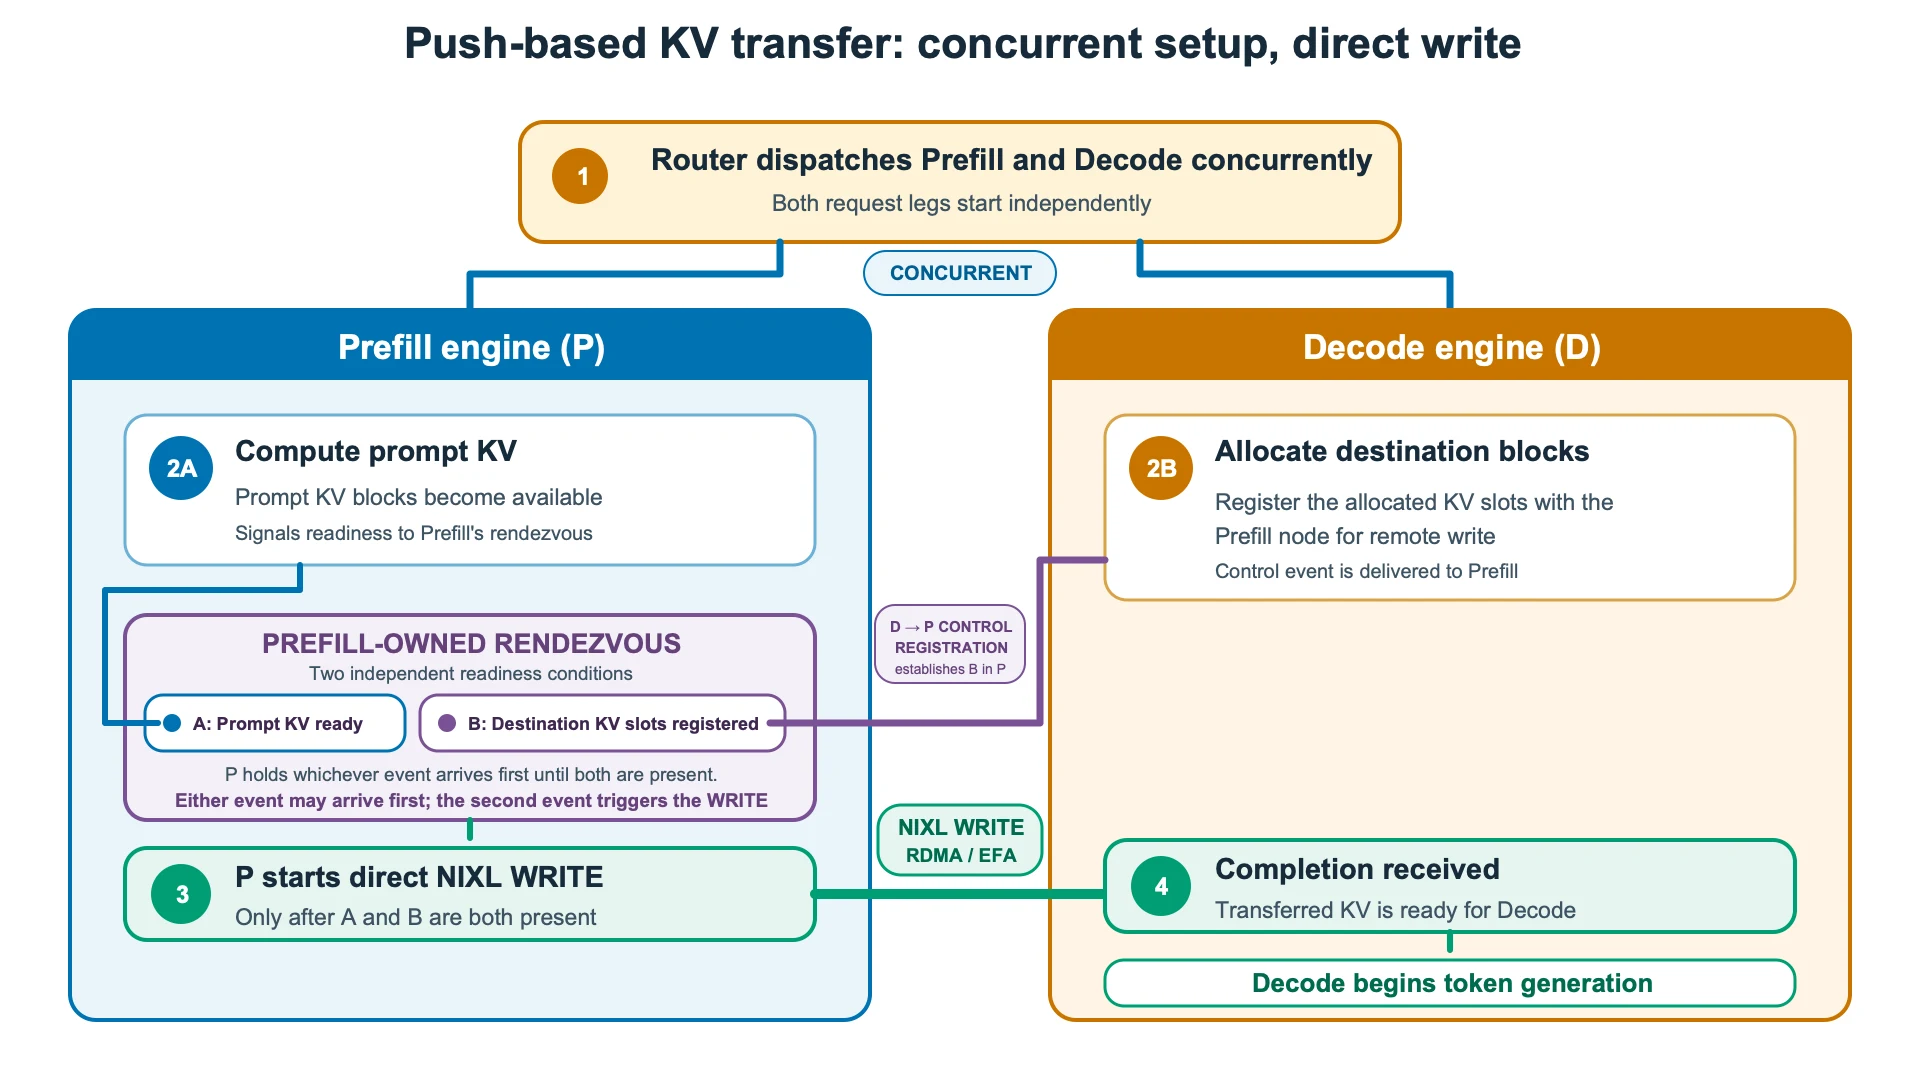
Der Push-Konnektor koordiniert drei Akteure: die Decode-Instanz, die ihre Zielblöcke vorab registriert; die Prefill-Instanz, die jede Anfrage abgleicht und die Übertragung auslöst; und einen dedizierten Hintergrund-Thread, der den KV-Schreibvorgang aus der Forward-Pass-Schleife der Engine herauslöst. Das folgende Diagramm zeigt, wie diese Teile zusammenspielen.
Implementierungsdetails
Das Protokoll besteht aus drei logischen Schritten.
1. Registrierung (Decode-Seite). Wenn die Decode-Instanz lokale Blöcke für eine Anforderung zuweist, die ein Remote-Prefilling erfordert, bereitet sie eine Registrierung vor, die beschreibt, wohin die Prefill-Instanz das KV schreiben soll: ihre eigene Identität und die Blockpositionen, die sie gerade reserviert hat. Innerhalb desselben Engine-Schritts übermittelt der Worker diese Registrierung als NIXL-Benachrichtigung an die Prefill-Instanz. Da die Registrierung zum Zeitpunkt der Zuweisung erfolgt, kennt der Connector die Zielblöcke, bevor die Prefill-Instanz das Prefilling abgeschlossen hat.
2. Rendezvous (Prefill-Seite). Die Registrierung vom Decoder und der Abschluss von Prefill auf dem Producer können in beliebiger Reihenfolge eintreffen, und der Connector behandelt beides. Trifft die Registrierung zuerst ein, hält der Producer sie zurück, bis sein eigenes Prefill abgeschlossen ist. Ist das Prefill zuerst fertig, hält der Producer die Blöcke der Anfrage zurück, bis die Registrierung eintrifft. Welches Ereignis auch immer als zweites eintritt, löst die Übertragung aus. Der Connector ordnet Anfragen anhand des Bezeichners zu, und die Zuordnung berücksichtigt erneut übermittelte Anfragen und verbindet verdrängte oder wiederholte Anfragen korrekt.
3. Transfer (Prefill-Seite). Sobald eine Anfrage gematcht wurde, baut der Producer eine Verbindung zur Decode-Instanz auf (sofern noch keine existiert) und führt ein NIXL WRITE aus, das die KV-Blöcke direkt in den registrierten Speicher des Decoders kopiert, wobei jeder Ziel-Tensor-Parallel-Rank adressiert wird. Producer und Consumer können unterschiedliche interne Block-Layouts verwenden. Jede Seite mappt die Blockpositionen zur Übertragungszeit auf ihr eigenes physisches Layout, wodurch unterschiedliche Blockgrößen auf jeder Seite möglich sind. Jedes WRITE enthält eine Abschlussbenachrichtigung, die NIXL der Decode-Instanz zustellt, sobald die Daten angekommen sind. Der Decoder zählt diese Benachrichtigungen – eine pro Producer-Rank, der in ihn schreibt – und behandelt die KV-Daten erst als empfangen, wenn alle erwarteten Benachrichtigungen eingegangen sind; zu diesem Zeitpunkt geht die Anfrage in die Dekodierung über.
Threading-Modell
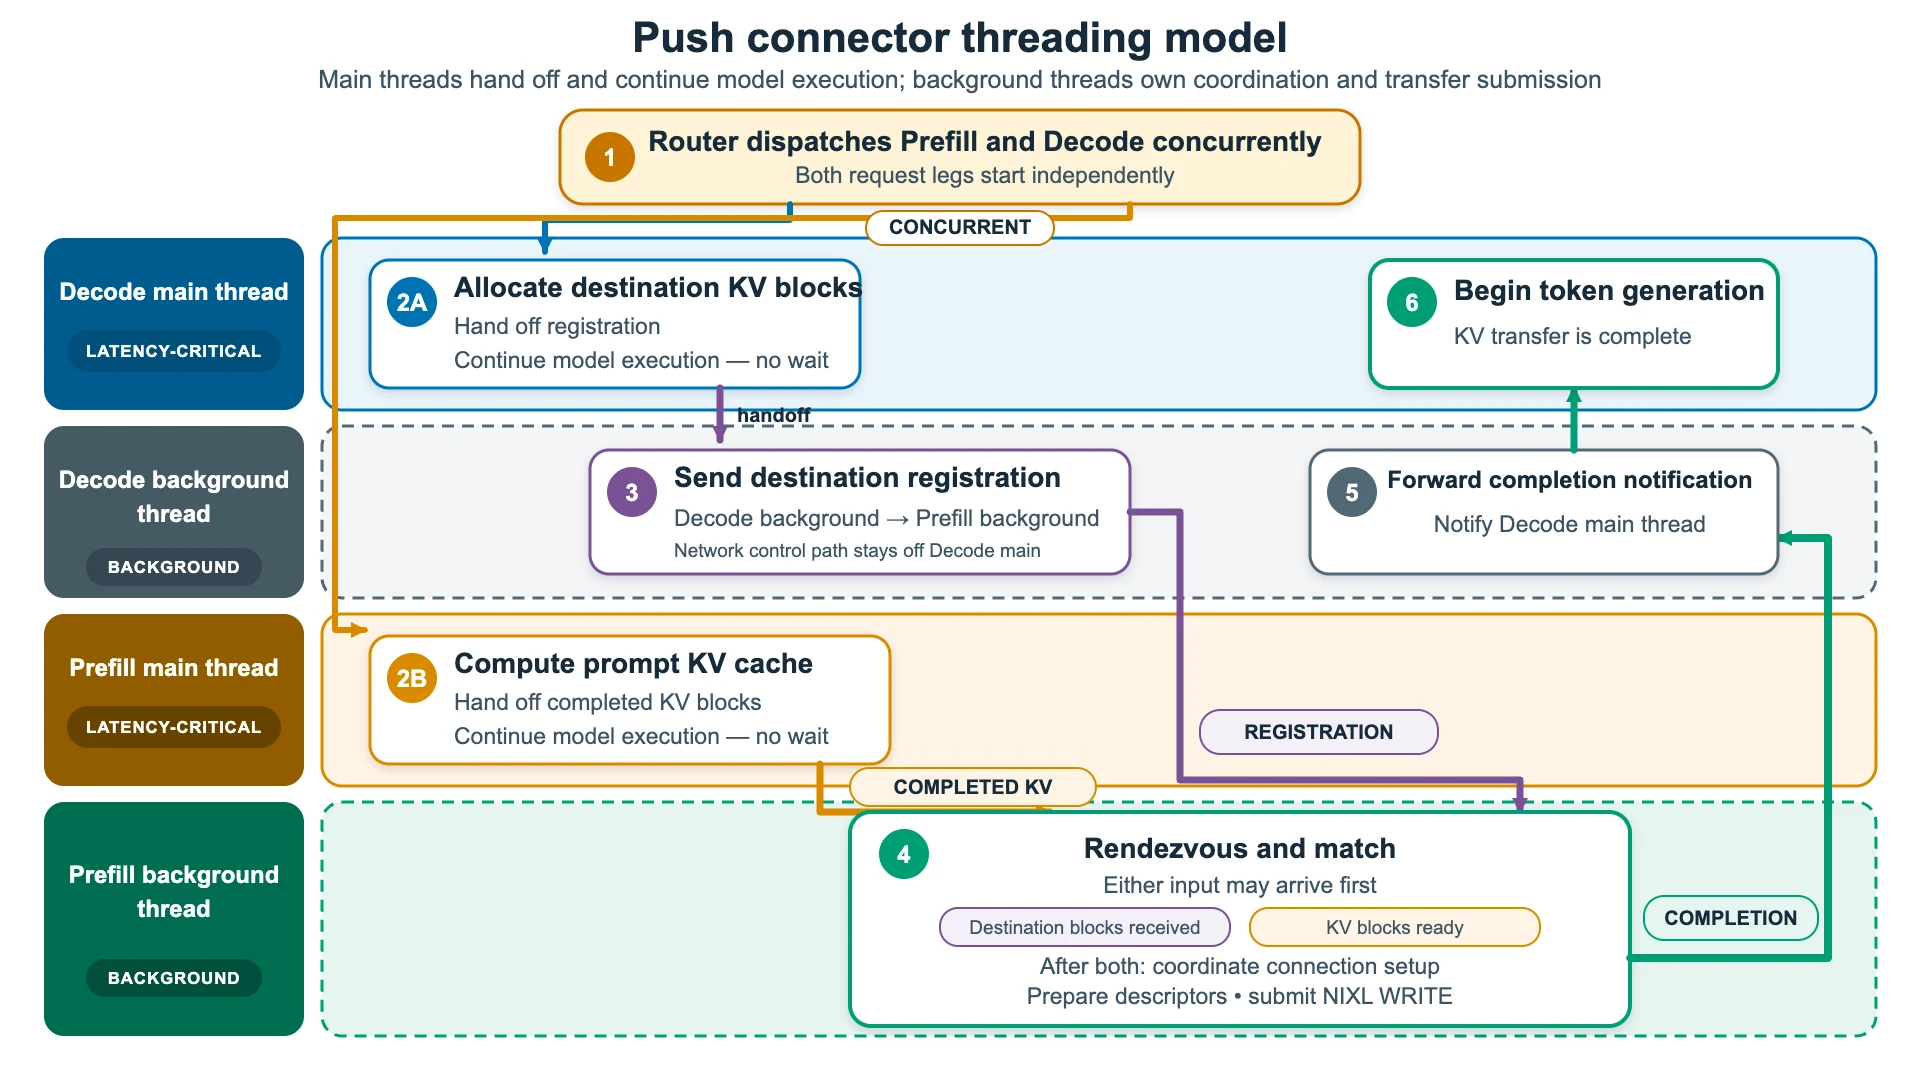
Der Push-Connector entkoppelt die Modellausführung von der Vorbereitung der KV-Übertragung, indem er auf jedem Prefill-Worker einen eigenen Hintergrund-Übertragungsthread verwendet. Zu Beginn einer Anfrage allokiert die Decode-Hauptschleife ihre Ziel-KV-Blöcke und registriert sie bei der Prefill-Instanz, während die Prefill-Hauptschleife den Prompt-KV-Cache berechnet. Sobald sowohl die Zielregistrierung als auch der Prompt-KV bereit sind, übergibt die Prefill-Hauptschleife die KV-Blöcke an den Hintergrundthread und kehrt schnell zur Modellausführung zurück.
Der Hintergrund-Thread establishes oder uses die NIXL-Verbindung erneut wait no—produce German properly.
Zeitvergleich: Pull vs. Push
Das folgende Diagramm fasst die in den vorangegangenen Abschnitten beschriebenen Pull- und Push-Übertragungsflüsse zusammen und hebt deren Auswirkung auf die TTFT hervor. Obwohl beide Modi denselben NIXL- und EFA/RDMA-Datenpfad verwenden, führt Pull die Metadaten-Weiterleitung und das Setup auf der Decode-Seite nach dem Prefill durch, während Push das Setup auf der Decode-Seite mit dem Prefill überlappt. Dadurch entfernt Push diese Operationen aus dem kritischen Pfad nach dem Prefill, sodass die Dekodierung früher beginnen kann.
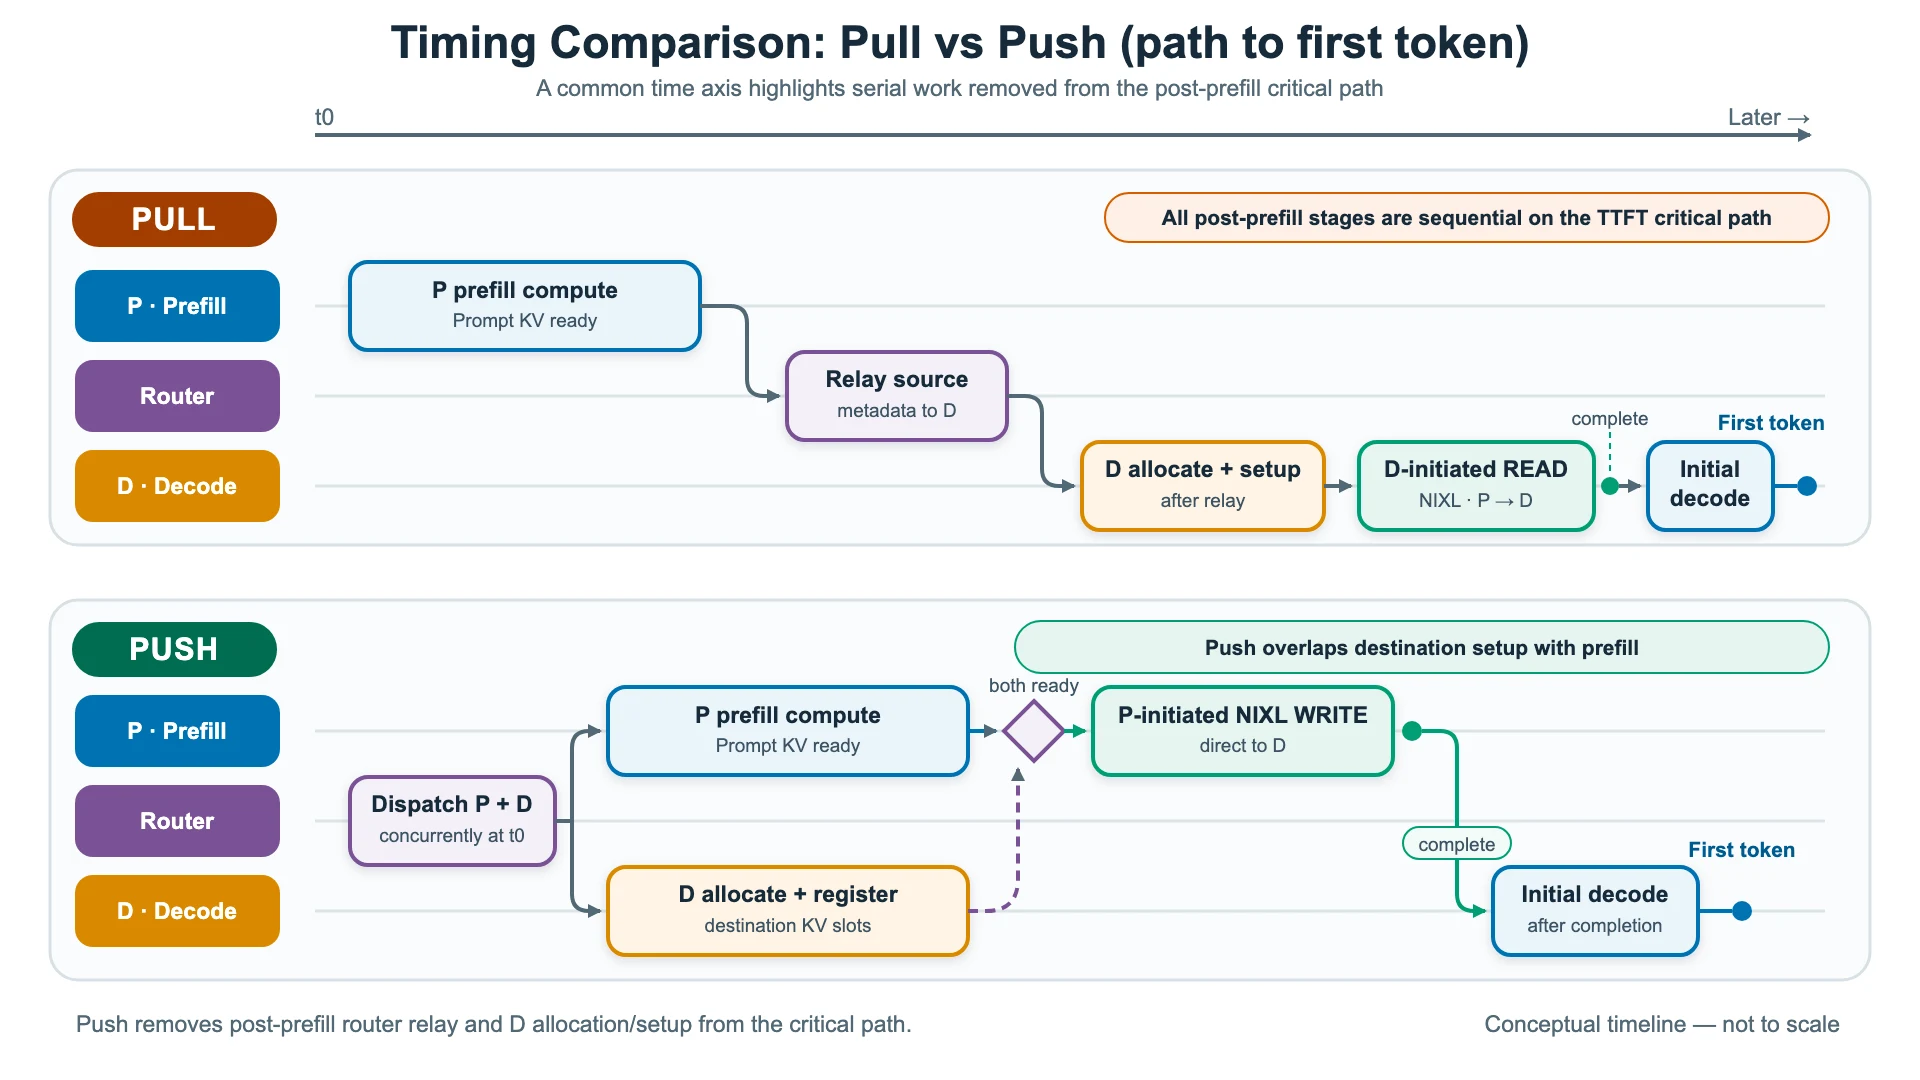
Die beiden Modi beinhalten auch einen Routing-Kompromiss. Der Pull-Modus ermöglicht dem Router, eine Decode-Instanz erst nach Abschluss des Prefill auszuwählen, was mehr Flexibilität für lastbewusstes Routing und Quality-of-Service-Management bietet. Der Push-Modus wählt die Decode-Instanz früher aus, damit sich das Einrichten des Ziels mit dem Prefill überlappen kann. Dafür kann die Prefill-Instanz bei vergleichbarer Last ihre KV-Blöcke früher freigeben, weil die Übertragung startet, sobald sowohl der Prompt-KV als auch die Zielregistrierung bereit sind.
Leistungsdaten
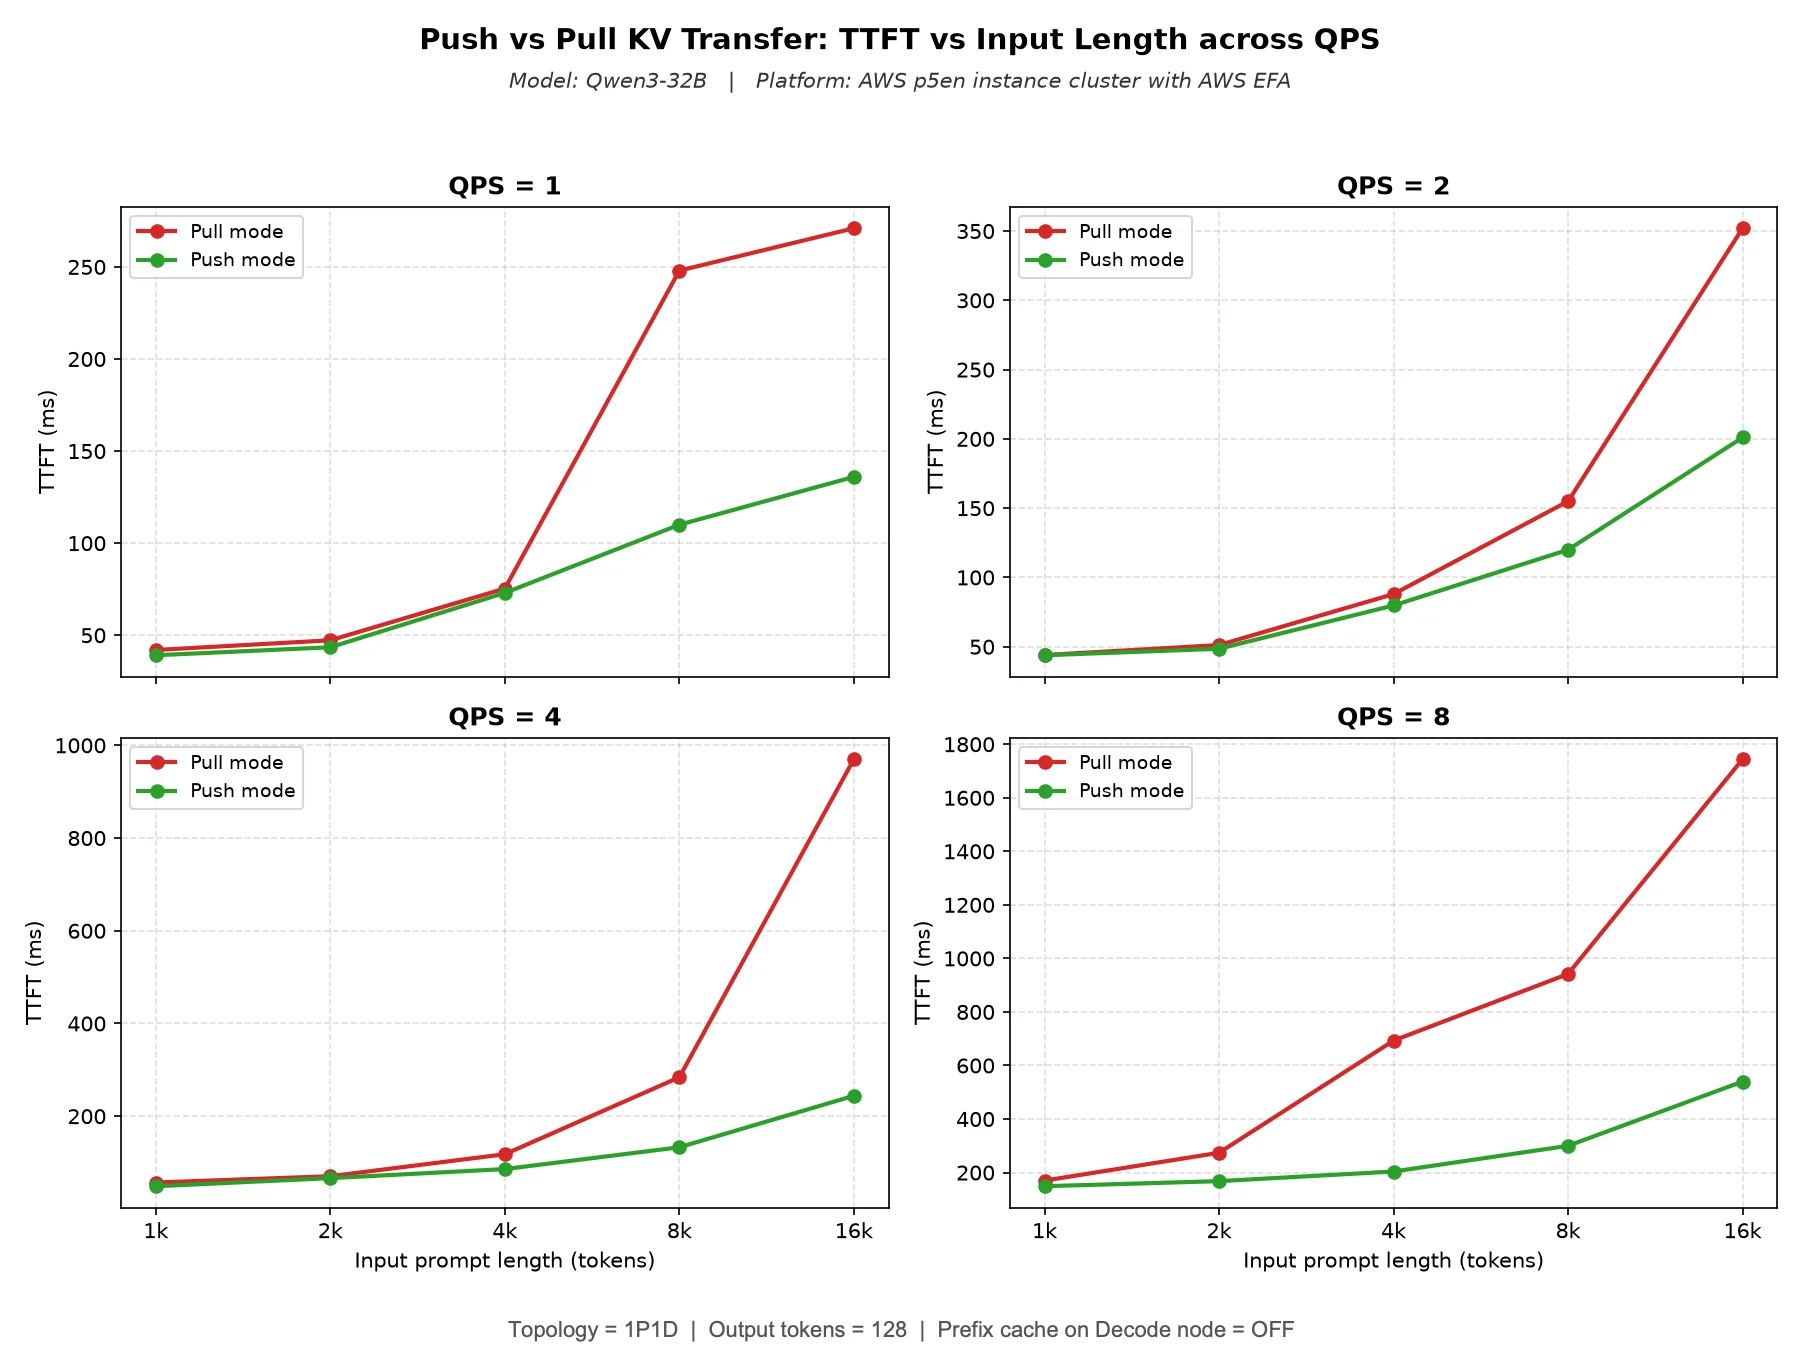
Für die Evaluierung verwendeten wir das Modell Qwen3-32B in einer 1P1D-Bereitstellung auf Amazon EC2 P5en-Instanzen, die über EFA verbunden sind. Um die P→D-Transferleistung zu isolieren, konfigurierten wir den Benchmark so, dass Prefix-Caching mit --no-enable-prefix-cachingdeaktiviert war. Diese Konfiguration bewirkt, dass der Decode-Knoten den vollständigen KV-Cache für jede Anfrage vom Prefill-Knoten abruft. Andernfalls könnten sich überlappende Prompts den lokalen Cache des Decode-Knotens wiederverwenden und die Übertragung umgehen, was irreführende Vergleichsergebnisse liefern würde.
Das folgende Diagramm vergleicht die TTFT für Push- und Pull-KV-Transfer. Wir variieren die Eingabelängen 1k–16k und die Anfrageraten 1–8 QPS. Bei geringer Last und kurzen Prompts verhalten sich die beiden Modi nahezu identisch. Wenn QPS und Eingabelänge wachsen, verschlechtert sich der Pull-Modus deutlich und erreicht etwa 1,744 ms bei 8 QPS und 16k. Der Push-Modus bleibt mit rund 540 ms deutlich niedriger, eine Reduktion um etwa 3x. Die Lücke entsteht, weil der Pull-Modus NIXL-Deskriptoren inline auf dem Decode-Worker postet, synchron innerhalb seiner Engine-Schleife, sodass diese Arbeit die Token-Generierung blockiert. Der Push-Modus verlagert sie in einen Hintergrund-Thread, außerhalb des kritischen Pfads.
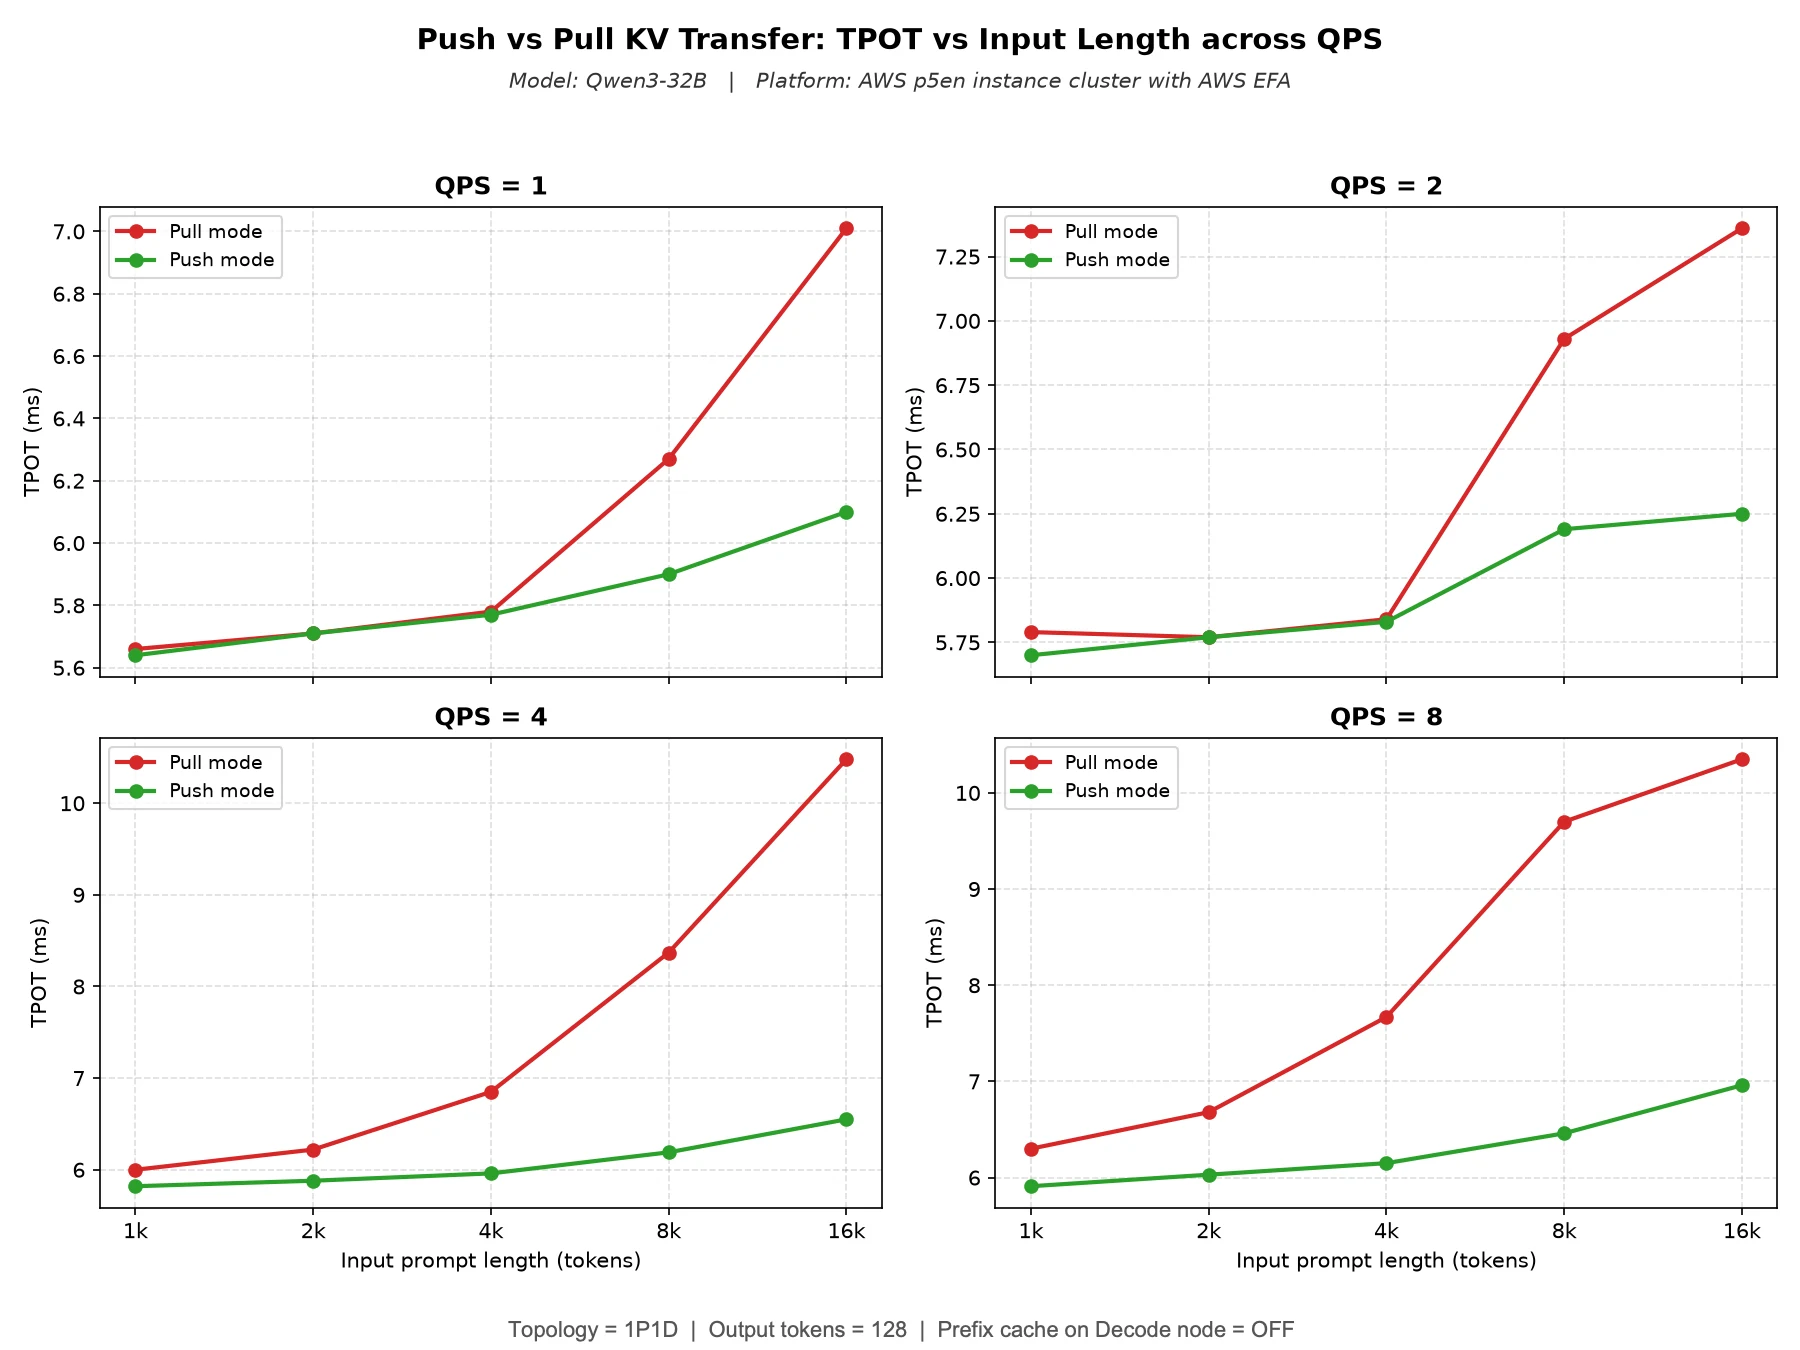
Dieses Diagramm zeigt den TPOT unter denselben Bedingungen. Das Muster spiegelt den TTFT wider. Bei geringer Last liegen Push und Pull nahe beieinander, etwa bei 5.6–5.8 ms. Mit steigender Last und Eingabelänge klettert Pull auf etwa 10.4 ms bei 4–8 QPS und 16k, während Push bei etwa 7 ms bleibt. Der Grund ist, dass Push die Deskriptorvorbereitung und die Übermittlungsübermittlung vom Decode-Worker auslagert. Die Token-Generierung wird nie ausgehungert, daher bleibt die Latenz pro Token selbst bei hoher Parallelität und langen Kontexten konstant.
So führen Sie den Benchmark aus
Um unsere 1P1D-Benchmark-Konfiguration mit einem Prefill-Knoten und einem Decode-Knoten unter Verwendung von Amazon EC2 P5en-Instanzen, verbunden mit EFA, zu reproduzieren, folgen Sie den detaillierten Anweisungen im Reproducing our results -Guide. Der Guide behandelt die Einrichtung der Umgebung, das Starten der vLLM-Prefill- und Decode-Server, die Ausführung des Benchmarks und das Sammeln der Ergebnisse. Das Feature kann auf anderen unterstützten Konfigurationen ausgeführt werden, aber die Leistungsergebnisse variieren je nach Hardware, Modell, Workload und Netzwerkkonfiguration.
Fazit
In diesem Beitrag haben wir gezeigt, wie der push-basierte KV-Connector die Prefill-Berechnung mit der Blockzuweisung und Registrierung auf der Decode-Seite überlappt und damit den Router-Roundtrip nach dem Prefill sowie die Übertragungseinrichtung auf der Decode-Seite aus dem kritischen Pfad entfernt. Dies reduziert TTFT und TPOT, insbesondere bei hohen Anforderungsraten. In unserem Qwen3-32B-Benchmark auf einer 1P1D-Bereitstellung mit Amazon EC2 P5en-Instanzen, verbunden mit EFA, bot der Push-Modus bis zu eine 3x-Verbesserung beim TTFT und 30% Verbesserung beim TPOT im Vergleich zum Pull-Modus. Die Ergebnisse variieren je nach Workload und Konfiguration. Um den Push-Modus zu verwenden, konfigurieren Sie sowohl die Prefill- als auch die Decode-Server so, dass sie NixlPushConnector anstatt NixlConnector.
verwenden. Wählen Sie den push-basierten Connector, wenn eine frühe Decode-Knotenauswahl akzeptabel ist und ein niedrigerer TTFT Priorität hat. Der pull-basierte Connector bleibt die bessere Wahl für Workloads, die eine bidirektionale KV-Übertragung erfordern oder die Decode-Instanzauswahl bis nach dem Prefill für lastbewusstes Routing aufschieben. vLLM unterstützt sowohl push- als auch pull-basierte KV-Connectors, sodass Benutzer den Ansatz wählen können, der am besten zu ihrer Bereitstellung passt.
Als zukünftige Verbesserung untersuchen wir, das Hintergrund-NIXL-Threading-Modell auf den Pull-Mode-Connector zu übertragen, wodurch das NIXL-Setup aus dem kritischen Pfad verlagert würde, sodass Pull-Mode-Workloads von denselben Optimierungen profitieren könnten; wir haben einen Pull Request (#45211) geöffnet, um dies zu untersuchen.
Verwandte Ressourcen
Danksagungen
Wir danken der vLLM-Community für ihre Unterstützung bei der Wartung dieses Features.
Anhang: Reproduktion unserer Ergebnisse
Die Topologie besteht aus zwei p5en-GPU-Knoten (Prefill auf :8100, Decode auf :8200) mit aktiviertem EFA, plus einem dritten kleineren Knoten, der den Proxy und den Benchmark-Client ausführt. Mit diesem Beitrag werden drei Skripte ausgeliefert: serve_pd.sh startet einen der beiden Zweige in einem der beiden Modi, run_sweep.sh steuert den Sweep, und cleanup.sh baut alles ab. plot_push_vs_pull.py erstellt die beiden obigen Abbildungen aus den Ergebnis-JSONs neu.
Testumgebung
Beide GPU-Knoten wurden identisch konfiguriert:
| Instance-Typ | p5en.48xlarge (8x NVIDIA H200), einer für Prefill und einer für Decode |
| Region / AZ | ap-south-1 (Mumbai), ap-south-1b (AZ ID aps1-az3), beide Knoten in derselben AZ |
| Platzierung | Kein Cluster-Placement-Group; beide Instanzen wurden in eine gezielte On-Demand Capacity Reservation mit Default-Tenancy gestartet |
| AMI | Öffentliches AWS ParallelCluster 3.14.2-Image für Ubuntu 24.04 x86_64, aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae in ap-south-1; AMI-IDs unterscheiden sich je nach Region). Es bringt Kernel 6.14.0-1018-aws, NVIDIA-Treiber 570 und CUDA 12.8 mit, daher müssen Treiber, CUDA-Toolkit und EFA-Installer auf die unten genannten Versionen aktualisiert werden. |
| Betriebssystem / Kernel | Ubuntu 24.04.4 LTS, 6.14.0-1018-aws |
| NVIDIA-Treiber / CUDA | Treiber 580.126.16 (CUDA 13.0 Treiber-API); CUDA-Toolkit 13.0 |
| EFA-Schnittstellen | 16 pro Instanz, eine pro Netzwerkkarte (Karten 0-15, alle vom Schnittstellentyp efa), jeweils 200 Gb/s für insgesamt 3.2 Tb/s. 8 Schnittstellen sitzen auf jedem NUMA-Knoten, und jede GPU teilt sich einen PCIe-Switch mit 2 davon. |
| EFA-Software | EFA-Installer 1.50.0, EFA-Kernelmodul 3.3.0g, libfabric 2.6.0amzn1.0, rdma-core 64.0amzn0 |
EFA-Geräteauswahl durch NIXL. Das LIBFABRIC-Backend öffnet alle 16 EFA-Geräte als Rails mit dem efa -Provider. Anschließend registriert es den KV-Cache jeder GPU nur auf den 2 Rails, die den PCIe-Switch dieser GPU teilen, sodass jede Übertragung PCIe-lokal bleibt. Es wurden keine NIXL- oder libfabric-Geräte-Overrides gesetzt; dies ist die Standardauswahl. Um dies auf Ihren eigenen Nodes zu bestätigen, starten Sie die Server mit NIXL_LOG_LEVEL=DEBUG und prüfen Sie die Registrierungszeilen:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. Die Nodes bereitstellen
Installieren Sie den EFA-Userspace-Stack auf beiden GPU-Nodes und bestätigen Sie, dass der Provider vorhanden ist. Wir haben den Installer 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa            # verify the EFA provider is present
Die beiden GPU-Nodes müssen sich auf 8100/8200 sowie auf dem NIXL-Seitenkanal (5600).
2. vLLM und NIXL installieren
Auf beiden GPU-Nodes:
python3.12 -m venv ~/vllm_env && source ~/vllm_env/bin/activate
pip install --upgrade pip
pip install vllm==0.29.0      # any build that includes the NIXL push connector
pip install nixl==1.4.1       # NIXL with the libfabric/EFA backend
Auf dem Proxy-Node (keine GPU-Runtime erforderlich):
pip install vllm aiohttp fastapi uvicorn pandas datasets3. Das Modell herunterladen
export HF_HOME=/shared/huggingface     # a large shared volume
hf download Qwen/Qwen3-32B
4. Das P/D-Paar starten
Führen Sie serve_pd.sh einmal pro GPU-Node aus. Der einzige Unterschied zwischen den beiden Modi ist kv_connector: NixlConnector für Pull, NixlPushConnector für Push. Ports, Engine-IDs, Rollen und Ranks bleiben gleich.
# on the prefill node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=prefill MODE=pull ./serve_pd.sh
# on the decode node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=decode  MODE=pull ./serve_pd.sh
Was sich auf der Prefill-Seite erweitert zu:
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"]}}'
Der Decode-Server fügt --no-enable-prefix-cachinghinzu, was jeden Request zwingt, den vollständigen KV von Prefill abzurufen — genau das, was wir messen. Bei aktiviertem Caching könnten überlappende Prompts den lokalen Cache des Decode-Nodes treffen und die P->D-Übertragung überspringen, was zu irreführenden Zahlen führen würde. Warten Sie, bevor Sie das Benchmarking starten, bis beide /health -Endpoints 200 zurückgeben.
5. Die Sweep-Messung durchführen
Das Benchmark-Skript befindet sich in #57567; es wählt den Proxy aus, der zum Modus passt (disagg_proxy_demo.py für Pull, disagg_proxy_pushconnector_demo.py für Push) und steuert ihn mit vllm bench serve.
git clone https://github.com/vllm-project/vllm.git ~/vllm && cd ~/vllm
git fetch origin pull/57567/head:pd-bench && git checkout pd-bench
export VLLM_SRC=~/vllm

VLLM_SRC=~/vllm PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> \
  MODE=pull ./run_sweep.sh
an. Beenden Sie dann beide Server und starten Sie Schritt 4 neu mit MODE=push auf jedem Knoten und führen Sie den Sweep mit MODE=pusherneut aus. Der Push-Modus benötigt zusätzlich die NIXL-Koordinaten der Prefill-Instanz (PREFILL_ENGINE_ID, PREFILL_KV_HOST, PREFILL_SIDE_CHANNEL_PORT, PREFILL_TP_SIZE, PREFILL_PP_SIZE), damit der Proxy dem Decode-Knoten mitteilen kann, wo er sich registrieren soll; run_sweep.sh füllt diese anhand der oben verwendeten Standardwerte aus. Lassen Sie QPS_LIST, INPUT_LENS, und OUTPUT_LENS über die beiden Läufe hinweg identisch und stellen Sie sicher, dass PREFILL_TP_SIZE der tatsächlichen Tensor-Parallel-Größe des Prefill-Servers entspricht.
results/ enthält <mode>_qps<q>_in<in>_out<out>_iter<i>.json (plus .log) mit TTFT, ITL, Durchsatz und End-to-End-Latenz pro Lauf. Um die Abbildungen neu zu zeichnen:
python plot_push_vs_pull.py --results-dir ./results --metric ttft
python plot_push_vs_pull.py --results-dir ./results --metric tpot
Fehlerbehebung
- Server stürzt direkt nach der ersten Anfrage ab — der Modus stimmt nicht mit dem Connector überein. Pull benötigt
NixlConnector; Push benötigtNixlPushConnector, auf beiden P und D. Backend 404: model ... does not exist—SERVED_MODEL_NAMEstimmt nicht mit dem der Server überein--served-model-name(Qwen).- Proxy-Bereitschaft läuft auf Timeout — stellen Sie sicher, dass der Proxy für den gewählten Modus unter
$VLLM_SRC/examples/disaggregated/disaggregated_serving/existiert und dass sowohl P als auch D/health200 zurückgeben. - NIXL-Handshake- oder Übertragungsfehler — überprüfen Sie EFA (
fi_info -p efa), dass der Side-Channel-Port (5600) zwischen P und D offen ist und dassPREFILL_TP_SIZEder Tensor-Parallel-Größe des Prefill-Servers entspricht.
Aufräumen
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
Folgen Sie dann dem AWS EC2-Benutzerhandbuch, um die Instanzen zu beenden.