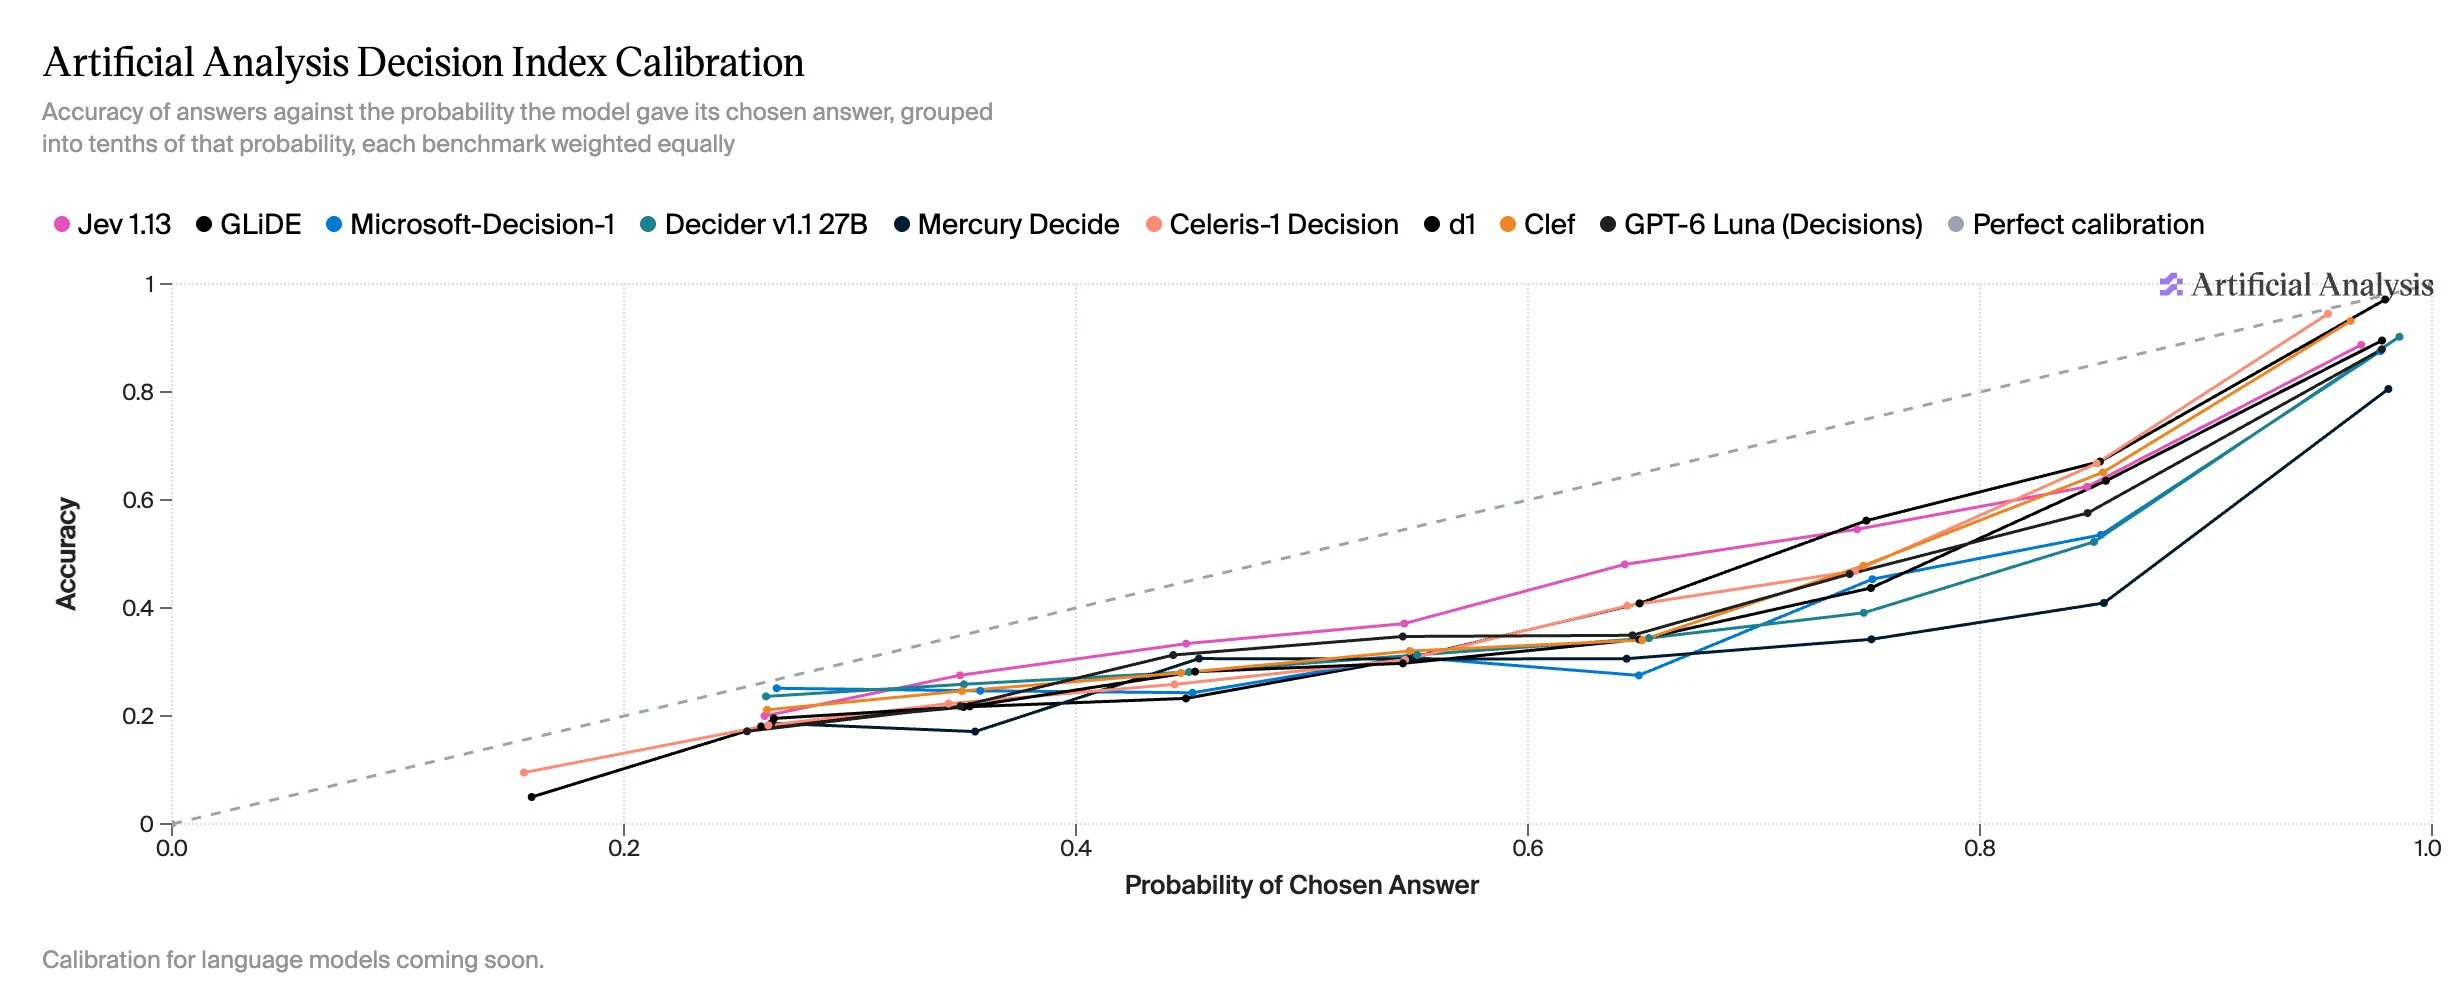
Entscheidungsmodelle sind bei Wissens- und Denkaufgaben schlecht kalibriert. Bei fast allen Wahrscheinlichkeitsniveaus für gewählte Antworten liegt die Genauigkeit unter dieser Wahrscheinlichkeit bei allen Entscheidungsmodellen. Diese Lücke ist bei AA-Omniscience-Decision und HLE-MultiChoice am größten, während die meisten Modelle bei WildGuardTest (Klassifizierung) und When2Call (Tool Calling) relativ gut kalibriert sind