
Die wichtigsten Erkenntnisse
- "Context rot" tritt auf, wenn langlebige Agents mehr Kontext ansammeln, als das Modell speichern kann, was zu Genauigkeitsverlusten führt.
- Deep Agents, LangChains Open-Source-Agent-Harness, verwendet fünf Techniken, um Kontext aus dem aktiven Fenster herauszubewegen (ohne ihn zu löschen), um Context Rot zu verhindern.
- Der Speicher eines Agents in Deep Agents wird als einfache Dateien in einem Speicher Ihrer Wahl abgelegt, sodass Sie Modelle oder Anbieter wechseln können, während alles Erlernte erhalten bleibt.
Wer schon einmal in der Nacht vor einer Prüfung gebüffelt hat, kennt das Gefühl: Je mehr man lernt, desto mehr geraten die frühen Kapitel in Vergessenheit.
Agents haben dasselbe Problem. Wenn sie längere Aufgaben übernehmen, nehmen sie immer mehr Informationen auf (Anweisungen, Tool-Ergebnisse, Dateien usw.); schließlich wird daraus weit zu viel Kontext um bequem in das Kontextfenstereines Modells zu passen. Je mehr Historie, Rauschen und Tool-Ausgaben ein Modell mit sich trägt, desto schlechter werden tendenziell seine Genauigkeit und sein Denkvermögen.
In der Welt des Agent-Engineerings nennen wir das Context Rot. Dieser Blog behandelt Techniken zur Verwaltung des Kontextfensters Ihres Agents und wie der Deep-Agents-Harness ein Konzept namens Middleware verwendet, um sie in den Lauf Ihres Agents einzuspeisen.
Verstehen von Context-Engineering-Techniken
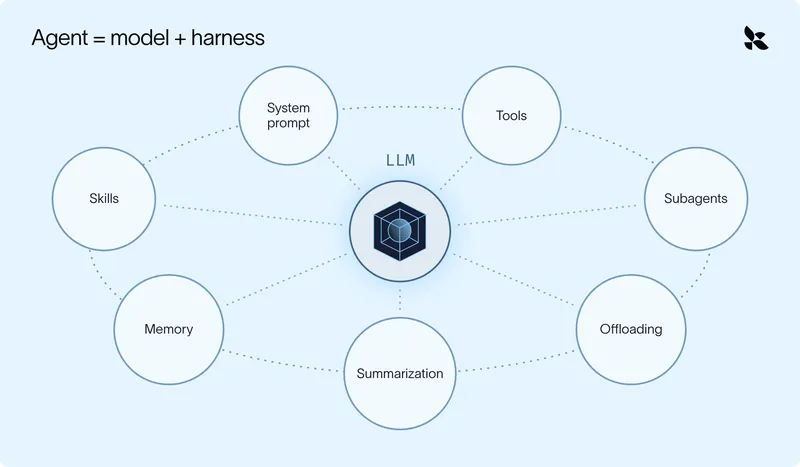
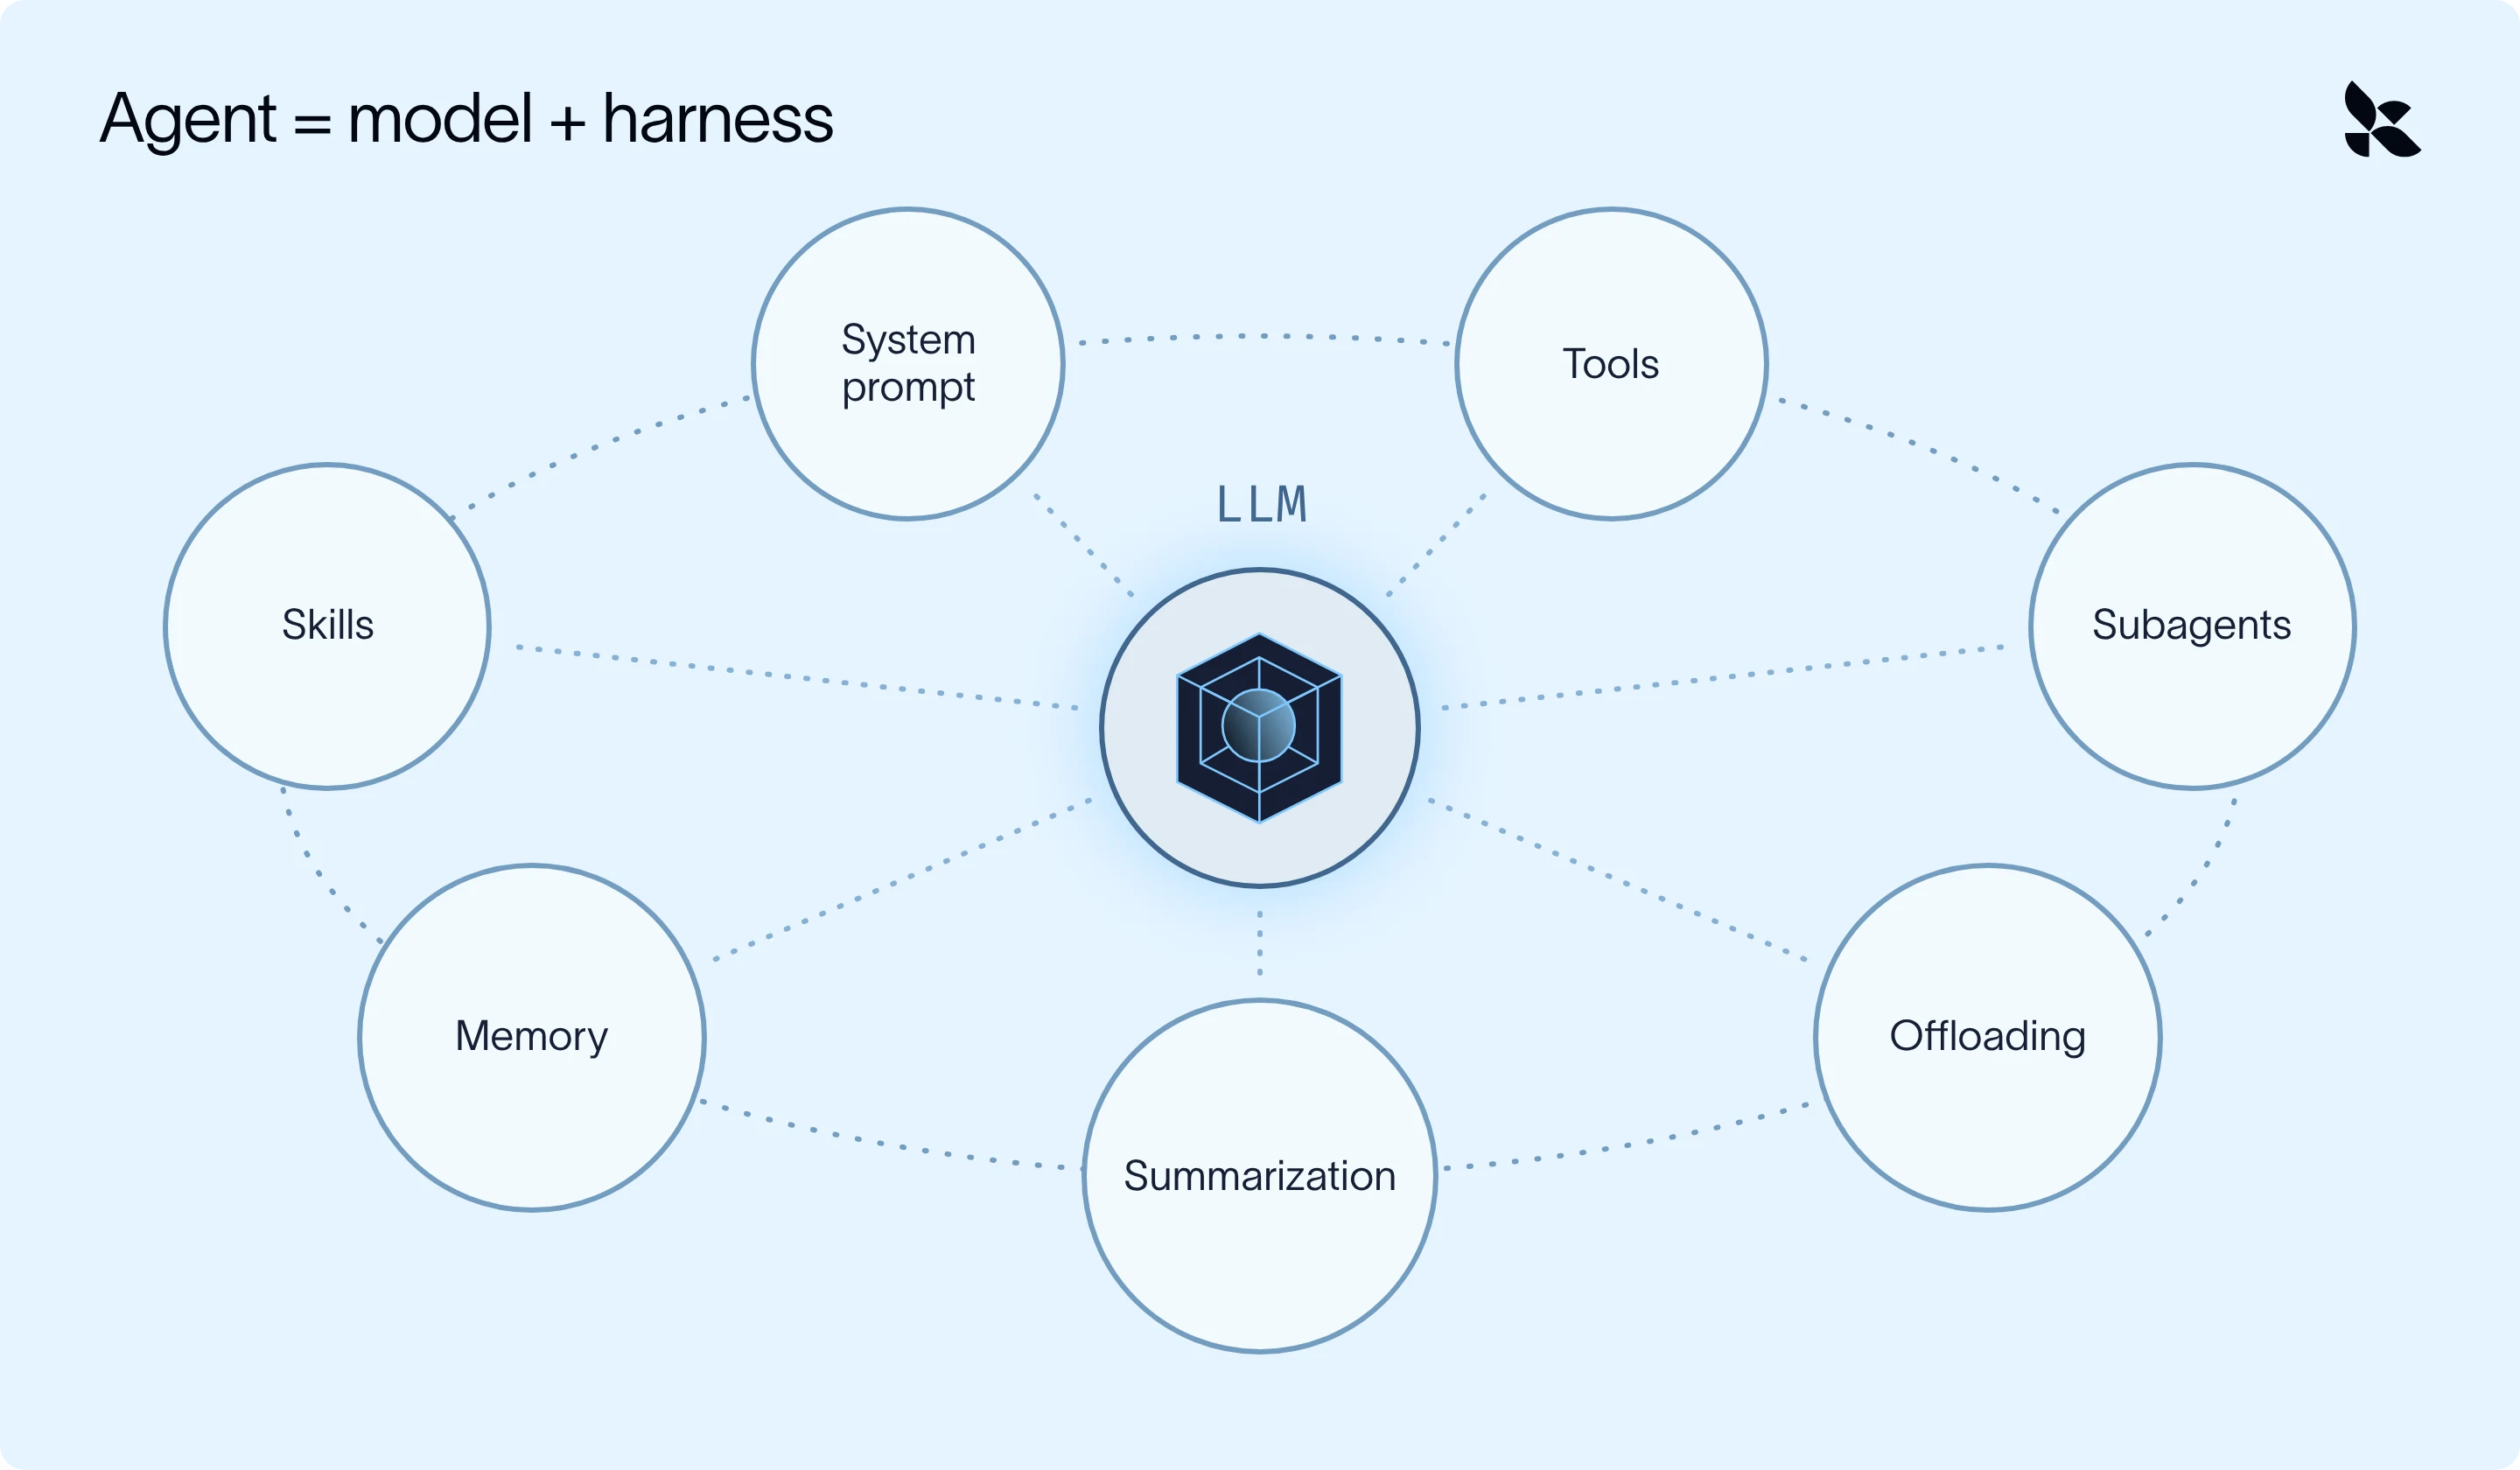
Zur Vereinfachung: Ein Agent ist nichts anderes als ein Modell mit einem Harness drumherum.
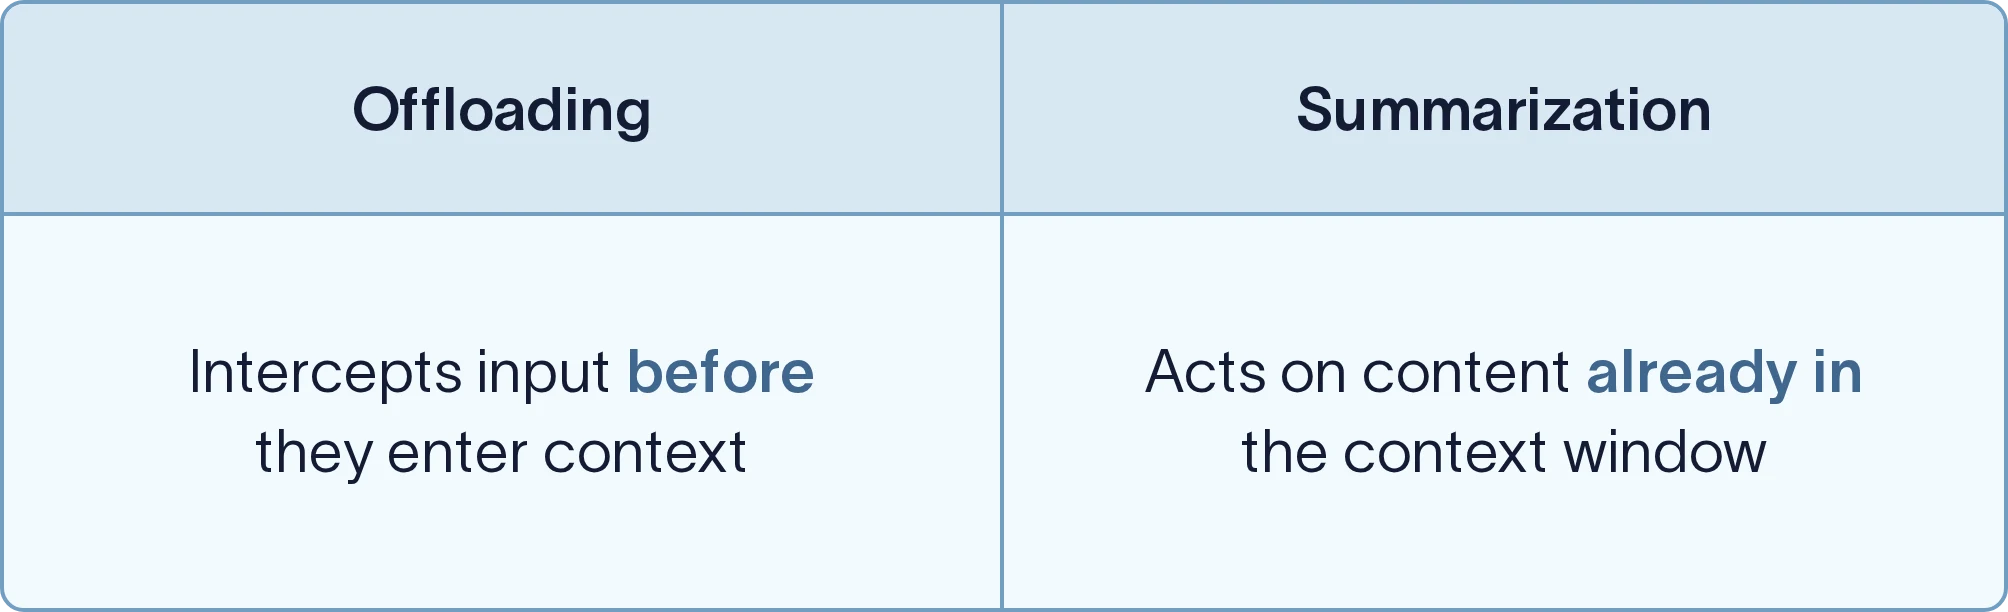
Die Context-Engineering-Techniken, die dem Agent zur Verfügung stehen, um Context Rot zu begegnen, fallen hauptsächlich in zwei Kategorien:
- Verhindern, dass unnötige Informationen in das Kontextfenster eintreten Verwalten und Filtern dessen, was sich
- bereits im Kontextfenster befindet Der Harness wendet diese Methoden strategisch an, um dem Modell
den richtigen Kontext zur richtigen Zeit für die jeweilige Aufgabe zu liefern. Nun zum Aufbau eines Harness, der dies
gut macht ist leichter gesagt als getan und erfordert viel Arbeit (vielleicht zu viel Arbeit, wenn man vom Typ her die Prüfung in der Nacht vorher lernt).
Deep Agents ist LangChains Open-Source-Harness. Es umgibt das Modell Ihrer Wahl mit Techniken, die Kontext heraus aus dem aktiven Fenster bewegen (in Dateien, Zusammenfassungen oder einen separaten Agenten), sodass der Hauptagent nur das mitführt, was er braucht (und die Rohdaten bei Bedarf später wieder abrufen kann):
- Offloading: große Tool-Ergebnisse und Nutzernachrichten werden im Dateisystem gespeichert, und das Modell sieht eine Vorschau.
- Summarization: wenn sich die Konversation dem Kontextlimit nähert, werden ältere Nachrichten zu einer Zusammenfassung verdichtet.
- Skills: Aufgabenwissen wird nur geladen, wenn das Modell entscheidet, dass es relevant ist.
- Subagents: lautstärmige Arbeit läuft in einem separaten Kontextfenster, und nur das Ergebnis kommt zurück.
- Long-term memory: was der Agent lernt, wird in einer Datei gespeichert, die in die nächste Konversation übernommen wird.
Anwendung von Context Engineering auf gängige Anwendungsfälle
Sehen wir uns an, wie sich die obigen Techniken in einem realen Anwendungsfall umsetzen lassen: einem Competitive-Analysis-Agenten. Jeden Montag recherchiert dieser Agent fünf Wettbewerber und schreibt einen Bericht in der Vorlage des Teams. Ein einzelner Durchlauf sieht etwa so aus:
- Einen Marktdatenexport für Firma A abrufen (Zehntausende von Zeilen)
- Die Nachrichten durchsuchen, ein paar Artikel lesen und Notizen machen
- Das Gleiche für die Firmen B bis E wiederholen
- Den Bericht entwerfen, auf Basis Ihres Feedbacks überarbeiten und formatieren
Bis zu Schritt 4 hat der Agent fünf Rohexporte, Dutzende Suchergebnisse und zwei veraltete Entwürfe durch jeden Modellaufruf geschleppt. Das meiste davon ist für die Formatierung des abschließenden Berichts irrelevant.
Retrieval-Methoden (RAGoder Dateisystemsuche) helfen dem Agenten, nur das abzurufen, was er braucht, aber das löst immer nur die halbe Aufgabe. Selbst ein präziser Agent sammelt unnötige Nachrichten, Tool-Ergebnisse und Zwischenarbeiten an, daher muss der Harness auch verwalten, was sich bereits in und um das Kontextfenster befindet.
Wie man diese Techniken implementiert: Middleware
Ein Agent läuft in einer Schleife: Das Modell entscheidet, was zu tun ist, ruft ein Tool auf, liest das Ergebnis und wiederholt den Vorgang, bis die Aufgabe erledigt ist. Middleware ist Code, der an bestimmten Punkten dieser Schleife andockt: etwa bevor der Agent startet, um jeden Modellaufruf herum oder um jeden Toolaufruf herum.
- An jedem Punkt kann er den Kontext lesen und ihn verändern, bevor der nächste Schritt ausgeführt wird.
- Jede Context-Engineering-Technik in diesem Beitrag ist ein Stück Middleware, das an einen dieser Punkte eingehängt ist.
- Das meiste davon ist eingebaut, sodass Sie keine Middleware schreiben müssen, um diese Techniken zu nutzen (es sei denn, Sie möchten etwas Bestimmtes anpassen).
Offloading: Es aus dem Kontextfenster heraushalten
Unser Agent muss nicht immer alle Daten sehen, die von jedem Toolaufruf oder jeder menschlichen Nachricht zurückgegeben werden, besonders wenn es sich um ein großes Datenvolumen handelt.
Zum Beispiel gibt jeder pull_market_report-Toolaufruf einen vollständigen Datenexport zurück (tausende Zeilen); der Agent benötigt jedoch nur ein paar Zahlen daraus, daher kann das Modell darauf beschränkt werden, nur diese Zeilen zu sehen.
FilesystemMiddleware läuft bei jedem Toolaufruf:
- Wenn ein Tool-Ergebnis ungefähr 20,000 Token überschreitet, wird das vollständige Ergebnis in /large_tool_results/{tool_call_id} geschrieben, bevor es in die Konversation gelangt.
- Das Modell sieht nur eine kurze Vorschau (die ersten und letzten Zeilen) plus den Dateipfad.
- Wenn der Agent später den Quartalsumsatz von Unternehmen B benötigt, blättert er mit read_file durch die Datei.
Überdimensionale Nutzer-/Menschennachrichten, wie ein eingefügtes Anruftranskript, erhalten dieselbe Behandlung bei einem höheren Schwellenwert (50,000 Token) und werden in /conversation_history/ gespeichert.
Summarization: Verdichten dessen, was bereits vorhanden ist
So sehr wir uns auch bemühen, ausführliche Toolaufrufe auszulagern, wird der Kontext bei einem langen Lauf allmählich anwachsen (z. B. Suchen, Notizen und Entwürfe im Umfang von fünf Unternehmen). Summarization kann verwendet werden, um das gesamte Kontextfenster unseres Agents zu einer Zusammenfassung des bisher Geschehenen zu verdichten, damit er mit seinen Recherchenaufgaben fortfahren kann.
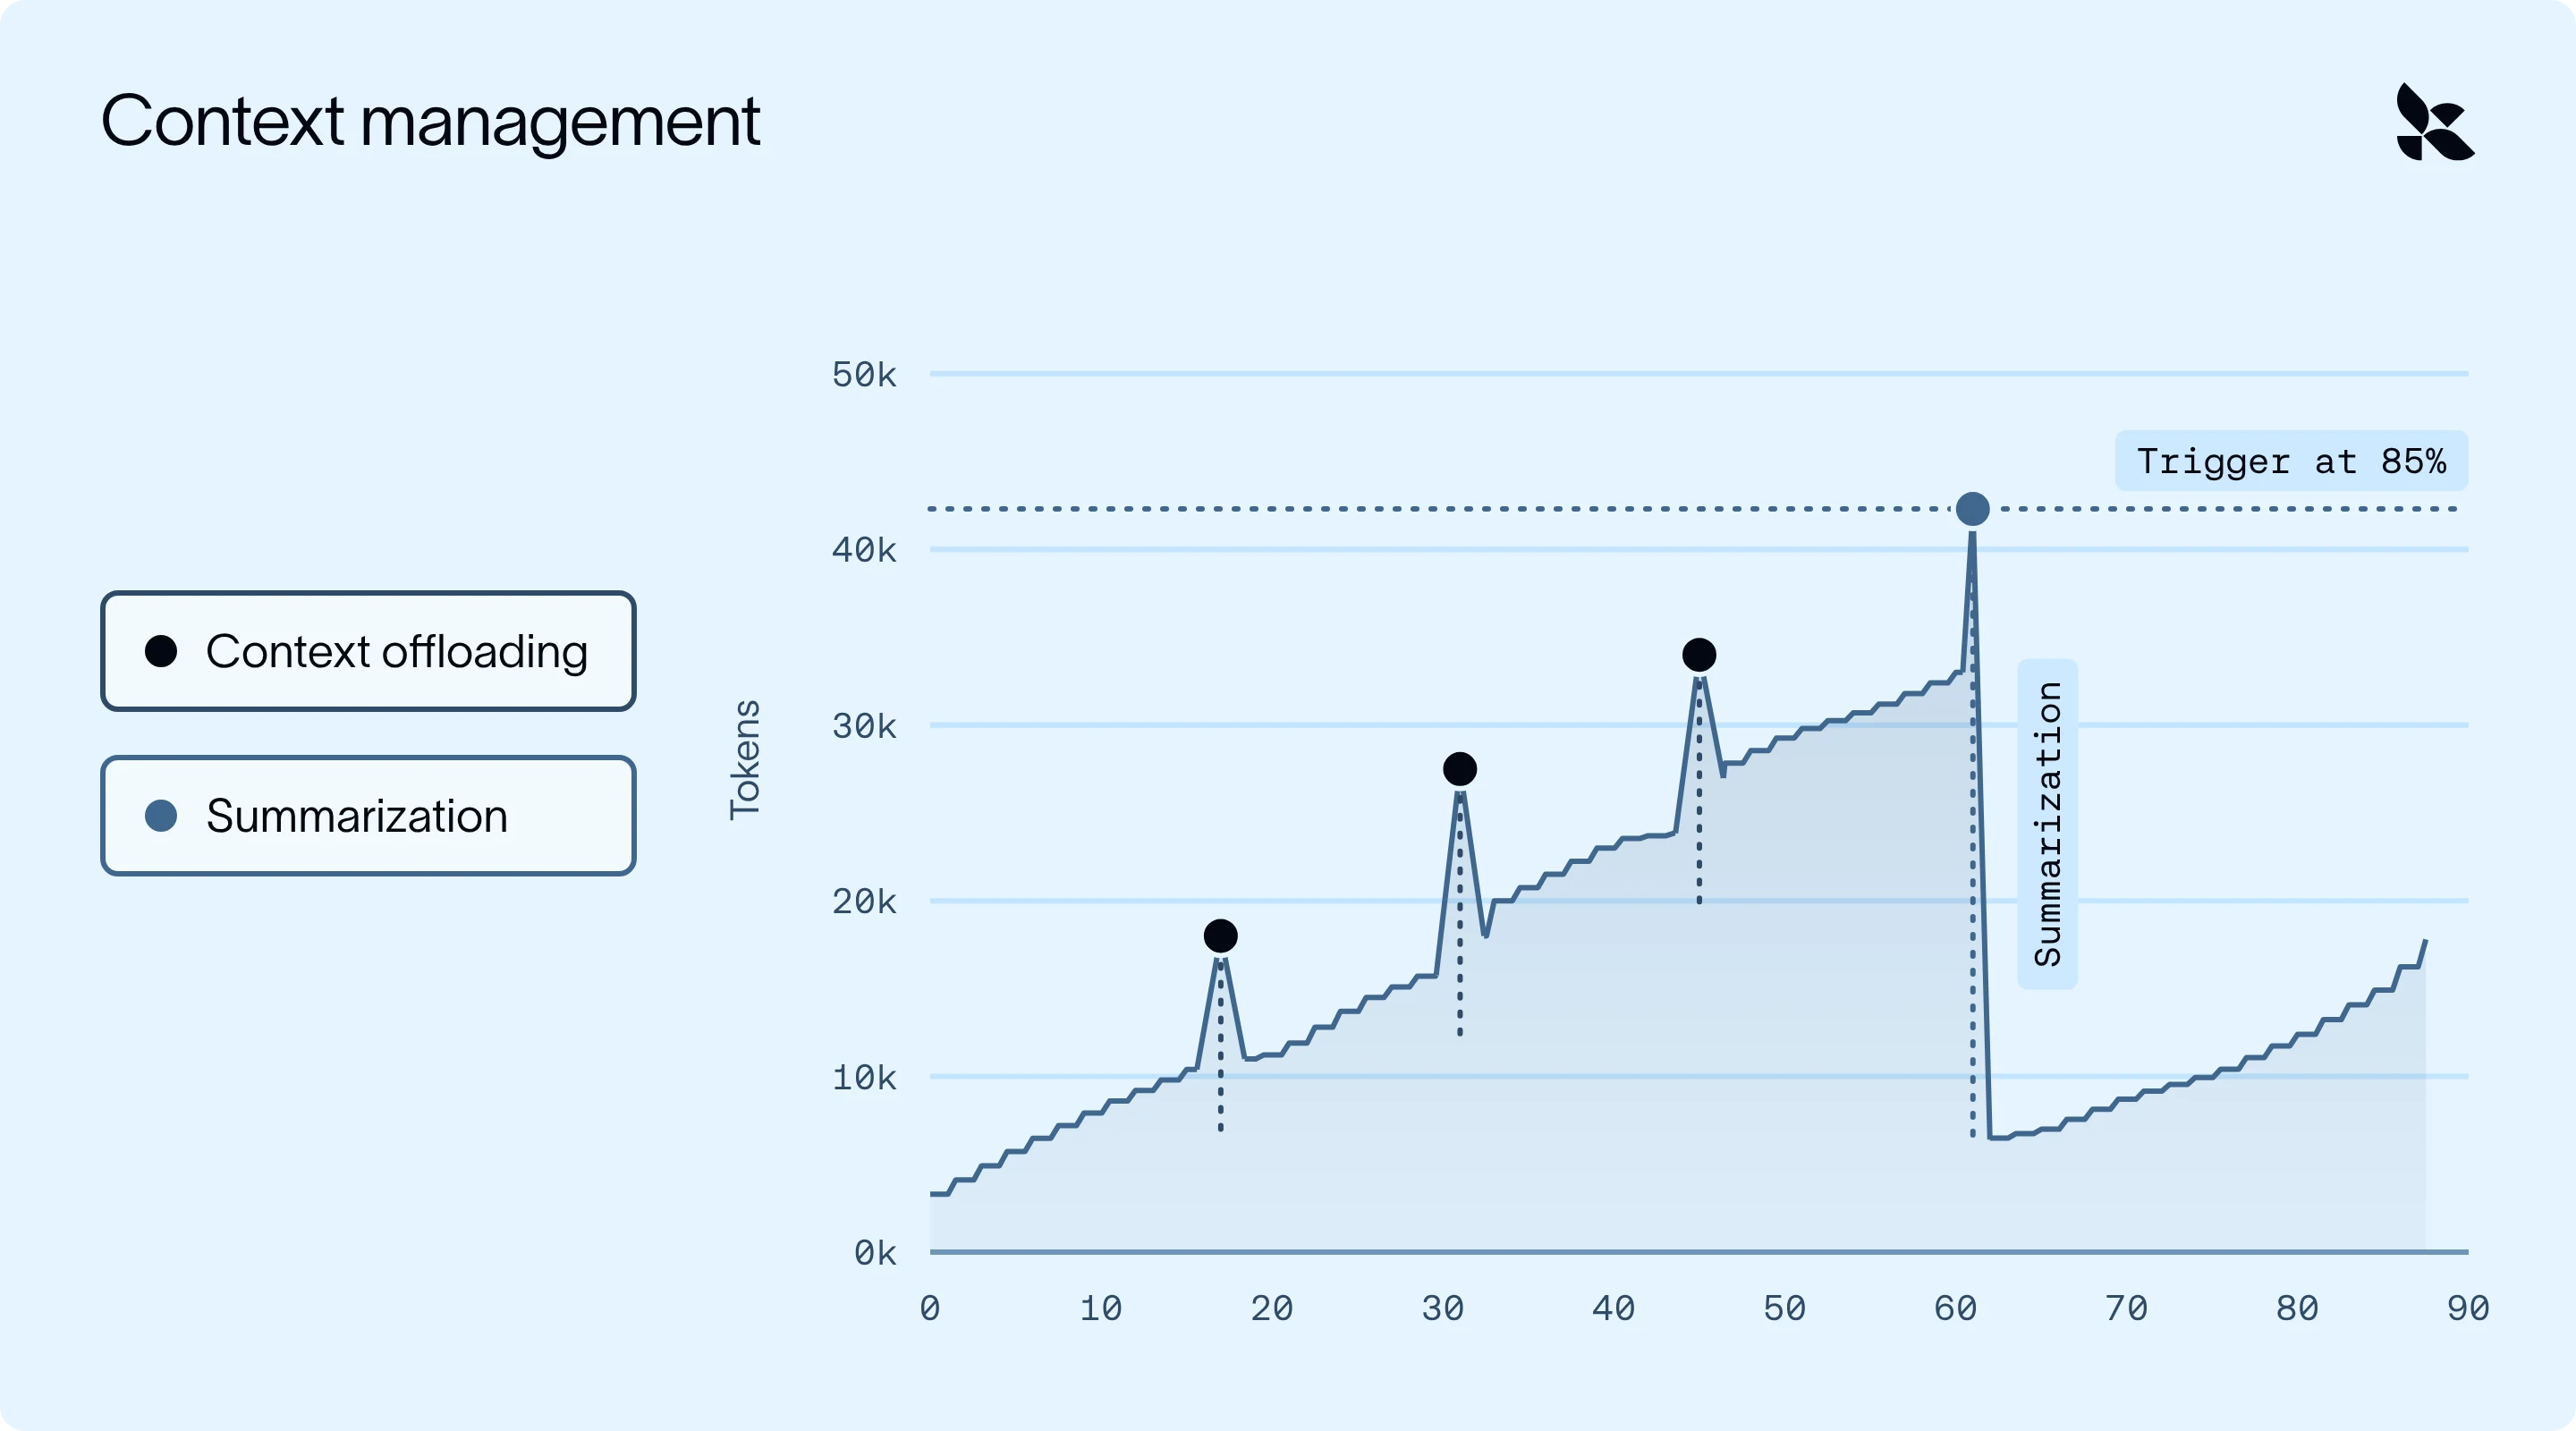
- Die Spitzen sind große Tool-Ergebnisse/Menschennachrichten, die eintreffen; Offloading tauscht jede einzelne gegen eine kurze Vorschau aus, bevor das Modell sie sieht, sodass der Kontext nur wenig wächst.
- Summarization behandelt den langsamen Anstieg: Sobald die Auslastung 85% erreicht, werden ältere Nachrichten zu einer Zusammenfassung verdichtet und der Kontext sinkt wieder.
SummarizationMiddleware prüft die Token-Auslastung direkt vor jedem Modellaufruf:
- Sobald die Auslastung einen Schwellenwert überschreitet (standardmäßig 85% des Kontextfensters des Modells), verdichtet ein separater LLM-Aufruf ältere Nachrichten zu einer einzigen Zusammenfassung
- Ältere Nachrichten werden aus dem Kontextfenster entfernt, während die neuesten Nachrichten wortwörtlich beibehalten werden.
- Das Modell sieht nun zuerst die Zusammenfassung und dann die aktuellen Nachrichten (damit nichts Aktuelles paraphrasiert wird).
Zwei wichtige Details:
- Es ist wiederherstellbar. Die zusammengefassten Nachrichten werden in /conversation_history/{session_id}.md geschrieben. Wenn der Agent beim Verfassen eines Entwurfs ein Detail aus der Recherche zu Unternehmen A benötigt, kann er es nachlesen.
- Es zyklisiert. Während der Lauf fortgesetzt wird, steigt die Auslastung erneut, und die nächste Zusammenfassung enthält die vorherige.
Sie können auch zusammenfassen, wenn das Thema wechselt, nicht nur bei einem bestimmten Token-Schwellenwert. Es kann hilfreich sein, den Summarization-Prompt anzupassen.
Unser Beitrag über Kontextmanagement für Deep Agents geht auf beides ausführlicher ein.
Skills: Informationen nur laden, wenn sie benötigt werden
Angenommen, Ihr Vertriebsteam hat ein bestimmtes Format für Quarterly Business Reviews. Der Agent benötigt diese Anweisungen nur einmal pro Quartal. Wenn man sie im System-Prompt belässt, zahlt man sie (in Tokens und Antwortzeit) bei jedem Aufruf mit. Stattdessen können Sie diese Informationen als Skill verpacken.
Ein Skill ist ein Ordner mit Anweisungen (mit optionalen Skripten und Referenzdokumenten), die einem Agenten alles für eine spezialisierte Aufgabe Notwendige bereitstellen.
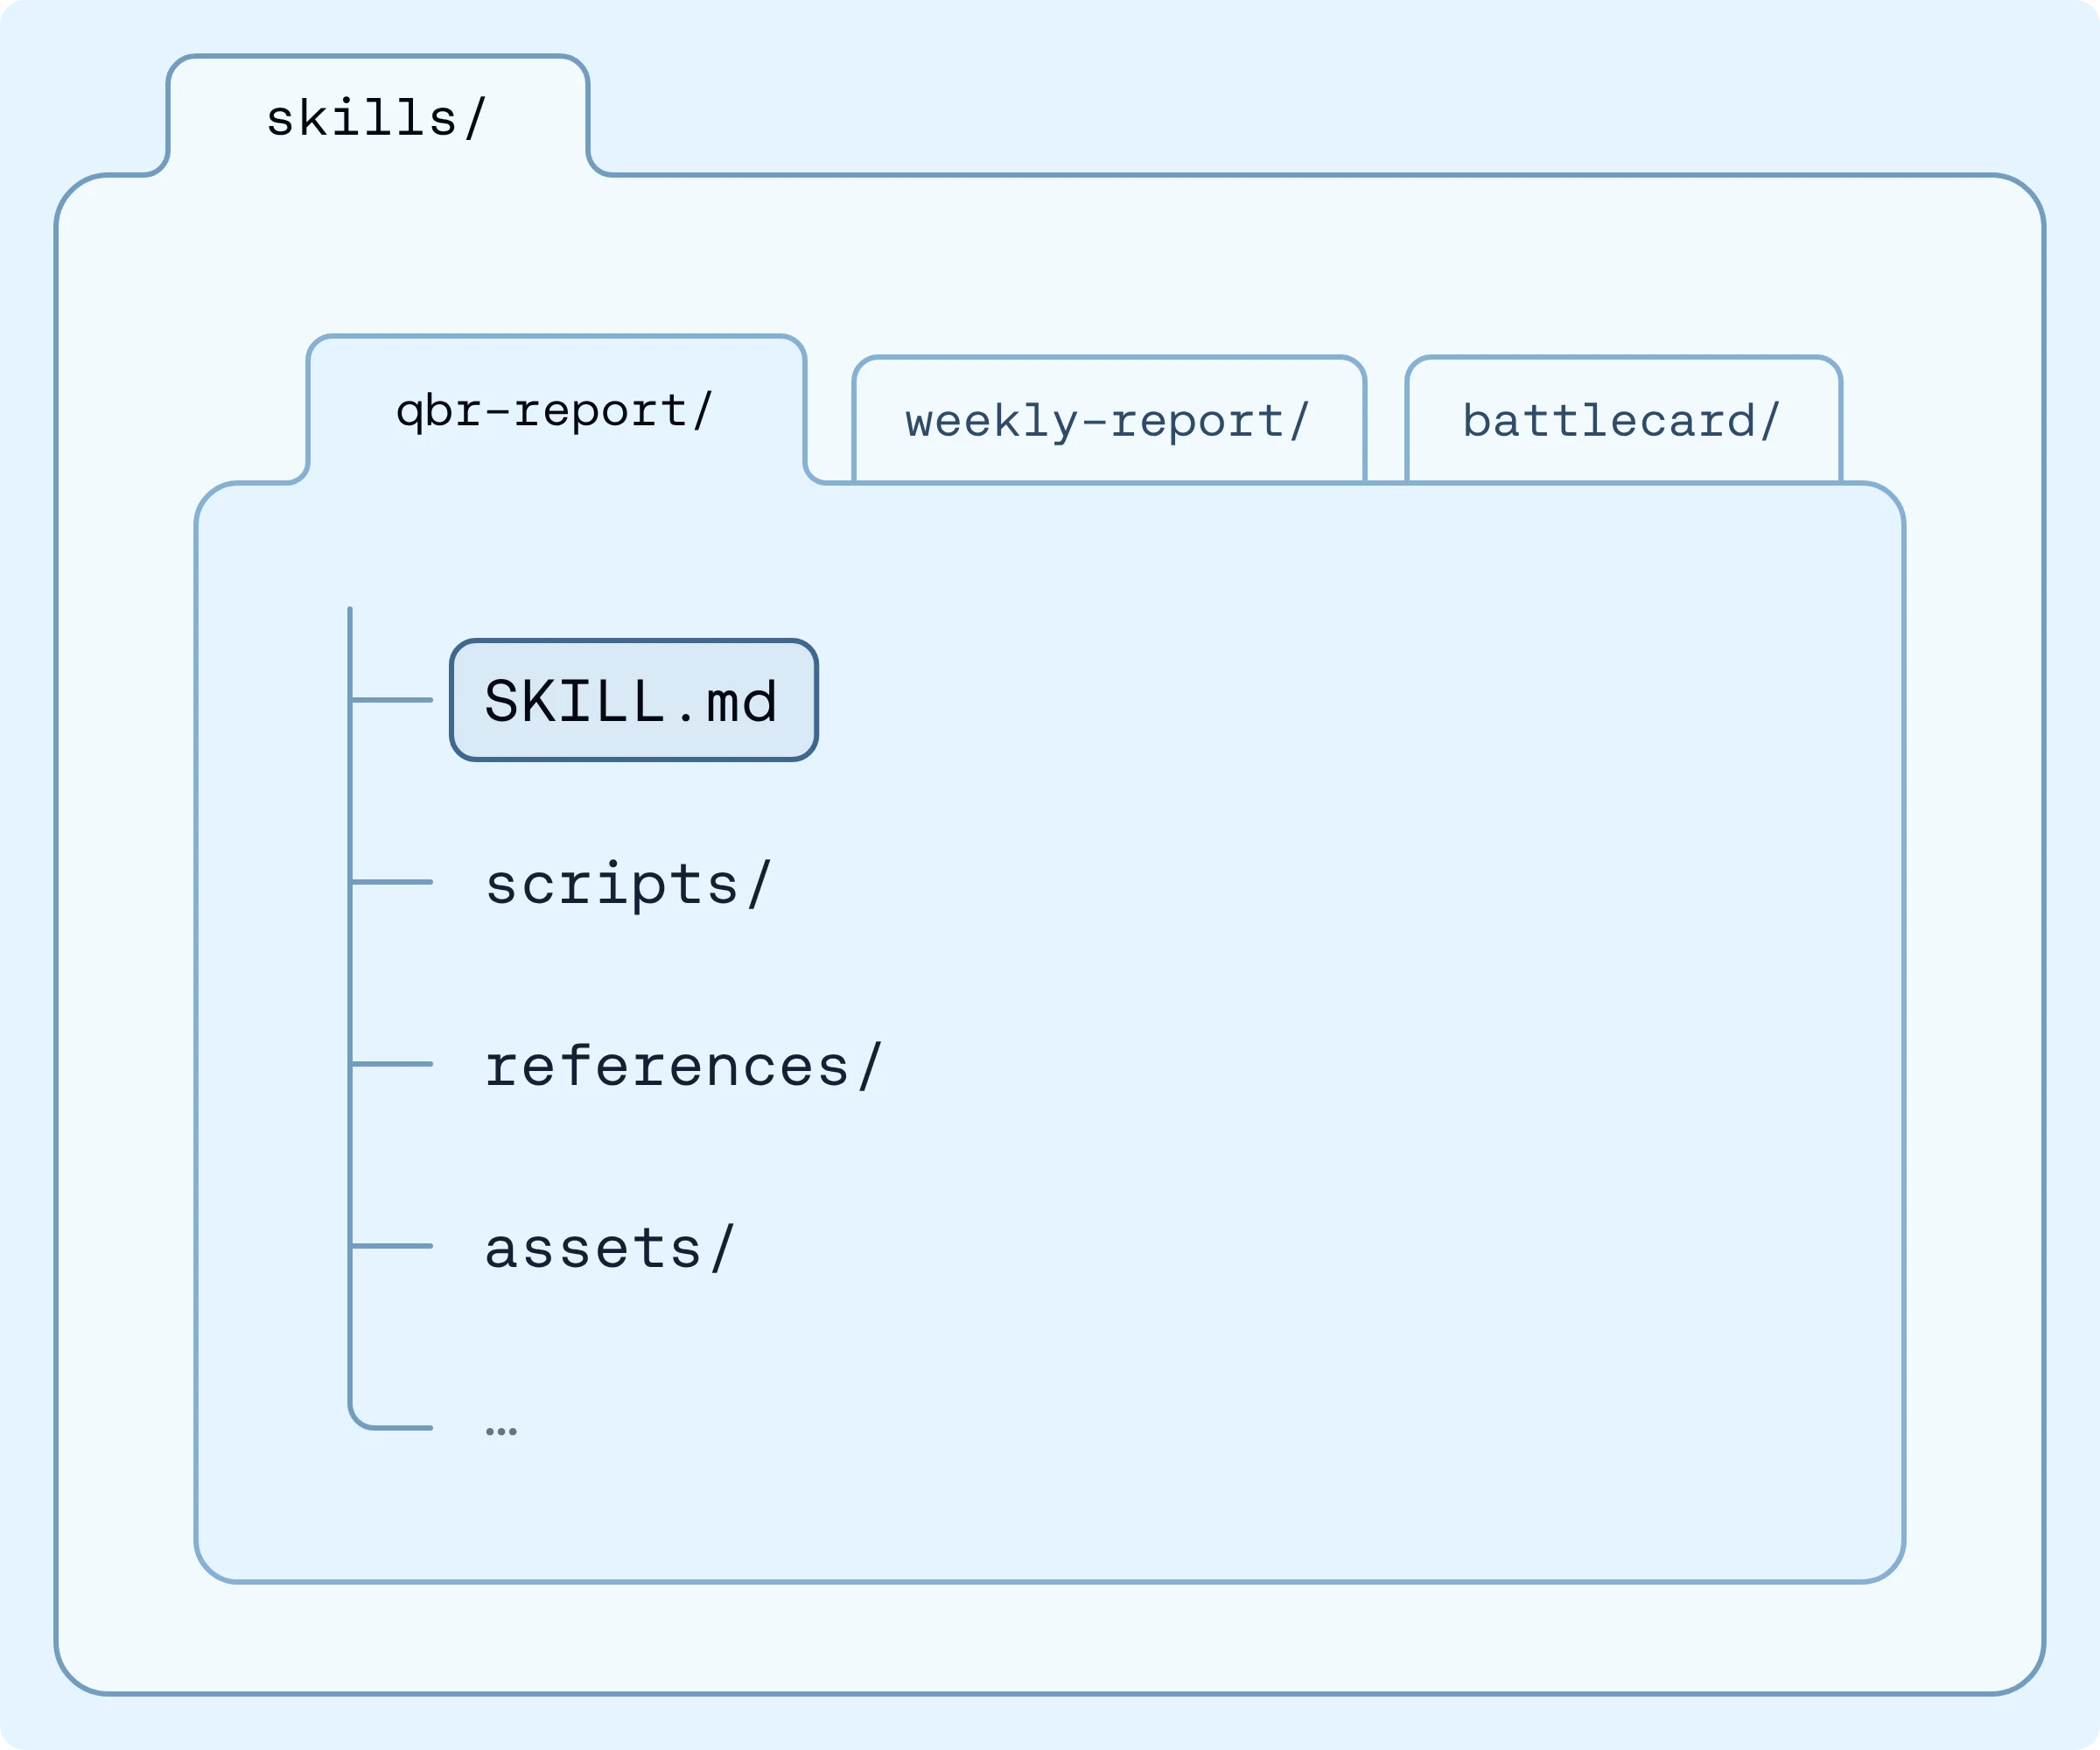
Der Agent sieht vorab eine kurze Beschreibung und lädt die vollständigen Anweisungen für qbr-report erst, wenn ein QBR ansteht (bei anderen Aufgaben werden sie nie mitgeladen).
Skills laden Kontext in Schichten, sodass das Fenster klein bleibt, bis etwas tatsächlich relevant ist. Das nennt man progressive disclosure (fortschreitende Offenlegung): Das Modell sieht vorab ein „Menü“ und zieht das vollständige Rezept heran, wenn es es braucht, sodass zehn Skills etwa so viel Kontext kosten wie zehn Einzeiler.
Sie verweisen den Agenten auf Ihre Skills, und SkillsMiddleware verwendet zwei Hooks:
- Bevor der Agent startet, durchsucht er den Skills-Ordner und liest nur den Kopfbereich jeder SKILL.md.
- Bei jedem Modellaufruf fügt er diese Namen und Beschreibungen zum Systemprompt hinzu.
Die vollständigen Anweisungen gelangen nur dann in den Kontext, wenn das Modell entscheidet, dass ein Skill relevant ist (und liest ihn mit einem read_file-Werkzeug), sodass unser Agent ohne die Vorlage recherchiert und sie erst lädt, wenn es Zeit ist, einen QBR zu formatieren.
Subagents: die lautstarke Arbeit isolieren
Offloading bekämpft effektiv übergroße Ergebnisse, aber Subagents sind eine gute Designwahl für Arbeit, die bereits bekannt lautstark sein wird (etwa die Recherche zu einem Unternehmen über Dutzende Suchanfragen und Seiten hinweg). Der Subagent erledigt diese Arbeit in seinem eigenen Kontextfenster und liefert nur das Endergebnis zurück, sodass der Hauptagent die „Störgeräusche“ nie sieht.
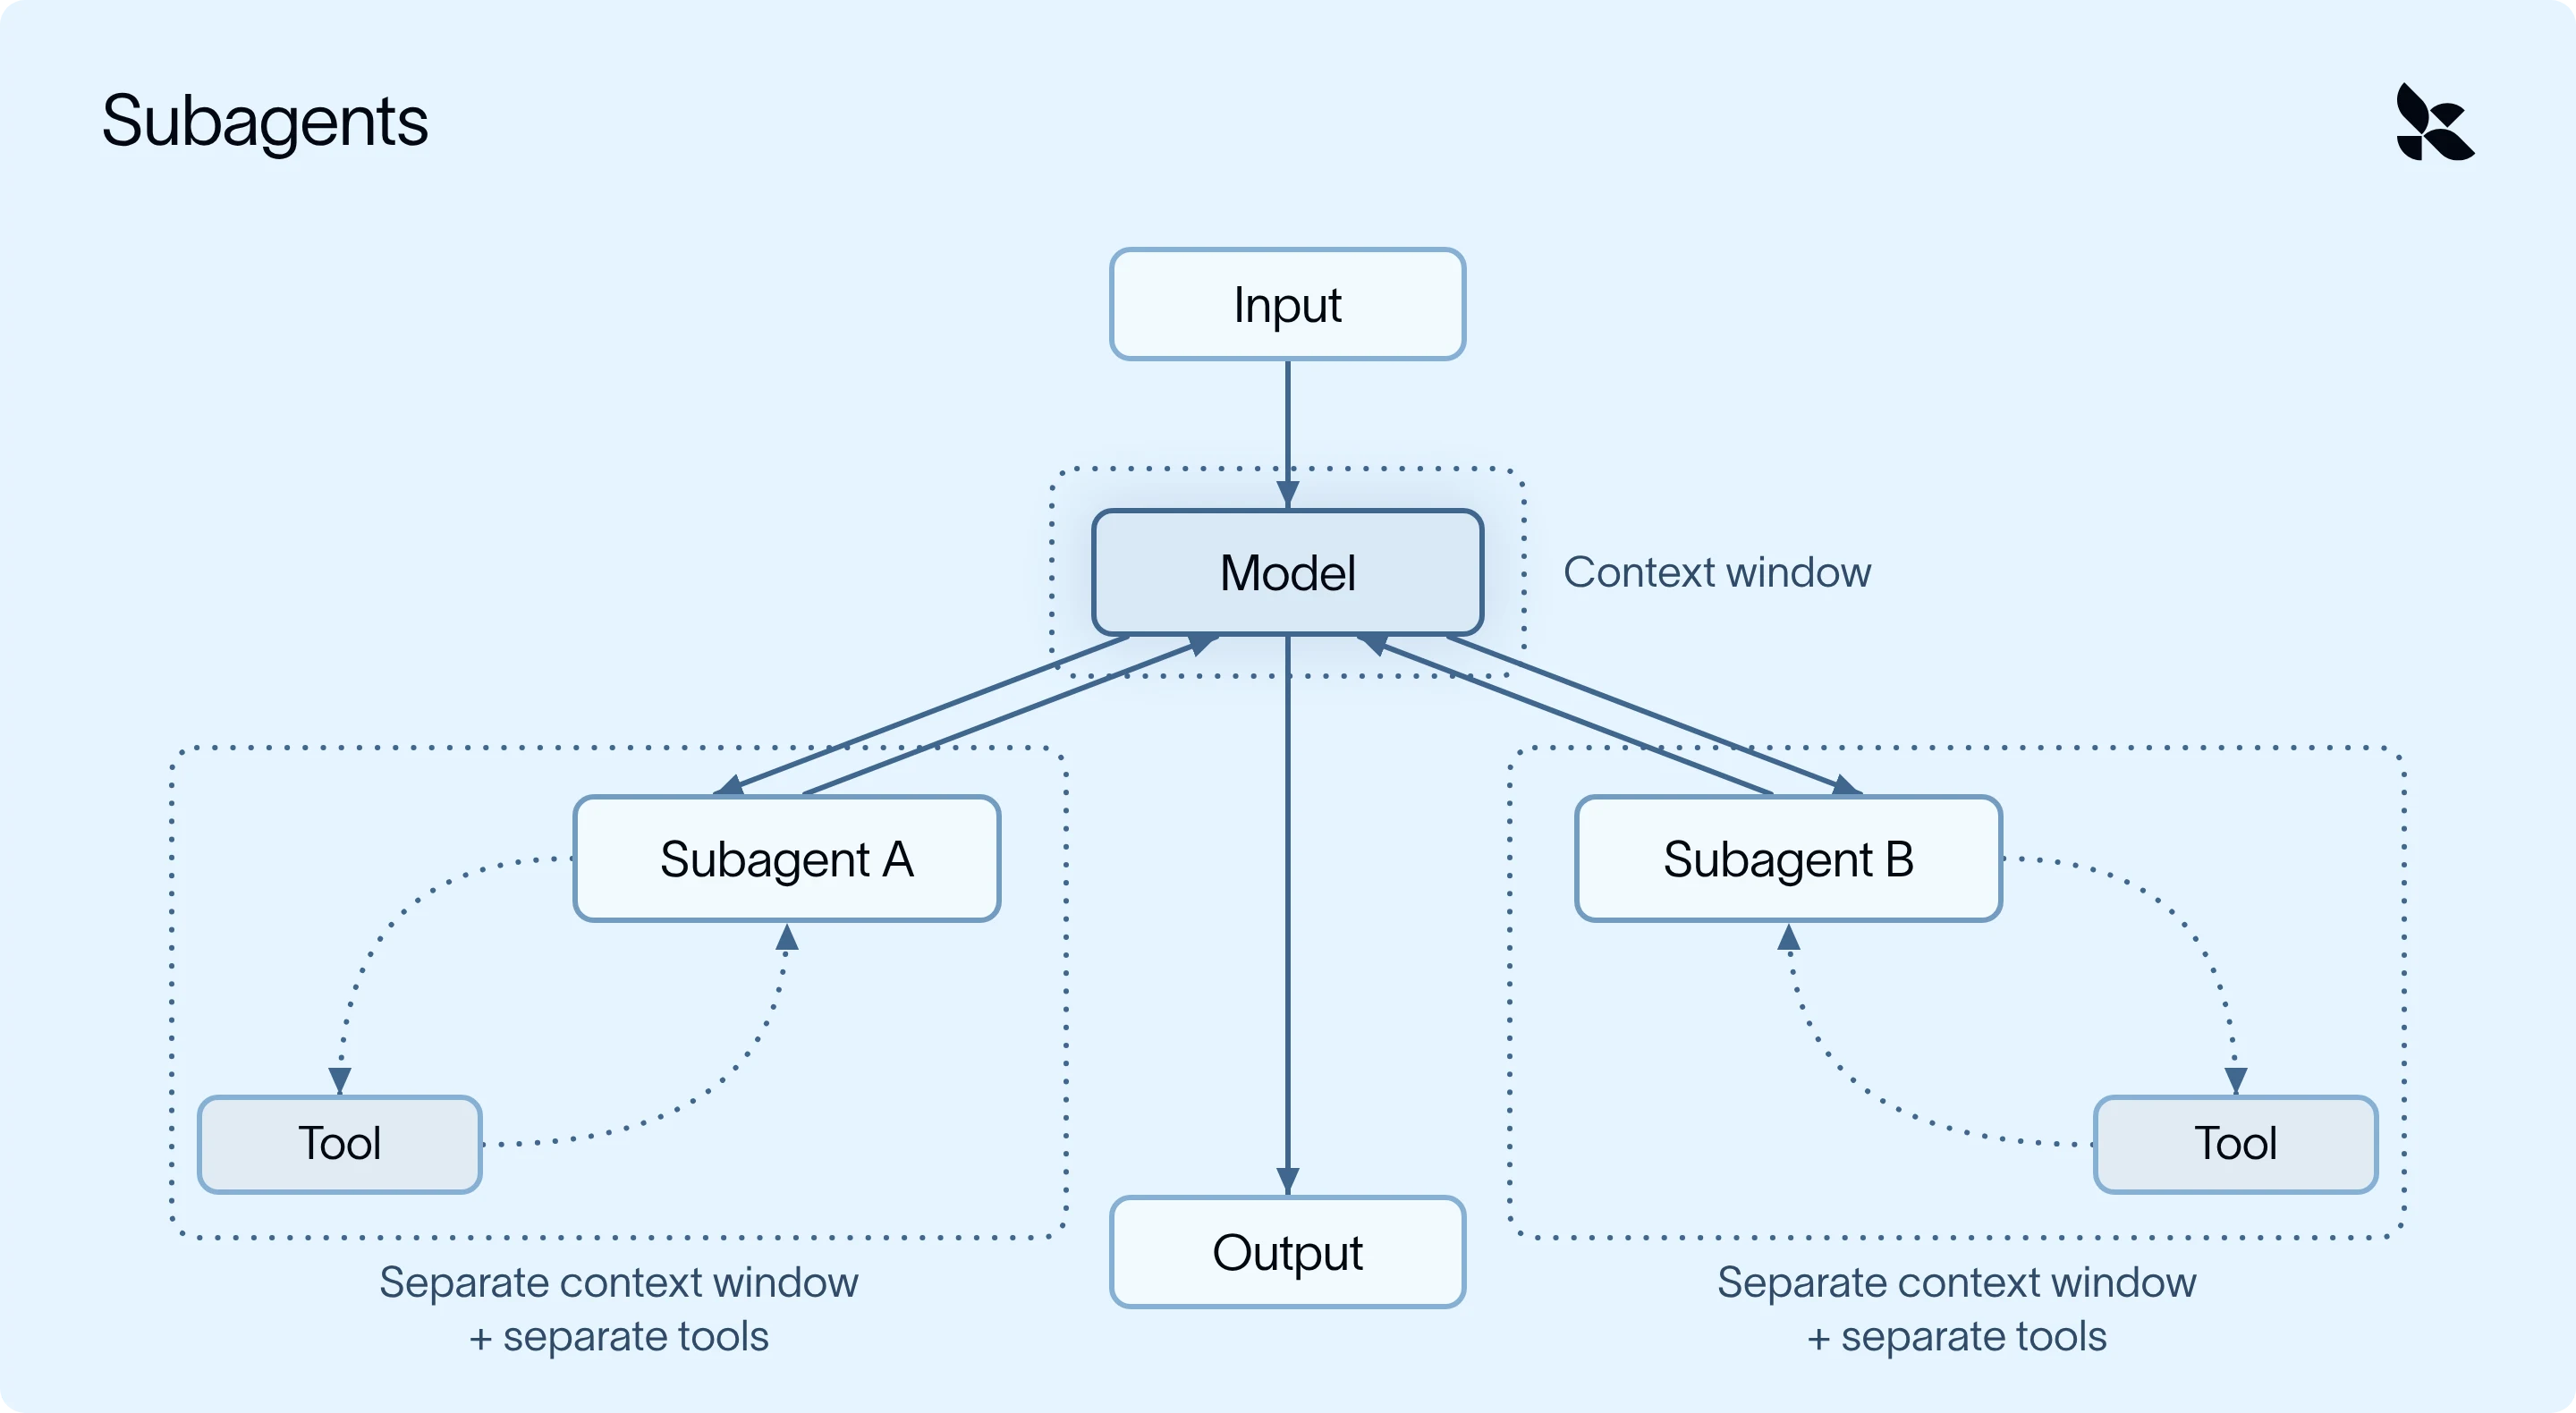
SubAgentMiddleware erlaubt uns, den Systemprompt und die verfügbaren Werkzeuge für unsere Subagents anzupassen.
market_researcher = {
    "name": "market-researcher",
    "description": "Researches a company and returns the 3 most notable developments.",
    "system_prompt": "Use pull_market_report, then return 3 short bullet points. Do not return the raw report.",
    "tools": [pull_market_report],
}

agent = create_deep_agent(model=model, subagents=[market_researcher])
In unserem Fall übergibt der Hauptagent jedes Unternehmen an den Subagenten market-researcher.
Der Recherche-Subagent liest den vollständigen Bericht in seinem eigenen Kontext und liefert nur drei Aufzählungspunkte zurück, sodass der Hauptagent nur diese drei Aufzählungspunkte sieht (nicht einmal eine Vorschau des Rohberichts). Da Subagent-Aufgaben zudem tendenziell klein und klar abgegrenzt sind, können sie oft auf einem günstigeren Modell und parallel ausgeführt werden.
Langzeitgedächtnis: über Gespräche hinweg bestehen
Am Ende wird Ihr Agent viel gelernt haben. Manches davon nützlich, manches nicht.
Angenommen, Sie sagen Ihrem Agenten: „Verwende in der Zusammenfassung Aufzählungspunkte, keine Absätze.“ Ohne Gedächtnis müssten Sie das jede Woche wiederholen. In Deep Agents ist das Langzeitgedächtnis eine Markdown-Datei. Sie verweisen den Agenten mit einem Argument darauf, und MemoryMiddleware kümmert sich um den Rest:
- Load (Laden): die Datei wird zu Beginn eines Laufs gelesen.
- Inject (Einfügen): ihr Inhalt wird bei jedem Modellaufruf zum Systemprompt hinzugefügt.
- Update (Aktualisieren): wenn der Agent etwas behaltenswertes lernt, etwa Ihre Formatierungsvorgabe, aktualisiert er die Datei.
Modell tauschen, Gedächtnis behalten
Deep Agents ist providerunabhängig, und das gilt auch für das Gedächtnis. Da das Gedächtnis eine einfache Datei in Ihrem eigenen Speicher ist (nicht etwas, das ein Anbieter verwahrt), können Sie dasselbe Backend auf ein anderes Modell richten:
agent = create_deep_agent(
    model="openai:gpt-6",  # different provider, same memory
    memory=["/memories/AGENTS.md"],
    backend=backend,
    store=store,
)
Nächste Woche könnte ein anderes Modell dieselbe Datei lesen und die Zusammenfassung trotzdem in Aufzählungspunkten schreiben.
Context-Engineering-Strategien, die man im Kopf behalten sollte
Ob Sie auf Deep Agents aufbauen, ein anderes Harness verwenden oder selbst eines bauen – hier sind einige Dinge, auf die Sie achten sollten:
- Große Eingaben sollten ausgelagert, nicht abgeschnitten werden. Abschneiden ist verlustbehaftet; Offloading hält sie abrufbar.
- Komprimierung sollte wiederherstellbar sein. Nach der Zusammenfassung kann der Agent die benötigten Details weiterhin zurückerhalten.
- Know-how sollte bei Bedarf geladen werden. Anweisungen für jede Aufgabe im System-Prompt kosten bei jedem Aufruf Kontext.
- Störende Arbeiten sollten isoliert werden. Subagents mit eigenem Kontext halten den Haupt-Agenten fokussiert.
- Sie sollten das Gedächtnis besitzen. Gedächtnis in einem von Ihnen kontrollierten Speicher überlebt einen Modell- oder Anbieterwechsel.
- Standardeinstellungen sollten anpassbar sein. Schwellenwerte, die zu einer Aufgabe passen, passen selten zu jeder Aufgabe.
Ausprobieren
uv add deepagentsMöchten Sie mehr von einem Live-Instruktor lernen? Ich werde dies am 3. November behandeln: Registrieren HIER!
Um tiefer in Context Engineering einzusteigen, schauen Sie sich unseren kostenlosen, selbstgesteuerten Deep Agents-Kurs auf LangChain Academy an.