
TL;DR
Confidence Scoring wird jetzt für alle Speculator-Typen unterstützt, die auf Draft-Modellen basieren. Fehlt ein Confidence Head, leitet ein online angepasster Schätzer ein Merkmal aus den Logits des Drafters ab, um die Akzeptanzwahrscheinlichkeit des Zielmodells vorherzusagen, die direkt als Confidence Score für Adaptive Verification verwendet wird. Die Koeffizienten des Schätzers werden kontinuierlich angepasst und passen sich dem eingehenden Datenverkehr an. Diese Funktion wurde in PR #52228zusammengeführt und wird aktiviert mit enable_adaptive_verification für Draft-Modelle ohne Confidence Head.
Hintergrund
vLLMs Adaptive Verification (AV) ermöglicht die Verifikation einer Teilmenge der entworfenen Token während des speculative decoding. Draft-Token mit geringer Akzeptanzwahrscheinlichkeit werden vor dem Forward-Pass des Zielmodells aus dem Batch entfernt, was Rechenleistung spart. Diese Optimierung ist besonders vorteilhaft beim Betrieb mit großen Batch-Größen, da in diesem Regime die GPU compute-bound wird. Weitere Details finden Sie in diesem vLLM-Blogbeitrag .
AV benötigt eine Token-für-Token-Schätzung der Akzeptanzwahrscheinlichkeit, weshalb es bislang nur DSpark-Drafter unterstützte. DSpark-Modelle werden häufig mit einem Confidence Head ausgeliefert: einer kleinen linearen Schicht über dem Hidden State des Drafters an jeder Position, trainiert als binärer Klassifikator für die Frage „Wird das Ziel dieses Token akzeptieren?“.
Problem
Draft-Modelle ohne Confidence Head, wie EAGLE, MTP, DFlash und einige DSpark-Checkpoints, gehen bisher komplett leer aus, was AV betrifft. Um es zu nutzen, benötigen diese Drafter eine Token-für-Token-Schätzung der Akzeptanz, und das Hinzufügen eines Confidence Heads bedeutet ein Neutraining des Drafters, was für die vielen bereits im Einsatz befindlichen Checkpoints keine Option ist.
Vorherige Arbeiten
Die Verwendung der eigenen Confidence des Drafters als Proxy für die Akzeptanz ist ein etabliertes Verfahren. EAGLE-2 zeigte, dass EAGLEs Draft-Wahrscheinlichkeiten eng mit den Akzeptanzraten korrelieren, und nutzte sie, um einen dynamischen Draft-Baum aufzubauen und neu zu ranken. Draft & Verify und mehrere Nachfolgearbeiten stoppen das Drafting, sobald die Wahrscheinlichkeit des Drafters unter einen festen Schwellenwert fällt. SpecDec++ stattdessen trainiert einen dedizierten Head zur Vorhersage der Akzeptanz, ähnlich im Geist wie DSparks Confidence Head. In allen Fällen wird die Abbildung von Draft-Confidence auf Akzeptanz entweder unverändert verwendet oder offline gelernt.
AV benötigt mehr als ein gutes Ranking. Seine Budgetentscheidung summiert die vorhergesagten Akzeptanzwahrscheinlichkeiten und gewichtet sie gegen die gemessenen Kosten, daher müssen die Vorhersagen für das spezifische Modellpaar und die bereitgestellte Workload kalibriert sein – genau das liefert der online angepasste Schätzer im nächsten Abschnitt.
Lösung: Online angepasster Akzeptanzschätzer
Wir haben eine leichte logistische Regression hinzugefügt, die die Akzeptanzwahrscheinlichkeit jedes Draft-Tokens aus einem einzelnen Skalar schätzt, der aus der Draft-Verteilung abgeleitet wird: den Log-Odds des wahrscheinlichsten Tokens des Drafters. Sie hat eine gemeinsame Steigung und einen Intercept pro Draft-Position, sodass ein K-Token-Drafter insgesamt K + 1 Parameter. Diese Parameter werden online aus den Accept/Reject-Entscheidungen angepasst, die das Zielmodell bereits während der normalen Verifizierung erzeugt. Jeder vorhandene Draft-Checkpoint erhält AV kostenlos dazu.
Der Rest dieses Abschnitts behandelt die beiden Hälften des Designs: welche Größe der Schätzer bewertet und wie seine Koeffizienten während des Betriebs angepasst werden.
Bewertung der Verteilung
Der Confidence-Score für einen gegebenen Draft-Token wird mithilfe einer logistischen Regression pro Position geschätzt:
wobei ω die angepasste Steigung ist, die über alle Draft-Positionen hinweg geteilt wird, βi ist der angepasste Abschnitt pro Position, und q ist die Entwurfsverteilung. Die alternative Log-Odds-Form macht die Beziehung deutlich:
logit(qmax„) ist das Merkmal des Schätzers und ist der Log-Odds des wahrscheinlichsten Tokens des Entwurfs. Anschaulich ausgedrückt stellt es dar, wie sicher das Entwurfsmodell bei seinen Vorhersagen ist. Es wird linear durch die Koeffizienten ω und β transformiertich „um die Log-Odds der Annahme des Entwurfs durch das Zielmodell vorherzusagen. Die Sigmoidfunktion davon ist“ p, die geschätzte Akzeptanzrate, die als Konfidenzwert für AV verwendet wird.
Weitere betrachtete Merkmale
Mehrere alternative Merkmale wurden aus dem einen oder anderen Grund in Betracht gezogen und wieder verworfen. Die vier Hauptachsen, die uns bei der Bewertung eines Merkmals am wichtigsten waren, waren:
- Verlustfreiheit — Ob das Merkmal die Ausgabeverteilung während des speculativen Decodierens verzerrt.
- Fläche unter der Kurve (AUC) — Die Wahrscheinlichkeit, dass ein zufällig gewählter akzeptierter Entwurf höher bewertet wird als ein zufällig ausgewählter abgelehnter. Dies misst die Diskrimination zwischen Entwürfen, die akzeptiert bzw. abgelehnt werden sollten. Ein höherer Wert zeigt eine bessere Fähigkeit zur Unterscheidung, und 0.5 entspricht dem Zufall.
- Log-loss — Die mittlere negative Log-Likelihood der vorhergesagten Akzeptanzwahrscheinlichkeit, die falsche, aber selbstbewusst getroffene Aussagen bestraft und Kalibrierung belohnt. Ein niedrigerer Wert zeigt eine bessere Fähigkeit, die tatsächliche Akzeptanzwahrscheinlichkeit eines bestimmten Entwurfs vorherzusagen.
- Expected Calibration Error (ECE) — Binen Sie jeden Draft anhand seiner vorhergesagten Akzeptanzwahrscheinlichkeit, messen Sie dann den Fehler zwischen der mittleren Vorhersage und der mittleren beobachteten Häufigkeit innerhalb jedes Bins, gewichtet mit der Belegung des Bins. Dies misst die Kalibrierung, und ein niedrigerer Wert zeigt eine bessere Fähigkeit an, einem Draft eine Wahrscheinlichkeit zuzuweisen, die der tatsächlichen Häufigkeit unter ähnlich bewerteten Drafts entspricht.
Verlustfreiheit ist eine nicht verhandelbare Eigenschaft, die die Merkmale haben müssen. Andernfalls brechen wir die grundlegende Garantie des speculative decoding, genau die Verteilung des Zielmodells auszugeben. AUC und ECE sind beide für die Trimming-Entscheidung von AV relevant, allerdings auf unterschiedliche Weise. AUC ist wichtig für die lokale Ordnung der Überlebenswahrscheinlichkeiten:
survival = confidence_probs[idx_mapping].cumprod(dim=1)
...
winners = flat.topk(draft_budget).indices
AUC stellt sicher, dass ein wahrscheinlicher zu akzeptierender Draft-Token gegenüber einem weniger wahrscheinlichen zugelassen wird. Andererseits ist ECE wichtig für die globale Budget-Entscheidung:
num_tokens_to_estimated_accepted_tokens = np.concatenate(
    ([num_sampling_requests], num_sampling_requests + np.cumsum(scores))
)
costs = draft_cost_ms[...] + verify_cost_ms[...]
...
draft_budget = int(np.argmax(num_tokens_to_estimated_accepted_tokens / costs))
Die Wahrscheinlichkeiten werden summiert und dann durch die gemessene Kostentabelle dividiert. ECE stellt sicher, dass die geschätzte Anzahl akzeptierter Tokens der Realität entspricht.
Nachfolgend eine Tabelle der verschiedenen experimentierten Merkmale zusammen mit ihren Werten für die vier Kategorien. Sie wurden über ~4.5M gelabelte Drafts gemessen, die im Verlauf des Betriebs von DeepSeek-V4-Flash + DSpark (temp=1, top-p=0.95, conc=64) ohne AV über fünf Datensätze gesammelt wurden: SPEED-Bench 2k low/high-entropy, GSM8K, HumanEval und MT-Bench. Die letzten zwei Zeilen sind Referenzen und keine gefitteten Merkmale: das qmax des Drafters, direkt als Akzeptanzwahrscheinlichkeit ohne Fit verwendet, sowie die Werte des trainierten Confidence-Heads.
| Merkmal | lossless | AUC | log-loss | ECE |
|---|---|---|---|---|
| log(qmax) | ja | 0.8069 | 0.4813 | 0.0592 |
| log(qmax) − log(q2nd) (Rand oben-2) | ja | 0.8156 | 0.4437 | 0.0105 |
| H(q) (Entropie) | ja | 0.8321 | 0.4577 | 0.0638 |
| −log(−log(qmax)) | ja | 0.8336 | 0.4289 | 0.0103 |
| logit(qmax) (ausgeliefert) | ja | 0.8336 | 0.4284 | 0.0100 |
| logit(qsampled) | nein | 0.8553 | 0.4040 | 0.0152 |
| −log(−log(qsampled)) | nein | 0.8554 | 0.4075 | 0.0193 |
| qmax (kein Fit, direkt als Wahrscheinlichkeit verwendet) | ja | 0.8259 | 0.4880 | 0.0736 |
| trainierter Confidence-Head | ja | 0.8191 | 0.4449 | 0.0052 |
logit(qsampled) und −log(−log(qausgesampelten)) schneiden in Bezug auf die AUC klar besser ab als das in der Tabelle gewählte Merkmal, wurden aber nicht verwendet, weil ein Trimming auf ihrer Grundlage zu einer verzerrten Ausgabeverteilung führt. Beide lesen qausgesampelten, die Wahrscheinlichkeit des Tokens, das der Drafter tatsächlich gezogen hat. Trimmt man einen Entwurf anhand einer Funktion dieses Werts, so wird die Entscheidung, Position i zu verifizieren, abhängig von xi selbst, sodass die Entwürfe, die das Trimming überstehen, nicht mehr wie qverteilt sind. Standard-Rejection-Sampling akzeptiert ein Token mit der Wahrscheinlichkeit min(1, p/q) und erwartet dabei, dass q die Verteilung ist, aus der das Entwurfstoken gesampelt wurde. Ein Trimming auf Grundlage von qausgesampelten verzerrt die emittierte Verteilung hin zu den Tokens, bei denen der Drafter selbst sicherer ist.1
Die qmax -Zeile "no fit" zeigt, warum wir überhaupt eine Anpassung vornehmen, statt direkt die eigene Wahrscheinlichkeit des Drafters zu verwenden, wie es EAGLE-2 beim Aufbau seines Entwurfsbaums tut. Direkt verwendet ordnet die Top-Token-Wahrscheinlichkeit des Drafters Entwürfe tatsächlich besser als der trainierte Confidence-Head (0.8259 gegenüber 0.8191 AUC). Sie ist jedoch nicht gut kalibriert. Ihre mittlere Vorhersage über die gelabelten Entwürfe beträgt 0.784 gegenüber einer beobachteten Akzeptanzrate von 0.723, und ihr ECE ist 7x schlechter als das ausgelieferte logit(qmax)-Merkmal (0.0736 gegenüber 0.0100). Die Top-Token-Wahrscheinlichkeit des Drafters spiegelt nur wider, wie sicher der Drafter bei seiner eigenen Vorhersage ist, nicht aber, ob das Zielmodell zustimmen wird. Diese Übereinstimmung wird zusätzlich durch das Sampling-Setup und die Workload beeinflusst. Ein Online-Fit lernt diese Abbildung direkt aus den Accept/Reject-Entscheidungen des Zielmodells und liefert eine bessere Kalibrierung, wovon die Budgetentscheidung abhängt.
Wir haben uns schließlich für das logit(qmax)-Merkmal entschieden, das bei vernünftigem Aufwand eine gute Balance zwischen AUC und ECE bietet. Es war auch eine naheliegende Wahl, da es sowohl die Log-Odds-Skala als auch die Auflösung der Größe teilt, die wir zu schätzen versuchten.
Vergleich mit einem trainierten Confidence Head
Wie in der obigen Tabelle zu sehen ist, übertrifft bei DeepSeek-V4-Flash + DSpark der Estimator den Confidence Head sowohl bei AUC als auch bei der Log-Likelihood-Verlustfunktion, liegt jedoch bei ECE zurück. Die folgende Tabelle fasst den Unterschied zusammen:
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| estimator logit(qmax) | 0.8336 | 0.4284 | 0.0100 |
| trainierter Confidence Head | 0.8191 | 0.4449 | 0.0052 |
| Δ (Estimator − Head) | +0.0146 | −0.0166 | +0.0048 |
Sobald man jedoch den ersten Entwurf aus den Durchschnittswerten ausschließt, ändert sich das Bild erheblich:
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| estimator logit(qmax) | 0.8352 | 0.4420 | 0.0103 |
| trainierter Confidence Head | 0.8075 | 0.4743 | 0.0090 |
| Δ (Estimator − Head) | +0.0278 | −0.0323 | +0.0013 |
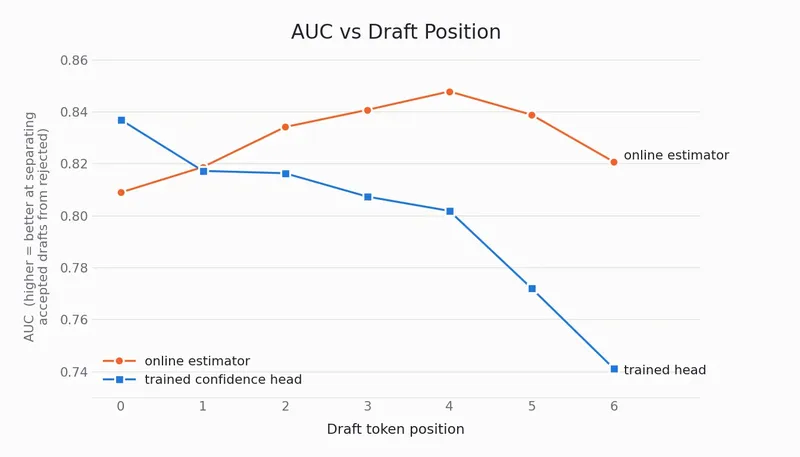
Head und Estimator liegen bei der Kalibrierung nun praktisch gleichauf. Die Aufschlüsselung der AUC nach Position hilft zu erklären, warum:
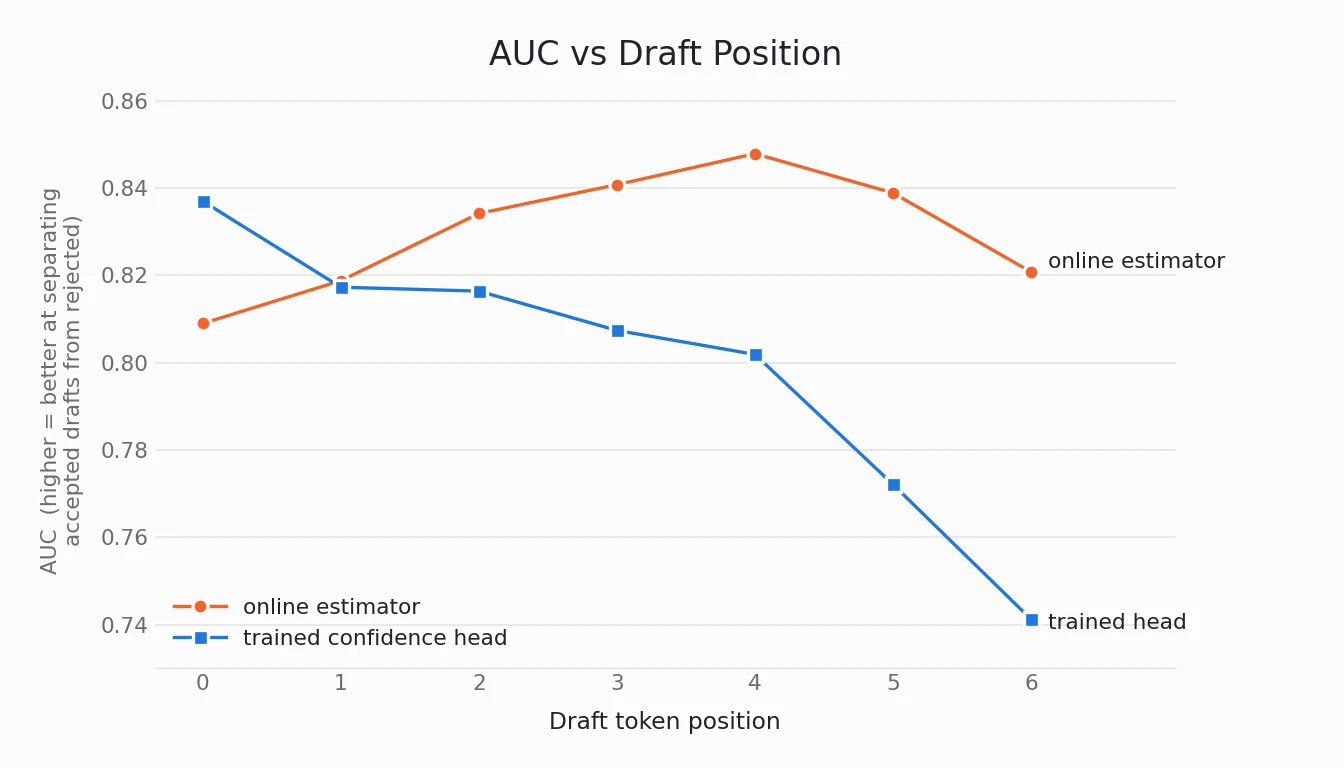
Der Confidence Head ist der bessere Prädiktor an der ersten Entwurfsposition, aber der Estimator übernimmt ab der zweiten Position die Führung. Der Abstand vergrößert sich mit der Tiefe, wobei der Estimator an der letzten Position um 0.08 AUC vorne liegt. Beide Prädiktoren fallen außerdem nach der fünften Position ab. Das liegt wahrscheinlich daran, dass DSV4-Flashs DSpark eine Blockgröße von 5 deklariert und der Drafter nie darüber hinaus trainiert wurde, sodass die Entwürfe dort selbst schlechter werden.
Da das Überleben ein laufendes Produkt ist und die erste Entwurfsposition stets den höchsten Score einer Anfrage trägt, ist sie seltener das Token, das das Budget streicht. Der Vorteil des Estimators liegt genau dort, wo die Kürzung stattfindet, und das erklärt, warum der Estimator mit dem Confidence Head in der End-to-End-Leistung mithalten kann.
Anpassen der Koeffizienten
Die Koeffizienten ω und βi werden während des Live-Betriebs von Anfragen kontinuierlich neu angepasst. Entwurfstokens, die im vorherigen Decode-Schritt vorgeschlagen wurden, werden im nächsten Decode-Schritt vom Zielmodell verifiziert. Nur Entwurfstokens bis zur ersten Ablehnung (falls vorhanden) sind für das Training geeignet, weil das Zielmodell sie explizit gelabelt hat (akzeptieren oder ablehnen).
Wir verwenden Iteratively Reweighted Least Squares (IRLS), um die Log-Likelihood-Verlustfunktion der Vorhersagen gegenüber den Labels zu minimieren. Diese Minimierung wird über eine Taylor-Approximation zweiter Ordnung der Log-Likelihood-Verlustfunktion durchgeführt. Der Optimierungsschritt für ω und βi wird durch Lösen des Gleichungssystems erhalten
wobei Δθ das Delta für die gemeinsame Steigung ω und die positionsbezogenen Achsenabschnitte β isti, H ist die Hessesche Matrix der Verlustfunktion mit der Form (K + 1) × (K + 1), und g ist der Gradient der Verlustfunktion, mit einer Größe von K + 1.
Eine Neueinpassung (Refit) erfolgt nach jeder festen Runde von N Decode-Schritten. Während jedes Decode-Schritts in diesem Intervall akkumulieren wir die Hesse- und Gradientenwerte, die aus den während der Runde gesammelten Koeffizienten, Features und Labels abgeleitet werden. Dadurch wird der Speicherverbrauch über eine Runde auf O(K²) begrenzt, im Gegensatz zu O(N × B × K), wenn wir stattdessen die Rohdaten der Labels sammeln würden. Im letzten Schritt der Runde wird das Gleichungssystem gelöst und die Koeffizienten werden aktualisiert.
Wie zu erwarten, werden tiefere Drafts seltener akzeptiert als flachere. Folglich können tiefe Draft-Positionen während einer Runde an Labels verhungern. Um die Auswirkungen davon auf den Refit-Prozess zu mildern, wurden zwei Designentscheidungen getroffen:
- Shared Slope: Die Steigung wird über alle Draft-Positionen hinweg geteilt, um verrauschte Updates zu vermeiden, die durch Datenverdünnung in der Tiefe entstehen. Vorhersagen reagieren viel empfindlicher auf Fehler in der Steigung als auf Fehler im Achsenabschnitt, sodass das Teilen den Newton-Schritt gut bestimmt macht. Darüber hinaus zeigen empirische Messungen, dass das Teilen der Steigung praktisch nichts an Genauigkeit kostet (nur 0.0002 AUC und 0.0003 log-loss).
- Step Damping: Das Update jedes Koeffizienten wird mit der Menge der unterstützenden Belege skaliert, und zwar nach der Formel n / (n + constant), wobei n die Anzahl der bewerteten Drafts ist. Dies stellt sicher, dass tiefere Positionen mit weniger Labels konservativer aktualisiert werden, wodurch Updates auf Basis von Rauschen verhindert werden.
Slope vs Intercept Roles
Die angepassten Koeffizienten wurden über mehrere Modell/Datensatz-Kombinationen hinweg verfolgt, und die beiden Arten von Parametern verhalten sich sehr unterschiedlich.
Halten Sie das Modellpaar fest und variieren Sie die Workload: Passt man DSV4-Flash + DSpark unabhängig voneinander auf jede von fünf Workloads an, bewegt sich die Steigung kaum (0.51 bis 0.55), unkorreliert mit der Schwierigkeit der Workload (r = −0.08 gegenüber der mittleren Draft-Entropie). Die Achsenabschnitte verhalten sich umgekehrt: Der Achsenabschnitt der ersten Draft-Position korreliert mit der Draft-Entropie bei r = −0.89 und reicht von ~0.5–0.6 bei den besser vorhersagbaren Workloads bis unter 0 bei der am wenigsten vorhersagbaren.
| Datensatz | Akzeptanzrate | Mittlere Draft-Entropie | Steigung ω | Achsenabschnitt β0 |
|---|---|---|---|---|
| gsm8k | 0.781 | 0.562 | 0.5365 | +0.478 |
| humaneval | 0.751 | 0.669 | 0.5135 | +0.486 |
| speed-bench 2k low-entropy | 0.755 | 0.703 | 0.5087 | +0.610 |
| mt-bench | 0.714 | 0.800 | 0.5495 | +0.181 |
| speed-bench 2k high-entropy | 0.642 | 1.077 | 0.5197 | −0.089 |
Variieren wir nun das Modellpaar: Die Steigung liegt über alle Paare hinweg zwischen 0.45 und 0.59, während sie innerhalb jedes Paars eng beieinander bleibt. Die Achsenabschnitte unterscheiden sich ebenfalls zwischen den Paaren, sind also im Gegensatz zur Steigung keine Eigenschaft einer einzelnen Achse allein.
| Modell | nspec | Steigung ω | ω sd | Achsenabschnitt β0 |
|---|---|---|---|---|
| DeepSeek-V4-Flash + DSpark | 5 | 0.5013 | 0.0250 | +0.279 |
| MiMo-V2.5-Pro-FP4 + DFlash | 8 | 0.5197 | 0.0415 | −1.000 |
| Inkling-NVFP4 + MTP | 8 | 0.5859 | 0.0349 | −0.572 |
| Muse-Glimmer-30B + DFlash2 | 7 | 0.4450 | 0.0323 | +0.167 |
Liest man die beiden Tabellen zusammen, ergibt sich eine Arbeitsteilung. Die Steigung misst, wie gut das Entwurfsmodell weiß, wann es recht hat. Dies ist eine Eigenschaft des Ziel-/Entwurfspaars und der Entwurfsmethode, weshalb sie sich kaum verändert, wenn sich nur die Workload ändert. Die Achsenabschnitte nehmen den Rest auf: die Basisakzeptanzrate an jeder Entwurfsposition, die mit der Tiefe sinkt und bei weniger vorhersagbarem Inhalt noch weiter abfällt. Diese Basisakzeptanzrate hängt sowohl vom Modellpaar als auch von der Workload ab, weshalb sich die Achsenabschnitte entlang beider Achsen bewegen, während die Steigung sich nur entlang einer einzigen bewegt.
Benchmarks
Wir haben drei Checkpoints benchmarked (MiMo-V2.5-Pro-FP4 + DFlash, Inkling-NVFP4 + MTP und Muse-Glimmer-30B + DFlash2), die zuvor AV überhaupt nicht nutzen konnten, sowie DSV4-Flash + DSpark + den Estimator und DSV4-Flash + DSpark + den Confidence Head als Referenz. Die folgenden Zuwächse wurden mit AV aus vs. ein, Temperatur 1.0, top-p 0.95 und Nebenläufigkeit 64 über vier Datensätze erfasst.
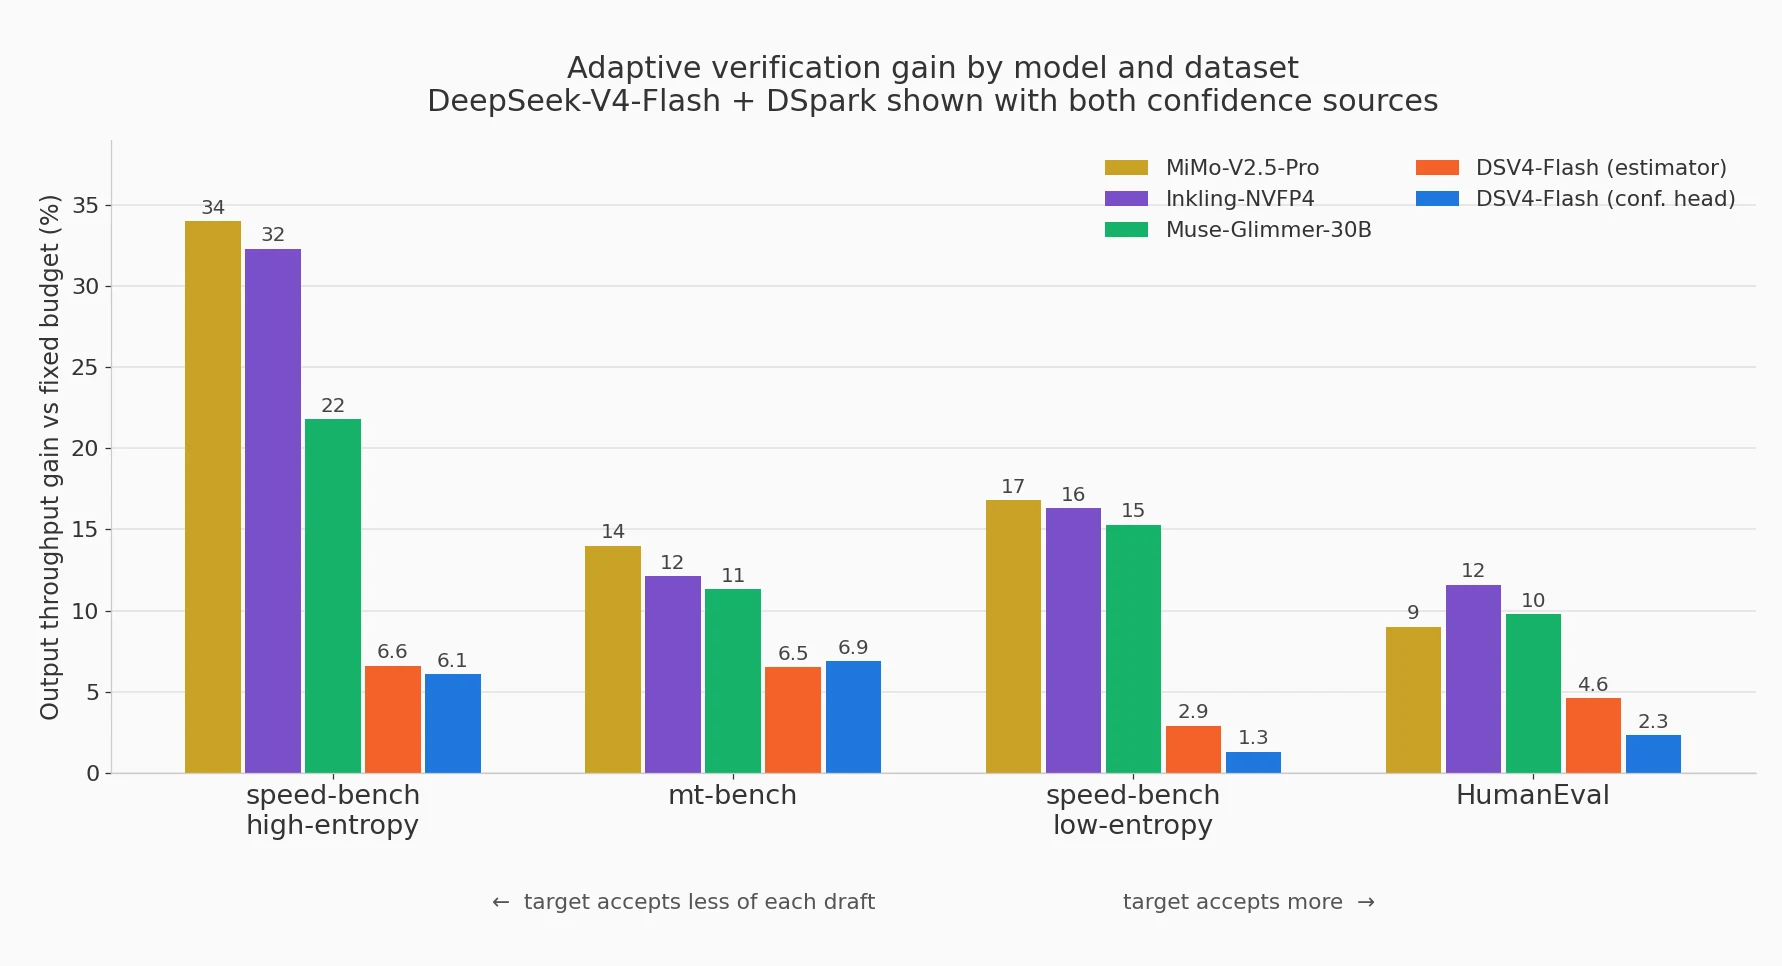
Verglichen mit fester Verifikation ist der Online-Estimator bei derselben spekulativen Länge ein Gewinn über alle benchmarkten Datensätze hinweg. Dieser Gewinn allein erzählt jedoch nicht die ganze Geschichte. Oft lässt sich eine kleinere feste Länge finden, die AV bei der maximalen spekulativen Länge bei bestimmten Nebenläufigkeiten übertrifft. Die folgende Pareto-Kurve wurde mit DSV4 + DSpark über eine Abtastung fester spekulativer Längen und AV bei der maximalen spekulativen Länge erfasst:
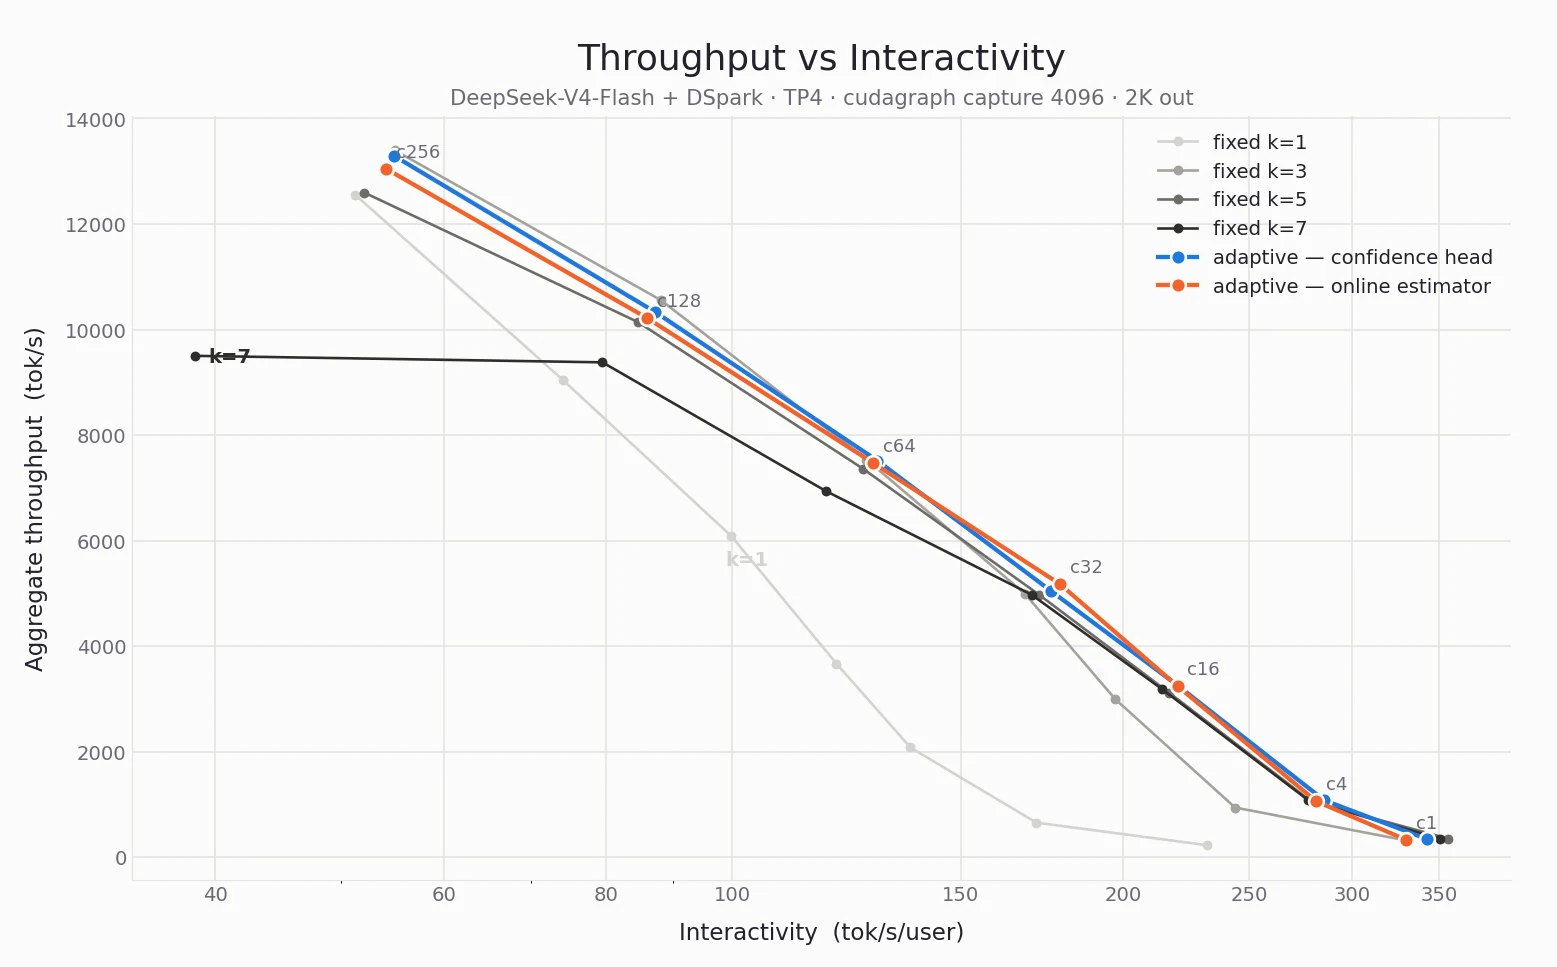
Der Online-Estimator und der Confidence Head sind hinsichtlich der Leistung bei allen gemessenen Nebenläufigkeiten ungefähr gleichauf. Der Online-Estimator ist jedoch nicht als Ersatz für den Confidence Head gedacht, sondern als Drop-in-Alternative, wenn keiner vorhanden ist. Sehen wir uns an, wie er bei einem Modellpaar abschneidet, das derzeit keinen Confidence Head besitzt. Unten ist die Pareto-Kurve für MiMo-V2.5-Pro-FP4 + DFlash über eine Abtastung fester spekulativer Längen und AV:
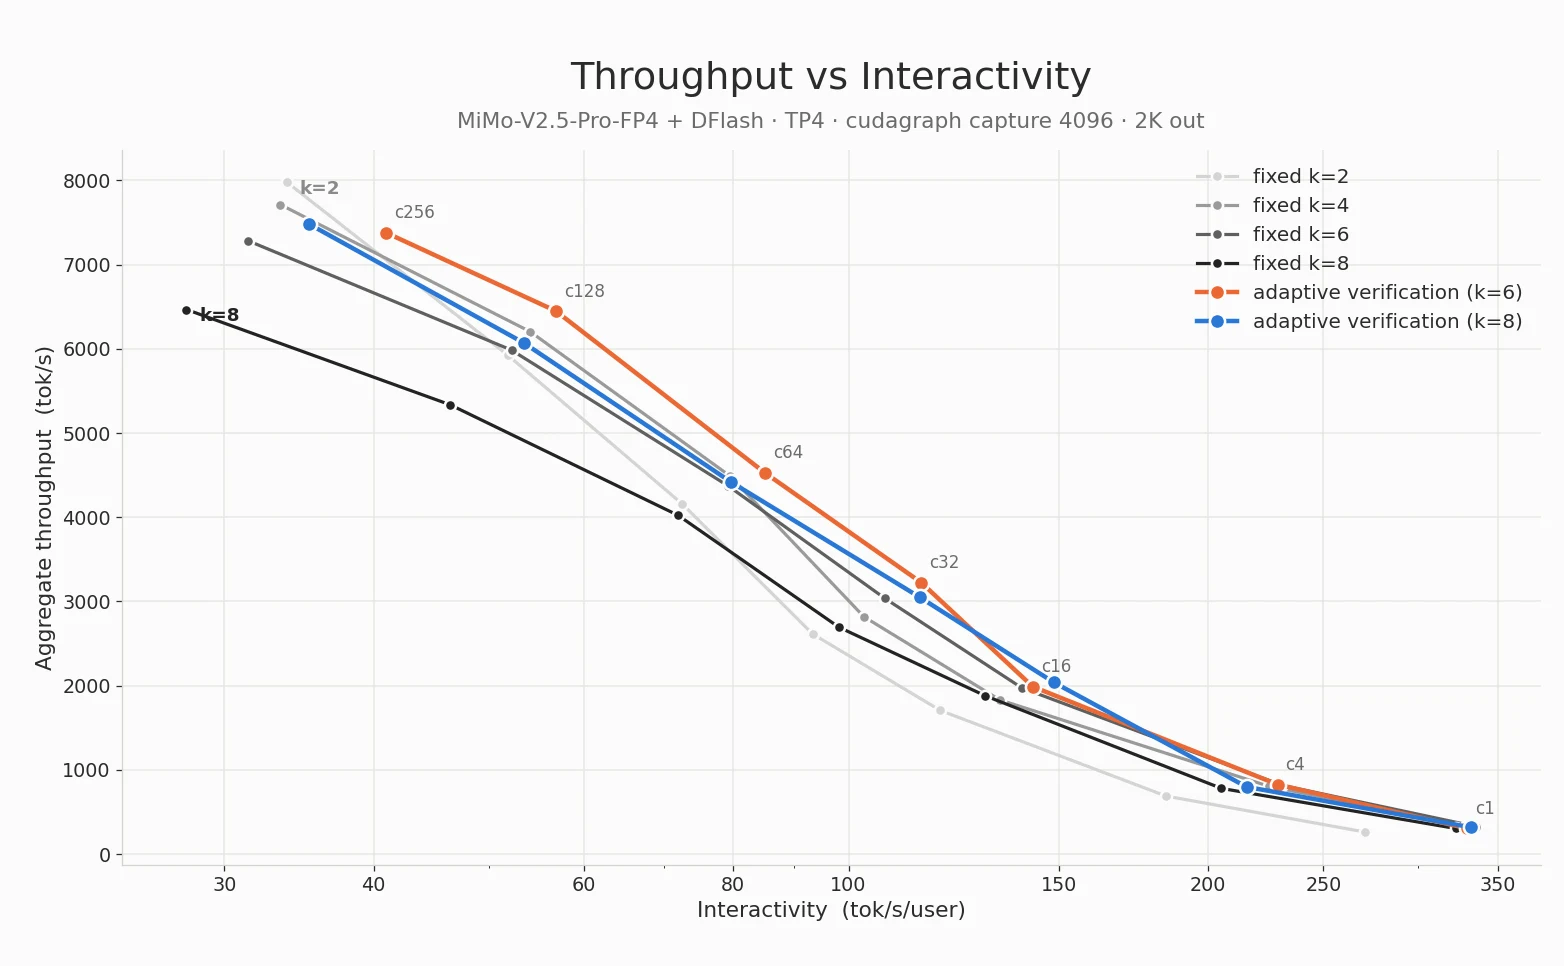
AV liegt bei 5 von 7 Nebenläufigkeiten auf der Durchsatz-Interaktivitäts-Frontier.
Einschränkungen
- Das Attention-Backend des Zielmodells muss Verifikation mit variabler Länge unterstützen. Dies ist dieselbe Voraussetzung, die DSpark AV bereits hat.
- MTP und EAGLE profitieren weniger von AV als DFlash und DSpark. Das liegt daran, dass diese auto-regressiven Speculatoren proportional höhere Kosten für das Entwurf von Tokens zahlen, die möglicherweise vor der Verifikation gekürzt werden.
vLLM-Verwendung
AV wird über die speculative config aktiviert. Bei einem Entwurfsmodell, das (1) keinen Confidence Head hat und (2) Attention mit variabler Länge für alle seine Backends unterstützt, wird der Online-Estimator automatisch ausgewählt:
vllm serve <target_model> \
  ...
  --speculative-config '{
    "model": "<draft_model>",
    "method": "<method>",
    "num_speculative_tokens": <num_speculative_tokens>,
    "draft_sample_method": "probabilistic",
    "enable_adaptive_verification": true
  }'
Danksagungen
Diese Arbeit wurde von Giancarlo Delfin (Inferact) durchgeführt und baut direkt auf Adaptive Verification von Lucas Wilkinson (Red Hat) und Benjamin Chislett (NVIDIA) auf.
Fußnoten
-
Ein Beispiel mit einem einfachen Zwei-Token-Vokabular aus [a, b] kann diesen Bias veranschaulichen. Angenommen p = [0.5, 0.5], q = [0.2, 0.8], und dass ein Draft-Token bei der Verifikation verworfen wird, wenn q(x) < 0.5. Das Ziehen von a führt zum Verwerfen, und das Zielmodell sampelt ein Token aus seiner eigenen Verteilung, p(x). Das Ziehen von b führt jedoch zur Verifikation: Das Token wird mit Wahrscheinlichkeit min(1, p(b)/q(b)) = 0.625 akzeptiert, andernfalls abgelehnt und aus dem Residuum norm(max(0, p − q)) = [1, 0] neu gesampelt, wodurch aergeben wird. Beim Rejection Sampling erhalten wir pout(a) = q(a)·p(a) + q(b)·(1 − 0.625) = 0.4 und pout(b) = q(a)·p(b) + q(b)·0.625 = 0.6. Dies unterscheidet sich von der Verteilung des Ziels [0.5, 0.5] und verletzt die verlustfreie Garantie des speculative decoding. ↩