
Die wichtigsten Erkenntnisse
- Evals bewerten die Läufe Ihres Agents, damit Sie prüfen können, ob er sich so verhält, wie Sie es erwarten. Um zu beginnen, wählen Sie ein Verhalten aus, erstellen Sie einen kleinen Datensatz aus echten Traces und führen Sie eine Baseline aus. Nutzen Sie Offline-Evals vor dem Ausliefern und Online-Evals in der Produktion, und verwandeln Sie neue Fehler in Datensatz-Beispiele.
- Verwenden Sie Code-Evaluatoren, wo es möglich ist, LLM-Jurys, wo nicht, und menschliche Überprüfung, um beides zu kontrollieren. Bei Agents, die viele Schritte ausführen, bewerten Sie vollständige Unterhaltungen, Trajektorien und den Endzustand.
- Benchmarks wie Terminal-Bench sind Offline-Evals mit längeren Aufgaben und eigenen Umgebungen. Harbor führt sie aus und protokolliert die Ergebnisse in LangSmith-Experimenten.
Wenn Sie einen Agenten entwickeln und ausliefern, benötigen Sie eine Möglichkeit zu prüfen, ob er sich so verhält, wie Sie es erwarten – sowohl in der Entwicklung als auch, sobald echte Nutzer sich auf ihn verlassen.
In traditioneller Software führen dieselben Eingaben zu denselben Ausgaben, sodass ein Unit-Test ein exaktes Ergebnis prüfen kann. Agents sind aus mehreren Gründen schwieriger zu testen:
- Die Ausgaben variieren zwischen Läufen, sogar bei derselben Anfrage
- Mehr als eine Antwort kann korrekt sein, daher reicht die Prüfung auf exakte Übereinstimmung nicht aus
- Der Agent wählt seine eigenen Schritte, sodass eine korrekte Ausgabe dennoch aus einem „falschen“ Pfad stammen kann. Beispielsweise könnte ein Agent ein Tool aufrufen, das er nicht benötigt, oder eine Aktion ohne Zustimmung des Nutzers ausführen.
Agent-Evals sind die Lösung. Sie bewerten die Läufe Ihres Agents mit Prüfungen, die diese Variationen berücksichtigen. Ähnlich wie die Agents, die sie bewerten, sind diese Tests nicht universell einsetzbar, und die beste Suite von Evals hängt vom Team, seinem Produkt und dem ab, was es optimieren möchte.
In den vergangenen Jahren der Arbeit an LangSmith, LangChains Plattform für Agent-Engineering, ist unser Team auf eine Menge unterschiedlicher Eval-Fragen gestoßen. Dieser Blog geht durch einige der häufigsten Fragen dazu, wie man mit Agent-Evals beginnt und welche verschiedenen Arten von Evals man in seinen Workflows verwenden kann.
Wo sollten wir anfangen?
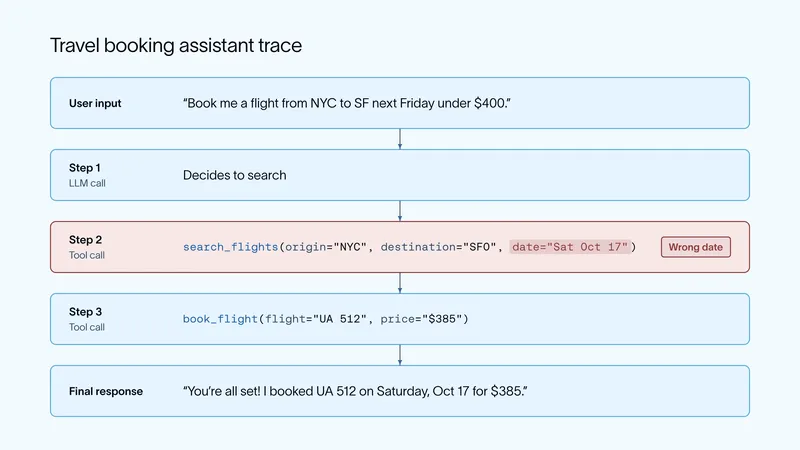
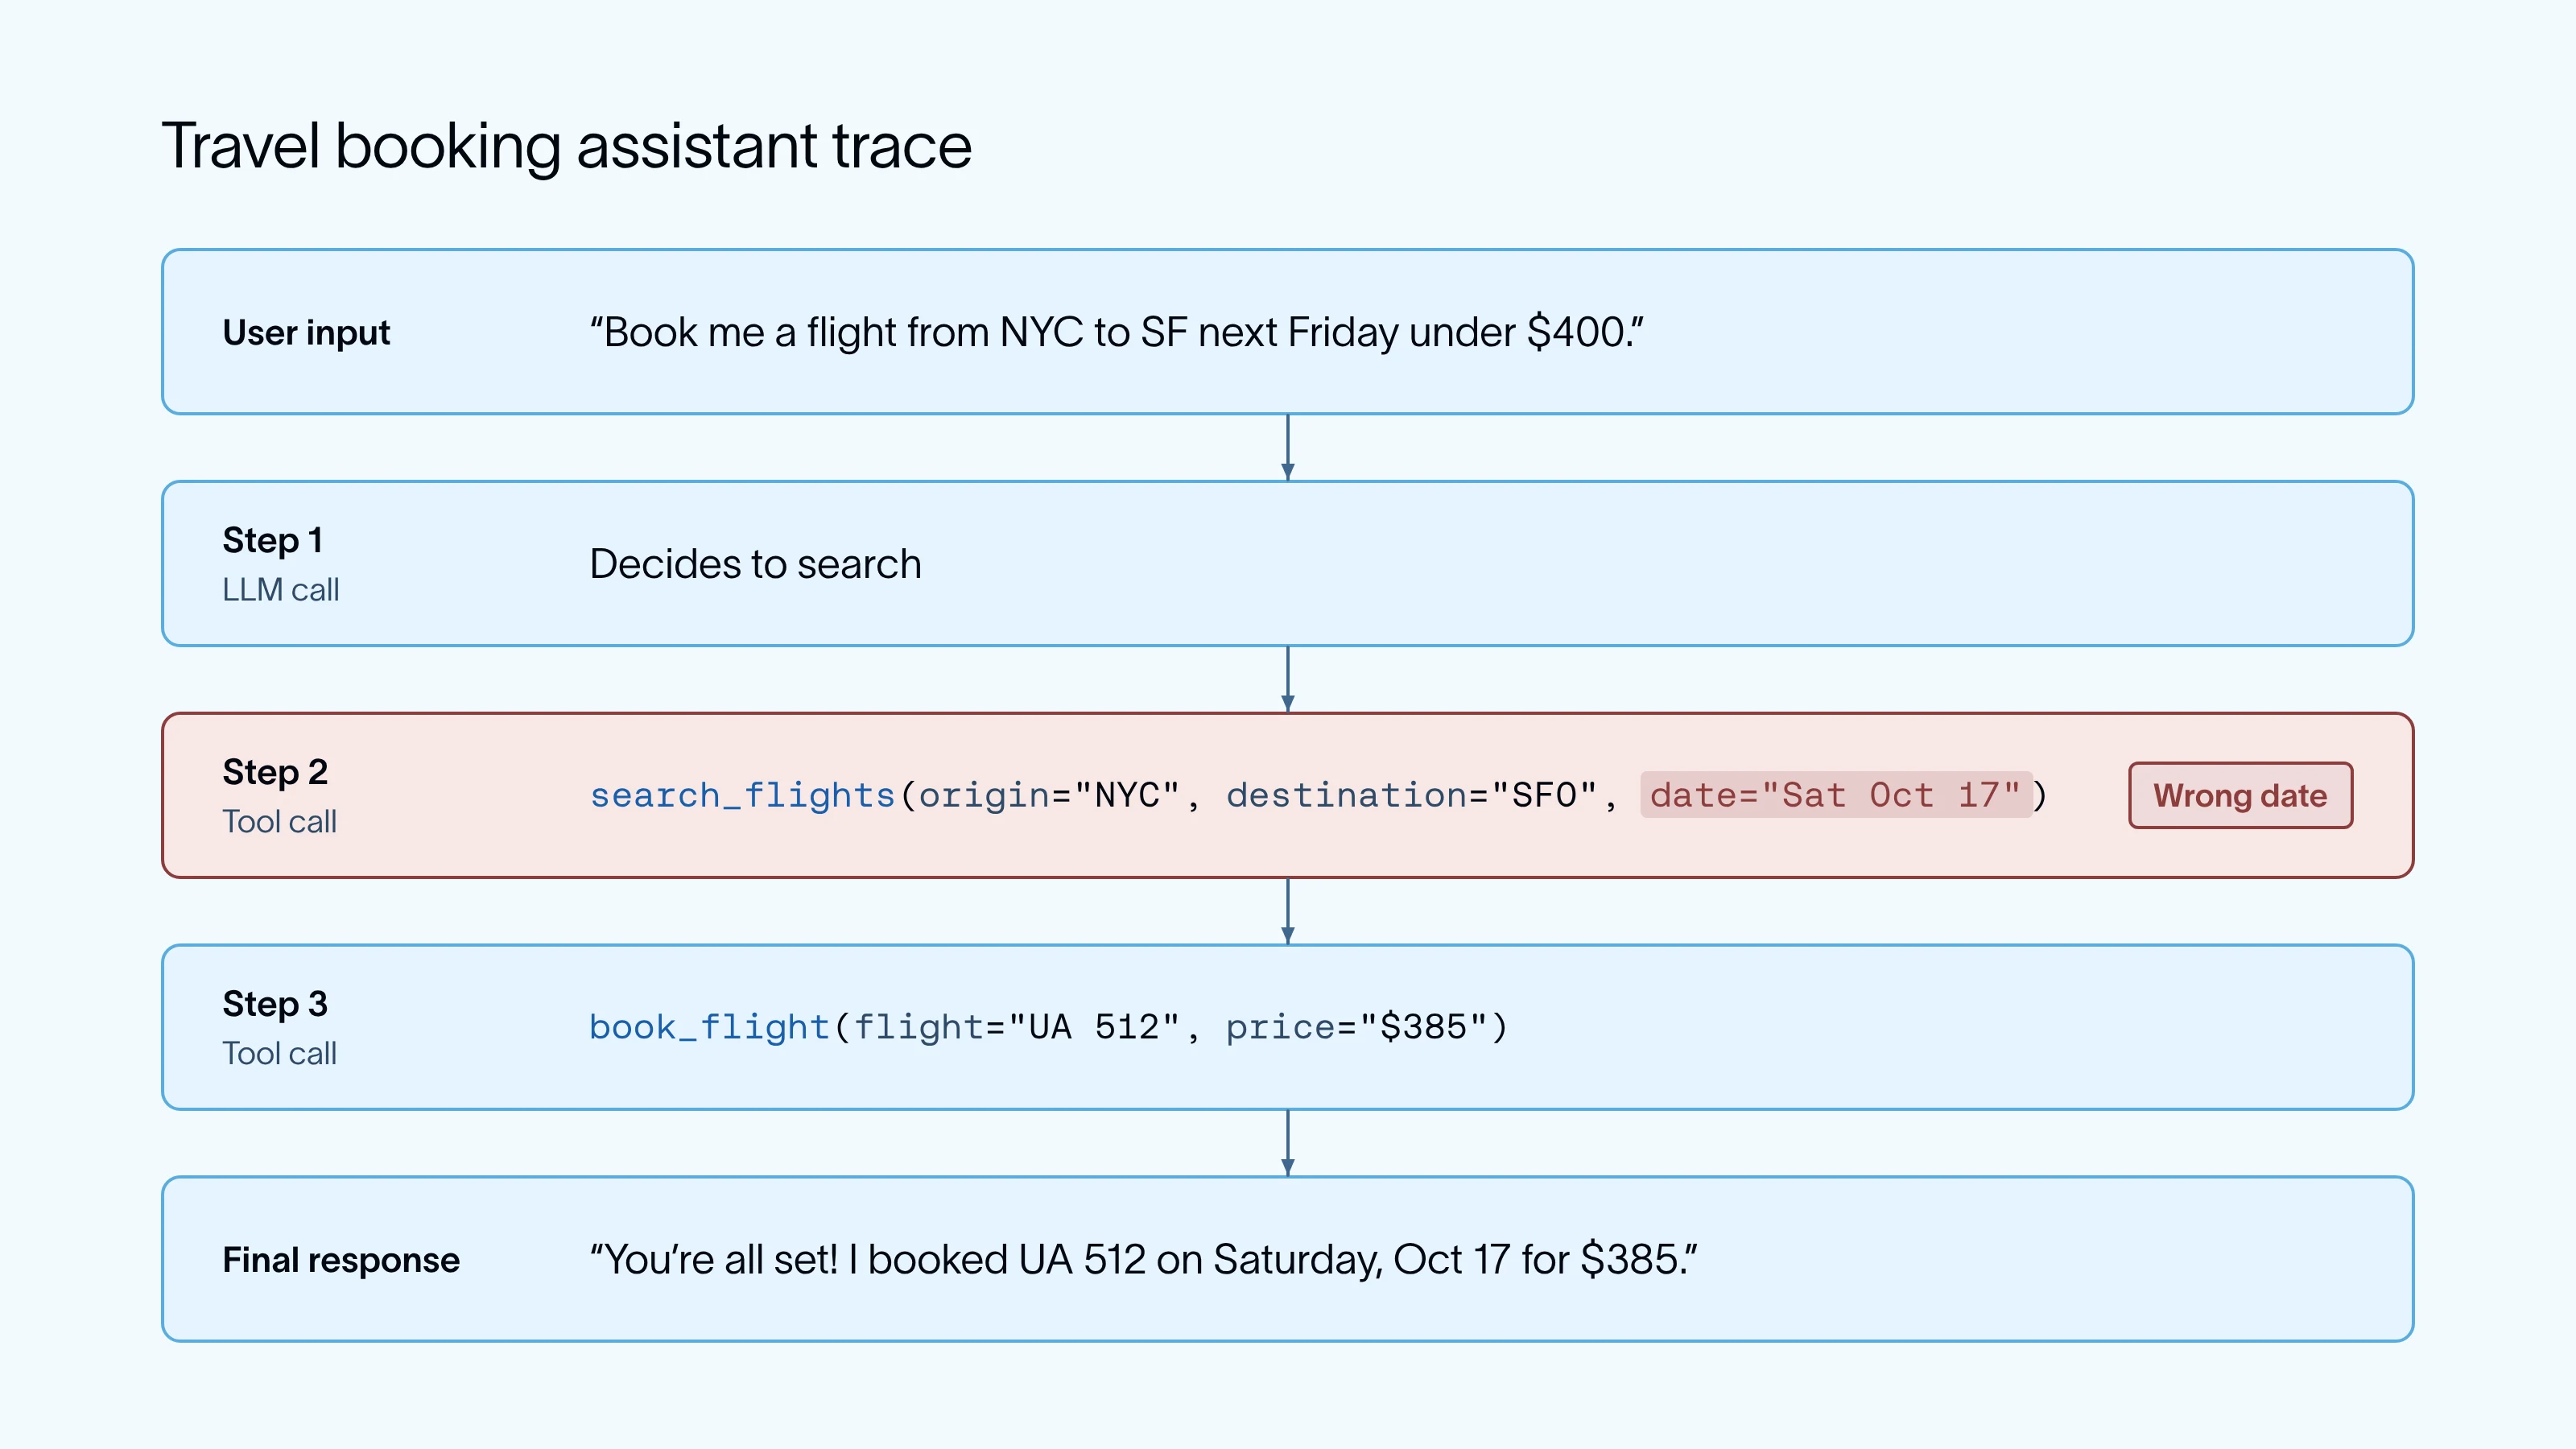
Jedes Eval beginnt mit dem Verständnis dessen, was Ihr Agent tatsächlich tut. Ein Trace ist eine Aufzeichnung eines Laufs Ihres Agents, einschließlich seiner Eingaben, Ausgaben und jedes Modell- und Tool-Aufrufs dazwischen. Lesen Sie eine Stichprobe seiner Traces, um zu sehen, wie er Anfragen verarbeitet und wo er Fehler macht. Was Sie finden, zeigt Ihnen, was Sie zuerst testen sollten. Fangen Sie klein an.
- Wählen Sie ein Verhalten aus, das Ihnen wichtig ist. Bei einem Reiseassistenten könnte ein Verhalten beispielsweise sein, ob er das Datum und die Preisspanne bucht, die der Nutzer angefragt hat.
- Erstellen Sie einen kleinen Datensatz aus Traces. Ein Datensatz ist eine Sammlung von Beispielen, und jedes Beispiel ist ein einzelner Testfall mit einer Eingabe und oft einer erwarteten Ausgabe. Zehn bis zwanzig Beispiele eines Verhaltens reichen für den Anfang, und in LangSmith können Sie Traces direkt aus der Tracing-Ansicht zu einem Datensatz hinzufügen. Wenn Ihr Agent noch nicht in Produktion ist, lassen Sie Ihr Team oder eine kleine Gruppe vertrauenswürdiger Design-Partner ihn testen (Dogfooding) und arbeiten Sie mit diesen Traces.
- Führen Sie eine Baseline aus. Führen Sie Ihren aktuellen Agenten gegen den Datensatz aus und speichern Sie das Ergebnis als Experiment. Ein Experiment enthält die Ergebnisse der Ausführung einer Version Ihres Agenten auf einem Datensatz sowie die Bewertungen Ihrer Evaluatoren. Sie vergleichen die Leistung zukünftiger Versionen Ihres Agenten mit diesem Experiment.
- Fügen Sie neue Fehler hinzu, sobald Sie sie finden. Jeder Fehler, den Sie in der Produktion oder beim Testen sehen, wird zu einem neuen Beispiel.
Fahren Sie fort, Fehler zu Ihrem Datensatz hinzuzufügen, und Sie haben eine Verbesserungsschleife. Finden Sie einen Fehler, fügen Sie ihn Ihrem Datensatz hinzu, verbessern Sie den Agenten und führen Sie alles erneut aus. Wenn Sie weitere Agentenverhaltensweisen identifizieren, die evaluiert werden sollen, erweitern Sie Ihre Eval-Suite nach demselben Muster wie oben.
Was ist der Unterschied zwischen Offline- und Online-Evals?
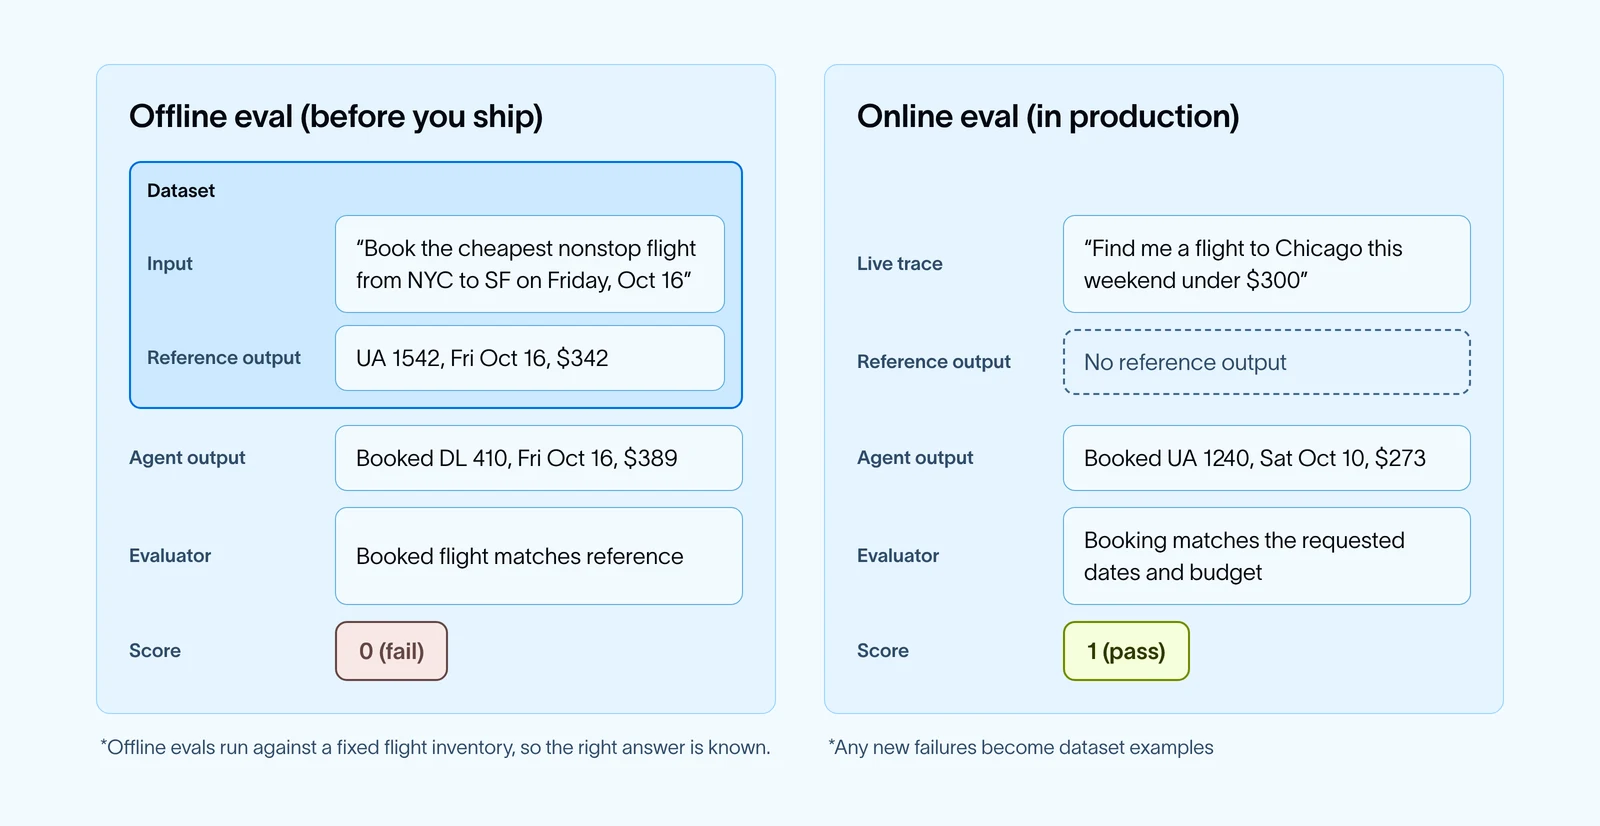
Evals können und sollten ausgeführt werden, bevor Sie eine Änderung ausliefern, und nachdem Ihr Agent live ist. Vor dem Ausliefern können Evals Ihnen sagen, ob eine Änderung den Agenten besser oder schlechter gemacht hat. Nach dem Ausliefern können Evals Ihnen sagen, wie der Agent mit echten Nutzern abschneidet.
Offline-Evals führen Ihren Agenten gegen einen Datensatz aus bevor Sie eine Änderung ausliefern. Sie wählen die Beispieleingaben, und Sie können auch erwartete Ausgaben (auch Referenzausgaben genannt) einbeziehen. Mit Ihrem Datensatz können Sie Experimentsergebnisse über Agentenversionen hinweg vergleichen. Sie eignen sich am besten, um einen neuen Prompt, ein Modell oder ein Tool zu testen und Regressionen abzufangen, bevor sie Nutzer erreichen.
Benchmarks wie Terminal-Bench sind ebenfalls Offline-Evals, aufgebaut auf einer festen Menge von Aufgaben, sodass Sie Agenten, Modelle oder Versionen vergleichen können. Harbor führt sie aus und protokolliert die Ergebnisse in LangSmith-Experimenten, was wir weiter unten genauer behandeln.
Online-Evals bewerten echte Produktionsspuren sobald sie eingehen. Normalerweise gibt es keine Referenzausgabe zum Vergleichen, daher stützen sie sich auf Codeprüfungen und LLM-Richter, die einen Durchlauf eigenständig bewerten können. Sie eignen sich am besten, um die Qualität zu überwachen und die Probleme zu finden, die Ihr Datensatz übersehen hat.
Sie brauchen beides, und beide speisen sich gegenseitig. Fehler, die Online-Evals kennzeichnen, werden zu neuen Beispielen in Ihrem Offline-Datensatz.
Es gibt einige Möglichkeiten, in LangSmith einen Datensatz für Offline-Evals zu erstellen. Sie können Beispiele von Grund auf schreiben, Runs aus Ihren vorhandenen Traces hinzufügen, Runs, die Ihr Team in einer Annotation Queuegeprüft hat, übermitteln, eine CSV- oder JSONL-Datei hochladen oder synthetische Beispiele aus einigen vorhandenen generieren.
Wenn Ihre Eval-Suite wächst, müssen Sie entscheiden, ob Sie Beispiele zu einem bestehenden Datensatz hinzufügen oder einen neuen anlegen. Als Faustregel gilt:
- Behalten Sie Beispiele im gleichen Datensatz wenn sie dasselbe Verhalten mit denselben Evaluatoren testen, damit Experimente über die Zeit vergleichbar bleiben.
- Legen Sie einen neuen Datensatz an, wenn die Eingaben anders aussehen (z. B. einzelne Anfragen im Vergleich zu vollständigen Konversationen), wenn Sie andere Evaluatoren benötigen oder wenn der Datensatz einem anderen Zweck dient, etwa ein kleiner Satz, der bei jedem Pull Request läuft, im Vergleich zu einem größeren, den Sie vor einem Release ausführen.
Innerhalb eines einzelnen Datensatzes können Sie außerdem Splits verwenden, um eine Teilmenge der Beispiele auszuführen.
Welche verschiedenen Typen von Agent-Evaluatoren gibt es?
Ein Evaluator ist die Logik, die einen Lauf bewertet. Es gibt vier häufige Typen. Die meisten Teams beginnen mit ein oder zwei und fügen im Laufe der Zeit weitere hinzu.
- Code-Evaluatoren prüfen Dinge deterministisch, etwa ob der gebuchte Preis unter dem Budget des Nutzers liegt. Sie sind schnell, günstig und konsistent, obwohl ihr Bedarf an deterministischen Eingaben und Ausgaben ihren Nutzen einschränkt.
- LLM-as-a-judge nutzt ein Modell, um Dinge zu bewerten, die Code nicht kann, etwa ob die Antwort des Assistenten die Flugdetails klar bestätigt.
- Menschliche Überprüfung bedeutet, dass Ihr Team oder Fachexperten Läufe direkt bewerten. Es ist langsamer, aber es ist das beste Signal für subjektive Qualität und zur Überprüfung Ihrer anderen Evaluatoren. Es wird oft an einer kleineren Stichprobe eingesetzt, um anschließend das Urteil eines LLM-Evaluators zu informieren.
- Paarweise Evaluatoren vergleichen zwei Ausgaben nebeneinander und wählen die bessere aus, was nützlich ist, wenn Sie zwischen zwei Prompts oder Modellen wählen.
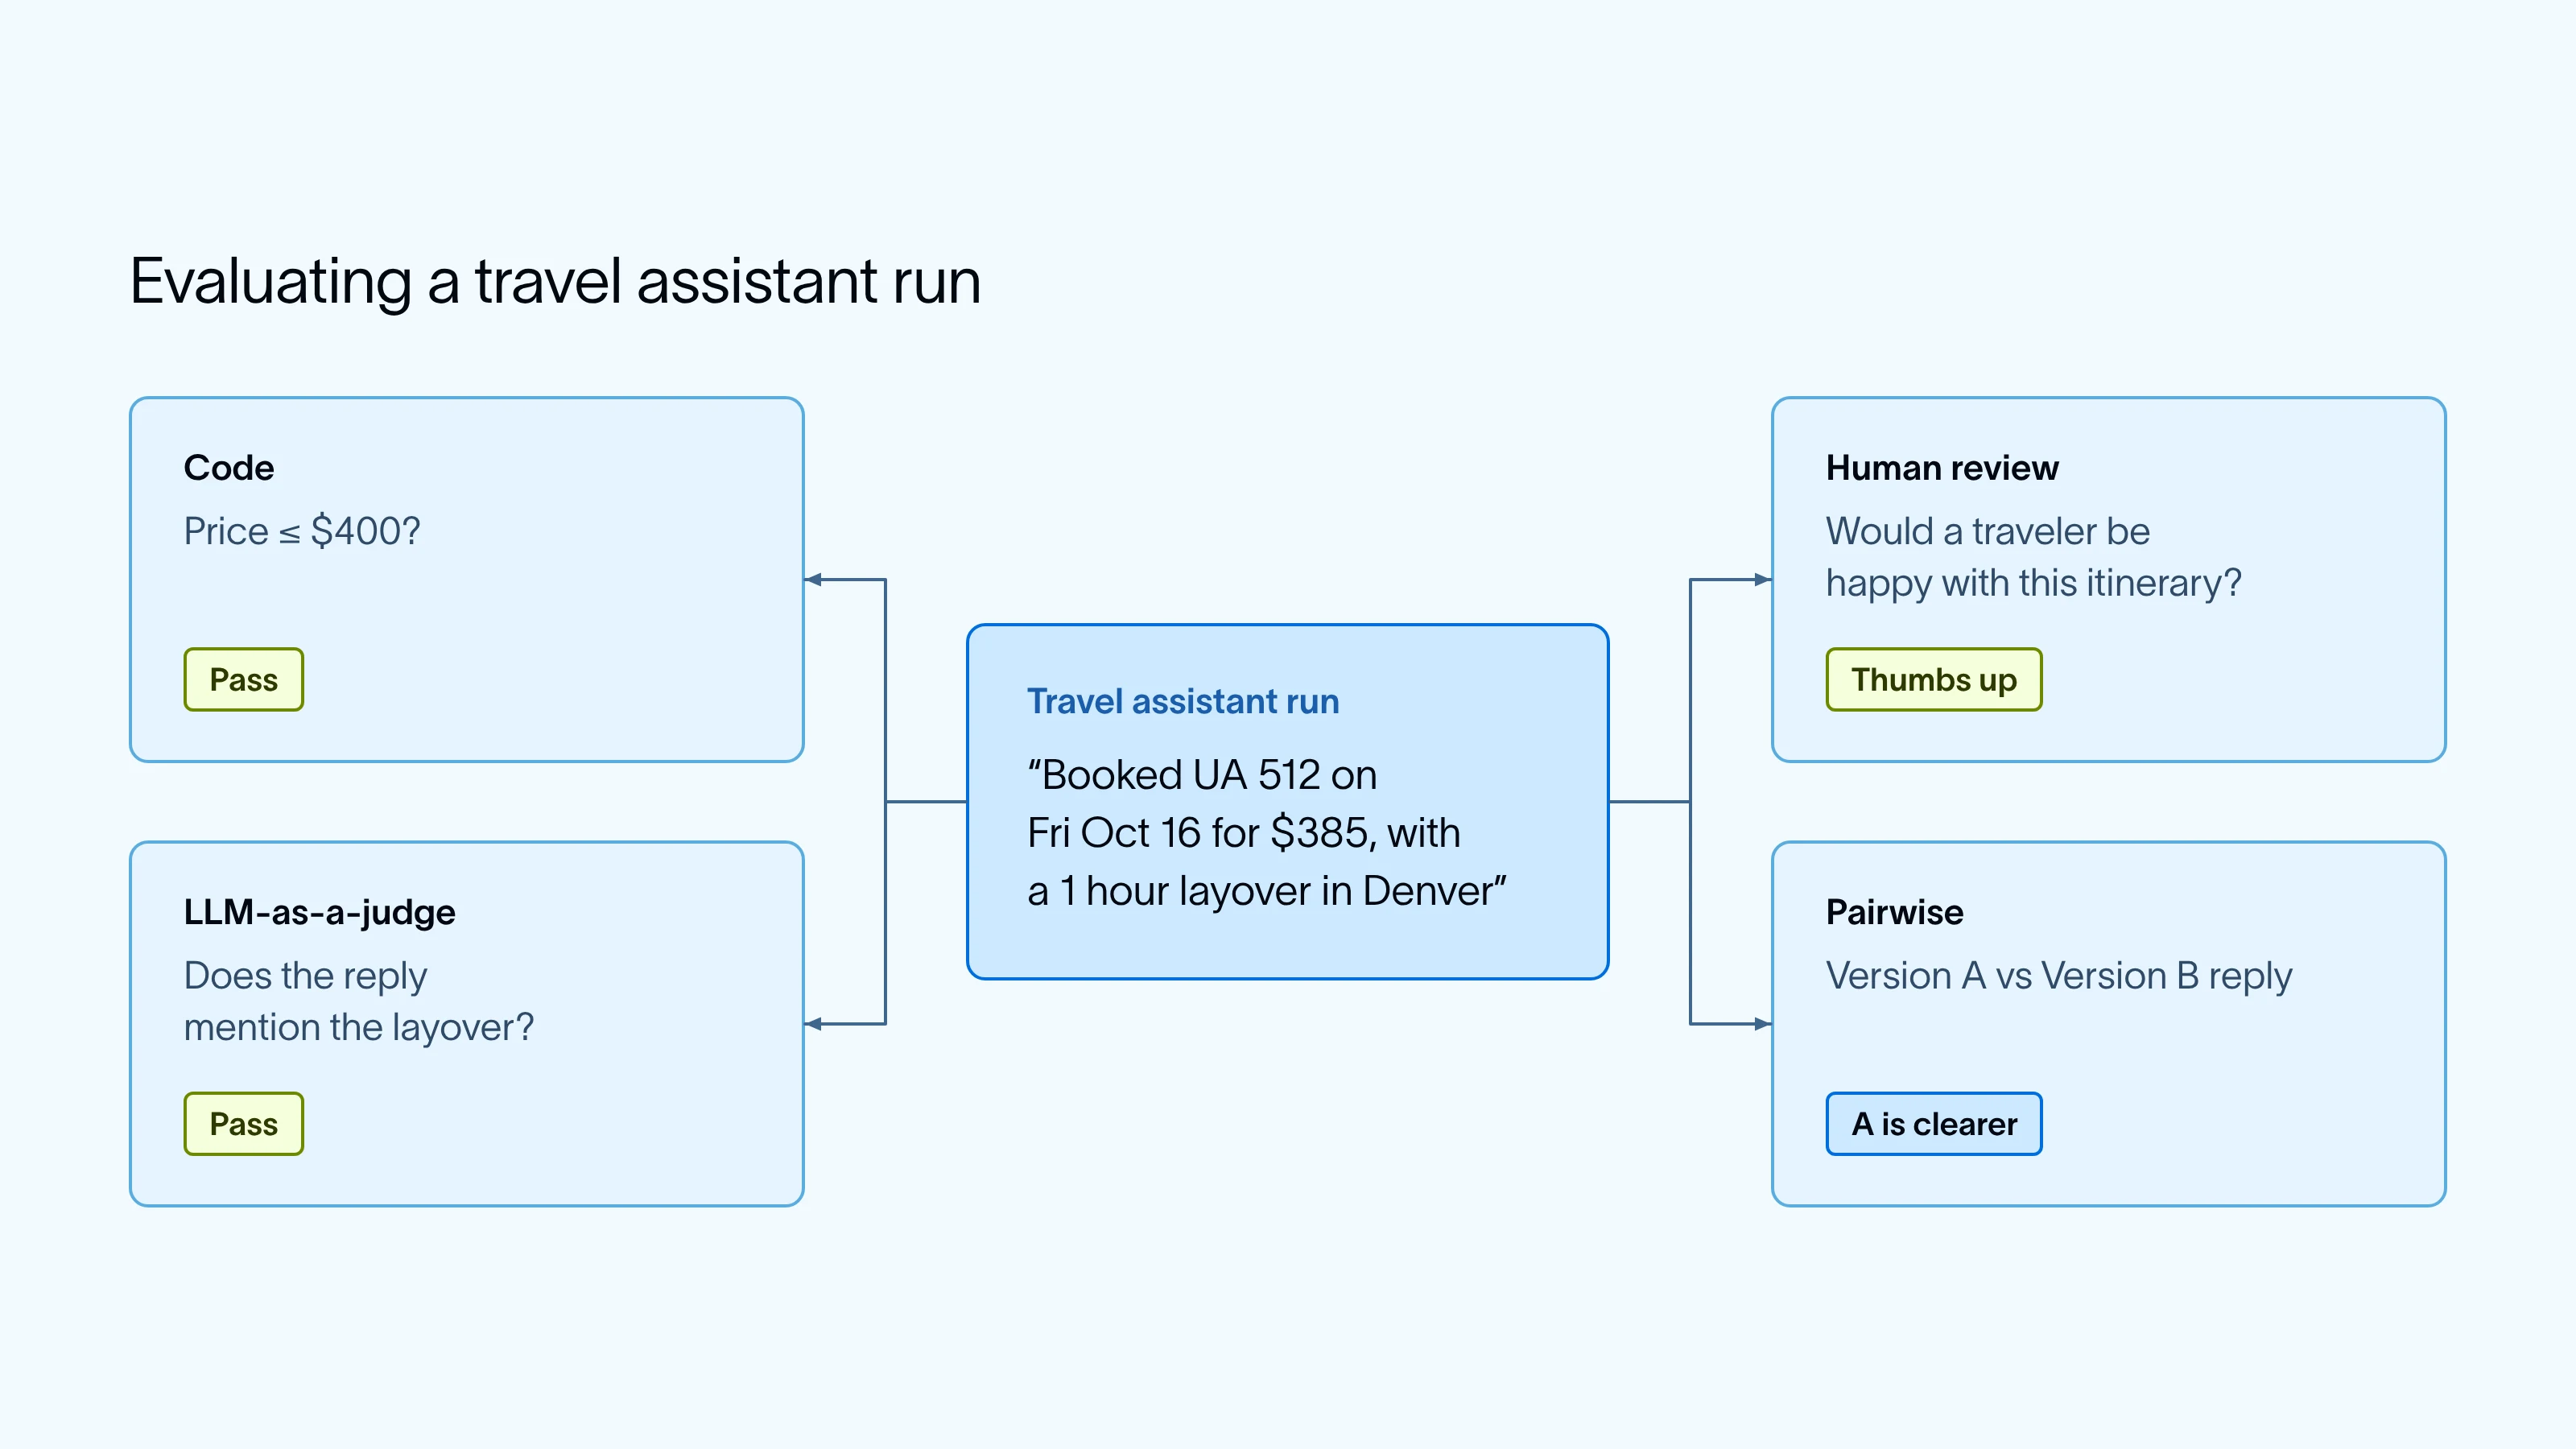
Jeder dieser Evaluatoren kann auf verschiedene Teile des Laufs eines Agenten gerichtet werden. Ein Eval könnte bewerten:
- Einen einzelnen Schritt. Z. B. ob
search_flightsmit dem richtigen Datum aufgerufen wurde. - Die endgültige Antwort. Z. B. ob die Antwort den Flug bestätigt, den der Agent tatsächlich gebucht hat.
- Eine vollständige Konversation. Z. B. ob die endgültige Buchung jede Änderung widerspiegelt, die der Nutzer über mehrere Runden hinweg angefordert hat
- Den Endzustand einer Umgebung. Z. B. die Buchungseinträge in einem simulierten Buchungssystem, nachdem der Agent in seinem eigenen Container läuft. Benchmarks verwenden häufig dieses Setup, und Sie hören diese manchmal als containerized evals bezeichnet.
Kann man einem LLM-Richter vertrauen?
Ein LLM-Richter nutzt ein Modell, um Ausgaben zu bewerten, die sich schwer per Code prüfen lassen, etwa ob eine Antwort durch die abgerufenen Dokumente gestützt wird. Richter sind flexibel, aber sie können inkonsistent sein und von der Einschätzung Ihres Teams abweichen. Einige Gewohnheiten machen sie zuverlässig:
- Vergleichen Sie den Richter mit menschlichen Bewertungen. Lassen Sie jemanden in Ihrem Team eine Stichprobe der Durchläufe bewerten und prüfen, wo der Richter nicht übereinstimmt. Passen Sie den Prompt oder die Beispiele des Richters an, bis sie übereinstimmen. Annotation Queues in LangSmith machen das einfach. Unsere LLM-as-a-judge-Dokumentation führt Sie Schritt für Schritt darin ein.
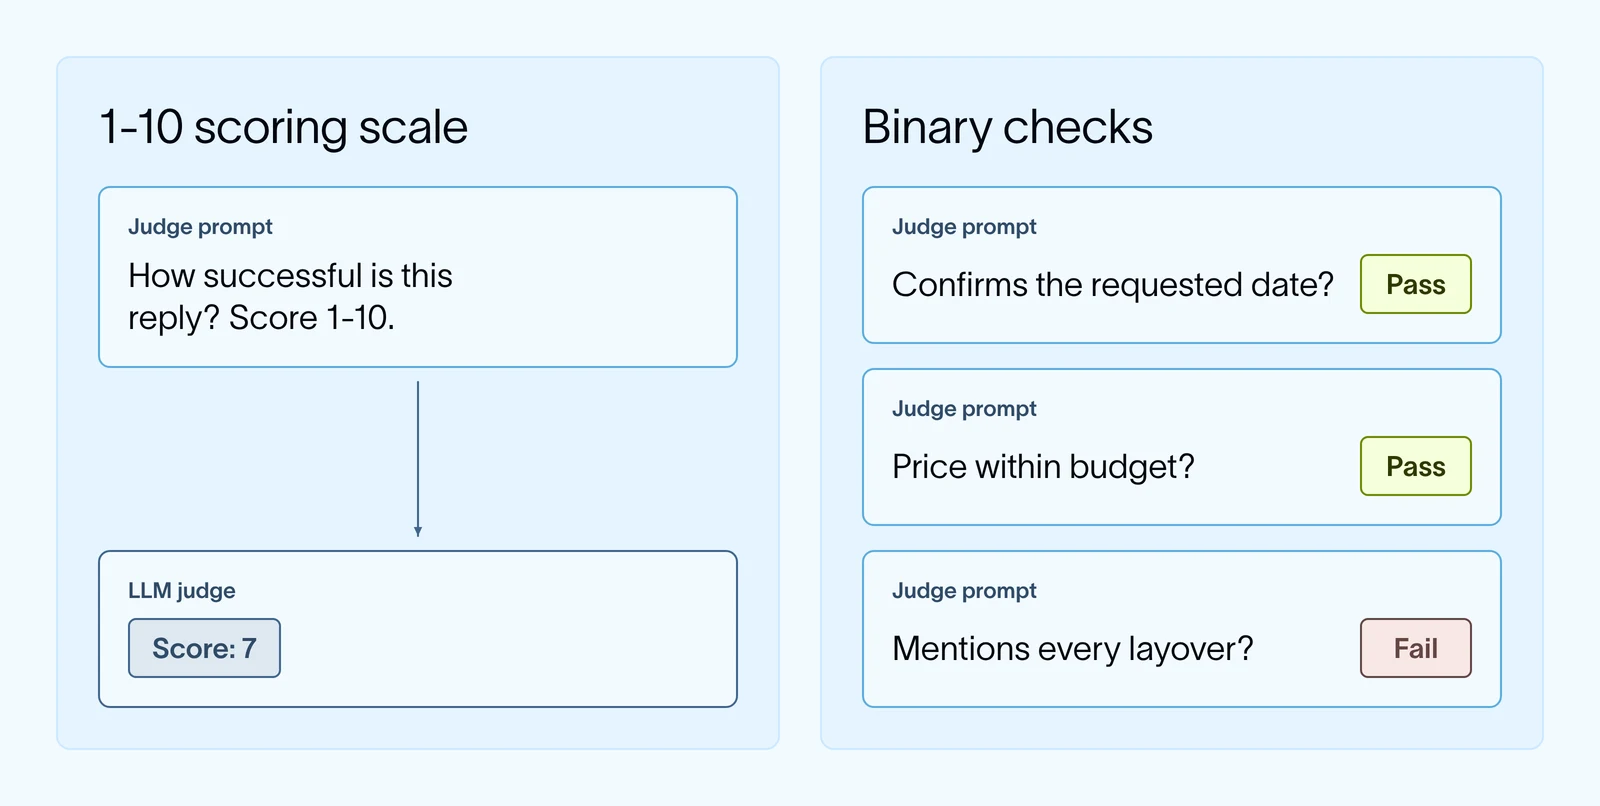
- Stellen Sie enge Fragen. In unserem Reiseagent-Beispiel ist es einfacher zu beurteilen, ob die Antwort jeden Umstieg erwähnt, als ob dies eine gute Antwort ist.
- Definieren Sie eine präzise Bewertungsskala. Ein binäres Bestehen oder Nichtbestehen oder eine kleine Menge beschrifteter Kategorien ist weitaus reproduzierbarer als eine Bewertung auf einer Skala von 1 bis 10. Einem Richter kann es schwerfallen, zwischen einer Bewertung von 6 und 7 zu unterscheiden.
Sind Evals dasselbe wie Benchmarks?
Ein Benchmark ist eine Art Offline-Eval, das aus einer Reihe von Aufgaben besteht. Eine Aufgabe ist ein einzelner Testfall in einem Benchmark, einschließlich Anweisungen, einer Umgebung in einem Container und einem Testskript, das das Ergebnis bewertet. Da Agents immer fähiger werden, ist ein einfacher LLM-Richter oder ein codebasierter Eval oft nicht mehr ausreichend. Agents können inzwischen Code ausführen, Dateien bearbeiten und mit Diensten interagieren. Um dieses mehrstufige Verhalten zu modellieren, richten Benchmarks isolierte Infrastruktur in Containern ein. Dies ermöglicht es Entwicklern, das Verhalten von Agents offline genauso zu testen, wie der Agent in der Produktion arbeiten wird.
Benchmarks unterscheiden sich in mehrfacher Hinsicht von einfacheren LLM-Richtern und codebasierten Evals:
- Aufgaben umfassen mehr Schritte. Um eine einzelne Aufgabe abzuschließen, muss ein Agent möglicherweise Pakete installieren, Dateien bearbeiten und Befehle über Dutzende von Tool-Aufrufen hinweg ausführen.
- Jede Aufgabe verfügt über eine eigene Umgebung. Agents können nun Aktionen in Umgebungen wie einer Sandbox mit einem Code-Repository, Dateien und Tools ausführen. Jede Aufgabe wird mit ihrer eigenen isolierten Umgebung geliefert, in der der Agent arbeitet.
- Die Bewertung prüft, was der Agent getan hat. Ein Testskript überprüft den Zustand der Umgebung nach dem Durchlauf, etwa ob die Tests bestehen oder die richtige Datei existiert. Sie können den Trace weiterhin überprüfen, aber die Bewertung ergibt sich aus den Aktionen, die der Agent ausgeführt hat, und dem Zustand, den er hinterlassen hat.
Für unseren Reiseassistenten könnte eine Benchmark-Aufgabe dem Agenten ein simuliertes Buchungssystem und eine Anfrage wie „Ein Sturm hat den Flug des Reisenden nach Denver annulliert. Buchen Sie ihn um und passen Sie sein Hotel entsprechend an“ geben. Sobald der Agent fertig ist, würde das Testskript die Buchungsdaten in der Datenbank überprüfen.
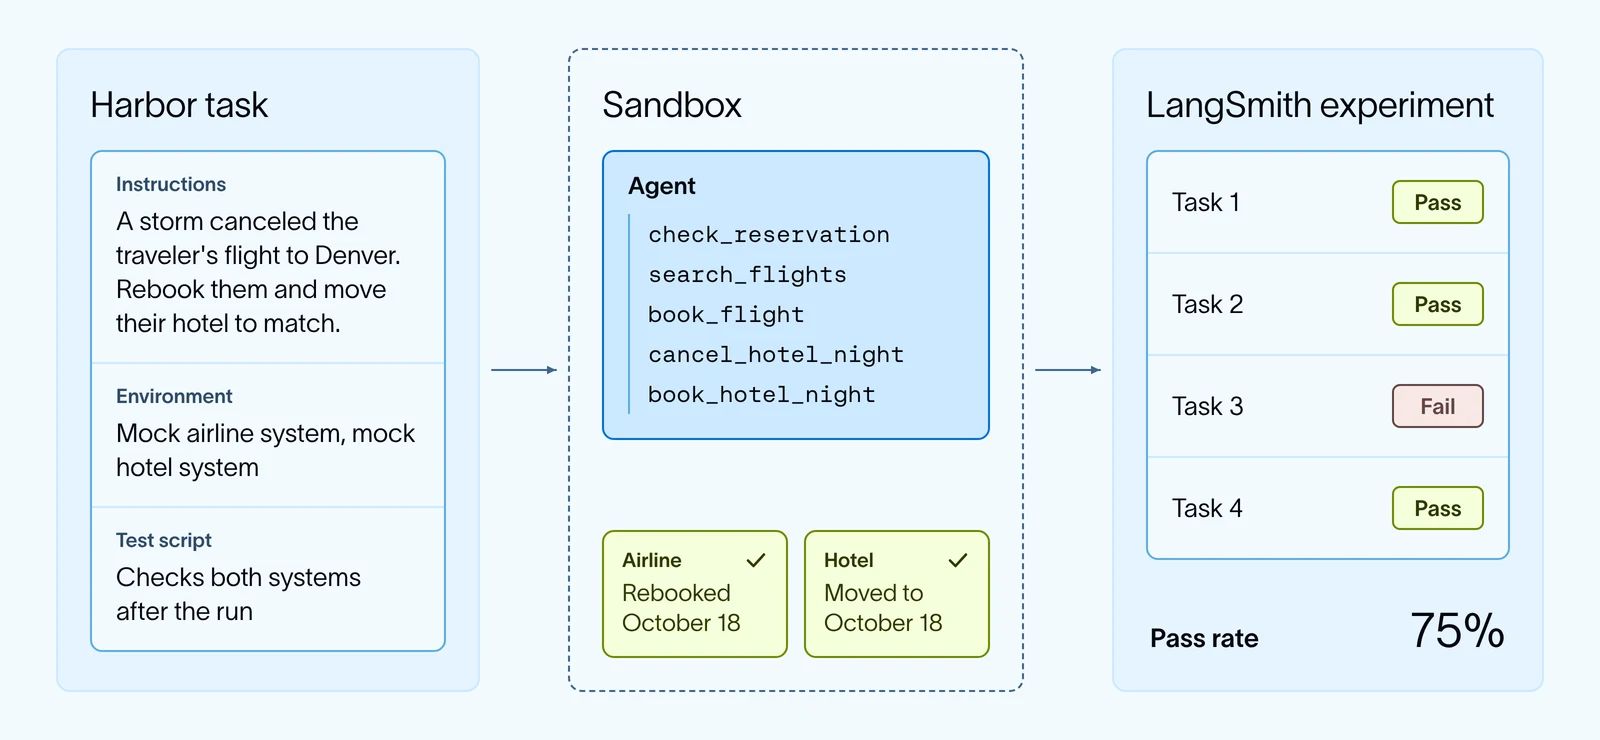
Harbor ist ein Open-Source-Eval-Harness, der das Grundgerüst für Tests bei diesen längeren Aufgaben bereitstellt. Es ist das Framework, das Terminal-Bench antreibt, und Sie können dasselbe Aufgabenformat verwenden, um einen Benchmark für Ihren eigenen Agenten zu erstellen. Mit der LangSmith-Integration wird jeder Harbor-Lauf als LangSmith-Experiment protokolliert. Harbor erstellt einen Container für jede Aufgabe, und Sie können LangSmith-Traces verwenden, um jede Umgebung näher an das heranzuführen, was Ihr Agent in der Produktion sieht. Benchmark-Ergebnisse liegen dann neben Ihren übrigen Evals, und Sie können jeden Lauf öffnen, um den vollständigen Trace neben seinem Score zu sehen.
Wir haben dieses Setup verwendet, um Deep Agents auf Terminal-Bench 2.0 zu verbessern indem wir Traces überprüften, um Fehlermuster zu finden, und dann den Harness änderten. Wir nutzten es auch, um IssueBenchzu erstellen, einen Benchmark für LangSmith Engine. Jede IssueBench-Aufgabe gibt Engine einen Stapel von Traces und bewertet, ob es die richtigen davon in die richtigen Issue-Cluster gruppiert.
Der Aufbau eines Benchmarks für Ihren eigenen Agenten folgt denselben Schritten wie die Evals oben, mit wenigen Änderungen:
- Aufgaben aus Traces sammeln. Finden Sie Fehler in LangSmith-Traces und machen Sie dann aus jedem einzelnen eine Harbor-Aufgabe mit eigener Umgebung, etwa einem simulierten Buchungssystem, das mit den Reservierungen eines Nutzers gefüllt ist.
- Definieren Sie, was „gut“ bedeutet. Erstellen Sie LLM-Judges oder codebasierte Evals, die anhand Ihrer Rubrik bewerten.
- Hill Climbing auf dem Score. Führen Sie den Agenten aus und nutzen Sie die Scores für A/B-Tests von Änderungen. Sie können eine Agentenschleife einrichten, die diesen Prozess für Sie durchläuft. Sie würde Änderungen an Ihrem Agenten vornehmen, den Benchmark erneut ausführen und jede Änderung beibehalten oder zurücksetzen, ähnlich wie Andrej Karpathys autoresearch -Schleife von vor ein paar Monaten.
Wie können Sie Produktionsverkehr ohne hohe Kosten bewerten?
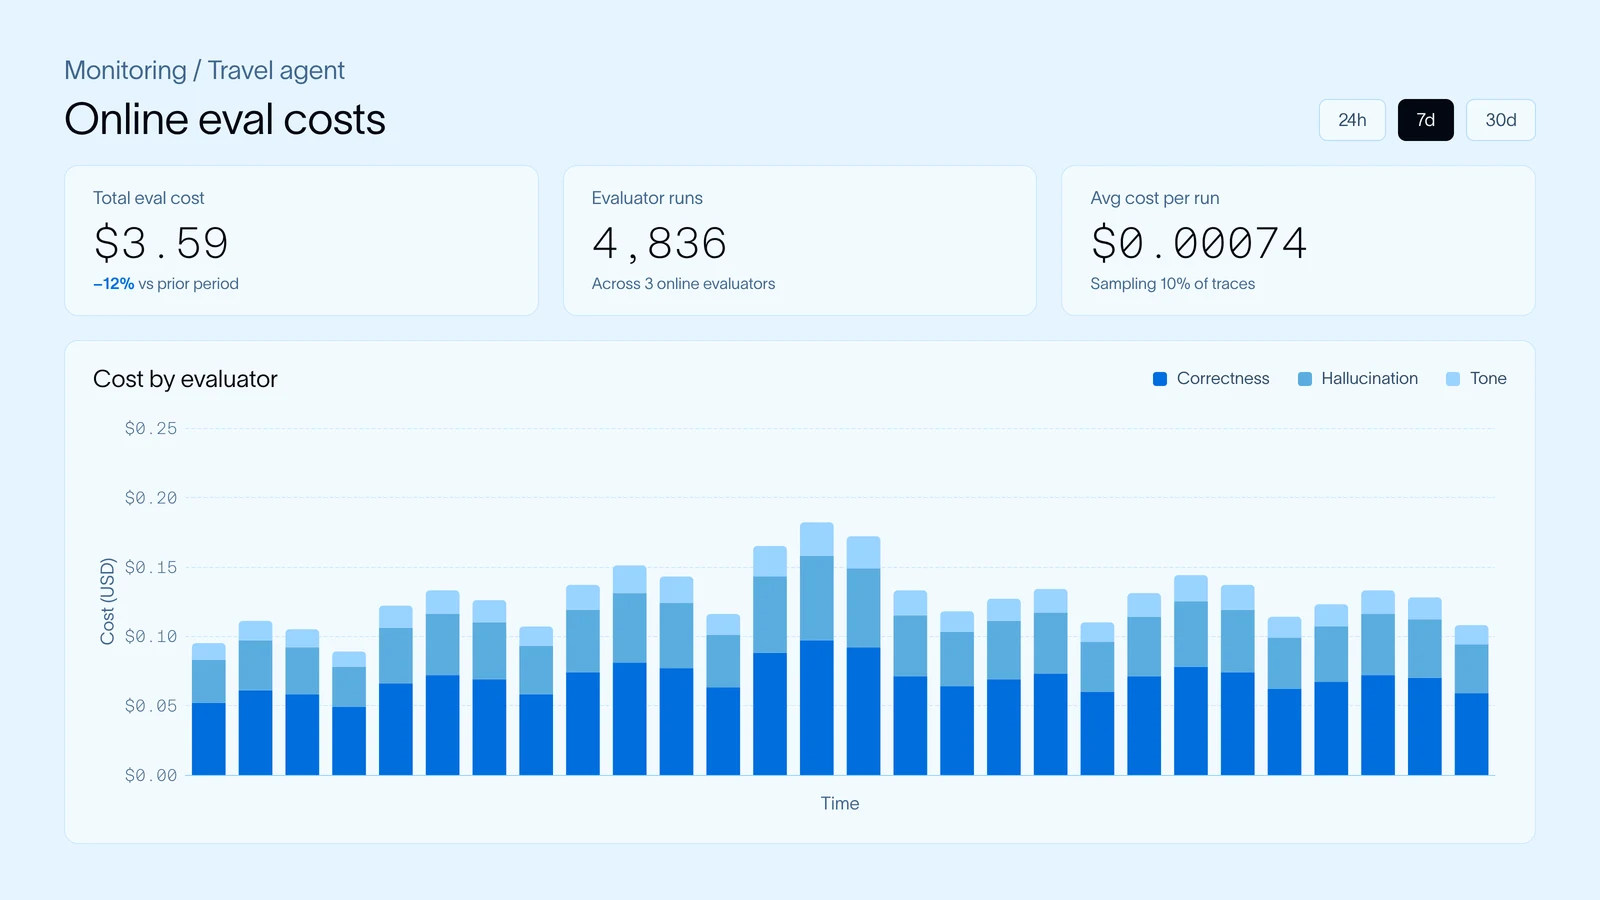
Offline-Evals laufen auf einem festen Datensatz, daher sind ihre Kosten vorhersehbar. Online-Evals laufen auf Live-Traffic, also steigen Ihre Eval-Kosten mit jedem neuen Nutzer, wenn ein LLM-Judge jeden Trace bewertet. Um sie erschwinglich zu halten:
- Stichproben ziehen und filtern. Online evaluators in LangSmith können einen Prozentsatz des Traffics bewerten oder nur Traces, die einem Filter entsprechen, wie negativem Nutzerfeedback.
- Verwenden Sie Code-Prüfungen, wo möglich. Zu prüfen, ob die Buchung zum angeforderten Datum passt oder ob der Agent vor der Buchung gesucht hat, kostet fast nichts.
- Verwenden Sie einen günstigeren Judge. In unserem Jev-as-a-Judge -Experiment stimmte Jev von TypeSafe AI bei jeder Pass/Fail-Entscheidung mit den menschlichen Labels überein und kostete insgesamt $0.34, verglichen mit $28.17 für Claude Sonnet 4.6.
Die Kosten von Online-Evals werden in LangSmith über die Zeit gespeichert, damit Teams ihre Ausgaben überwachen können.
Müssen Sie Ihre eigenen Agent-Evals erstellen?
Nein, besonders wenn Sie auf häufige Agent-Probleme evaluieren. Ein guter Ausgangspunkt sind unsere vorgefertigten LLM-Evaluator-Vorlagen in LangSmith für typische Prüfungen wie Halluzinationen oder das Austreten personenbezogener Daten (PII). Fügen Sie einen zu einem Datensatz- oder Tracing-Projekt hinzu und passen Sie seinen Prompt an Ihren Agenten an, etwa indem Sie dem Judge mitteilen, dass unser Reiseassistent niemals außerhalb des Budgets des Nutzers buchen darf.
Unser Open-Source- agentevals -Paket enthält außerdem vorgefertigte Evaluatoren für die Nachrichten und Tool-Aufrufe eines Agenten. Sie können die von Ihrem Agenten aufgerufenen Tools mit einer Referenzliste vergleichen oder einen LLM-Judge fragen, ob die Schritte sinnvoll waren.
Sie können einen Offline-Evaluator auch datensatzübergreifend wiederverwenden und als Online-Evaluator für Produktions-Traces ausführen (das funktioniert nur, wenn der Evaluator keine Referenzausgabe benötigt).
Für evals, die speziell auf Ihren Agenten zugeschnitten sind, wird der Eval Engineering Skill in Coding-Agenten wie Claude Code oder Codex ausgeführt, liest Ihr Repository und Ihre Traces und erstellt gemeinsam mit Ihnen lauffähige Evals.
LangSmith Engine kann Evals auch automatisch für Sie schreiben, indem es Produktions-Traces heranzieht. Wenn es eine Problem-Cluster-Gruppe identifiziert, verwandelt es die fehlerhaften Traces in Datensatz-Beispiele und schreibt deren Referenzausgaben als Assertions, wie zum Beispiel „Bucht einen Flug zum vom Nutzer angefragten Datum.“
Wie evaluiert man Konversationen mit mehreren Runden?
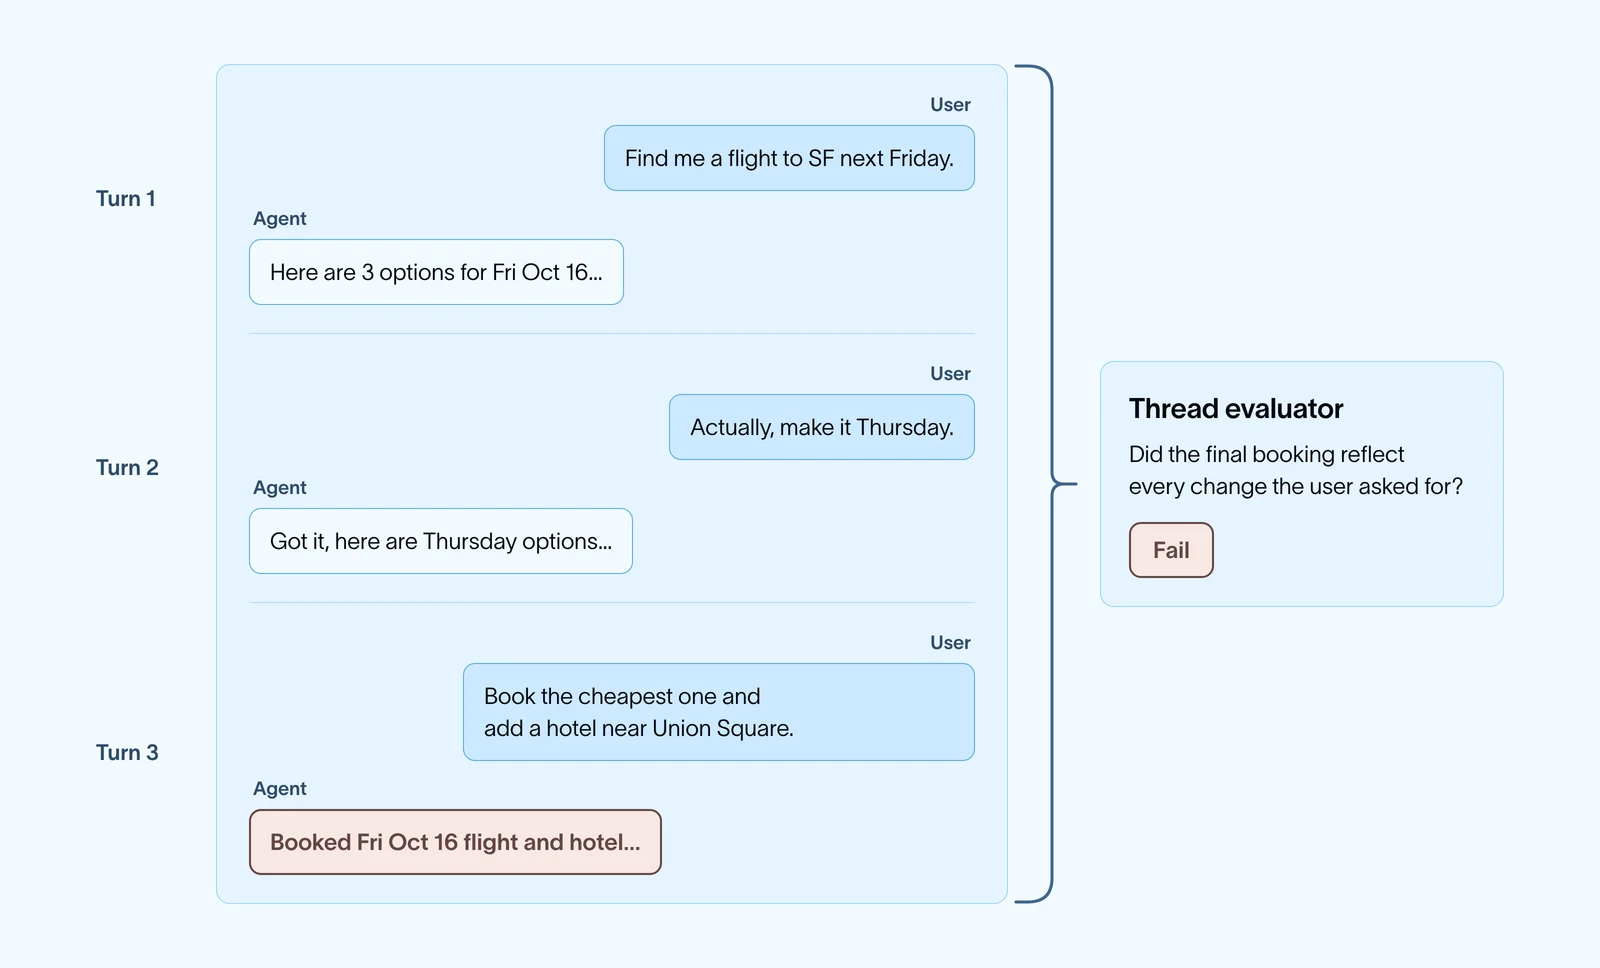
Viele Agenten arbeiten über mehrere Runden hinweg. Beispielsweise könnte ein Nutzer unseren Reiseassistenten nach Flügen fragen, das Datum ändern und dann ein Hotel hinzufügen. Jede einzelne Runde kann für sich genommen in Ordnung aussehen, während die Konversation als Ganzes schiefgeht.
Um Konversationen in LangSmith auszuwerten, übergeben Sie eine Thread-ID in Ihren Trace-Metadaten, sodass jeder Zug in einen Threadgruppiert wird. Ein Thread ist eine Sequenz von Traces aus derselben Konversation. Von dort können Sie Online-Evaluatoren anhängen, die einen gesamten Thread bewerten, sobald die Konversation endet, mit Fragen wie "Spiegelte die endgültige Buchung jede Änderung wider, die der Benutzer angefordert hat?" oder "Musste der Benutzer sich wiederholen?" LangSmith zeigt jeden Thread auch als Trajektoriean, mit jeder Nachricht und jedem Tool-Aufruf genau einmal, in der richtigen Reihenfolge aufgeführt.
Für Offline-Evals können Sie vollständige Konversationen als Beispiele in einem Dataset speichern oder den Benutzer mit einem LLM simulieren, sodass Sie testen können, wie der Agent eine Konversation von Anfang bis Ende handhabt.
Wie evaluieren Sie einen Agenten über seine endgültige Ausgabe hinaus?
Agenten führen viele Schritte aus, daher zeigt die endgültige Antwort nur einen Teil dessen, was passiert ist. Über die endgültige Antwort hinaus möchten Sie möglicherweise Folgendes prüfen:
- Den Pfad, also die Sequenz von Nachrichten und Tool-Aufrufen, die der Agent erzeugt hat.
- Den endgültigen Zustand, wie etwa den Buchungsdatensatz, den unser Reiseagent erstellt hat, eine Datei, die er geschrieben hat, oder eine Änderung, die er an einem Repository vorgenommen hat.
Da Ihre Produktionsagenten zunehmend komplexer werden, benötigen Sie möglicherweise eine dedizierte Eval-Infrastruktur. Insbesondere, wenn die Arbeit des Agenten die Änderung ist, die er an einer Umgebung vornimmt. Angenommen, ein Coding-Agent wird gebeten, einen Fehler zu beheben. Ein LLM-Richter kann die Antwort des Agenten lesen, aber die zuverlässige Prüfung besteht darin, die Tests des Repositorys auszuführen, nachdem der Agent fertig ist. Damit das funktioniert, braucht jeder Testlauf seine eigene saubere Kopie des Repositorys, damit sich die Läufe nicht gegenseitig beeinflussen. Harbor richtet das für Sie ein. Sie können Agenten, die mit Deep Agents gebaut wurden, in LangSmith Sandboxes ausführen und jeden Lauf zusammen mit seinem Trace in einem LangSmith-Experiment protokollieren. Erfahren Sie mehr in Harbor x LangChain.
Können Sie einen Agenten in LangSmith tracen und evaluieren, wenn er nicht mit LangChain, LangGraph oder Deep Agents gebaut wurde?
Ja! LangSmith ist framework-agnostisch, sodass Sie einen Agenten tracen und evaluieren können, der mit einem beliebigen Framework oder ganz ohne Framework gebaut wurde. Es gibt mehrere Möglichkeiten, Traces zu senden:
- Framework-Integrationen. LangSmith hat Integrationen für beliebte Agenten-Frameworks wie das OpenAI Agents SDK, Claude Agent SDKund mehr.
- Modell-Provider-Wrapper. Wenn Sie einen Modell-Provider direkt aufrufen, umhüllen Sie den Client für OpenAI oder Anthropic und jeder Modellaufruf wird nachverfolgt.
- Der
@traceableDecorator. Fügen Sie ihn Ihren eigenen Funktionen hinzu, etwa dem Flug-Such-Tool des Reiseassistenten, um jeden Schritt Ihres Agenten nachzuverfolgen.
Sobald Ihre Traces in LangSmith sind, funktionieren Evals auf die gleiche Weise für jedes Framework. Sie können Traces zu einem Dataset hinzufügen, Offline-Experimente ausführen, indem Sie Ihren Agenten an die SDK-Funktion evaluate() übergeben, und Online-Evaluatoren an Produktionsverkehr anhängen.
Wie wechseln Sie von einem bestehenden Eval-Stack weg?
Sie müssen nicht von vorne anfangen. Das meiste, was Sie bereits aufgebaut haben, lässt sich auf LangSmith übertragen:
- Datasets. Laden Sie bestehende Testfälle als CSV- oder JSONL-Datei hoch oder erstellen Sie sie mit dem SDK.
- Code-Evaluatoren. Bestehende Bewertungsfunktionen brauchen meist nur kleine Änderungen, um als LangSmith-Evaluatoren zu laufen. Wenn Ihre Evals bereits als Tests laufen, ermöglichen Ihnen die pytest- und Vitest-Integrationen dieses Setup beizubehalten.
- LLM-Richter. Fügen Sie Ihren bestehenden Judge-Prompt als LLM-as-a-judge-Evaluator in die UI ein oder behalten Sie ihn im Code.
- Tracing. LangSmith funktioniert mit jedem Framework, sodass Sie Traces von Ihrem aktuellen Agenten senden können, ohne ihn umzuschreiben.
Wie berichten Sie Ergebnisse?
Offline-Experimente zeigen, ob jede Veröffentlichung eine Verbesserung gebracht hat. Online-Eval-Dashboards zeigen, wie sich die Leistung in der Produktion über die Zeit hält. In LangSmith können Sie Experimentsergebnisse direkt vergleichen und benutzerdefinierte Dashboards für Metriken wie Token-Kosten, Latenz und Evaluator-Werte über die Zeit erstellen. Ein Benchmark liefert Ihnen einen stabilen Wert, um Modelle oder Agentenversionen über Veröffentlichungen hinweg zu vergleichen.
Weiter
Wenn Sie tiefer einsteigen möchten, lesen Sie How We Build Evals for Deep Agents, probieren Sie das LangSmith evaluation quickstartaus oder schauen Sie sich unseren LangChain Academy Kurs zu LangSmith Essentials.
an. Prefer a live instructor? Ich werde am 28. Oktober 2026 einen virtuellen Workshop zu Agent Evals veranstalten. Registrieren Sie sich hier!