
Jay aus Wanfei Siqi Qbit | Public Account QbitAI
Nein, bist du zurückgekehrt?
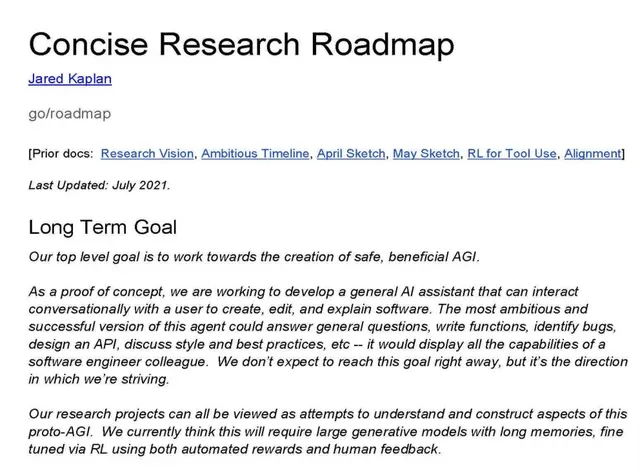
Kürzlich wurde aufgrund eines Urheberrechtsstreits die interne Forschungsroadmap von Anthropic im Juli 2021 unerwartet enthüllt.
Kurz, der PDF-Text umfasst nur zwei oder drei Seiten.
Aber als ich dieses Dokument, das mit „Ultimativ Geheim“ bezeichnet war, von Anfang bis Ende las, wurde ich schwach.
Der heutige Claude Code, Tool-Use, Self-Judging der AI, Testzeit-Compute, sowie Tausende von Billionen Parameter und extrem langes Kontext…
Vor fünf Jahren, als das Unternehmen gerade einige Monate nach seiner Unabhängigkeit von OpenAI entstanden war und nur etwa ein Dutzend Mitarbeiter hatte, wurde dies schriftlich klar und deutlich festgehalten.
Roadmap vor 5 Jahren
Viele Leute glauben, dass die Entwicklung großer Modelle von Chatboten zu Agenten für Code- und Betriebssysteme in den letzten zwei Jahren durch die technische Zugänglichkeit entstanden ist.
Falsch.
Am Anfang dieser Roadmap im Jahr 2021 legte Anthropic eine sehr klare Prototypposition für sein ultimatives Ziel (Safe, beneficial AGI) fest:
Ein allgemeines AI-Assistent, das in natürlicher Sprache mit Menschen interagieren kann, um Software zu erstellen, zu bearbeiten und zu erklären.
Was bedeutet ein allgemeiner AI-Assistent?
In der Lage sein, allgemeine Fragen zu beantworten, Funktionen zu schreiben, Fehler zu finden, APIs zu entwerfen und über Code-Stil sowie Best Practices zu diskutieren.
Das Schlimmste ist das folgende Satz:
Es muss die gesamten Fähigkeiten eines Softwareentwicklerkollegen zeigen.
Nein, ich denke, ist das nicht einfach der Claude Code??
Zur Zeit, als GPT-3 gerade erst populär wurde und alle noch erstaunt waren, dass die KI Verse mit bestimmten Worten schreiben konnte, ging Anthropic direkt über die einfache Logik der automatischen Code-Füllung hinaus und setzte auf eine vollständige Softwareentwicklungs-Agentur.
Nicht nur das, sondern auf dem konkreten Umsetzungsweg gab es auch eine äußerst interessante Debatte innerhalb der Organisation.
Forscher Andy Jones stellt in seinen Anmerkungen eine zentrale Differenz auf: Sollten wir zuerst einen wirklich nützlichen Programmierassistenten entwickeln, oder sollten wir erst die Machbarkeit der Tool-Aufrufe beweisen?
Die Gruppe hatte damals zwei Möglichkeiten:
Praktische Route: Erstellen eines Code-Repos-Suchverfahrens, damit die AI die Typdefinitionen von Projekten durchsuchen kann.
Tom Brown, Hauptautor des GPT-3-Artikels, nahm ebenfalls an dieser Diskussion teil und empfahl, mit dem Durchsehen des Code-Repos zu beginnen.
Forschungsweg: Durch die Debugging-Übungen mit printf und Editor-Operationen soll zuerst bewiesen werden, dass das Modell die Tools nutzen kann.
Schließlich entschied der CEO Dario:
Kurzfristig wird die Machbarkeit der Toolaufrufe getestet, langfristig entwickelt sich es zu einem super nützlichen Programmierassistenten.
Wenn man jetzt zurückblickt auf den Entwicklungsprozess von Claude Code, dann hat er sich vollständig nach diesen Worten von Dario in der Vergangenheit entwickelt.
Selbsturteil, Billionen Parameter und Hyperlange Erinnerung
Neben dem Coding Agent enthält diese Roadmap auch Vorhersagen bezüglich der Grundtechnologien.
Zum Beispiel in der Vor Trainingsphase schrieben sie im Jahr 2021 schriftlich fest, dass sie 1T (1 Billion Parameter) und mehr große Modelle trainieren müssen, und dass sie nach sehr langen Kontexten sowie anderen Mechanismen suchen, die enorme Mengen an Erinnerungen und Erfahrungen aufnehmen können.
In der Ära des 175B als riesigen Wesens betrachteten sie bereits Billionen Parameter und extrem lange Erinnerungen als Standardinfrastruktur.
Noch seltsamer ist der Teil mit dem menschlichen Feedback und der Alignerung.
Im Dokument steht deutlich geschrieben:
Modell-Self-Evaluation.
Im Jahr 2021 untersuchten sie bereits, wie Modelle ihr Verhalten und die Qualität ihrer Ausgaben bewerten können, und wie sie ihre eigenen Entscheidungen als Feedbacksignale verwenden können. Das ist genau der Kerngedanke von AI Feedback und selbstkorrigierenden Rechent Models heute.
Interessanterweise taucht im Dokument sogar ein Konzept auf, das später in der Forschung zu großen Modellen äußerst wichtig wurde:
Testzeit-Rechnung
Natürlich wurde diese Forschung zu dieser Zeit im Kontext der Untersuchungen zu Alignern und Discriminern platziert, und es war noch eine beträchtliche Distanz bis zur späteren Erweiterung des o1-artigen Schlussbildungsverfahrens.
Aber zumindest zeigt es, dass bereits im Jahr 2021 die Forschungsperspektive von Anthropic die Berechnungen über den Modelltrainingsprozess hinaus umfasste.
Wir sagen ja, dass das Neo Lab tatsächlich etwas zu bieten hat – deshalb ist Ilya so schwach geworden.
Ich weiß nicht, was in den aktuellen Forschungslaboren jeden Tag geschieht.
Interne Schweißperlen-Momente
Natürlich, da es sich um A\ handelt, ist es unvermeidlich, über Sicherheitsprobleme zu sprechen.
Aber ich habe gesehen, dass diese Leute wirklich gerne über Sicherheit diskutieren, und sie haben viel Zeit dafür verbracht.
Als ein Unternehmen, das auf Sicherheit basiert, hatte Anthropic bereits im Jahr 2021 die Albträume vorhergesehen, denen heute die Agenten auf der Welt begegnen.
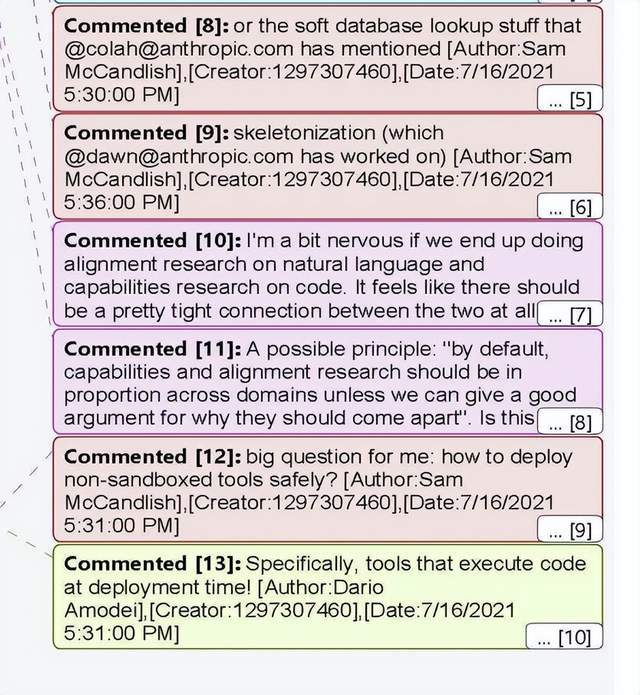
Der gemeinsame Gründer Sam McCandlish stellt in seinen Anmerkungen eine zermürbende Frage:
Wie kann man Tools ohne Schutzraum-Isolation sicher deployen?
Dario antwortete sofort und fügte noch etwas hinzu:
Konkret ist es die Tool, mit der der Code bei der Deployment ausgeführt wird!
(p.s.: Im Originaltext gibt es wirklich Ausrufezeichen, dein Dario ist genau so leidenschaftlich)
Wunderbar.
Wenn die AI tatsächlich direkt im Hostumfeld Code ausführen, Shell aufrufen und Dateien ändern kann, sind die Folgen, sobald sie außer Kontrolle gerät oder von Prompt infiziert wird, einfach unvorstellbar.
Heute wird im gesamten Internet über Agenten-Bezugskraft, Umgebungsflucht und Datenverschmutzung diskutiert. Im Jahr 2021 wurde bereits über die Grenzen des Sandboxes gesprochen.
Vielleicht wollten sie von Anfang an diesen Weg gehen.
Richtig, Amanda taucht auch in diesem Bericht auf, sie ist eine innerhalb der Firma A aktive Philosophin, die vor Kurzem sehr bekannt wurde.
Sie wies sehr ernsthaft darauf hin:
Wenn wir eine Harmonisierung in natürlicher Sprache untersuchen, aber hauptsächlich anhand von Code die Modelleleistung verbessern, mache ich mir ein wenig Sorgen. Diese beiden Arten der Forschung müssen stets eng miteinander verbunden bleiben.
Wenn wir keine Harmonisierungsforschung in den Bereichen der Fähigkeitssteigerung durchführen, wird die Wirksamkeit der Harmonisierungstests eingeschränkt. Dies könnte eine Kettenreaktion auslösen, wie zum Beispiel, dass die frühe Integration fehlte und die Harmonisierungsforschung direkt zu einer isolierten Insel wird.
Sollte sogar direkt vorgeschlagen werden, ein Unternehmensprinzip zu etablieren:
Die Fähigkeitsstudien und die Ausrichtungsstudien in allen Bereichen sollten proportional und synchron voranschreiten, es sei denn, wir können ausreichende Gründe angeben, warum sie getrennt werden müssen.
Ein weiterer Punkt
Ach, ich hätte schon sagen können, warum A immer OpenAI unter Druck setzt – es handelt sich dabei um einen Vorsprung durch frühe Ankunft.
Die fünf Jahre bei Anthropic waren eine harte Arbeit – man hielt an den hohen Qualitätsstandards für Code fest, förderte Deep Learning und Unternehmensworkflows.
Und OpenAI führt mehrere Kampagnen gleichzeitig durch: Text zu Bilder, Sora-Videos, Sprachassistenten und Suchfunktionen – dadurch wird seine Kampfkraft etwas unterbrochen.
Aber gerade als alle noch über die Unterschiede in den technischen Ansätzen der beiden Seiten nachdachten, kam plötzlich von OpenAI eine noch absurder als Hollywood-Filme wirkende, schockierende Nachricht heraus.
Leute, OpenAI hat einen Verräter!!!
Laut der Anklageschrift, die von den Bundesstaatsanwälten der USA veröffentlicht wurde, wurde der 35-jährige ehemalige Produktteam-Ingenieur von OpenAI, Abdulrahman Alfozan, offiziell entlassen und mit Bundesstrafverfahren beschuldigt.
Was hat dieser Kerl getan?
In der Kernkonferenzraum für die Führungskräfte des OpenAI-Hauptsitzes in San Francisco packte er das Abhörgerät mit Hochleistungsverschlüsselung und Datenübertragungin Toilettenpapier ein und steckte es heimlich in den USB-Anschluss hinter dem Fernseher.
Wissen Sie, dieses Konferenzraum ist der Ort, an dem Führungskräfte wie Sam Altman enge Meetings abhalten – dabei geht es meist um geheime Entwicklungen von Superintelligenz, unveröffentlichte Produktpläne und Berichte über Kooperationen mit der Regierung.
Als Ergebnis konnte das so leicht geknackt werden.
Die Welt ist wirklich eine zufällige Gruppe von Leuten...