
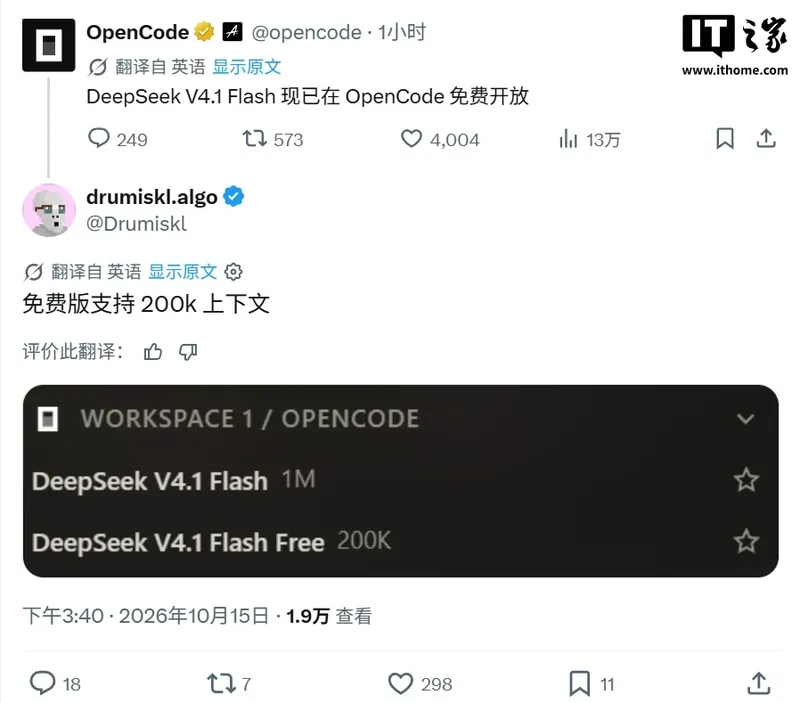
IT之家 Bericht vom 15. Oktober: OpenCode hat kürzlich bekanntgegeben, dass die DeepSeek V4.1 Flash-Version nun kostenlos verfügbar ist. Die kostenlose Version unterstützt eine 200K-Kontextfenster-Größe, was im Vergleich zur 1M-Kontextversion weniger ist.
Die kostenlose Verfügbarkeit erfolgt auf der Grundlage des zuvor laufenden Projekts „Operation Cheepseek“. Im September dieses Jahres erhöhte OpenCode die Nutzungskapazität von DeepSeek V4.1 Flash im OpenCode Go-Paket vorübergehend von 15 US-Dollar auf 60 US-Dollar, und am 12. Oktober wurde diese Kapazität auf 80 US-Dollar angepasst. Nach der kostenlosen Verfügbarkeit werden die Aufrufe dieses Modells auf der OpenCode-Plattform nicht mehr zur Kapazitätsverbrauchung gezählt.
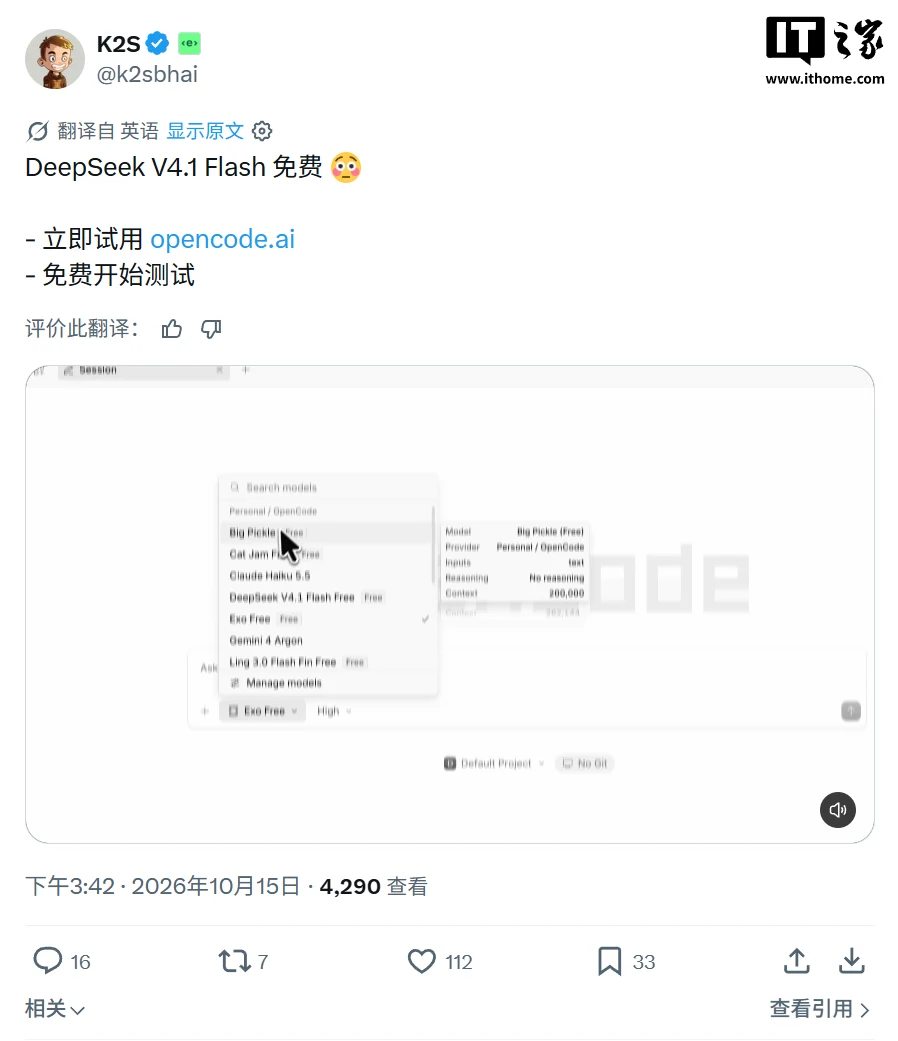
DeepSeek V4.1 Flash wurde am 10. September 2026 offiziell veröffentlicht. Es ist ein nativer Multimodales MoE-Modell mit einem Hauptparametermaß von 552B und 196B Engram-Bedingungsmembranparametern. IT Home hat festgestellt, dass seine Architektur einen Kausal-Encoder-Decoder-Design verwendet: Die ersten 20 Schichten der 40-Schichtigen Sprach-Hauptschicht sind Kausal-Encoders und die letzten 20 Schichten sind Decoders, wodurch die Berechnungsmenge durch Prefill fast halbiert wird. Auf der offiziellen Plattform von DeepSeek gibt es keine kostenlose API-Ebene, und die Gebühren werden nach Vorlastung auf Basis der verbrauchten Menge abgerechnet.
In Bezug auf die Benutzerberichte ist die Geschwindigkeit der Generierung (TPS) ein Thema in den Kommentaren der Community. Viele Benutzer berichteten über erhebliche Schwankungen in der Geschwindigkeit. Einige Benutzer erwähnten, dass auf der ollama Cloud-Plattform eine maximale Geschwindigkeit von etwa 490 tokens/s beobachtet wurde, doch insgesamt war die Leistung instabil; zwischen Mittag und Nachmittag konnte sie auf fünfzig bis sechzig tokens/s sinken.
Im OpenCode Go-Paket haben auch Nutzer berichtet, dass der TPS unter 100 fällt. Zudem zeigen die Community-Tests, dass die Geschwindigkeit mit zunehmendem Kontext abnimmt. Einige Nutzer berichteten, dass der TPS nachdem der Kontext über 100K liegt, unter 100 fällt und bei 200K etwa 50 tokens/s beträgt.
Verwandte Lesestoffe: