
TL;DR
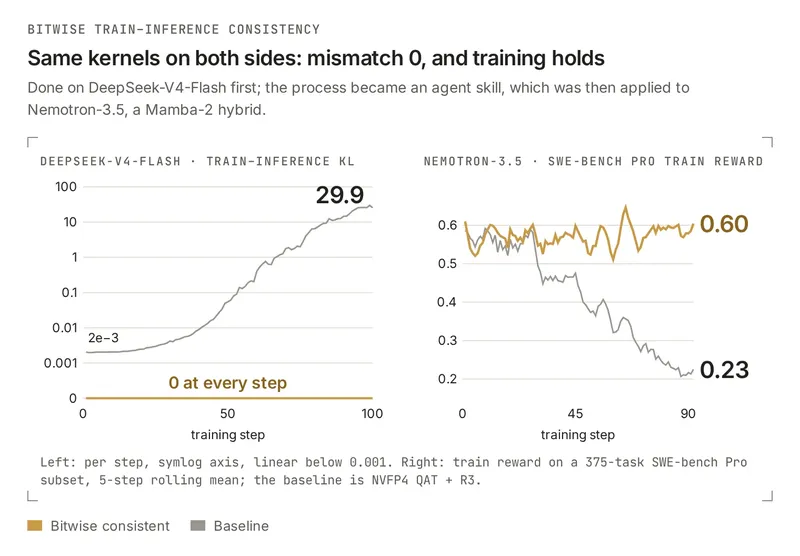
- Problem: Inferenzseitige Optimierungen in leistungsstarkem RL verändern die Numerik, sodass das Training eine andere Policy optimiert als die, die gesampelt hat. Auf DeepSeek-V4-Flash stieg die Train-Inference-KL des leistungsstarken Baseline von 2e-3 auf 29.9, während die Reward zurückfiel.
- Ansatz: Der Training-Forward ruft vLLMs Inferenz-Kernels direkt auf, und diese leistungsstarken Kernels werden so modifiziert, dass Rollout und Training für jedes gesampelte Token bitweise identische Logprobs erzeugen (diff = 0).
- Ergebnisse: Über 100 DeepSeek-V4-Flash-Trainingsschritte hinweg ist diff bei jedem Schritt 0 bei 91.3% des Rollout-Durchsatzes der Baseline. Auf Nemotron übertragen (Mamba-Hybrid + NVFP4) bleibt der SWE-bench-Pro-Score des konsistenten Laufs stabil, während der der Baseline von 0.56 auf 0.22 fällt.
- Open Source: Der Prozess ist als Agent Skill verpackt und zusammen mit den Rezepten und dem Code veröffentlicht, was die Kosten senkt, dies auf einem neuen Modell umzusetzen.
- In Arbeit: DeepSeek-V4.1 hat 0 diff erreicht; die Leistungsarbeit wird finalisiert und wird einen eigenen Beitrag erhalten.
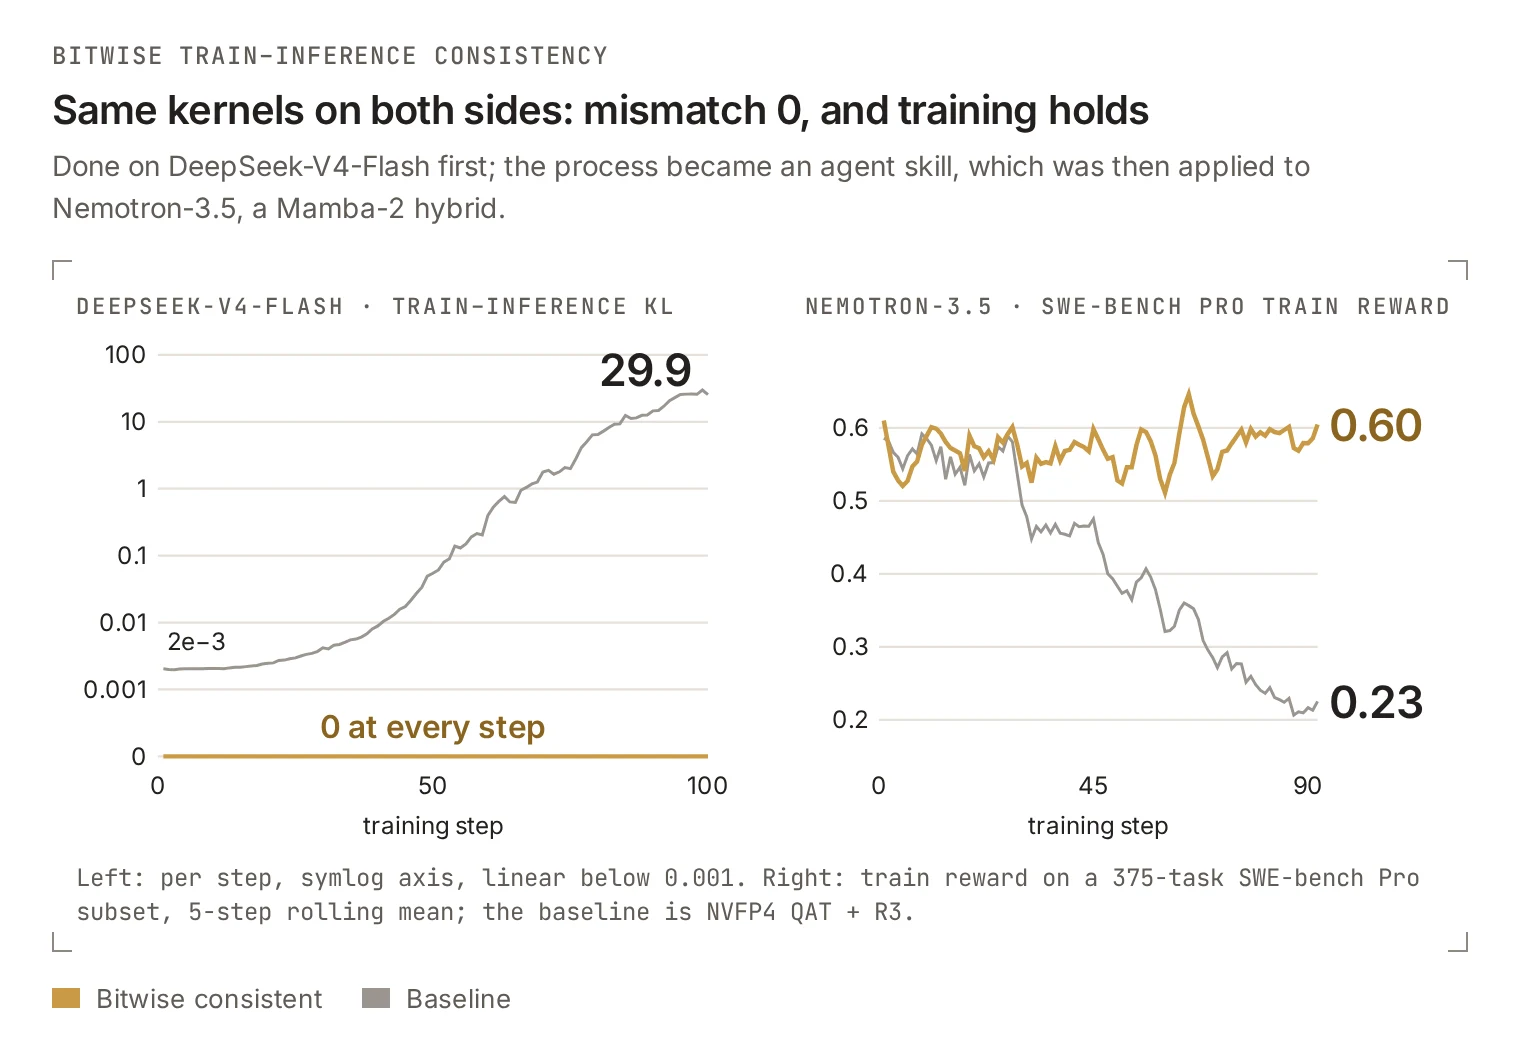
DeepSeek-V4-Flash erreichte zuerst 0 diff; der Prozess wurde zu einer Agent Skill, die dann auf Nemotron-3.5 (einen Mamba-2-Hybrid) angewendet wurde. Links: DeepSeek-V4-Flash Train-Inference-KL; die Baseline steigt von 2e-3 auf 29.9, und der konsistente Lauf liegt bei jedem Schritt bei 0. Rechts: Nemotron-3.5 Train-Score auf SWE-bench Pro (5-Schritt-gleitender Mittelwert); der konsistente Lauf bleibt bei etwa 0.6, während die Baseline auf 0.23 fällt.
Der Rollout dominiert die RL-Trainingszeit, daher setzen Trainingssysteme Rechnung mit niedriger Präzision, KV-Cache mit niedriger Präzision sowie Kommunikations- und Kernel-Optimierungen ein. Diese verändern die numerischen Werte auf der Inferenzseite. Die Inferenz-Engine generiert eine Antwort; die Trainings-Engine berechnet ihre Wahrscheinlichkeiten neu und aktualisiert das Modell. Mit identischen Gewichten weisen die beiden Seiten demselben Token nun unterschiedliche Wahrscheinlichkeiten zu, sodass das Training eine andere Policy optimiert als die, die gesampelt hat. Die Lücke kann mit Updates wachsen und das Training destabilisieren. In unserem DeepSeek-V4-Flash-Base-Experiment (ohne algorithmische Korrektur wie TIS) stieg die Train-Inference-KL des leistungsstarken Baseline von 2e-3 auf 29.9, während die Reward zurückfiel.
Instabiles Training bedeutet mehr Abstürze, Rollbacks und Wiederholungen, einen geringeren Anteil effektiven Trainings und mehr Gesamtzeit, um dasselbe Ergebnis zu erreichen. Unser Ziel ist es, effektives RL-Training schneller abzuschließen: durch weniger Abstürze und Wiederholungen in weniger End-to-End-Zeit ein Ergebnis erzielen.
Unser Ansatz: Auf dem leistungsstarken numerischen Pfad erzeugen Training und Inferenz für jedes gesampelte Token einen bitweise identischen Logprob (diff = 0; Abschnitt 2 definiert dies exakt), was echtes On-Policy-RL ist. Wir erreichen das, indem der Training-Forward vLLMs Inferenz-Kernels direkt aufruft und diese leistungsstarken Kernels so modifiziert werden, dass sich die Ergebnisse nicht mit Batch-Zusammensetzung, Prefill- oder Decode-Phase oder parallelem Layout ändern (Abschnitte 3 und 4). Eine Agent Skill senkt daraufhin die Kosten, dies auf einem neuen Modell umzusetzen, und macht den Prozess übertragbar: Sie tells einem Agenten, wie er den ersten Operator findet, bei dem die beiden Seiten auseinanderlaufen, ihn auf ein minimales Repro reduziert, ihn behebt und die Regressionstests erneut ausführt. Auf DeepSeek-V4-Flash erreichen wir 0 diff bei 91.3% des Rollout-Durchsatzes des leistungsstarken Baseline, und wir haben die Methode auf Nemotron übertragen, einen Mamba-Hybrid mit NVFP4.
Dieser Beitrag misst numerische Konsistenz, Trainingskurven und Rollout-Durchsatz. Der End-to-End-Gewinn entsteht durch weniger Abstürze und Wiederholungen, was sich erst über lange Läufe zeigt; dieser Wall-Clock-Vergleich bleibt einer späteren Betrachtung vorbehalten. Außerdem wurden beide Baselines weder gründlich getunt noch erkundet: Jede lief in einer einzigen Konfiguration, mit R3, aber ohne algorithmische Korrekturen wie TIS oder MIS. Die hier gezeigten Baseline-Zusammenbrüche spiegeln nur dieses Rezept wider; mit Tuning muss die Baseline nicht so leicht kollabieren.
1. Existierende Ansätze: wie sie die drei Eigenschaften gegeneinander abwägen
Effektives RL-Training schneller abzuschließen erfordert drei Eigenschaften gleichzeitig:
- A, hohe Leistung: schneller Rollout und Training, mit nutzbarer Rechnung mit niedriger Präzision, KV-Cache mit niedriger Präzision und Kommunikationsoptimierungen;
- B, hohe Konsistenz: Training und Inferenz berechnen dieselbe Policy für dieselben Gewichte;
- C, geringe Kosten und Generalität: A und B auf einem neuen Modell, einer neuen Präzision oder Hardware zu erreichen, braucht akzeptable Entwicklungszeit.
Diese halten selten zusammen. Lässt man B weg, optimiert man frei, riskiert aber instabiles Training. Lässt man A weg, kann man konsistente Kernels verwenden, aber die Inferenz wird deutlich langsamer (Zahlen in der Tabelle unten). A und B zu behalten bedeutet, modell für modell und operator für operator auszurichten, sodass C scheitert.
Die Diskrepanz zwischen Training und Inferenz ist nicht neu; bestehende Ansätze handhaben A, B und C unterschiedlich:
| Ansatz | Was er erhält | Was er aufgibt oder bezahlt |
|---|---|---|
| Algorithmische Korrektur: TIS, MIS, FlashREINFORCE, Score Centering | A und C: lässt die Inferenz-Engine unangetastet, modellunabhängig, günstig in der Einführung | B: der numerische Unterschied bleibt; nur seine Auswirkung auf das Update wird begrenzt. Kosten: Verzerrung, verworfene Samples, und die Korrektur wird schwieriger, wenn niedrige Präzision die Lücke vergrößert |
| R3 (replay rollout expert routing) | A, plus B für MoE-Routing | Entfernt nur Routing-Flips; andere numerische Unterschiede bleiben |
| QAT (der Vorwärtsschritt im Training simuliert die Deployment-Quantisierung) | A: Rollout kann sicher niedrige Präzision verwenden; verkleinert den durch Quantisierung verursachten Teil der Differenz (verbessert B) | Training muss die Quantisierung simulieren, und der Backward-Schritt verwendet den Straight-Through-Estimator (STE: der Backward behandelt Quantisierung als Identität); das Simulieren nur der Gewichte lässt Differenzen durch Aktivierungen, KV, Kerne und Reduktion bestehen |
| Strikte numerische Ausrichtung (Thinking Machines, slime, IsoExec, dieser Beitrag) | B | A oder C: generische batch-invariante Kerne kosten A (Thinking-Machines-Workload: 26 s bis 55 s, 42 s mit einem verbesserten Attention-Kern); die Ausrichtung auf dem Hochleistungspfad erhält A und kostet C (slime, IsoExec, dieser Beitrag: Ausrichtung und Verifikation pro Modell und pro Operator) |
Algorithmische Korrektur umfasst mehrere Mechanismen:
- TIS (Truncated Importance Sampling, Yao et al.): gewichtet den Gradienten mit dem Verhältnis von Trainings-/Rollout-Wahrscheinlichkeit, oben begrenzt abgeschnitten, tauscht ein wenig Bias gegen begrenzte Varianz;
- MIS (Masked Importance Sampling, When Speed Kills Stability): keine Abschneidung; verwirft ganze Sequenzen, deren Sequenz-Wahrscheinlichkeitsverhältnis einen Schwellenwert überschreitet;
- FlashREINFORCE (Hu, Zhang et al.): für asynchrones agentisches RL; Filterung von Drift auf Trajektorienebene (sequence trust region) entfernt Trajektorien, die zu stark abweichen;
- Score Centering (Marek & Ryabinin): gleicht die bei jedem Update angesammelte Train-Inference-Drift über einen additiven Korrekturterm aus; lässt sich mit Importance Sampling kombinieren.
Diese Methoden verringern die Wirkung der Diskrepanz, beseitigen sie aber nicht: Die Diskrepanz macht aus On-Policy-Training ein Off-Policy-Training (Yao et al.); wenn sie groß ist und mehrere Quellen hat, ist token-basiertes Importance Sampling verzerrt und das Training kollabiert eher (Li & Liu); bei P1-VLhat das abgeschnittene Importance Sampling den Kollaps nur verzögert. R3 (Rollout Routing Replay, Ma et al.) zeichnet das Experten-Routing des Rollouts auf und spielt es im Training wieder ab, wodurch nur der Routing-Flip-Teil entfernt wird.
In der letzten Zeile erreicht Thinking Machines Lab echtes On-Policy-RL mit batch-invarianten Kernen (Defeating Nondeterminism in LLM Inference) bei den Inferenzzeit-Kosten in der Tabelle, wovon ein großer Teil von einer FlexAttention-Integration stammt, die noch nicht gut optimiert ist; vLLM und TorchTitan verwenden vLLMs Forward-Kernel im Training wiederverwenden, und ihr bitwise-konsistenter Lauf erreichte eine höhere Belohnung in weniger Schritten; slime gleicht Logprobs auf der GLM-5-Architektur ab (MLA + DSA, gleiche Struktur wie DeepSeek-V3.2); und IsoExec von Alexander Jiang und dem SkyRL-Team behandelt lineare Aufmerksamkeit (Abschnitt 6).
Die meisten dieser Ansätze lassen sich kombinieren: Manche zielen auf den numerischen Unterschied zwischen Engines bei einer Gewichtsversion, andere auf den Richtlinienunterschied zwischen Gewichtsversionen. Beim asynchronen Training geht die Off-Policy-Anteile durch veraltete Gewichte weiterhin an TIS, MIS oder Score Centering, aber die Engines können weiterhin numerisch auf diesen Gewichten ausgerichtet werden, und der bitwise-konsistente Lauf wird zur Referenz für die Messung solcher Korrekturen. Auch QAT gehört zur strikten Ausrichtung: Low-Precision-Rollout und Training stimmen nur dann bitweise überein, wenn der Training-Forward dieselbe Quantisierung anwendet; unser Backward verwendet STE.
Wir nehmen den Pfad der letzten Zeile, der A beibehält, mit folgender Messlatte für A: Rollout-Durchsatz von mindestens 70% eines gleichwertig optimierten High-Performance-Baselines (Rollout ist der zeitaufwändigste Teil des RL-Trainings; der Overhead auf der Trainingsseite wurde nicht separat gemessen, siehe 3.2). C ist die Schwachstelle dieses Pfads; Abschnitt 5 behandelt, wie Agent + Skill dies ausgleicht.
2. Was Train-Inference-Konsistenz erfordert
In diesem Beitrag ist diff die Differenz, vor jedem Update mit derselben Gewichtsversion und demselben Token-Präfix, zwischen dem Logprob des Rollouts für jedes gültige Token (gesampelte Token innerhalb der Response-Maske) und dem von der Trainingsseite neu berechneten Old-Logprob. Die Akzeptanz verlangt, dass Maximum, Mittelwert und Standardabweichung der per-Token-Differenz |p_rollout − p_train| sowie die k3-KL alle exakt 0 sind. Dies ist exakte Gleichheit, kein Schwellenwert, geprüft vor jedem Update; ein Mini-Batch-Update ändert die Richtlinie ohnehin, was die Definition ausschließt. Dies gilt auf unseren akzeptierten Aufgaben (mathematisches Reasoning, Multi-Turn-Tool-Aufrufe) und parallelen Layouts, einschließlich unterschiedlicher Layouts pro Seite.
„Training und Inferenz berechnen dasselbe“ zerfällt in vier Dimensionen plus einen gemeinsamen numerischen Vertrag:
train-inference consistency ⇐ kernel determinism + batch independence + phase consistency + cross-GPU consistency + same numerical contract on both sides
Kernel-Determinismus (einzelne GPU). Derselbe Kernel auf derselben Eingabe liefert immer dieselbe Ausgabe. GPUs garantieren dies standardmäßig nicht. Ein Beispiel ist Split-K-Matrixmultiplikation: Eine andere Akkumulationsreihenfolge liefert ein anderes Ergebnis, weil Gleitkomma-Addition nicht assoziativ ist.
Batch-Unabhängigkeit. Das Ergebnis einer Anfrage darf nicht von den anderen Anfragen in ihrer Batch abhängen. Während der Inferenz führt die Engine Batches dynamisch zusammen und teilt sie für den Durchsatz auf. Im Training ändern auch Mikro-Batch-Größe, Packing und per-Expert-MoE-Tokenanzahlen den Pfad. Verschiedene Optimierungen (Kernel-Auswahl nach Batch-Größe, dynamische Split-Anzahl) machen eine bestimmte Anfrage von anderen in ihrer Batch abhängig.
Phasen-Konsistenz. Ein Token muss im Prefill (viele Token auf einmal) und im Decode (eines nach dem anderen) dasselbe Ergebnis liefern. Inferenz-Engines geben jeder Phase ihren schnellsten Kernel; das Erzwingen eines gemeinsamen Pfads ist eine Hauptquelle der Verlangsamung der konsistenten Version und ein Fokus der Optimierung.
GPU-übergreifende Konsistenz. GPU-übergreifende Reduktionen (AllReduce, reduce-scatter und das Zusammenführen der Expertenausgaben nach dem MoE all-to-all) müssen ebenfalls festgelegt werden, und zwar auf zwei Ebenen.
- Bei derselben Parallel-Layout auf beiden Seiten dürfen die Kommunikationsergebnisse nicht je nach Timing und Scheduling variieren (Algorithmus der Kommunikationsbibliothek, Reduktions-Chunking und Präzision sowie Expert-Merge-Reihenfolge festlegen).
- Bei unterschiedlichen Parallel-Layouts (z. B. unterschiedlichen TP/EP-Graden) müssen die Ergebnisse auch beim Wechsel des Parallelitätsgrads gleich bleiben, was einen festgelegten Reduktionsbaum erfordert und mehr kostet. Das DeepSeek-V4-Rezept verlagert die GPU-übergreifende Reduktion stattdessen aus dem verglichenen Pfad (4.5).
Jede Dimension schützt gegen eine von zwei Grundursachen: eine andere Reihenfolge der Operationen (parallele Akkumulations- oder Reduktionsreihenfolge folgt dem Scheduling) oder ein anderer Berechnungspfad (die beiden Seiten oder unterschiedliche Batch-Formen führen unterschiedliche Kernels oder Zweige aus). Um 0 diff zu erreichen, müssen zuerst die statischen Unterschiede beseitigt und dann die dynamische Pfadauswahl festgenagelt werden, sodass sie die Last ignoriert.
Neben diesen vier Dimensionen erfordert das Erreichen von diff = 0 noch einiges mehr:
- Derselbe numerische Vertrag auf beiden Seiten: gleiche Quantisierung und Rundung, gleiche Akkumulationspräzision, gleiche Kernel-Arithmetik. Zwei Engines können alle vier Dimensionen erfüllen und sich trotzdem unterscheiden, wenn sie unterschiedlich rechnen.
- Dieselben diskreten Entscheidungen: Top-K und MoE-Routing verwandeln einen One-Ulp-Unterschied stromaufwärts (eine Einheit an der letzten Stelle einer Gleitkommazahl) in eine andere Token-Menge oder Experten-Kombination. Sobald der stromaufwärtige Teil übereinstimmt, müssen auch Tie-Breaking, Ausgabereihenfolge und Merging-Regeln übereinstimmen.
- 1 Update pro Schritt (Step-Batch gleich Mini-Batch): bei mehreren Mini-Batch-Updates pro Schritt unterscheiden sich die Trainingsgewichte ab dem zweiten Update von den Sampling-Gewichten, was von diff = 0 nicht abgedeckt wird, sodass das Training nicht mehr strikt on-policy ist (bei einer Matheaufgabe mit 4 Updates pro Schritt wechselten etwa 7% der Token nach jedem Update die Experten-Kombination).
- Ein korrekter Backward und Restore: die vier Dimensionen liefern nur ein konsistentes Forward. Backward muss weiterhin korrekt sein, und der erste Schritt nach dem Checkpoint-Restore muss weiterhin konsistent sein.
Die Hauptoperatoren in Abschnitt 4 erfüllen jeweils eine dieser Anforderungen: die dichte GEMM fixiert die Kernel-Auswahl für Batch-Unabhängigkeit (4.1); der FP8 KV cache vereinheitlicht die Prefill- und Decode-Lesevorgänge für Phasen-Konsistenz (4.2); Top-K legt Ties und Reihenfolge fest, damit diskrete Entscheidungen übereinstimmen (4.3); die Experten-GEMM hält einen numerischen Vertrag über zwei Layouts hinweg ein (4.4); und die GPU-übergreifende Reduktion wird aus dem verglichenen Pfad verlagert für GPU-übergreifende Konsistenz (4.5).
diff = 0 sagt, dass beide Seiten dasselbe berechnen, nicht dass es für das Training passt: bei mehreren Updates pro Schritt gilt diff = 0, während das Routing zwischen den Updates driftet. diff = 0 ist unser Engineering-Ziel, keine hinreichende Bedingung für Trainingsqualität, die eine gesonderte Abnahme erfordert.
3. Referenzrezept: DeepSeek-V4-Flash
DeepSeek-V4-Flash kombiniert Low-Precision-Compute, Sparse Attention und Multi-Node-Expert-Parallelismus, was es zu einer anspruchsvollen Konfiguration macht. Von der FP8-Basis aus trainierten wir zwei 100-Schritt-Läufe auf GB200: eine optimierte High-Performance-Baseline und eine konsistente Version mit diff = 0.
Aufgabe: mathematisches Reasoning mit DAPO-Format-Daten, GRPO und einer Reward mit Überlängen-Strafe (damit er negativ sein kann). Jeder Lauf verwendet 8 Maschinen (32 GPUs), 128 Prompts × 8 Antworten pro Schritt und 1 Update pro Schritt (Step-Batch = Mini-Batch). Keiner der Läufe verwendet TIS, MIS oder ähnliche Korrekturen, wodurch der Engine-Unterschied direkt sichtbar wird.
Parallelismus: DP data, EP expert, CP context (Sequenz-Split), TP tensor. Das Rollout der konsistenten Version läuft mit 4 vLLM engines, jeweils DP8/EP8, TP=1; das Training verwendet EP32, CP4, TP=1. Die beiden Seiten verwenden unterschiedliche Parallel-Layouts (4.5).
Relevante Strukturen: MLA (Multi-Head Latent Attention, die KV vor dem Caching komprimiert); DSA (DeepSeek Sparse Attention: ein leichtgewichtiger Indexer bewertet Historienpositionen, Top-K behält höchstens 2048, und MLA beachtet nur diese); der CSA-Kompressor (komprimiert die Historien-KV in weniger Zeilen); mHC (Mischung über Residual-Streams, wobei die Mischmatrix durch Sinkhorn-Iterationen normalisiert wird); sowie 43 MoE-Schichten. SM100 ist Blackwell (das hier verwendete GB200); SM90 ist Hopper.
3.1 Kernentscheidung: Inferenz-Kernels definieren die Werte, das Training fügt nur den Backward-Pass hinzu
Zwei Engines stimmen am leichtesten überein, wenn sie denselben Code ausführen; die Frage ist, welche Seite sich anpasst. Der Rollout dominiert die RL-Zeit, wobei jeder Operator auf Durchsatz optimiert ist; das Training als Referenz zu nehmen, würde diese Optimierungen aufgeben. Daher sind die Inferenz-Kernels die numerische Referenz: Das Trainings-Forward ruft für seine Werte dieselben vLLM-Kernels auf, und das Training fügt nur den Backward-Pass hinzu. Auch die Inferenz wechselt nicht zu generischen batch-invarianten Kernels: Sie behält die leistungsstarken Deployment-Kernels bei und modifiziert sie, um die Anforderungen aus Abschnitt 2 zu erfüllen. Jeder Operator in Abschnitt 4 folgt diesem Kompromiss.
Die Herausforderung bei dieser Entscheidung ist, dass Inferenz-Kernels keinen Backward-Pass haben und FP8-Quantisierung nicht differenzierbar ist. Deshalb werden Forward und Backward getrennt behandelt, und die Forward-Werte stammen immer aus dem vLLM-Kernel. Jedes Modul kapselt den Kernel in einem benutzerdefinierten autograd.Function ein, dessen Backward gegen die BF16-Mastergewichte differenziert, wobei die FP8-Quantisierung als Identität behandelt wird (Straight-Through-Estimator, STE). Der Backward nutzt größtenteils vorhandene Kernels wieder: Transformer-Engine-BF16-GEMMs für lineare Schichten und Expert-GEMMs, den cuDNN-Frontend-DSA-Backward für Sparse Attention und DeepEPs Backward für das All-to-All; nur kleine Operatoren wie mHC, RMSNorm und SwiGLU haben handgeschriebene FP32-Ableitungen. Einige fused kernels haben Ausgaben, die sich so nicht differenzieren lassen (Attention q/k, komprimiertes KV, Routing-Gewichte, die finale logprob); für diese berechnen wir dieselbe Berechnung in PyTorch nur für ihren Gradienten erneut und behalten die Werte des Kernels: visible + (graph - graph.detach()). Jeder Backward prüft zunächst, ob sich die Mastergewichte seit dem Forward nicht verändert haben, damit Rekalkulation oder asynchrone Updates keine Gewichts-Versionen vermischen können.
Alle Kosten landen beim Training, in zwei Arten. Engineering und Verifikation: der Gradient ist ein Surrogat, nicht die exakte Ableitung des quantisierten Operators, daher beweist ein bitwise-identischer Forward nichts über die Gradienten, und das Skill prüft den Backward gegen eine unabhängige Referenz (Abschnitt 5); der Backward muss nur korrekt sein, nicht deterministisch. Jeder Layout-Einstiegspunkt (z. B. masked / contiguous in 4.4) benötigt zudem seine eigene Verifikation. Performance und Speicher: der Trainings-Forward muss die Eingaben und Ausgaben der Inferenz-Kernels für den Backward speichern; der Speicherdruck ist der Grund, warum das Rezept die vollständige Rekalkulation aktiviert, die Forward zweimal ausführt.
3.2 Ergebnisse und wer zahlt
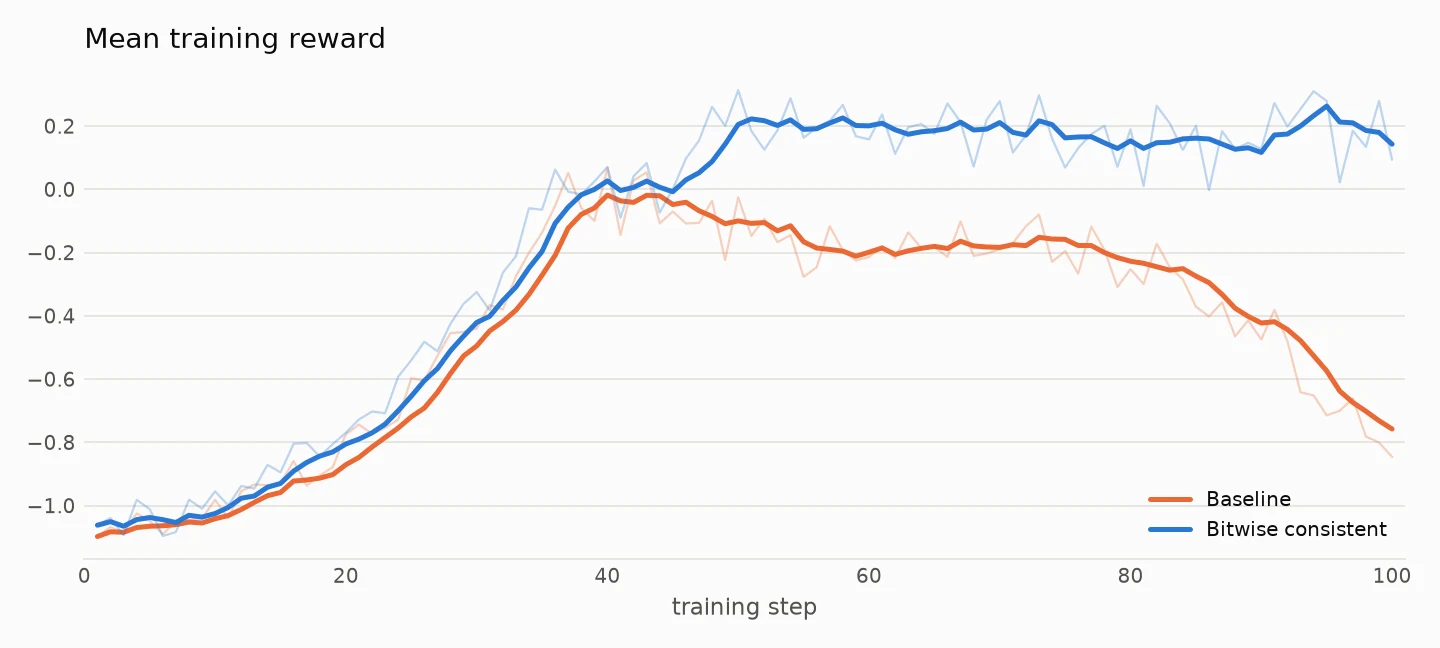
Trainings-Reward pro Schritt. Orange: Baseline; blau: konsistente Version. Dicke Linie: gleitender Durchschnitt des aktuellen und der vorherigen 4 Schritte; dünne Linie: Rohwert.
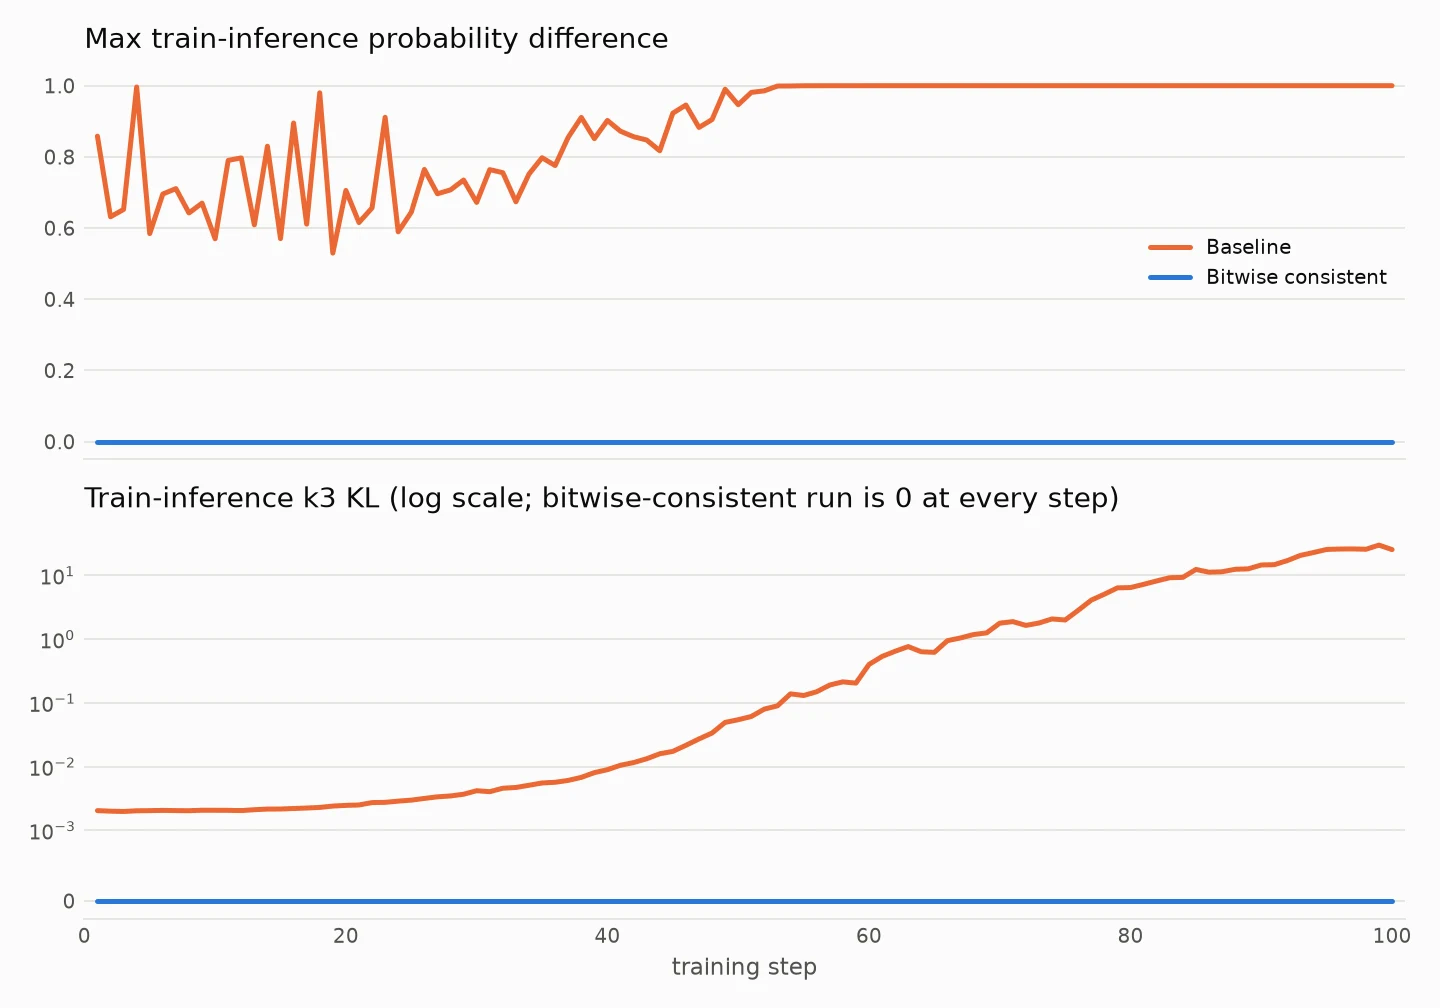
Oben: maximale Train-Inference-Wahrscheinlichkeitsdifferenz pro Schritt; unten: Train-Inference-KL (k3-Schätzer r − 1 − log r, durchgängig verwendet; symmetrisch logarithmische Skala, linear nahe Null). Die maximale Differenz reagiert auf eine einzelne Routing-Umkehr oder einen Top-K-Tausch, daher ist sie ab Baseline-Schritt 1 beträchtlich; die KL zeigt das Gesamtniveau. Orange: Baseline; blau: konsistente Version. Beide Metriken der konsistenten Version sind bei jedem Schritt 0.
Über 100 Schritte erreicht das Rollout der konsistenten Version im Durchschnitt 24.22 token/ms, 91.3% der Baseline (26.53):
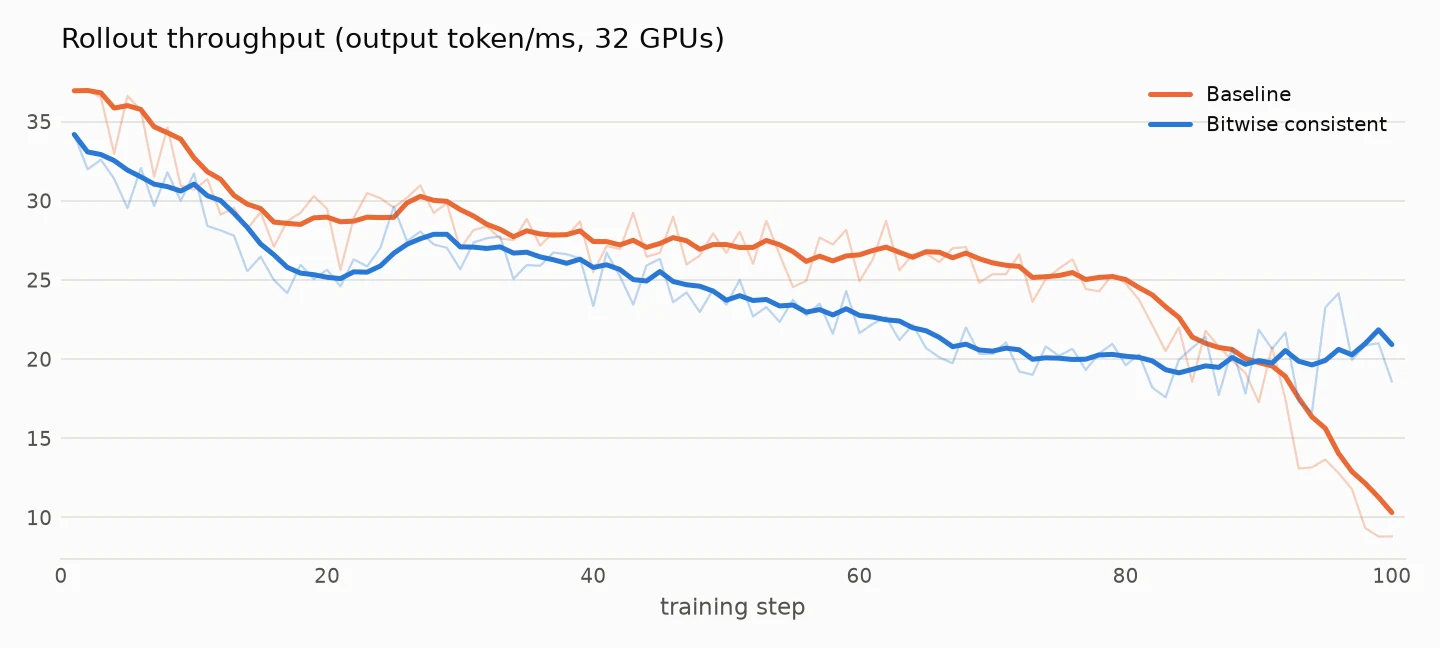
Rollout-Durchsatz pro Schritt (Ausgabe-token/ms, summiert über 32 GPUs). Orange: Baseline; blau: konsistente Version. Dicke Linie: gleitender Durchschnitt des aktuellen und der vorherigen 4 Schritte; dünne Linie: Rohwert.
Die Train-Inference-KL der Baseline wächst (2e-3 bis 29.9), während ihr Reward zurückfällt; die konsistente Version bleibt bei diff 0, und ihr Reward hält sich. Ein weiterer potenzieller Gewinn ist ein Forward weniger: Wir berechnen old-logprob in jedem Schritt nur, um diff zu messen; nach der Akzeptanz kann das Training stattdessen die Rollout-logprob verwenden.
Rollout-Seite, gemessen in diesem Lauf: Der Durchschnittsdurchsatz liegt bei 91.3% der Baseline (etwa 9% niedriger), über der 70%-Untergrenze aus Abschnitt 1. Nach Schritt 90 sinkt der Durchsatz der Baseline, was das Verhältnis aufbläht; über dieselben Schritte sinkt ihre mittlere Antwortlänge von etwa 3,000 auf etwa 1,600 Token. Die ersten 89 Schritte ergeben 88.6%. Die Antwortlängen der beiden Läufe unterscheiden sich während des gesamten Trainings, daher spiegelt das Verhältnis auch unterschiedliche Workloads wider, nicht nur die Engines.
Diese Lücke ist den Operatoren noch nicht zugeordnet; Abschnitt 4 verweist auf MoE-LL-Kommunikation und Backend, Attention-Gather und Dequantisierung sowie Requests-pro-Aufruf-Starts.
Trainings-Seite, nicht separat gemessen: laut Abschnitt 4 besteht der Overhead aus der Requantisierung der FP8-Gewichte bei jedem Forward, serieller Attention und Top-K pro Request, einem zusätzlichen Routing-Metadaten-Dispatch und der vollständigen Rekalkulation (3.1), die Forward zweimal ausführt.
Ein separater Verl-Rezept-PR-Vorschau auf 32 GB200 GPUs meldet etwa 10% End-to-End-Overhead: Rollout nahe Parität, die Lücke hauptsächlich im Training. Die Optimierung der Trainingsseite ist der nächste Schritt.
4. Operator für Operator: technische Entscheidungen im DeepSeek-V4-Rezept
Jeder Unterabschnitt behandelt, was beibehalten wird, was aufgegeben wird, wie Geschwindigkeit zurückgewonnen wird und welche Kosten bleiben. Welcher Kernel welche Seite pro Operator verwendet und wie der Backward geschrieben ist, steht im Skill.
Master-Tabelle pro Operator
Die Kosten liegen hauptsächlich bei MoE-Kommunikation und Backend (4.4, 4.5), danach bei Attention-Gather und Dequantisierung (4.2, 4.3); dense ist günstig.
| Modul | Beibehalten | Aufgegeben | Kosten |
|---|---|---|---|
| Dichtes GEMM (4.1) | Deployment W8A8 und DeepGEMM; eine Akkumulationsreihenfolge pro Ausgabe | FlashInfer-Zweig bei M<32, Small-Batch-Gate-Kernel, fusionierter mHC-Kernel | Rollout: kein schnellerer Small-Batch-Kernel; Training: Gewichte werden bei jedem Forward neu quantisiert |
| FP8 KV-Cache (4.2) | FP8-Speicherung | Decode-Kernel, der FP8 direkt liest | Rollout: zusätzliches Gather und Dequantisierung im Decode; Training: ein privater Cache |
| Top-K (4.3) | DSA Sparse Attention | Standard-Tie-Breaking und Ausgabereihenfolge bei Top-K | Eine zusätzliche Sortierung pro Seite, durch Fusion wieder eingespart; mehrere Prefill-Launches pro Anfrage; Training: Attention und Top-K seriell pro Anfrage |
| Expert GEMM (4.4) | FP8 grouped GEMM; Routing stimmt by construction überein, kein R3 | FlashInfer TRT-LLM MoE | Rollout: eine größere Durchsatzlücke; Training: Alignment-Padding |
| Cross-GPU-Reduktion (4.5) | Unterschiedliche Parallel-Layouts für Training und Rollout | TP>1 | Rollout: LL-Kommunikation kann sich nicht mit Berechnung überlappen; Training: ein zusätzlicher Routing-Metadaten-Dispatch |
| CUDA Graph (4.6) | Graphen | Reine Performance-Shortcut-Zweige | Workspaces, die an ihrer oberen Grenze reserviert sind |
| Sonstiges (embedding, RMSNorm, o_proj, lm_head + logprob) | Existierende Kernel, feste Reduktionsreihenfolge | — | Klein |
4.1 Dense GEMM: FP8 beibehalten, eine Akkumulationsreihenfolge für jedes M
Beibehalten. DeepSeek-V4-Flash-Base wird in Block-FP8 ausgeliefert, und der Bereitstellungspfad ist W8A8 mit DeepGEMM. Die konsistente Version verwendet es auf beiden Seiten: Jeder Training-Forward quantisiert die BF16-Mastergewichte nach der Deployment-Regel in Block-FP8 und ruft die Inferenz-GEMM auf. Ein BF16-Rollout würde Rechenleistung und Bandbreite kosten; ein separates Training-seitiges Schema wie MXFP8 kommt den deployten Numeriken nur nahe, die Einschränkung der QAT-Zeile in Abschnitt 1.
Aufgegeben. Die Inferenz-Engine wählt Kernel nach Form: Die FP8-Linearschicht verwendet FlashInfer bei M<32 und andernfalls DeepGEMM; der Router-Gate wechselt bei 16 Tokens oder weniger auf einen Small-Batch-Kernel; die mHC-Split-Anzahl wächst mit der Token-Anzahl. Fließkomma-Addition ist nicht assoziativ, sodass jede davon das Ergebnis einer Anfrage von deren Nachbarn abhängig macht. Die konsistente Version entfernt diese Zweige: Die FP8-Linearschicht verwendet immer DeepGEMM im batch-invarianten Modus, der Router-Gate verwendet bei jeder Batch-Größe eine GEMM mit FP32-Ausgabe, kleine BF16-Matmul verwenden einen Triton-Kernel mit fester Summationsreihenfolge, und der mHC-Split ist auf 1 festgelegt. Wir vereinheitlichen auf DeepGEMM statt FlashInfer, weil DeepGEMM einen batch-invarianten Modus hat, bereits der Deployment-Kernel ist und das Training-M groß ist.
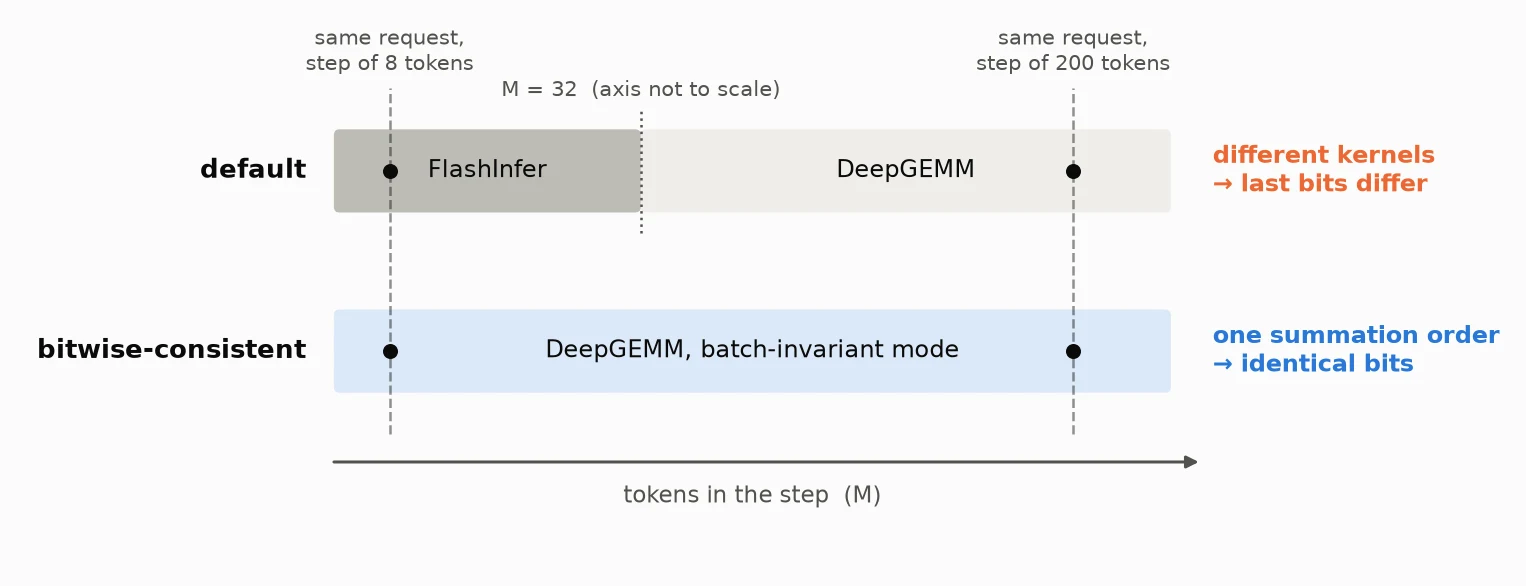
Horizontale Achse: Tokens pro Schritt (schematisch). Der Standardpfad wechselt bei 32 den Kernel, sodass dieselbe Anfrage in einem 8-Token- und einem 200-Token-Schritt durch FlashInfer und DeepGEMM läuft und sich im letzten Bit unterscheidet. Der batch-invariante Modus hat eine Summationsreihenfolge.
Kosten. Rollout verliert schnellere Small-Batch-Kernel und eine mHC-Fusion, aber Tensor Cores bleiben ausgelastet. Das Training requantisiert die Gewichte bei jedem Forward, einschließlich Recomputation; das Cachen der FP8-Gewichte spart diese Zeit gegen eine weitere residente Kopie.
4.2 FP8-KV-Cache: FP8-Speicherung beibehalten, den Lesepfad vereinheitlichen
Beibehalten. Der KV-Cache wird in FP8 gespeichert, etwa 57% von BF16, was die Konkurrenzfähigkeit direkt bestimmt. Beide Läufe teilen sich den Schreibpfad.
Aufgegeben. Standard-Decode verwendet einen FlashMLA-Kernel, der FP8 direkt liest und die Arbeit nach Batch aufteilt; Prefill dequantisiert zu BF16 und führt Sparse Attention aus. Die beiden Phasen laufen mit unterschiedlichen Algorithmen, und die Aufteilung des Decode hängt von seinem Batch ab. Die konsistente Version führt Decode über den Prefill-Pfad: Die ausgewählten KV werden dequantisiert und in einen BF16-Workspace gesammelt, dann wird derselbe aufgerufen flash_mla_sparse_fwd. Der Workspace ist pro Anfrage und wird nur durch die Modellgrenzen bemessen. Dieser Decode-Kernel muss explizit ausgewählt werden; der Konsistenzschalter allein ändert ihn nicht.
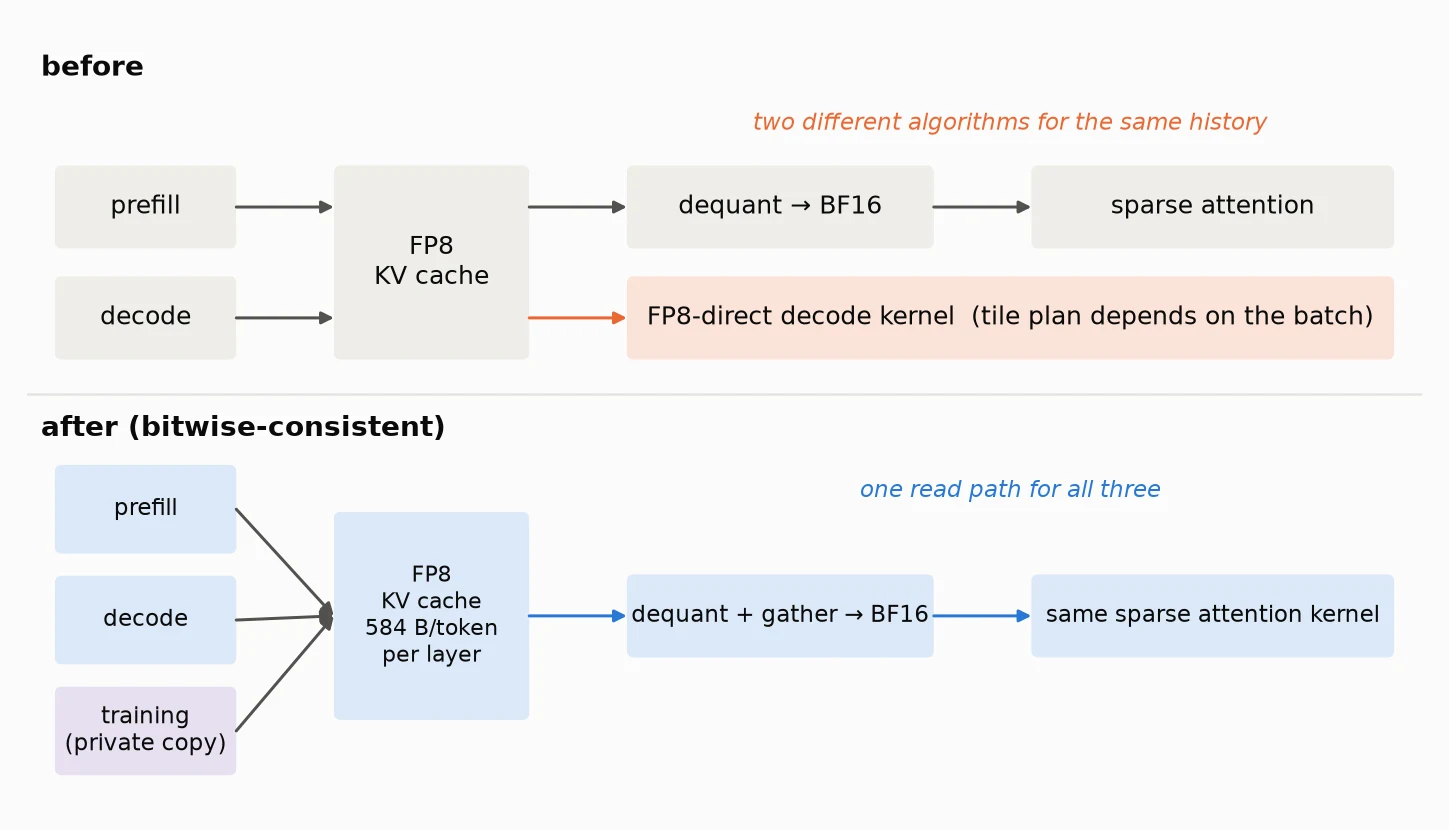
Oben: vorher lesen Prefill und Decode denselben FP8-Verlauf mit zwei Algorithmen, und die Partitionierung von Decode hängt vom Batch ab. Unten: Prefill, Decode und Training (mit einer privaten Cache-Kopie) teilen sich einen Lesepfad.
Training hat keinen echten Cache, aber K muss dieselbe FP8-Rundreise machen: derselbe fusionierte Kernel schreibt es in einen privaten FP8-Cache, und dieselbe Dequantisierung liest es zurück.
Kosten. Decode fügt Gathering und Dequantisierung hinzu, und Training fügt einen Cache hinzu. Das ist der Preis für Phasen-Konsistenz; die Speichergenauigkeit bleibt unberührt. Derzeit erzeugt jede Anfrage ein Token pro Schritt; Multi-Token-Prediction (MTP) und Speculative Decoding werden nicht abgedeckt.
4.3 Top-K in der Sparse Attention: Gleichstände und Reihenfolge festlegen
Problem. Der DSA-Indexer bewertet jede Verlaufsposition, und Top-K wählt höchstens 2048 für die Aufmerksamkeit aus. Diese diskrete Wahl macht aus einer Ein-Ulp-Differenz vorgelagert einen anderen Kontext. Die Bewertung ist zuerst ausgerichtet: Der Indexer verwendet denselben DeepGEMM-Kernel, Prefill liest zusammenhängendes KV und Decode liest gepagtes KV, und die beiden Lesevorgänge sind bitweise identisch.
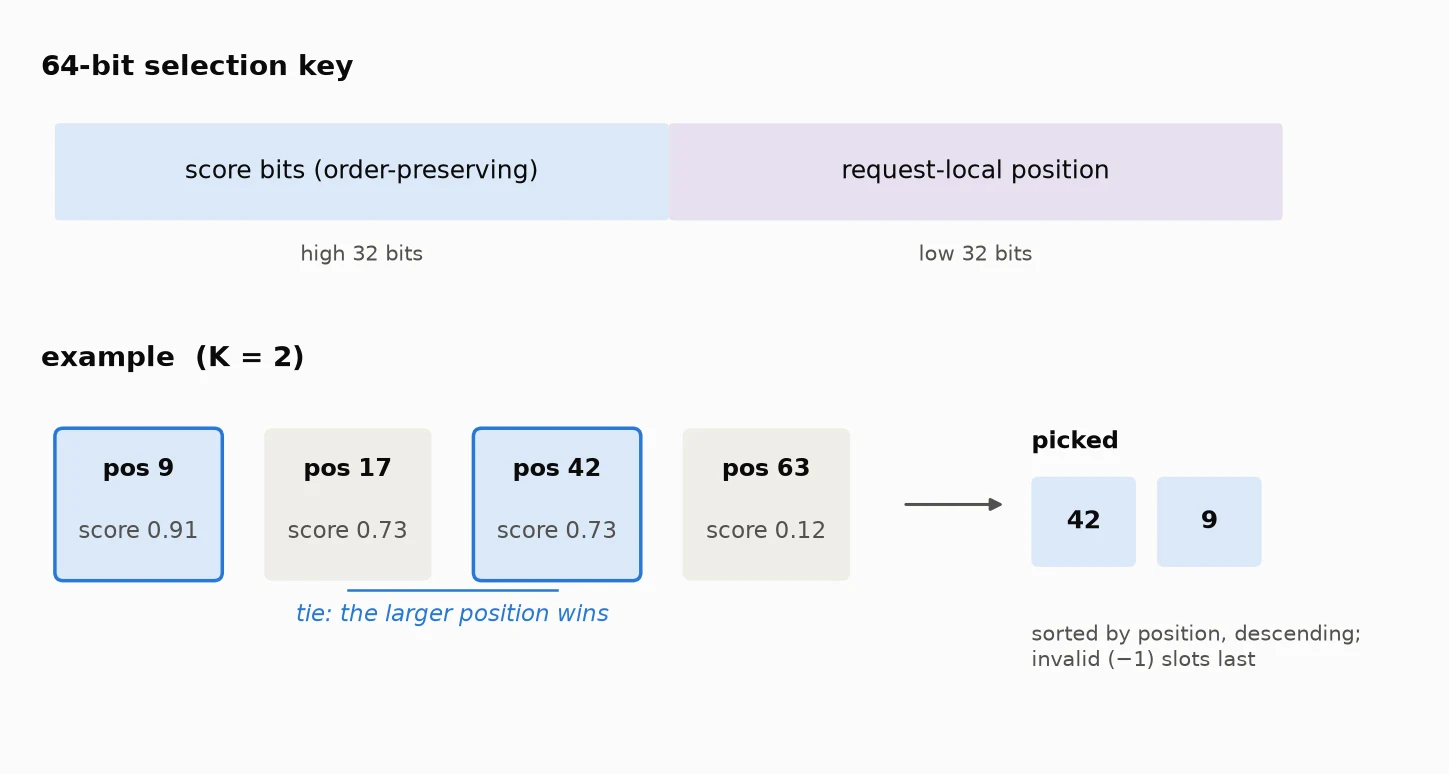
Oben: Layout des 64-Bit-Auswahlschlüssels. Unten: ein Beispiel mit K = 2, bei dem die Positionen 17 und 42 gleichauf liegen und die Positionsbits im Schlüssel 42 auswählen; die ausgewählten Positionen werden dann nach absteigender Position sortiert, ungültige Einträge zuletzt.
Auswahl und Reihenfolge festlegen. Das Standard-Top-K entscheidet Gleichstände durch Thread-Scheduling. Die konsistente Version kombiniert Bewertung und Position innerhalb der Anfrage zu einem eindeutigen Schlüssel, sodass Gleichstände an die größere Position gehen. Sie verwendet die Position innerhalb der Anfrage, nicht die globale Batch-Position; andernfalls würde das Verschieben einer Anfrage innerhalb des Batches die Ergebnisse bei Gleichständen ändern. Dieselbe Menge reicht nicht aus: Die Indexreihenfolge legt die Akkumulationsreihenfolge der Aufmerksamkeit fest, daher werden die ausgewählten Indizes nach absteigender Position sortiert, ungültige Einträge zuletzt.
Die R3-artige Alternative zeichnet die Indizes des Rollouts auf und spielt sie im Training wieder ab, aber das sind bis zu 2048 Indizes pro Token pro Schicht: GB-Größe pro Sequenz bei langen Antworten.
Trainingsseite. Das Trainings-Forward wählt dieselben Positionen mit derselben Bewertung und demselben Top-K aus, aber der Indexer wird nicht trainiert, hauptsächlich der Einfachheit halber. Dies entspricht der bestehenden Praxis: DeepSeek-V3.2 entkoppelt die Eingabe des Indexers beim Training von DSA, sodass der RL-Verlust ihn nie erreicht, und GLM-5 friert den Indexer im RL standardmäßig ein.
Kosten und Erholung. Jede Seite führt eine zusätzliche Sortierung durch. Das deterministische Top-K dauert etwa 5.9 µs pro Aufruf; die Verschmelzung mit der Indexsortierung erhöht den Durchfluss der konsistenten Version im Inferenz-Benchmark um 6.7% (Konfiguration in 4.4). Die verbleibenden Kosten sind mehrere Aufrufe pro Anfrage im Prefill.
4.4 Expert GEMM: zwei Layouts, dasselbe Zeilenergebnis
Beibehalten. Das FP8-grouped-GEMM der gerouteten Experten dominiert die MoE-Schicht, und die beiden Seiten speisen es mit unterschiedlichen Layouts. Rollout verwendet DeepEP im Low-Latency-Modus (LL) (Warum: 4.5), was ein maskiertes Layout ergibt, das nach Expert in Chunks mit fester Kapazität pro Chunk unterteilt ist. Das Training verarbeitet viele Token mit DeepEP im Normalmodus, was ein zusammenhängendes Layout ergibt, das nach Expert gepackt ist.
Wahl des Backends. Beide konsistenten Seiten verwenden DeepGEMM im batch-invarianten Modus: Es ist Open Source, hat einen batch-invarianten Modus und ist der leistungsstarke Deployment-Kernel. Das FlashInfer TRT-LLM MoE des Baseline wird als vorkompilierte Cubins ausgeliefert, sodass wir es nicht ändern oder prüfen können, ob es batch-invariant ist; cutlass fehlt block-FP8, und triton fällt in eine batched Implementierung, die keine Batch-Invarianz deklariert. Ein einzelner Expert-GEMM dauert in beiden etwa gleich lang; die Baseline ist schneller, weil TRT-LLM MoE Kommunikation mit Berechnung in einer Multi-Stream-Pipeline überlappt.
Dasselbe Zeilenergebnis aus zwei Layouts. Drei Bedingungen müssen erfüllt sein:
- Experten erhalten dieselbe FP8-Eingabe. LL quantisiert bei Dispatch und der Normalmodus danach, ursprünglich mit unterschiedlicher Rundung; wir haben beide auf elementweises round-to-nearest vereinheitlicht.
- Das Ergebnis jeder Zeile ist unabhängig vom Layout. Die Quantisierung erfolgt pro Token, und das batch-invariante DeepGEMM akkumuliert jede Zeile auf feste Weise, sodass das Ergebnis einer Zeile nicht von ihren Nachbarn abhängt. Bitweise Router- + MoE-Tests bestätigen dies.
- Die Aktivierung wird einmal gerundet. SiLU(gate) × up zwischen den beiden GEMMs wird in FP32 berechnet, und nur das Produkt wird auf BF16 gerundet und dann auf FP8 quantisiert. Eine Rundung von SiLU auf BF16 vor der Multiplikation kann um ein Ulp abweichen, was die FP8-Quantisierung in einen Code-Wechsel umsetzt.
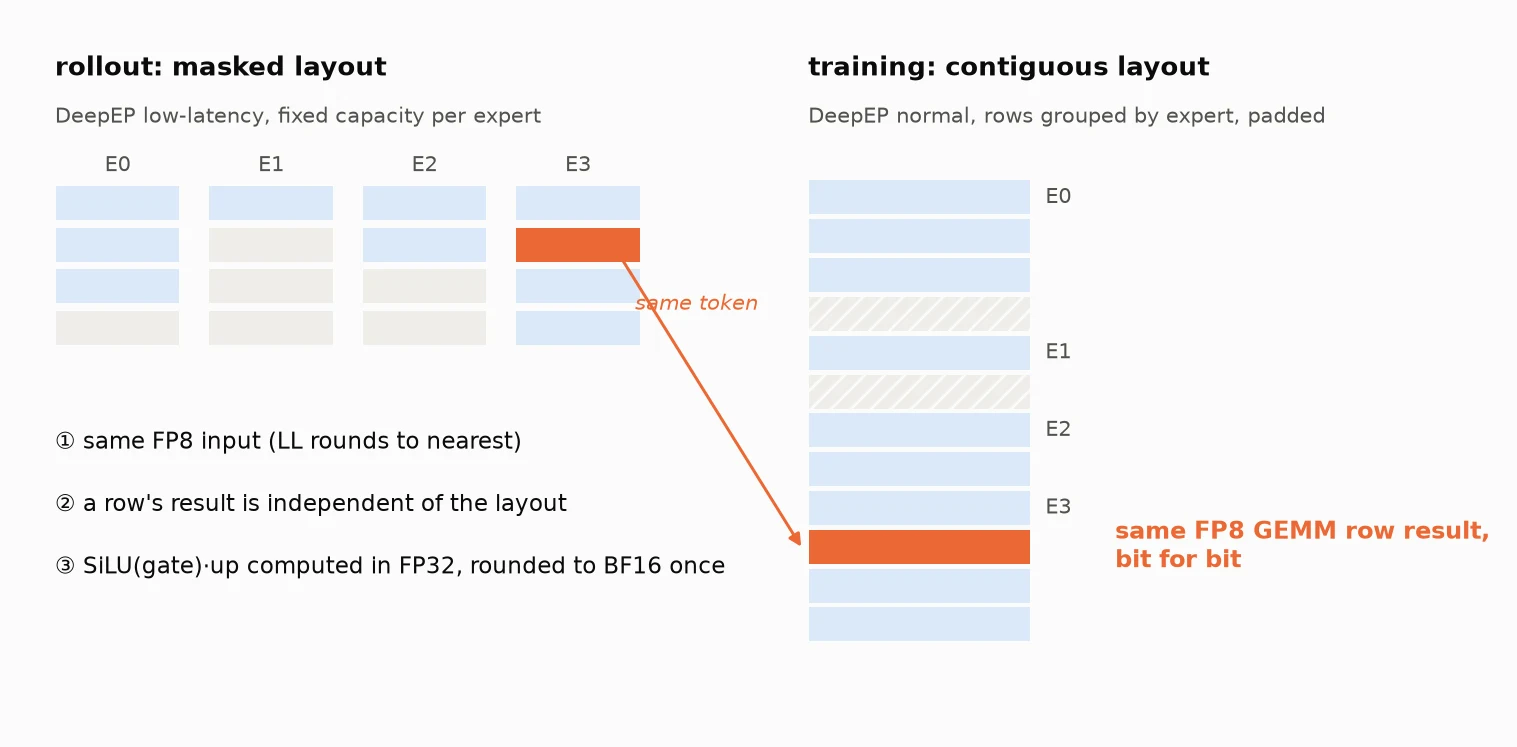
Dasselbe Token (orange) sitzt an unterschiedlichen Positionen im maskierten Layout des Rollouts und im zusammenhängenden Layout des Trainings, doch die drei Bedingungen machen sein Expert-GEMM-Ergebnis bitweise identisch. Grau: leere Slots; Schraffur: Ausrichtungspolster.
Kein R3 nötig. Die Bewertungs-GEMM des Routers verwendet einen FP32-Ausgabekernel bei jeder Batch-Größe auf bitweise identischen Eingaben, sodass die neu berechnete Routung mit dem Rollout übereinstimmt. Dies setzt 1 Update pro Schritt voraus (Abschnitt 2).
Kosten. Das Rollout verzichtet auf TRT-LLM MoE, aber das GEMM macht nicht den Großteil der Lücke aus. Im Inferenz-Benchmark (GB200, DP8/EP8, 256 Concurrency, 150 Eingabe / 3000 Ausgabe pro Anfrage) startete die konsistente Version 33% langsamer als die Baseline, davon etwa 83% durch nicht überlappbare LL-Kommunikation (4.5). Das Training speichert Zwischenergebnisse für den Backward-Pass und padded die Zeilen jedes Experten. Die Inferenz-Benchmark-Zahlen unten stammen aus verschiedenen Optimierungsstufen; vergleichen Sie sie nur innerhalb eines Satzes.
Vergleichen Sie vor dem Leistungsvergleich auch, welchen Kernel die Baseline ausführt: vLLM aktiviert den batch-invarianten SiLU·mul·Quantisierungs-Kernel immer dann, wenn seine Shared Library vorhanden ist, und ignoriert dabei den Konsistenz-Schalter, sodass auch jedes Image, das die Bibliothek mitbringt, ihn in der Baseline ausführt.
4.5 Cross-GPU-Reduktion: außerhalb des verglichenen Pfads
Problem. Das Rollout will niedrige Latenz und nutzt DP8/EP8; das Training muss Aktivierungen langer Sequenzen unterbringen und nutzt EP32 plus CP4. Wie in Abschnitt 2 angemerkt, benötigen unterschiedliche Layouts Ergebnisse, die invariant gegenüber dem Parallelitätsgrad sind, üblicherweise über einen festen, teuren Reduktionsbaum.
Entscheidung. Dieses Rezept hält die Cross-GPU-Reduktion aus dem numerischen Pfad, der verglichen wird, heraus, und die verbleibende Kommunikation verschiebt Daten, ohne Werte zu ändern:
- TP=1. Lineare Schichten haben kein All-Reduce. Das All-Reduce von vLLM wählt Algorithmen anhand der Nachrichtengröße, sodass TP diese Abhängigkeit zurückbringen würde; das Rezept lehnt TP>1 beim Start ab.
- EP-Merge ist lokal. Das All-to-All bewegt nur Daten. Die Expertenausgaben kehren zum besitzenden Rang des Tokens zurück und werden in FP32 in Top-k-Slot-Reihenfolge akkumuliert, unabhängig von EP=8 vs. 32 oder welcher Rang zuerst antwortet.
- CP macht keine Reduktion. Benachbarte Ränge tauschen nur Grenz-Hidden-States aus, und komprimierte KV wird in der CP-Gruppe all-gathered: Konkatenation, keine Summation.
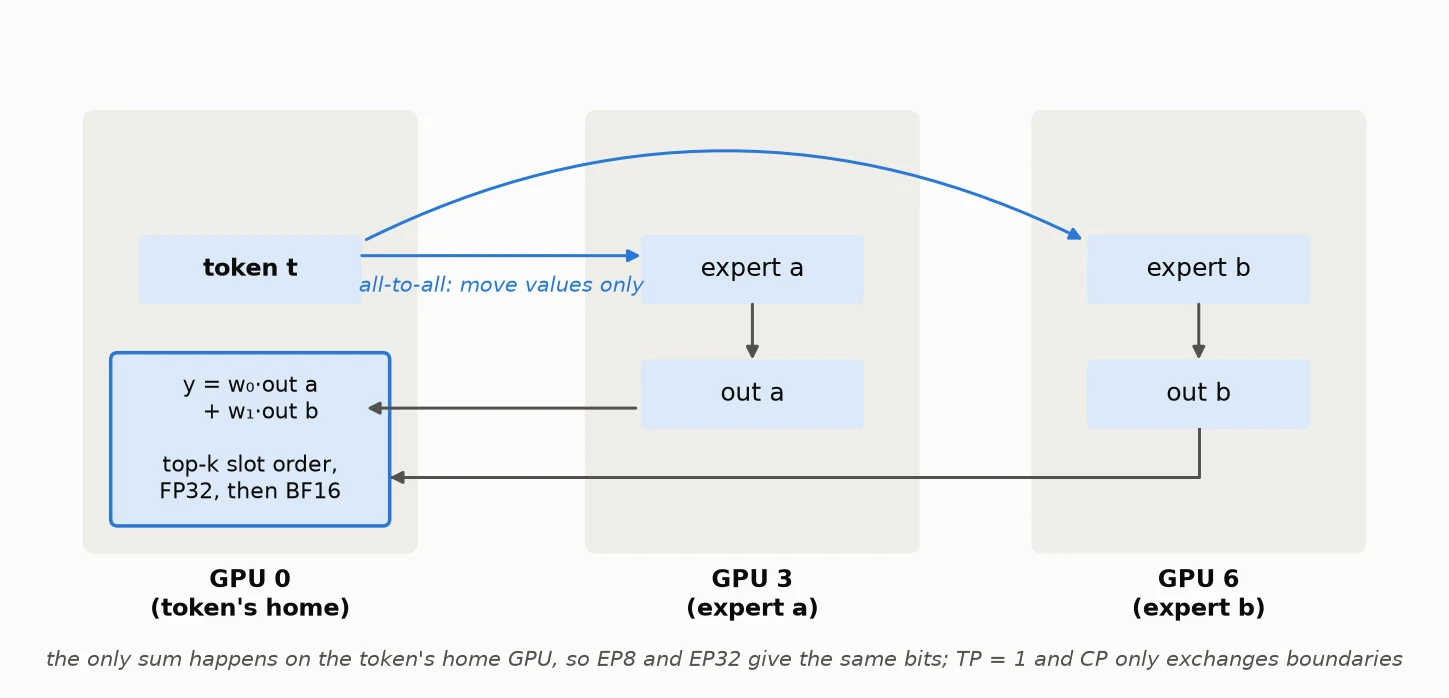
Der Pfad eines Tokens: Das All-to-All bewegt nur Daten, und die einzige Summation findet auf der dem Token zugeordneten GPU statt, in FP32 in Top-k-Slot-Reihenfolge, sodass EP8 und EP32 dasselbe Ergebnis liefern.
Die Datenbewegung deterministisch machen. Beim Rollout sendet jeder Rang pro Aufruf höchstens eine feste Anzahl von Tokens, und alle Ränge segmentieren im Lockstep, sodass die Kommunikationsform festgelegt ist. Nur LL implementiert dies, und DeepEP Normal Mode deaktiviert CUDA Graph bei DP>1, sodass der Rollout LL verwenden muss. Im Training hat Normal Mode keine feste Ankunftsreihenfolge, daher werden die Routing-Metadaten noch einmal dispatched und ein bitgenauer Hash ordnet jede Expertenausgabe ihrem Token und Slot zu.
Kosten und Wiederherstellung. Der LL-Modus führt 43 Layer × 2 = 86 serielle All-to-alls pro Schritt aus, die sich nicht mit Berechnungen überlappen lassen. Die von uns versuchten übergreifenden Überlappungsschemata berechnen, bevor die Eingaben bereit sind, und brechen die Batch-Unabhängigkeit. Das Interleaving von zwei Micro-Batches (DBO) war 39 % langsamer: Die Expertengewichte jedes Layers werden zweimal gelesen, und Gewichtungslesevorgänge nutzen bereits 84 % der HBM-Bandbreite.
Wir haben die Kommunikationslücke im Inferenz-Benchmark schließlich geschlossen. Zuerst bestätigen, dass beide Läufe denselben Transport verwenden: Wir verloren zwei Tage, weil ein Skript DeepEP der konsistenten Version an Ethernet RDMA (RoCE) pinnte, während die Baseline das viel schnellere MNNVL verwendete. Mit angepasstem Transport und dem Shared Expert auf einem zusätzlichen Stream war die konsistente Version 3,2 % schneller als die Baseline (16834 vs. 16313 tok/s).
TP>1 und Decode Context Parallel würden die GPU-übergreifende Reduktion wieder in den verglichenen Pfad bringen und werden noch nicht unterstützt.
4.6 CUDA Graph: Graphen behalten und ihre Koexistenz mit Konsistenz ermöglichen
Warum wir sie behalten. Decode führt bei einem Token pro Anfrage Dutzende kleiner Kernels pro Layer und Schritt aus, sodass der Launch-Overhead dominieren würde; wir behalten CUDA Graph, um das Leistungsziel zu erreichen. Graphen kollidieren an drei Stellen mit bitgenauer Konsistenz.
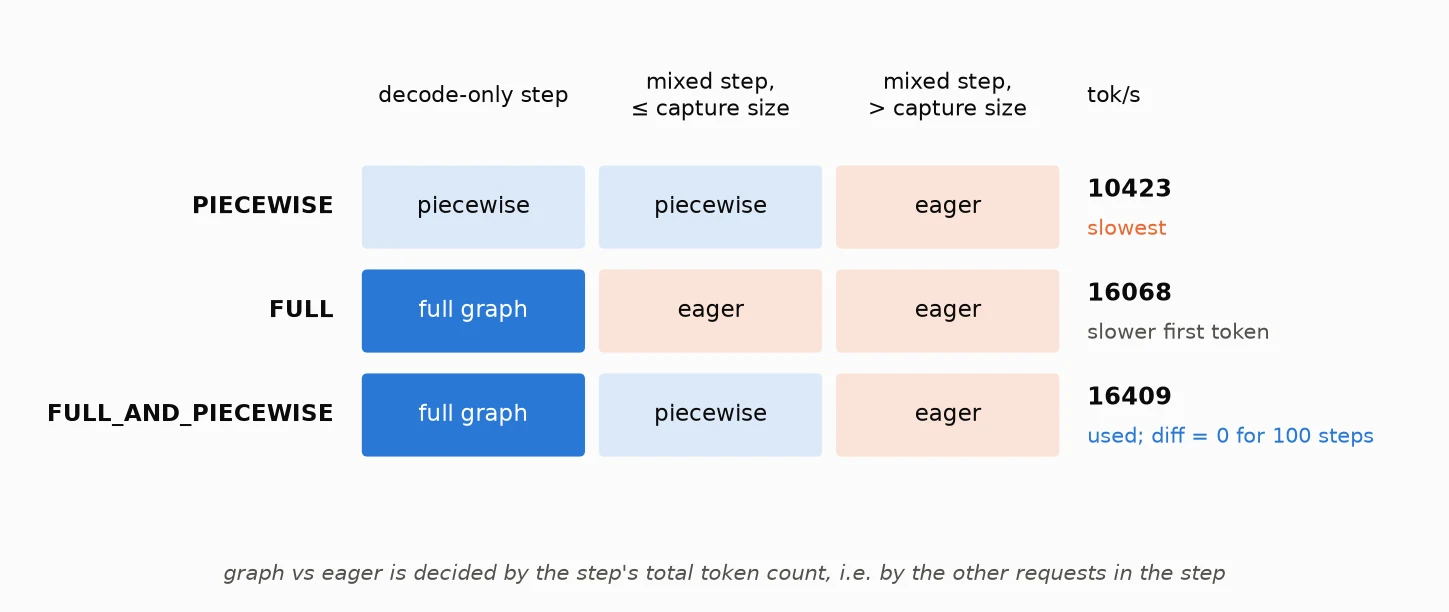
Der Pfad, den jeder Modus für drei Arten von Schritten nimmt, mit dem Durchsatz des Inferenz-Benchmarks rechts. Eine Anfrage wechselt je nach ihrem Batch zwischen Graph und Eager, daher müssen beide Pfade bitidentisch sein.
Konflikt 1: Graph oder Eager. Ein Schritt läuft im Graphen, wenn seine Gesamt-Tokenzahl in die maximale Capture-Größe passt, andernfalls in Eager, was von den anderen Tokens im Schritt abhängt, daher müssen die beiden Pfade bitidentisch sein. Das war unsere erste Diskrepanz: Ein Short-Context-Shortcut des Indexers wurde beim Capture anhand der Länge der Dummy-Eingabe in den Graphen eingebrannt. Wenn die Prüfung nur von einer statischen Obergrenze abhängt, war das Problem behoben.
Auch der Modus ist wichtig. PIECEWISE erfasst keine Attention, und FULL auf DeepSeek-V4 erfasst nur reine Decode-Schritte. Im Inferenz-Benchmark liefert FULL_AND_PIECEWISE 16409 tok/s, FULL 16068 und PIECEWISE 10423; FULL läuft bei jedem Schritt gemischt mit Prefill in Eager und erhöht die Zeit bis zum ersten Token von 764 ms auf 1792 ms. Wir verwenden FULL_AND_PIECEWISE: volle Graphen für reine Decode-Schritte, piecewise capture für gemischte Schritte; die Differenz bleibt über den 100-Schritt-Lauf hinweg bei 0.
Konflikt 2: kein Host-Sync und keine batchabhängigen Formen im Graphen. Das steht im Einklang mit Konsistenz, und viele Designs bedienen beides: Der MoE-Scheduling-Hinweis verwendet statische Kapazität, statt per-Experte-Token-Zahlen an den Host zurückzulesen (4.4); LL legt die Kommunikationsform fest (4.5); Workspaces werden nur nach Modellgrenzen dimensioniert, vor dem Capture alloziert und dann gesperrt; leistungsoptimierende Shortcut-Zweige werden zum Capture-Zeitpunkt deaktiviert.
Konflikt 3: Graphen erfassen Adressen, Gewichte ändern sich bei jedem Schritt. Der Rollout muss neue Gewichte in ihren ursprünglichen Speicher kopieren und gewichtsabgeleitete Parameter an Ort und Stelle neu berechnen, statt neuen Speicher zu allozieren, der den Graphen auf alten Adressen zurücklässt. Übereinstimmung im ersten Schritt reicht nicht aus, daher vergleicht der Skill erneut nach Update, Export und Reload.
Kosten. Workspaces, die auf ihrer Obergrenze reserviert sind, kosten etwas Speicher. Andere Geschwindigkeitswiederherstellungen (Entfernen unnötigen Debug-Paddings und Cold Start aus dem Rollout, schnelleres Nullen des KV-Cache) gelten für beide Läufe; die Baseline muss sie ebenfalls erhalten, sonst ist die Zahl des Leistungsverlusts bedeutungslos.
5. Senkung der Ingenieurskosten mit Agent + Skill
A und B können koexistieren, aber die Master-Tabelle aus Abschnitt 4 und die wichtigsten Entscheidungen darin erfordern Fachwissen: welches Backend batch-invariant ist, dass diskrete Auswahlmöglichkeiten ausgerichtete Gleichstände und Ordnung benötigen, wie man Quantisierung und Merge-Reihenfolge über verschiedene Kommunikationsmodi hinweg ausrichtet, und dass eine Kommunikationslücke zuerst erfordert, einen Transportunterschied auszuschließen. Ein neues Modell, eine neue Präzision oder Hardware bedeutet Neuanfang, also gilt C nicht.
Nach DeepSeek-V4-Flash stellten wir fest, dass der Großteil dieser Arbeit in zwei Kategorien fällt, jede mit einem messbaren Ziel:
- Die Differenz auf 0 bringen. Gewichte und Eingabe fixieren, den ersten Operator finden, bei dem die beiden Seiten abweichen, darauf einen minimal reproduzierbaren Repro reduzieren, ihn beheben und dann im echten Training verifizieren. Die Ausgaben werden direkt verglichen.
- Leistung optimieren und dabei die Differenz bei 0 halten. Profilieren Sie Hotspots, A/B-Vergleich einzelner Operatoren und überprüfen Sie die Konsistenz nach jeder Änderung erneut. Beschleunigungen, die Ergebnisse verändern oder nur in Mikro-Benchmarks auftauchen, nicht jedoch im echten Rollout, zählen nicht; das Verlangsamen der Basis, um die Lücke zu verkleinern, ist nicht erlaubt.
Code lesen, Aufrufketten nachverfolgen, Abweichungen lokalisieren, Repros schreiben, Kernels ändern und Regressionen erneut ausführen ist langwierige Arbeit, die sich für einen Agenten eignet, wobei der Erfolg durch Konsistenzvergleiche und Leistungsmessungen entschieden wird.
Wir haben dies als train-inference-consistency skillverpackt: Sie teilt einem Agenten mit, was er in welcher Reihenfolge tun muss und welche Bedingung jeder Schritt erfüllen muss, um zu bestehen, sodass der Prozess auf andere Modelle übertragbar ist.
Die Skill hat 11 Gates (C0–C10) mit expliziten Durchlaufbedingungen. Um den Cold Start zu beschleunigen, haben wir zuerst einige Schichten aus dem vollständigen Modell in ein kleines Modell geschnitten, dort die meisten Probleme gelöst und sind dann zum vollständigen Modell übergegangen. Fünf Schritte:
- Ziel und Basislinie festlegen (C0–C1). Die Module des Modells mit ihrer Präzision und Parallelität auflisten. Die gewöhnliche, nicht-konsistente Version (die Basislinie) auf normale hohe Leistung für die menschliche Prüfung tunen. Sie ist der Nenner für „wie viel langsamer die konsistente Version ist“.
- Inferenz auf einem kleinen Modell selbstkonsistent machen (C2–C4). Das kleine Modell (meistens 4–6 Schichten, die aus dem vollständigen Modell entnommen werden) muss jede Operatorklasse enthalten, die Wechselwirkung benachbarter Schichten beibehalten und in Schichtgröße und Quantisierung übereinstimmen, sodass es die meisten lokalen numerischen Probleme reproduziert. Volle Tiefe, langer Kontext, Multi-GPU-Layout und Speicherdruck müssen weiterhin am vollständigen Modell akzeptiert werden. Zuerst die Inferenz-Engine intern konsistent machen: Eine Anfrage liefert allein und in einem Batch dasselbe Ergebnis, und die Verarbeitung der gesamten Eingabe stimmt mit der Token-für-Token-Verarbeitung überein. Gleichzeitig nach strukturellen Problemen suchen, die die konsistente Version verlangsamen würden.
- Training anbinden (C5–C7). Das Training ruft dieselben Operatoren wie die Inferenz auf, berechnet inferenzgenerierte Daten neu und vergleicht Token für Token; bei einer Abweichung wird Schicht für Schicht nach der ersten divergierenden Schicht verglichen. Dann Backward hinzufügen und die Gradienten gegen eine Referenzimplementierung prüfen, die unabhängig vom getesteten Code ist: Ein konsistenter Forward impliziert keine korrekten Gradienten.
- RL ausführen, dann zum vollständigen Modell wechseln (C8–C9). Auf dem kleinen Modell zwei aufeinanderfolgende Updates im echten Trainingsframework ausführen und dabei vor und nach jedem Update unter derselben Gewichtsversion vergleichen. Nach menschlicher Prüfung zum vollständigen Modell wechseln und schrittweise hochskalieren, einschließlich der Prüfung des ersten Schritts nach der Wiederherstellung eines Checkpoints.
- Leistung zurückgewinnen (C10). Die teuersten Operatoren einen nach dem anderen optimieren und jedes Mal die Konsistenz erneut prüfen, dann einen gepaarten Vergleich gegen die Basislinie auf dem Delivery-Image ausführen.
Zwei Entwurfsentscheidungen sind am wichtigsten. Erstens, zwei Agenten bringen die Basislinie und die Konsistenz parallel voran: einer macht die Basislinie schnell, der andere baut die konsistente Version. Die getunte Basislinie wird für die menschliche Prüfung eingefroren, sodass der Agent sie nicht verlangsamen kann, um die Lücke zu verkleinern. Zweitens, unsere Fallstricke sind in den Prozess eingeschrieben: Das laufende Programm muss zum gelesenen Quellcode passen; Checkpoints erfordern die Prüfung des ersten Schritts nach der Wiederherstellung, nicht nur eines Speichervorgangs; jede Leistungsaussage benötigt eine faire Basislinie und nachvollziehbare Rohdaten; vor dem Vergleich von Kommunikationsengpässen bestätigen, dass beide Läufe denselben Transport verwenden (die Lektion aus 4.5).
Die Skill senkt die Kosten für Lokalisierung und Regression (Einsparungen hier noch nicht quantifiziert); sie ersetzt kein menschliches Urteil: Menschen prüfen weiterhin die Basislinie, Präzisionsabwägungen und das Rezept. Ein Beispiel ist das Routing-Drift-Problem mit mehreren Updates pro Schritt: Der Agent baute aus dem Symptom eine kleinmaßstäbliche Reproduktion, führte diskriminierende Experimente durch und eliminierte Hypothesen, und ein Mensch entschied, auf 1 Update pro Schritt umzusteigen.
6. Transfer: Nemotron, eine Mamba-Hybridarchitektur + NVFP4
Anschließend haben wir das Referenzrezept und die Skill an einem strukturell sehr unterschiedlichen Modell getestet.
Nemotron-3.5-Lightning-30B-A3B (NVFP4) ist ein Mamba-2 / Attention / MoE-Hybrid (NVFP4 W4A16 routed experts, FP8 Mamba-Projektionen, FP8 KV-Cache für Attention) auf GB200. Die Basislinie verwendet NVFP4-QAT-Training (Quantisierungsregel und Export von NVIDIA ModelOpt) + R3 route replay; die konsistente Version teilt vLLMs Forward, ohne route replay. Beide Läufe verwenden BF16-Mastergewichte und 1 Update pro Schritt.
Rekurrente Strukturen haben Präzedenzfälle. In der vLLM-Community entwarfen Alexander Jiang und das SkyRL-Team chunkwise-parallel recurrent (CPR) in IsoExec für das Gated DeltaNet (GDN) in Qwen3.5-35B-A3B: Es behält die rekurrente Form bei, berechnet aber chunk-parallel, sodass Training, Prefill und Decode eine gemeinsame Rundungsreihenfolge nutzen, und sein unified model gibt Training und Inferenz eine Modelldefinition und einen Satz ausgerichteter Kernels. IsoExecs „zero mismatch“ gilt innerhalb seines Ausführungskontrakts; Ende zu Ende meldet es dennoch eine winzige, von null verschiedene Logprob-Differenz (mittlere absolute Differenz etwa 1e-7), anders als das „bitwise identical“ dieses Beitrags. Mamba-2 ist dieselbe Art linearer Rekurrenz. Wir lassen Decode exakt die gechunkte Arithmetik des Prefill wiedergeben statt seiner eigenen Einzelschritt-Rekurrenz, und das Training importiert dieselben Operatoren wie die Inferenz, wie im unified model. Agent + Skill haben diese Ausrichtung vorgenommen.
In vLLM erhält jeder Operator, der von der Batch-Zusammensetzung abhängen könnte, eine batch-invariante Implementierung, und das Training (ein leichtgewichtiger Megatron-LM-Fork) importiert sie:
| Operator | Konsistente Version |
|---|---|
| Mamba-2 SSD-Scan | decodiert exakt die gechunkte Arithmetik des Prefill nach, feste Autotune-Konfiguration, fp32-State |
| Attention | FlashAttention mit festem Split-KV, Split-Anzahl unabhängig vom Batch |
| Geroutete Experten (NVFP4 W4A16: 4-Bit-Gewichte, 16-Bit-Aktivierungen) | CuTe-DSL grouped GEMM, einzelne Taktik, kein Split-K, fp32-Merge in Slot-Reihenfolge |
| MoE All-to-All | einseitige Kommunikation, feste Merge-Reihenfolge |
| Router GEMM | Batch-invariantes persistentes Matmul, fp32-Ausgabe |
| Norm / FP8-Quantisierung | Vereinheitlichte batch-invariante Kernels; wertverändernde Fusionen verboten |
Ergebnisse: Training auf SWE-bench Pro
Wir betreiben agentisches RL auf SWE-bench Pro in entfernten Sandboxes: 32 Aufgaben × 8 Trajektorien pro Schritt, durchschnittlich etwa 57K Token pro Trajektorie, GRPO, 8 GB200-Nodes pro Lauf. Der Trainingssatz besteht aus den 375 SWE-bench-Pro-Aufgaben, bei denen die 4 gesampelten Versuche des Basemodells weder alle richtig noch alle falsch waren und der Gold-Patch in unserer Sandbox durchläuft, daher sind die folgenden Scores Trainingsbelohnungen auf dieser Teilmenge. Beide Läufe verwenden dasselbe Image und dieselbe Rezeptur, ohne Korrekturen wie TIS oder MIS. Bei 1 Update pro Schritt ist die KL zwischen den Pre-Update-Rollout-Logprobs und der trainingsseitigen Neuberechnung die Train-Inference-KL dieses Schritts.
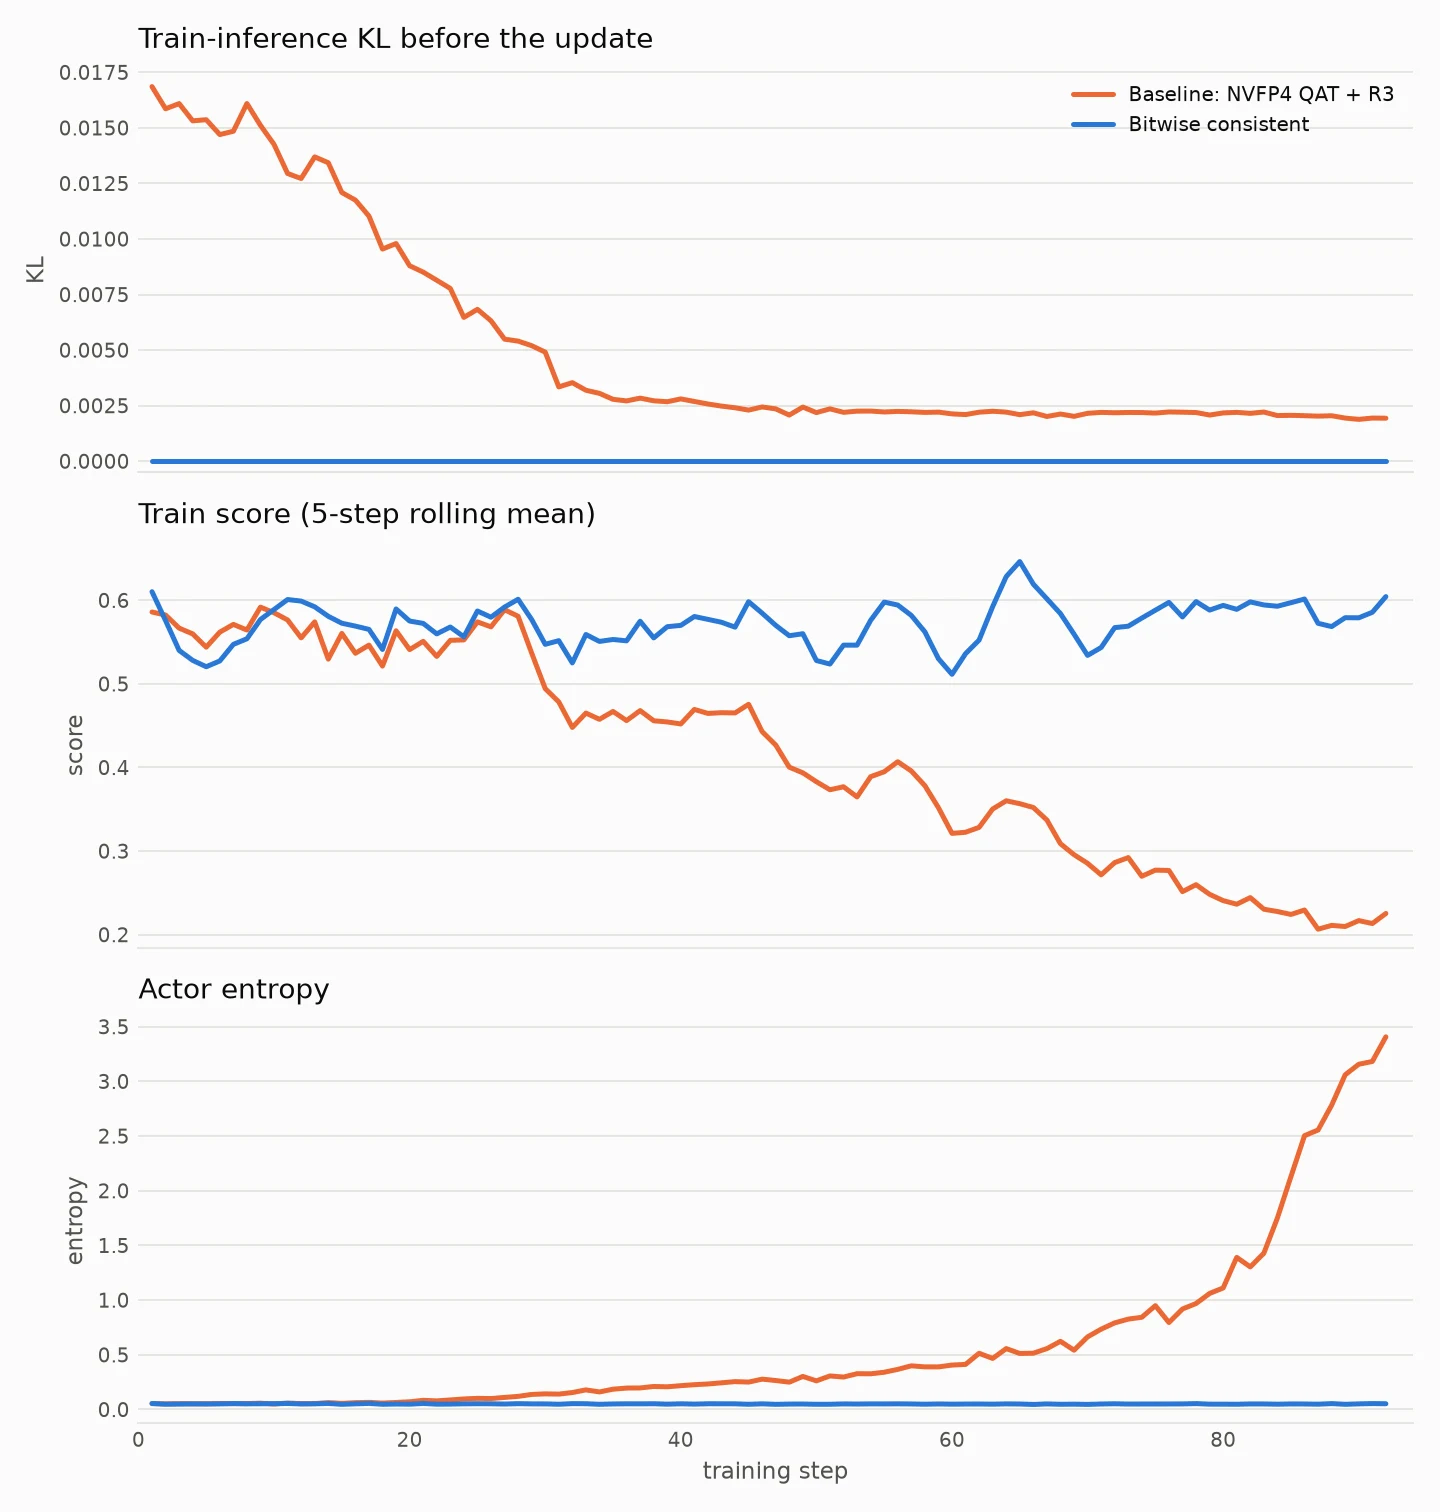
Oben: Train-Inference-KL pro Schritt; Mitte: Trainingsscore (gleitender Durchschnitt über den aktuellen und die vorherigen 4 Schritte); unten: Actor-Entropie. Orange: Baseline; blau: konsistente Version. Bei konsistentem-Version-Schritt 10 kehrten nur wenige Trajektorien aus der Sandbox zurück, daher ist ihr Score ausgeschlossen.
- Konsistente Version: die Train-Inference-KL ist bei jedem Schritt genau 0, die Entropie bleibt um 0.05, und der Score steigt von 0.56 (erste 10 Schritte) auf 0.59 (letzte 10), ohne Einbruch.
- Baseline: die Train-Inference-KL fällt von ~0.015 auf ~0.002, aber die Entropie steigt von 0.05 auf 2.6 und der Score fällt von 0.56 auf 0.22 (erste 10 Schritte vs. letzte 10).
- Rollout-Geschwindigkeit: über die ersten 30 Schritte, während beide Läufe gesund sind, beträgt der Rollout-Durchsatz der konsistenten Version 87.5% des der Baseline, also nur 12.5% langsamer.
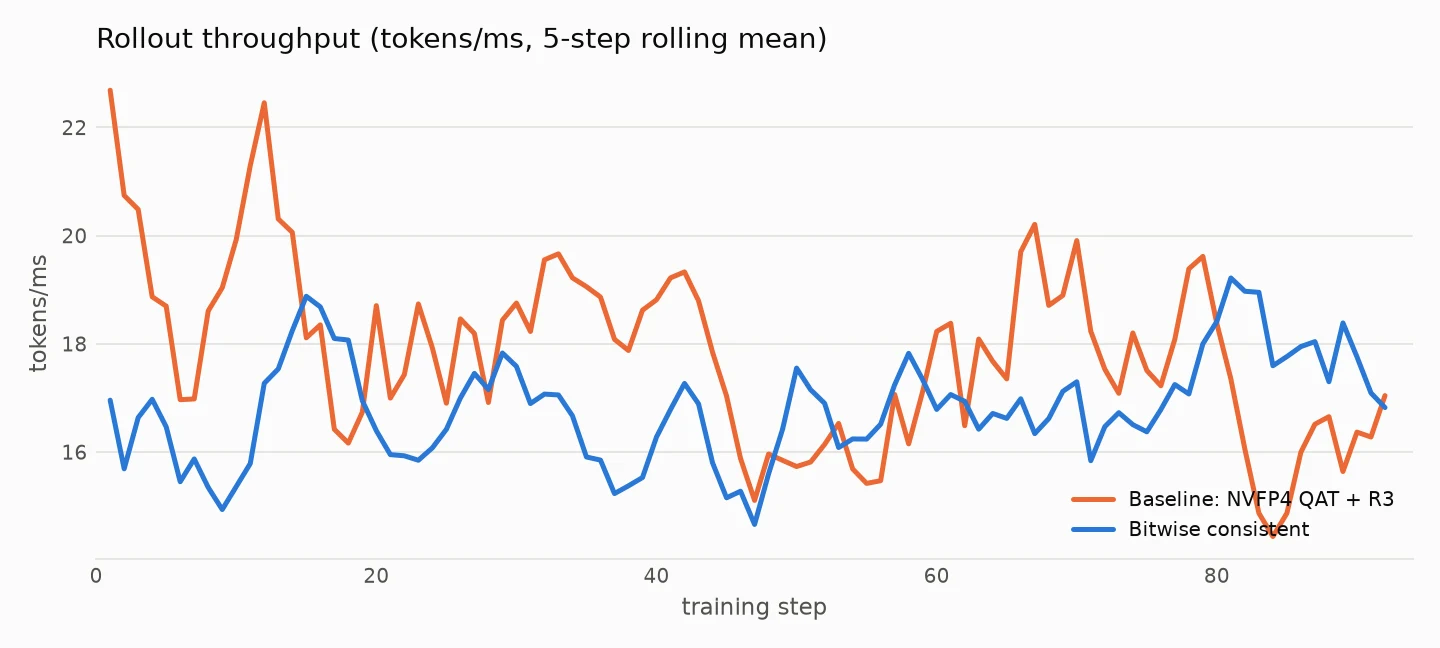
Rollout-Durchsatz pro Schritt (token/ms, gleitender Durchschnitt über den aktuellen und die vorherigen 4 Schritte). Orange: Baseline; blau: konsistente Version.
7. Open Source
Wir machen dies als Open Source verfügbar, damit andere Train-Inference-Konsistenz mit weniger Abhängigkeit von erfahrenen Ingenieuren erreichen können, die Operator für Operator prüfen – mithilfe des Skills, fertigen Codes und eines Agents auf ihrem eigenen Modell. Die Veröffentlichung umfasst:
- Train-Inference-Consistency-Skill: der vollständige Workflow (C0–C10), zehn Anleitungen und wichtige Praktiken wie Logprob-Vergleich und Gradienten-Gegenprüfung;
- DeepSeek-V4: eine echte On-Policy-RL-Rezeptur, die 0 diff auf Megatron und vLLM erreicht, verl-project/verl#7688;
- Nemotron-3.5-Lightning-30B-A3B (BF16-Mastergewichte, im Training-Forward und bei der Gewichtssynchronisierung auf das Deployment-NVFP4 quantisiert):
- vLLM bitweise konsistente Inferenz, ausgerichtet am Training: aoshen02/vllm#85;
- Ein Training-Actor, ausgerichtet an vLLM: aoshen02/Megatron-LM#7;
- Zwei verl-Änderungen: aoshen02/verl#11;
- Train-Inference-Consistency-Rezeptur und einheitliches Image-Dockerfile: aoshen02/verl#12.
Issues, PRs und Feedback aus der Nutzung des Skills auf Ihrem eigenen Modell sind willkommen.
Weiter: Die Train-Inference-Konsistenz für DeepSeek-V4.1 hat 0 diff erreicht; die Leistungsoptimierung läuft und wird einen eigenen Beitrag erhalten.
Danksagungen
Dank an (Organisationen in alphabetischer Reihenfolge):