
Unser neuestes Release, Apertus 1.5, erweitert die 8B- und 70B-Modelle von Apertus 1.0 um Bild-/Audioverständnis, einen optionalen Denkmodus, ein vierfach längeres Kontextfenster, verbessertes Befolgen von Anweisungen und bessere Werkzeugnutzung. Die aktualisierten 8B- und 70B-Modellgewichte wurden am 24. Juli 2026 unter einer Apache 2.0 Lizenz auf Hugging Face veröffentlicht. Weitere Details sind jetzt im Technical Reportdes Projekts verfügbar und werden hier zusammengefasst.
Apertus 1.5 ist ein fortgesetztes Pretraining des Modells der ersten Generation: Dem 8B-Modell wurden 4 Billionen Token an Text- und multimodalen Trainingsdaten hinzugefügt und dem 70B-Modell 2 Billionen Token, insgesamt also 19T bzw. 17T. Wie bei jeder Apertus-Veröffentlichung sind die Modelle vollständig offen: offene Gewichte, offene Daten, offene Werteund vollständige Trainings details.
Wichtige Verbesserungen
- Natives multimodales Verständnis: Apertus 1.5 akzeptiert Bilder und Audio neben Text und bringt Dokumente, Diagramme und Fotos in die Konversation. Die Modelle können auch gesprochene Sprache verarbeiten, wobei dies noch experimentell bleibt.
- Denkmodus: Die Modelle können in einen Denkmodus geschaltet werden, um vor der Antwort über die Eingabe nachzudenken, was die Leistung bei Denkaufgaben verbessert.
- Langer Kontext: Das Kontextfenster wächst auf 262,144 Token, eine 4-fache Vergrößerung gegenüber Apertus 1.0.
- Verbessertes Befolgen von Anweisungen: Eine bessere Einhaltung von Anweisungen als bei Apertus 1.0 liefert vorhersehbarere und genauere Antworten.
- Verbesserte Werkzeugnutzung: Die Modelle sind für eine bessere Werkzeugintegration trainiert, was eine effektivere Nutzung externer Werkzeuge und APIs ermöglicht.
- Offene Werte: Stärkere Orientierung an der Apertus-Charta, die Transparenz über die Werte und Prinzipien des Modells schafft.
Trainingsprozess
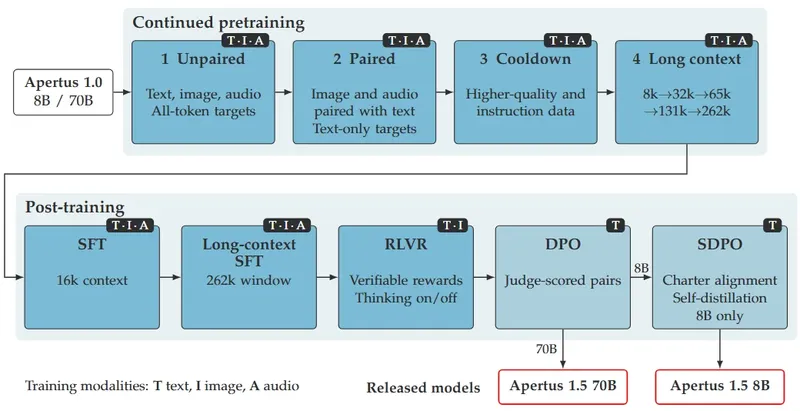
 Die vollständige Apertus-1.5-Trainingspipeline
Multimodalität über den Tokenizer
Wir führen Multimodalität in den v1.5-Modellen in Form einer Early-Fusion ein, bei der Bilder und Audio als diskrete Token in derselben Sequenz wie die Text-Token in Apertus einfließen, anstatt einen separaten Vision-Encoder zu verwenden. Bilder werden mit dem tokenisiert Emu3.5 Tokenizer (ein 512×512-Bild wird zu 1,024 Tokens) und Audio mit WavTokenizer (40 Tokens pro Sekunde). Wir erweitern nur das Vokabular, die Architektur bleibt unverändert und das Training läuft mit reiner Textgeschwindigkeit. Die Modelle verstehen Bilder und Audio, generieren aber nur Text.

Pre-Training
Ausgehend von Apertus 1.0 setzen wir das Pretraining in vier Stufen fort:
- Unpaired: Text plus eigenständige Bilder und Audio, damit das Modell die neuen Modalitäten lernt.
- Paired: Bild-Beschriftungs- und Audio-Transkript-Paare, damit es sie mit Sprache ausrichtet.
- Cooldown: Daten höherer Qualität mit mehr Mathematik und Code.
- Long context: Das Fenster wächst Schritt für Schritt von 8k auf 262k Tokens.
Insgesamt sind mehr als die Hälfte der Trainingstokens reiner Text, was die Sprachfähigkeiten von Apertus 1.0 bewahrt. Die Textdaten werden mit Quellen wie FineWeb2-HQ+, FinePDFs und Nemotron-CC aufgefrischt. Alle neuen Daten, multimodale eingeschlossen, erfüllen denselben Standard wie zuvor: öffentlich verfügbar, großzügig lizenziert und mit rückwirkend respektierten robots.txt-Opt-outs. Jede Quelle ist in apertus-data-transparency.
Post-Training
Das Post-Training läuft in fünf Stufen: SFT → Long-Context-SFT → RL → DPO → Charter-Ausrichtung (SDPO).
- SFT auf 3.7M Textbeispielen plus Bild- und Sprachdaten. Reasoning Traces werden nur zu Prompts hinzugefügt, die das Modell nicht bereits ohne sie lösen kann. Tool-Use-Daten sind auf ausführungsgeprüfte Trajektorien beschränkt. Wir veröffentlichen die Text-SFT-Mix , den wir auf Hugging Face verwendet haben.
- Long-context SFT am vollen 262k-Fenster stellt die Long-Context-Fähigkeit wieder her, die das Short-Context-SFT abbaut.
- RL mit verifizierbaren Belohnungen (RLVR) auf etwa 350k Mathematik-, Code-, Instruktionsbefolgungs-, mehrsprachigen und Vision-Prompts, mit gemischtem An- und Ausschalten des Denkens.
- DPO mit von einem Judge bewerteten Präferenzpaaren verbessert Chat-Qualität, Werkzeugnutzung und Sicherheit. Wir veröffentlichen den Präferenz-Pool und die Trainingspaare.
- SDPO richtet das Modell an der Apertus Charter aus, mithilfe von Judge-Feedback und Selbstdistillation.
Evaluationsergebnisse
Neben den erweiterten Modellfähigkeiten haben wir auch den Umfang der Evaluationen erheblich ausgebaut. Über die bestehenden textbasierten Evaluationen für Apertus 1.0 hinaus haben wir multimodale Evaluationen (Bild & Audio) sowie Evaluationen des Thinking-Modus hinzugefügt.
Die multimodalen Evaluationen erfolgen über die MLLM-eval-suite -Pipeline, die zwei große multimodale Evaluations-Frameworks zusammenführt: lmms-eval und VLMEvalKit. Zudem haben wir eine Reihe textbasierter Benchmarks sowie erweiterte Benchmarking-Verfahren für Übersetzungs- und mehrsprachige Fähigkeiten, Sicherheit und Werkzeugnutzung hinzugefügt. Diese finden sich in unserem Post-Training- Evaluation-Repository, basierend auf einem lm-evaluation-harness fork.
Während das neue Release weiterhin hinter Frontier-Modellen mit offenen Gewichten zurückliegt, hat es auch die Leistung in Programmierung und Befehlsbefolgung deutlich verbessert, wobei Apertus 1.5 8B vergleichbar große Modelle mit offenen Gewichten bei IF- und mehrsprachigen Aufgaben übertrifft. Thinking verbessert die Leistung bei anspruchsvollen, reasoning-lastigen Benchmarks wie AIME weiter. Die multimodale Leistung des Modells liegt näher bei Gemma 4 12B und anderen aktuellen Modellen mit offenen Gewichten. Die multimodale Leistung von Apertus 1.5 ist bei räumlichem Verständnis unter Modellen mit offenen Gewichten und bei Dokument-/Diagrammverständnis unter Open-Source-Modellen konkurrenzfähig.
Wir danken auch unseren Kooperationspartnern und externen Evaluatoren für ihre Hilfe beim effizienten Benchmarking der Apertus-Fähigkeiten. Insbesondere zeigt Apertus 1.5 eine starke Leistung bei Swiss Legal Aufgaben und liegt damit auf Augenhöhe mit führenden Modellen mit offenen Gewichten (Blog, Code). Darüber hinaus präsentiert Apertus 1.5 8B beim Last Translation Benchmark maschinelle Übersetzungsfähigkeiten, die mit GPT-OSS-20B übereinstimmen und Modelle wie Claude Haiku 4.5 oder Google Translate (Bestenliste, Paper).
Evaluation Cards: Apertus ❤️ EvalEval
Apertus arbeitet zusammen mit der EvalEval Coalition um ein vollständig transparentes und reproduzierbares Benchmarking sicherzustellen. Wir veröffentlichen die Ergebnisse von Apertus 1.5 im Every Eval Ever (EEE) Schema, einem gemeinsamen Format, das nicht nur Punkte erfasst, sondern auch, wer die Evaluierung durchgeführt hat, wie auf das Modell zugegriffen wurde, die Generierungseinstellungen und wie jede Metrik zu interpretieren ist: Details, die in Bestenlisten regelmäßig fehlen und die oft erklären, warum ähnlich aussehende Punkte unterschiedlich ausfallen.
Die Ergebnisse sind in der untenstehenden Eval Card dargestellt, die die Run-Daten mit Benchmark- und Modell-Metadaten zu einem interpretierbaren Datensatz zusammenführt, und sind außerdem verfügbar über Hugging Face Community Evals. Dies ist dieselbe Infrastruktur, die das UK AI Security Institute nutzt, um seine Evaluierungen offen zu veröffentlichen. Da unsere Textevaluierungen auf unserem öffentlichen Fork von lm-evaluation-harness laufen, den EEE mit einem dedizierten Konverter unterstützt, kann jeder sie erneut ausführen und seine Zahlen unter identischen Einstellungen mit unseren vergleichen.
Strukturierte Evaluationsberichterstattung ist auch außerhalb der Forschung wichtig. EvalEval hat Evaluation Cards auf Anforderungen der KI-Governance abgebildet, einschließlich Artikel 55 des EU AI Act und des GPAI Code of Practice, und festgestellt, dass das EEE-Schema 56 der 60 Elemente für Evaluationsberichterstattung darstellen kann, die diese Rahmenwerke verlangen. Dies passt dazu, wie wir Apertus bereits veröffentlichen: Neben den Modellen veröffentlichen wir eine Public Summary der Trainingsinhalte sowie freiwillig ein Code of Practice -Dokument. Maschinenlesbare Evaluationsdatensätze sind ein natürlicher nächster Schritt: Sie erleichtern es Aufsichtsbehörden, Deployern und Forschenden, die Evidenz hinter einem Modell zu finden, zu interpretieren und zu vergleichen.
Wir setzen uns dafür ein, reproduzierbare und transparente Evaluation durch Eval Cards und das EEE-Schema zu fördern, und ermutigen andere Modellentwickler, ihre Ergebnisse auf dieselbe Weise zu berichten, damit Scores über Modelle und Organisationen hinweg vergleichbar sind.
Apertus 1.5 Reproduzierbarkeit
Alle Rezepte, Ablationen und Datenmischungen sind im Technical Reportdokumentiert. Wir möchten die Entwicklung offener Modelle populär machen, indem wir den Trainingsprozess von v1.5 öffentlich und zugänglich machen. Zwischen-Checkpoints werden in unserer Apertus 1.5 Hugging Face collectiongehostet, einschließlich der Basis-Gewichte, SFT, RLVR und DPO, sowie unserer kuratierten Trainingsdatenmischungen/eigenen Datensätze in der Apertus 1.5 datasets collection. Das Teilen dieser Ressourcen ermöglicht es Forschenden, zu untersuchen, wie jede Stufe das Modellverhalten verändert.
Der Bericht deckt zahlreiche Ablationen zur Wirkung von Post-Training-Daten in verschiedenen Stufen ab, wobei wir beobachteten, dass multimodale Daten, die während des SFT zusammen mit Textdaten gemischt werden, über alle Modalitäten hinweg zu Verbesserungen beitragen. Wir stellen außerdem fest, dass die Vorteile multimodaler Reasoning-Traces das nachfolgende nur-textbasierte Reinforcement Learning überdauern: Beginnend von einem SFT-Checkpoint, der mit multimodalen Traces trainiert wurde, verbessert RL die Mathematik mehr als bei einem nur-textbasierten Checkpoint, und der Vorteil bei Reasoning-Aufgaben bleibt während des gesamten Trainings bestehen.
| Modelle | 8B | 70B |
|---|---|---|
| Pre-Training (Long-Context-Basis) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| Supervised Finetuning (SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| Reinforcement Learning (RLVR) | Apertus-v1.5-8B-RLVR | Apertus-v1.5-70B-RLVR |
| Präferenz-Ausrichtung (DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (finale Version) |
| Charta-Abstimmung (SDPO) | Apertus-v1.5-8B (finale Version) | – |
| Phase | Daten | Code / Rezept |
|---|---|---|
| Vortraining: Phasen 1–2 (ungepaart, gepaart) | Alle Quellen mit Versionen und Lizenzen in apertus-data-transparency; Rezepte für Bild- und Audioverarbeitung in multimodal-data | Megatron-LM, Startskripte in pretrain-code, apertus-omni-tokenizer, benchmark-image-tokenizer, benchmark-audio-tokenizer (einschließlich Builder für verschränkte Sprache–Text) |
| Vortraining: Phase 3 (Abkühlphase) | apertus-data-transparency; kuratierte Bilddatensätze NASA, Our World in Data, Smithsonian, swisstopo | Megatron-LM, Startskripte in pretrain-code |
| Long-context extension | apertus-data-transparency; synthetische Long-Context-Aufgaben in LongContextQA | Megatron-LM, Startskripte in pretrain-code |
| SFT | Apertus-v1.5-SFT-mix (multimodaler SFT-Mix, im Bericht aufgeführt) | posttraining-data, Megatron-LM (SFT-Startskripte) |
| Long-context SFT | Teilmengen des SFT-Mix (im Bericht aufgeführt), plus LongContextQA Aufgaben | Megatron-LM |
| RL (RLVR) | Im Bericht aufgeführte Mischung | verl, verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool (annotierte Completions), Apertus-v1.5-Preference-Data (Paare) | posttraining, verl |
| SDPO (Charter Alignment, nur 8B) | gretelai/gretel-safety-alignment-en-v1 | Selbstdistillation |
Modellverfügbarkeit
Proton Lumo und Infomaniak Euria sind zwei weit verbreitete Apps, die kürzlich Apertus 1.5 integriert haben. Diese Deployments sind unter anderem in der Community Showcase verlinkt – siehe diesen Diskussionsthread für eine Vorschau.
Der Zugriff auf Apertus 1.5 in Form einer API für Entwickler wurde von einer Reihe von Anbietern angekündigt, darunter Swisscom, Infomaniak, Phoeniqsund andere Unternehmen, die in unserem General-Availability-Leitfadenaufgeführt sind. Der Bericht enthält auch Details dazu, wie wir mit externen Evaluatoren zusammenarbeiten, um die Modelle zu testen und vorzubereiten.
Technische Anleitungen zum Ausführen der Modelle finden sich in den Modellkarten der Apertus-Releases auf Hugging Face und in unserem Quickstart-Leitfaden.
Wie Sie sich einbringen können
Danke, dass Sie diesen Blogbeitrag gelesen haben und Teil unserer Community sind! Wir haben gerade fünf Millionen Downloads in unserer Hugging-Face-Analytik gefeiert 🤗 und verlangsamen unser Tempo nicht. Beim kürzlichen AI+X Summit in Zürich kündigte unser Team die Roadmap für Apertus 2.0: Sparse-/MoE-Architektur, insgesamt ~600B Parameter, verlängerter Trainingszeitplan, mit Agents, Mathematik und Programmieren als Prioritäten.
Zusammengefasst: Wir laden Sie ein, unseren Bericht zu lesen, die Modelle herunterzuladen, die Zwischen-Checkpoints zu erkunden, die Gewichte zu finetunen und unsere Auswertungen zu reproduzieren. Fragen, die nicht bereits in unseren Publikationen oder im Website-FAQ beantwortet werden, sind jederzeit willkommen, und wir würden auch gerne erfahren, welche Themen für die Community bei künftigen Deep Dives am nützlichsten wären.
Wenn Sie mit Apertus bauen oder es verwenden, füllen Sie bitte das Showcase-Formularaus und kontaktieren Sie uns über die Optionen auf unserer Kontaktseite. Wir freuen uns darauf, weitere Arbeiten hervorzuheben, zu erfahren, was Sie entwickeln, und zu hören, wie Apertus verbessert werden kann!
Zitation
Project Apertus, et al. „Apertus 1.5: From Open Text Models to Open Multimodal Reasoners.“ arXiv:2610.15542. Preprint, arXiv, 11. Oktober 2026. https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}