
Thinking
Zusammenfassung
Timestral, Mistrals erste Familie von Fundamentmodellen für Zeitreihen, liefert state-of-the-art probabilistische, multivariate Prognosen mit nur 209M Parametern und übertrifft auf zentralen Benchmarks größere Modelle, während es vergangene und zukünftige Kovariaten unterstützt. In vier Größen erhältlich (5M bis 209M Parameter), bietet es eine Balance aus Genauigkeit und Effizienz, läuft effizient auf CPUs und punktet beim Zero-shot-Forecasting in verschiedensten Domänen. Das Modell kombiniert synthetisches Pre-Training, covariatenbewusste Aufmerksamkeit und Long-Context-Learning, mit Feinabstimmungsoptionen zur Domänenanpassung über Mistral Forge.
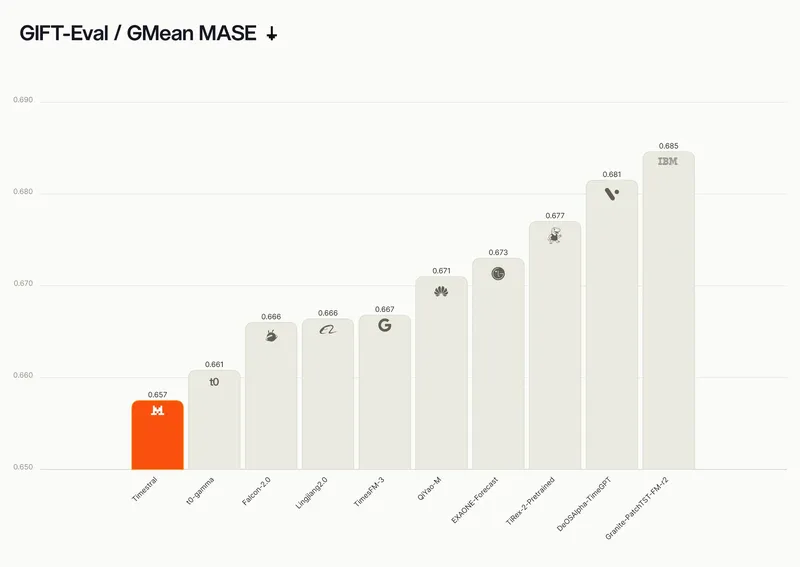
Heute veröffentlichen wir Timestral, unsere erste Familie von Fundamentmodellen für Zeitreihen. Unser größtes Modell, mit nur 209M Parametern, belegt den ersten Platz auf allen drei wichtigsten öffentlichen Benchmarks des Fachgebiets, GIFT-Eval, TIME und fev-bench, und übertrifft den bisherigen Stand der Technik mit nur zwei Dritteln der Modellparameter.
Timestral liefert probabilistische, multivariate Prognosen und unterstützt past-only- sowie known-future-Kovariaten. Unsere Modellfamilie liegt auf der Pareto-Front von Prognosegenauigkeit versus Modellgröße und liefert bei jeder Größe führende Leistung. Die Ergebnisse wurden an die GIFT-Eval- und TIME-Leaderboards übermittelt.
Time Series Foundation Models (TSFM)
Zeitreihen sind einer der häufigsten Datentypen im Unternehmen, von Sensor-Telemetrie bis zu Observability-Metriken. Darauf aufbauende Prognosen treiben Entscheidungen in Kapazitätsplanung, Energie, Lieferketten, Risiko und Wartung.
Industrieanlagen prognostizieren Prozesssensoren anhand des Produktionsplans, erkennen das Abdriften von Ausrüstung, bevor sie ausfällt, und planen Kapazitäten und Ersatzteile über Tausende von Anlagen hinweg. Finanzteams prognostizieren Ströme, Volumina und Volatilität, um Positionen, Absicherung und Treasury über Tausende von Konten hinweg zu steuern.
Klassische Modelle wie ARIMA und lineare Regression bleiben bewährte Werkzeuge zur Prognose von Zeitreihen. Diese Modelle werden üblicherweise an eine einzelne Reihe angepasst und lernen nur aus der Historie dieser Reihe.
Deep-Learning-Modelle wie PatchTST bieten die Kapazität, nichtlineare Muster über viele verwandte Reihen hinweg zu lernen, werden aber dennoch typischerweise von Grund auf für jeden Datensatz trainiert, sodass das Gelernte nicht auf neue Domänen übertragbar ist.
Fundamentmodelle für Zeitreihen bringen den Pre-Training-Ansatz auf Zeitreihen. Trainiert auf einem großen und vielfältigen Korpus lernt unser Modell Muster, die über Reihen hinweg übertragbar sind, und prognostiziert zero-shot auf Daten, die es nie gesehen hat, sogar in Domänen, in denen Daten knapp sind.
Benchmark-Ergebnisse
Wir haben Timestral auf den drei wichtigsten öffentlichen Prognose-Benchmarks evaluiert: GIFT-Eval, TIME und fev-bench. Unter den vortrainierten Zero-shot-Modellen belegt es den ersten Platz in allen fünf Metriken. Diese Ergebnisse stammen aus einem einzigen Checkpoint, ohne Ensembling.
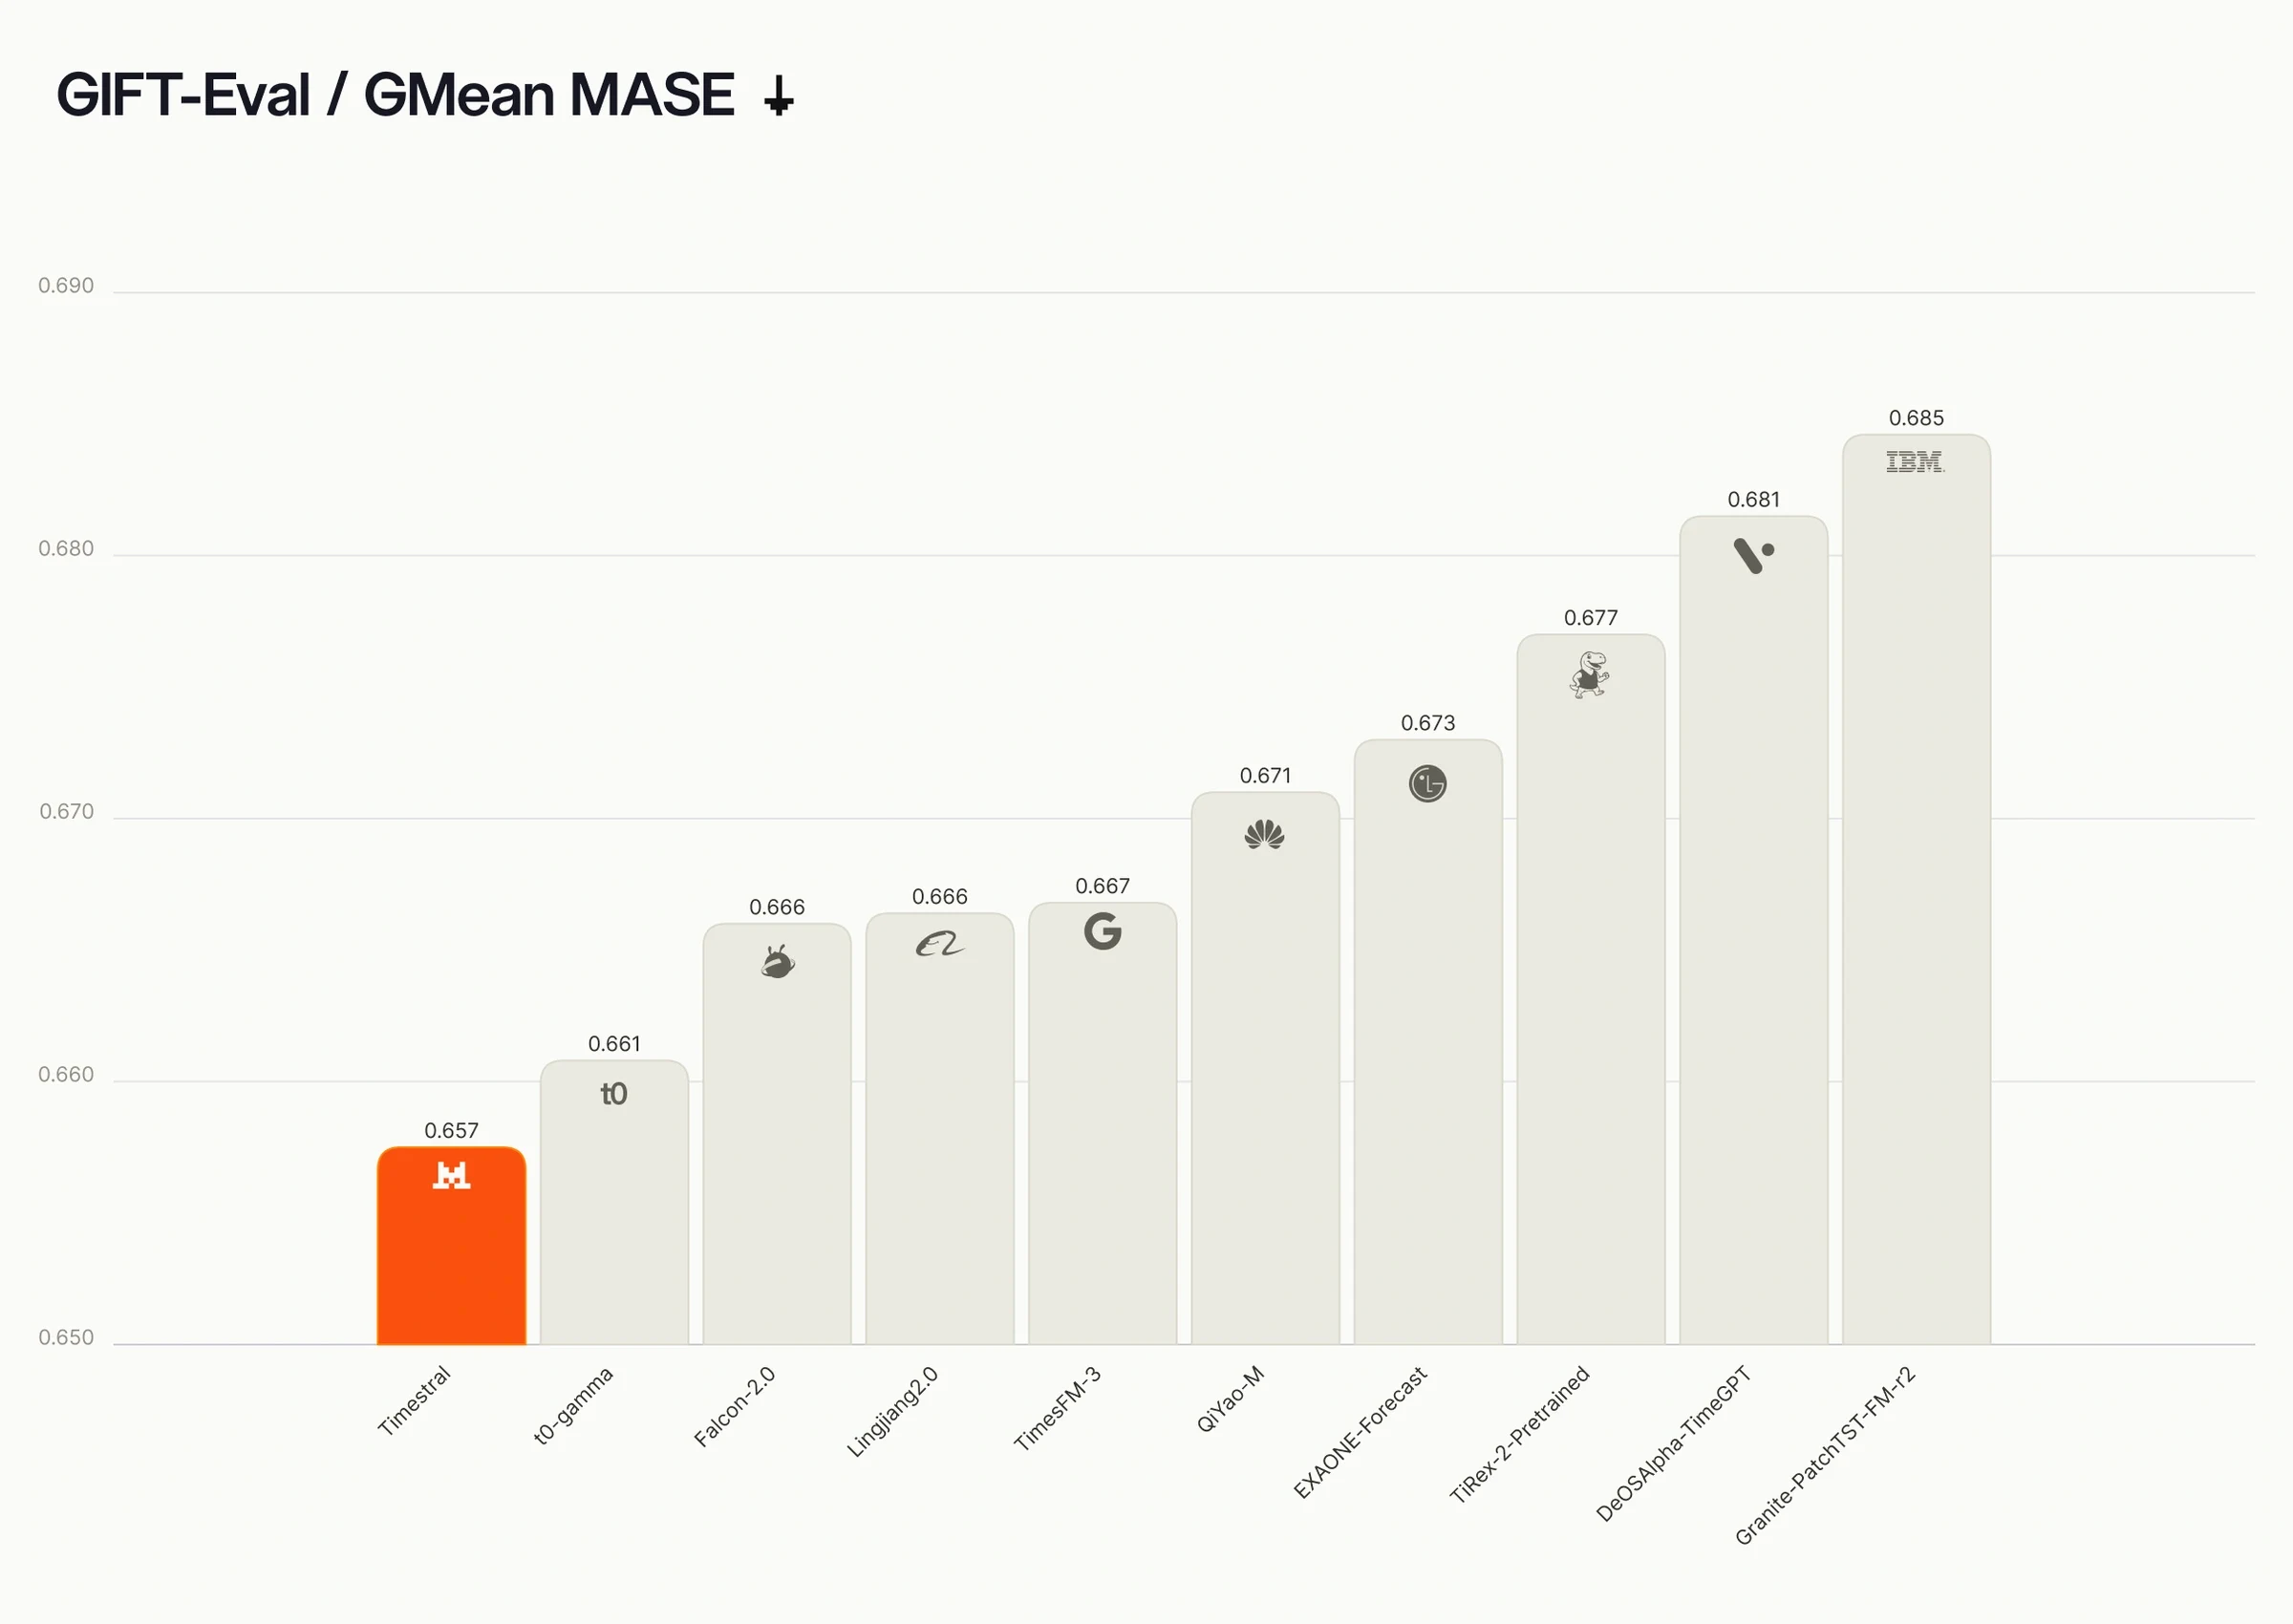
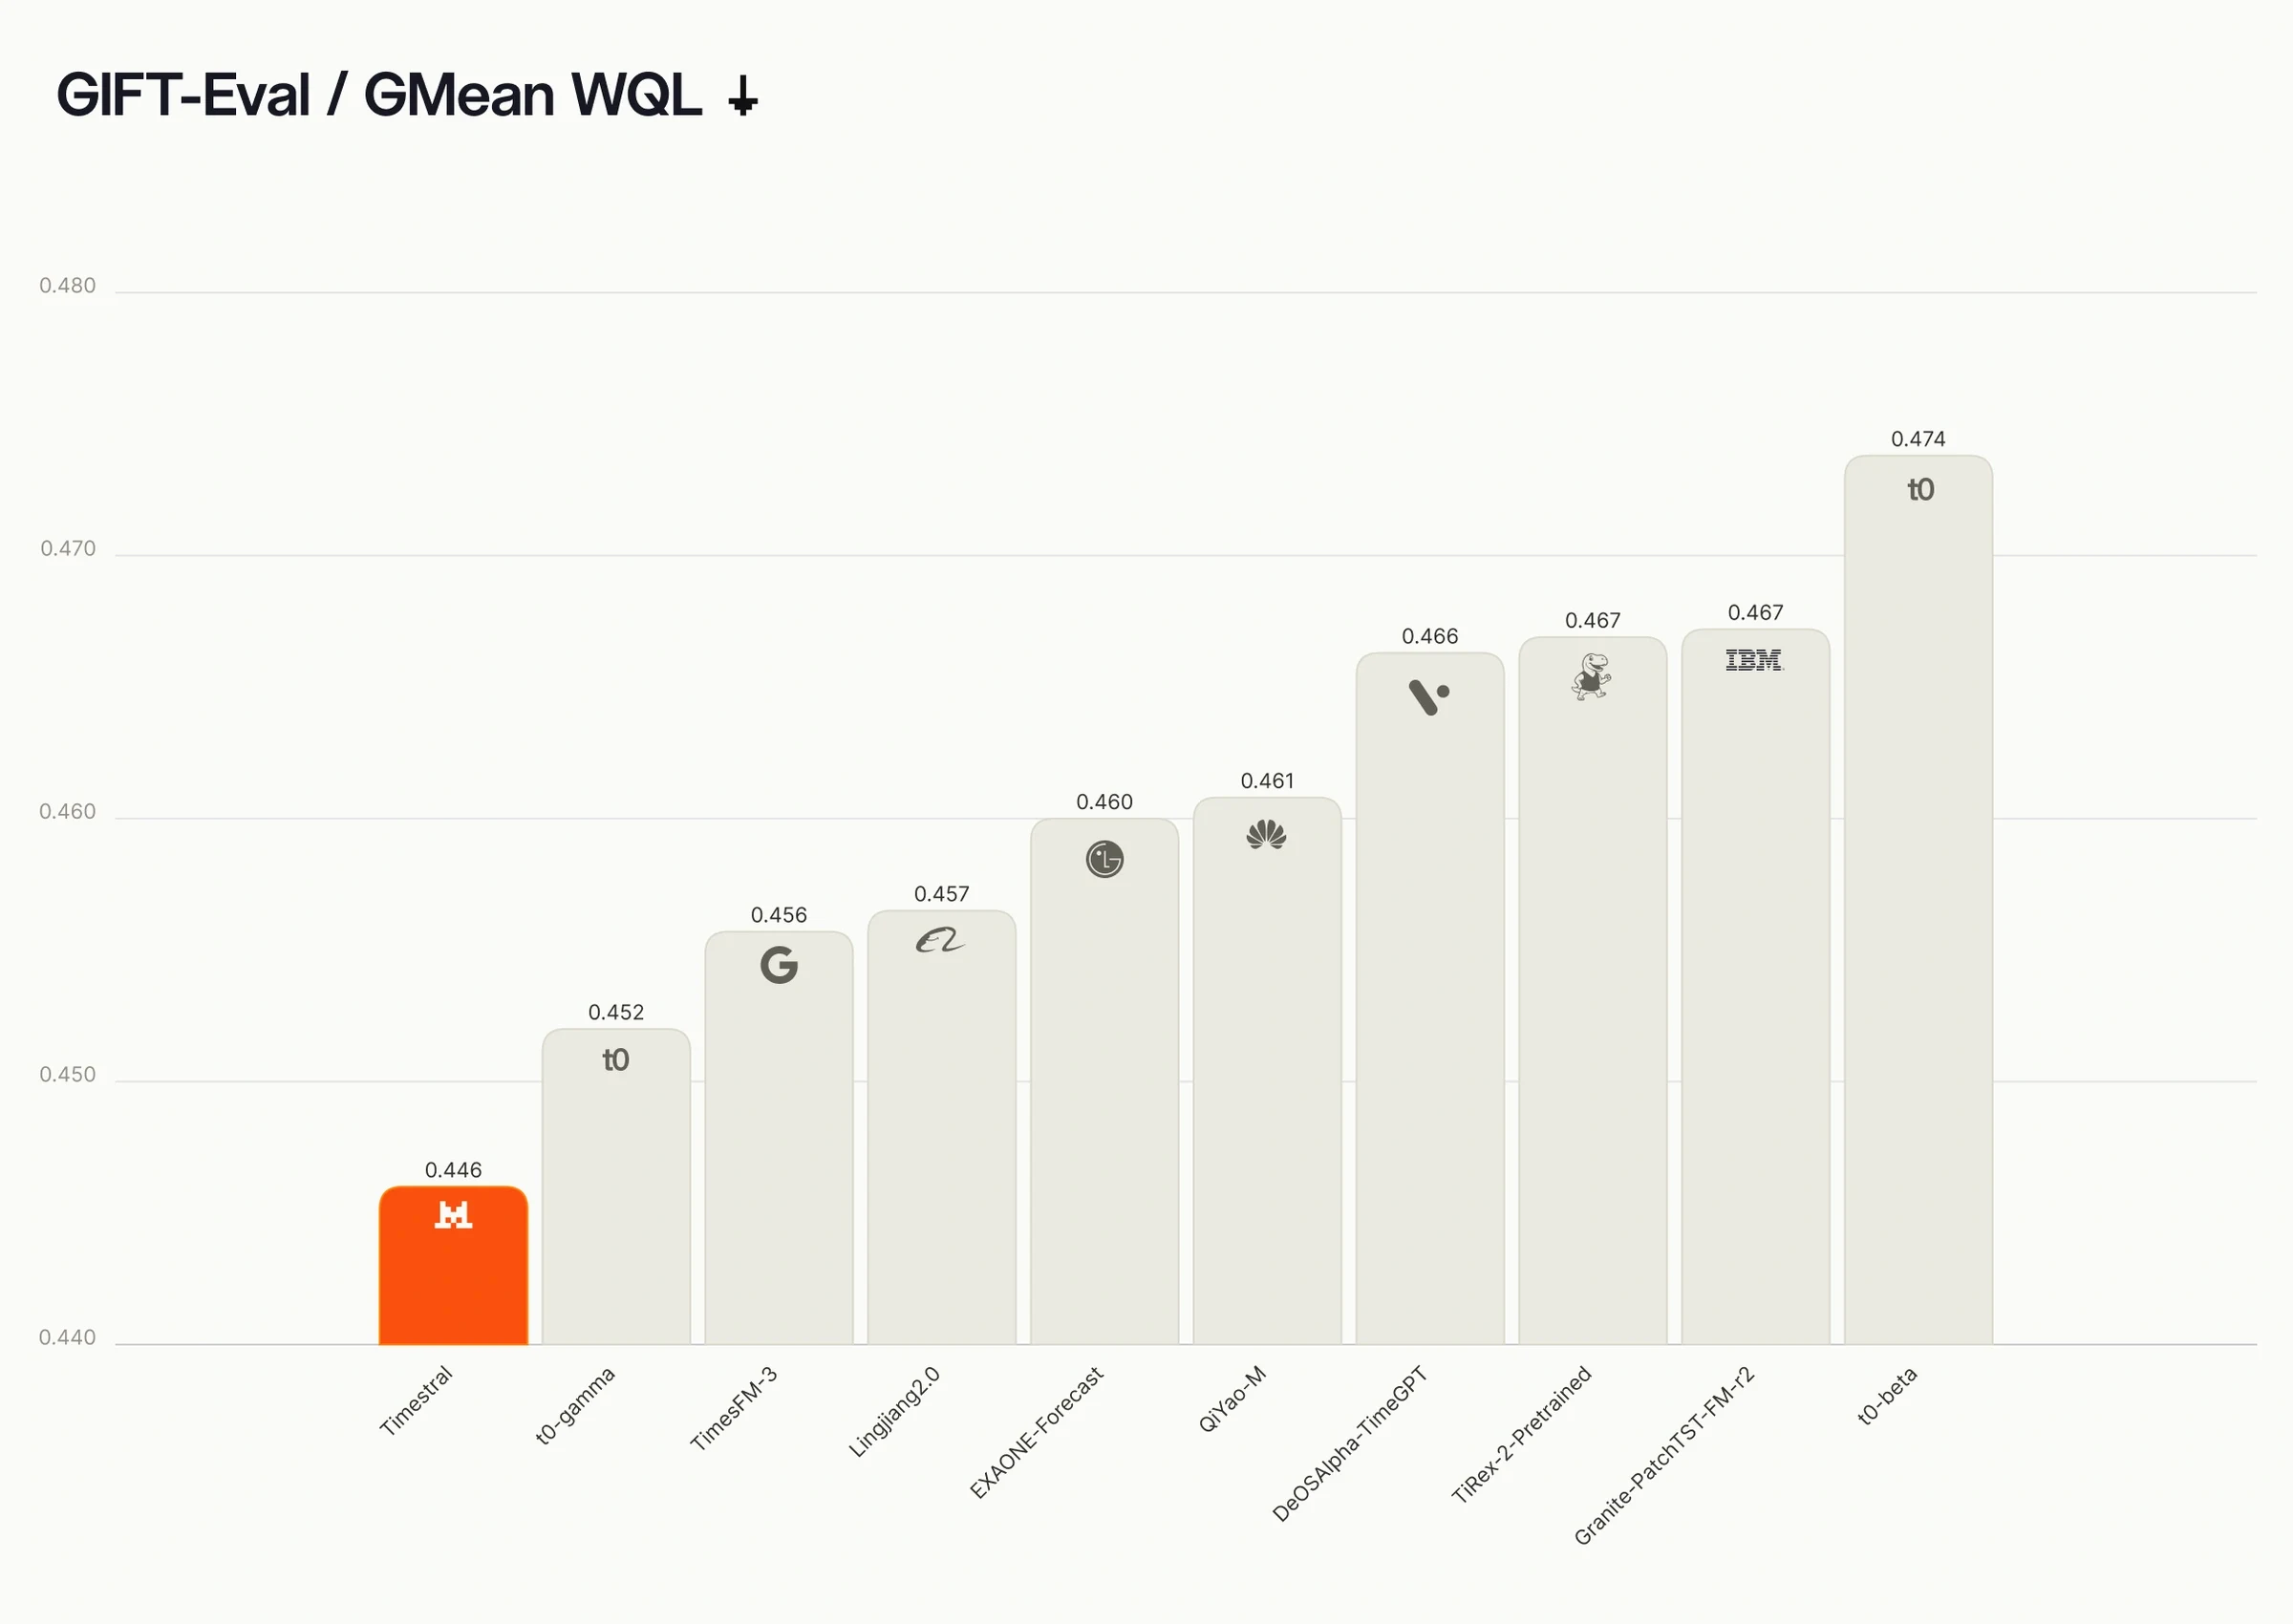
GIFT-Eval, Top Ten von 83 vergleichbaren pretrained- und zero-shot-Einträgen. Niedriger ist besser.
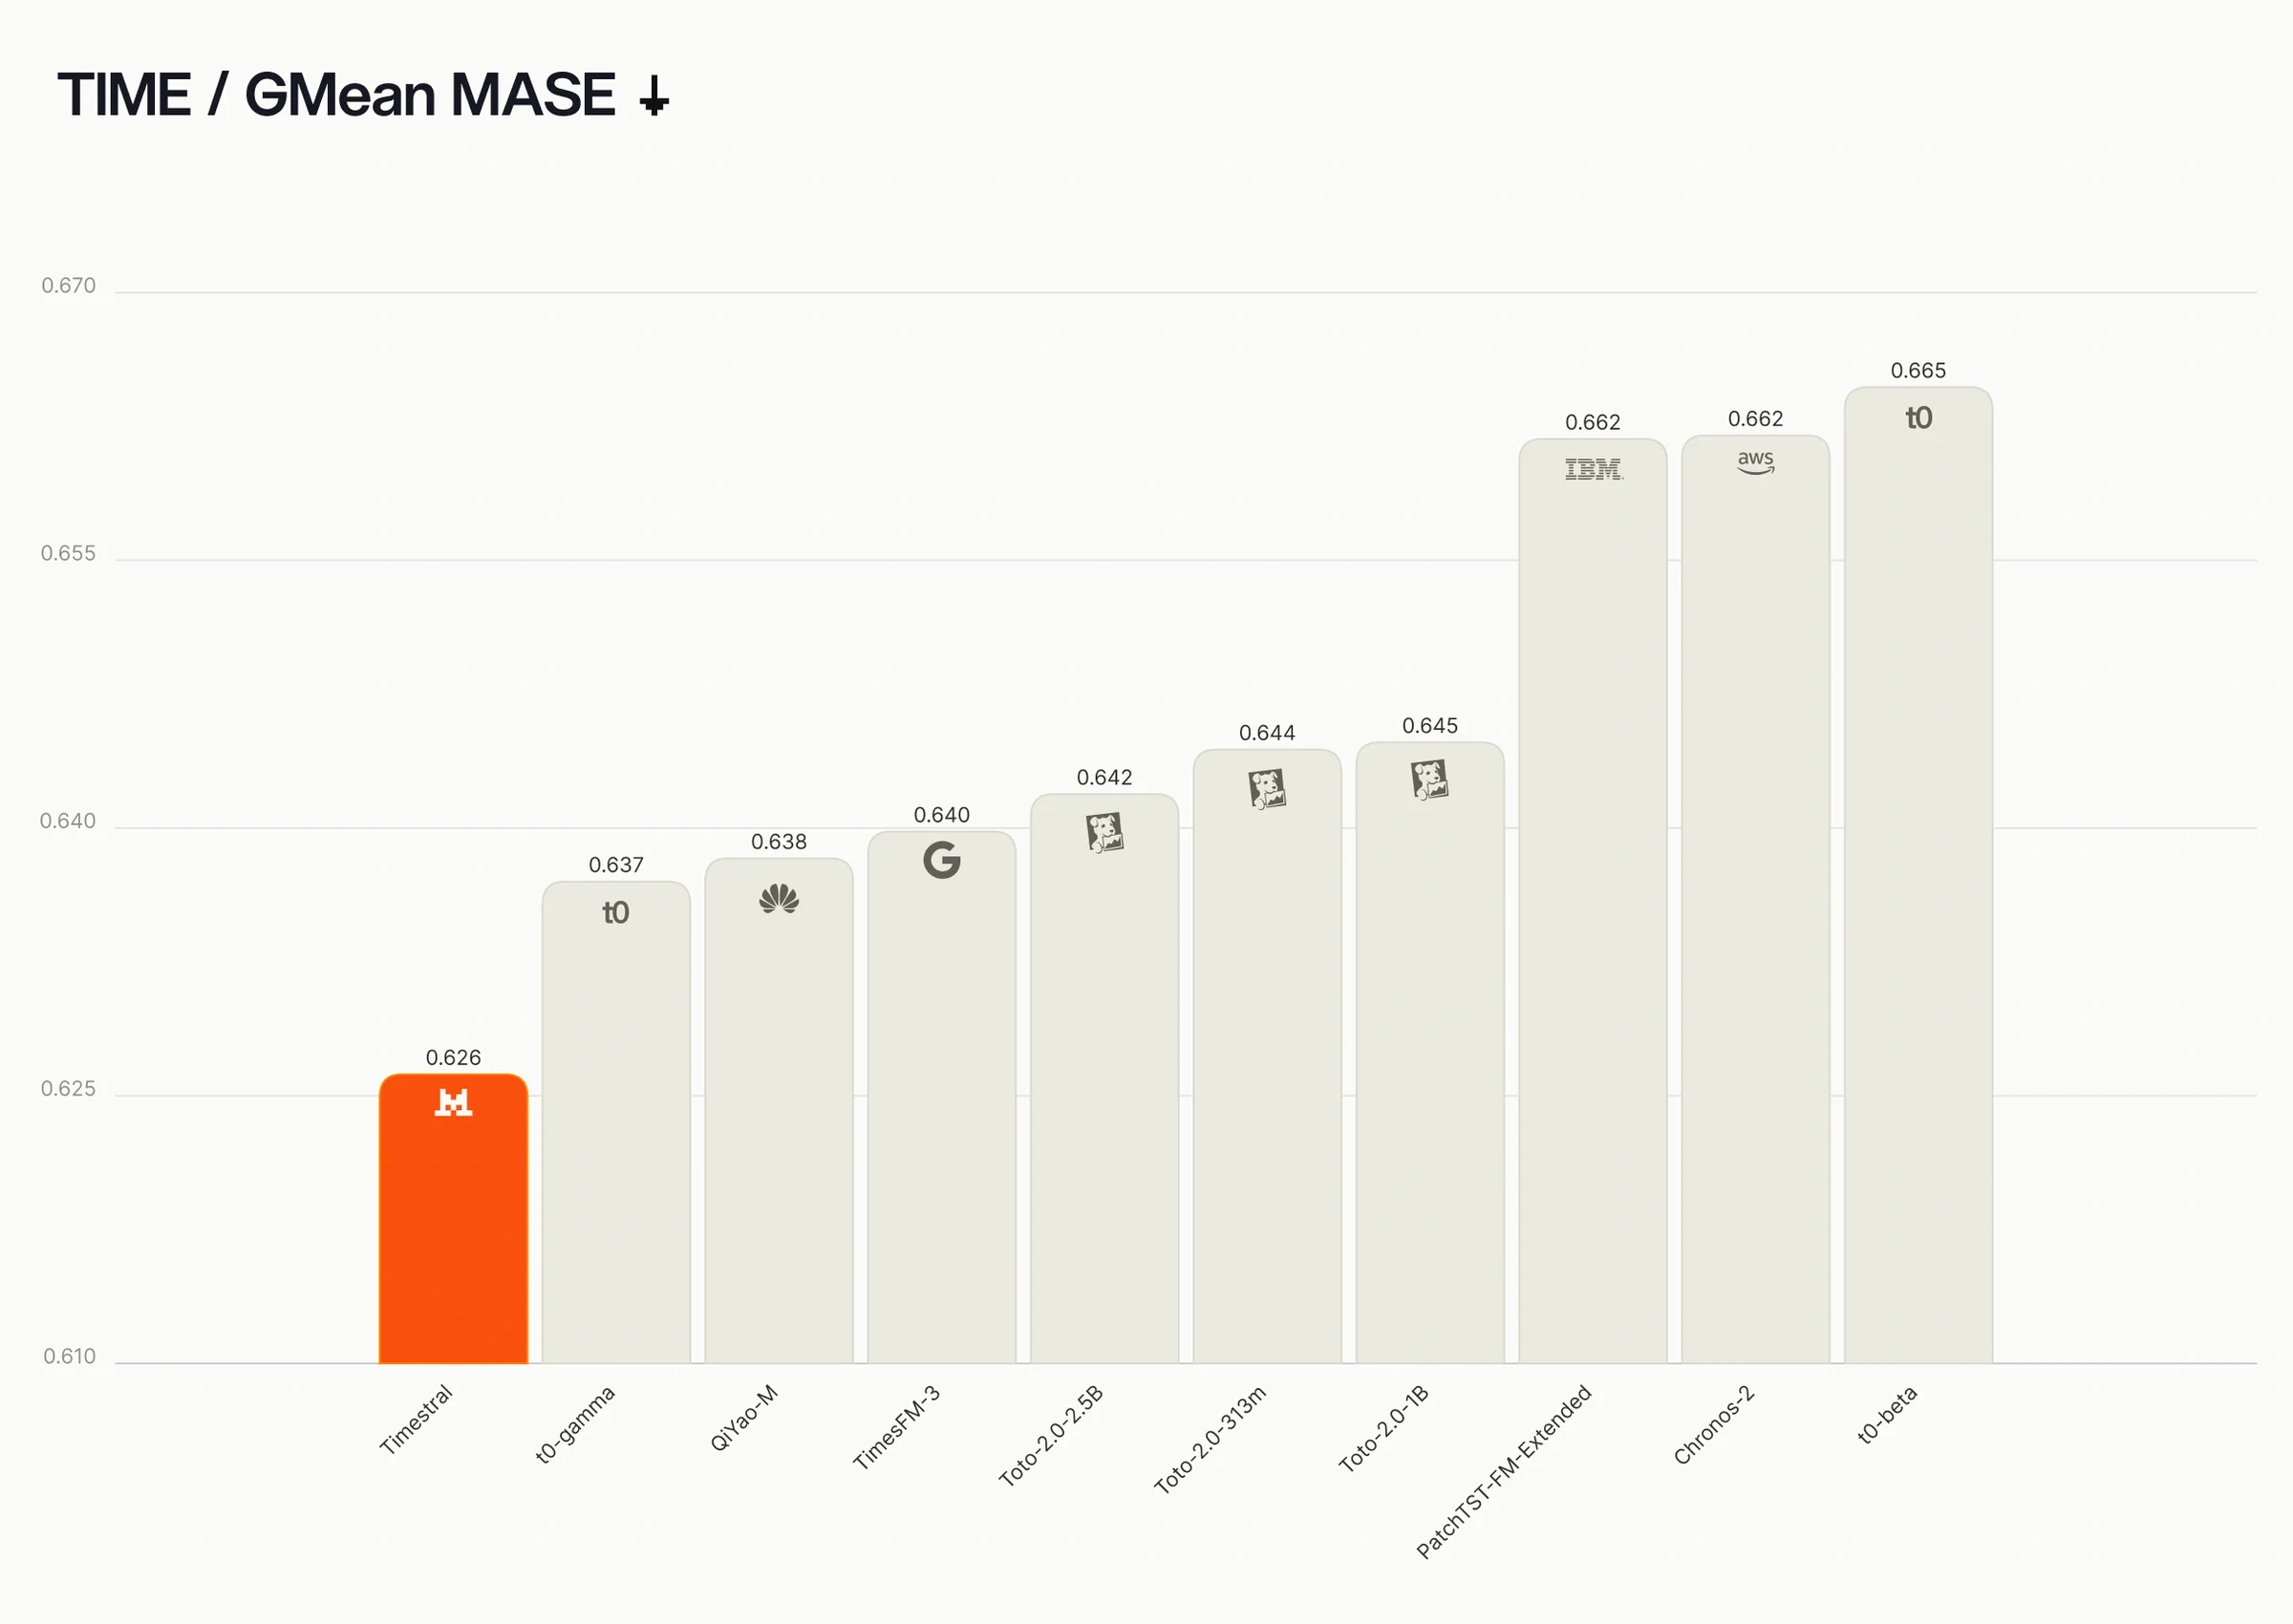
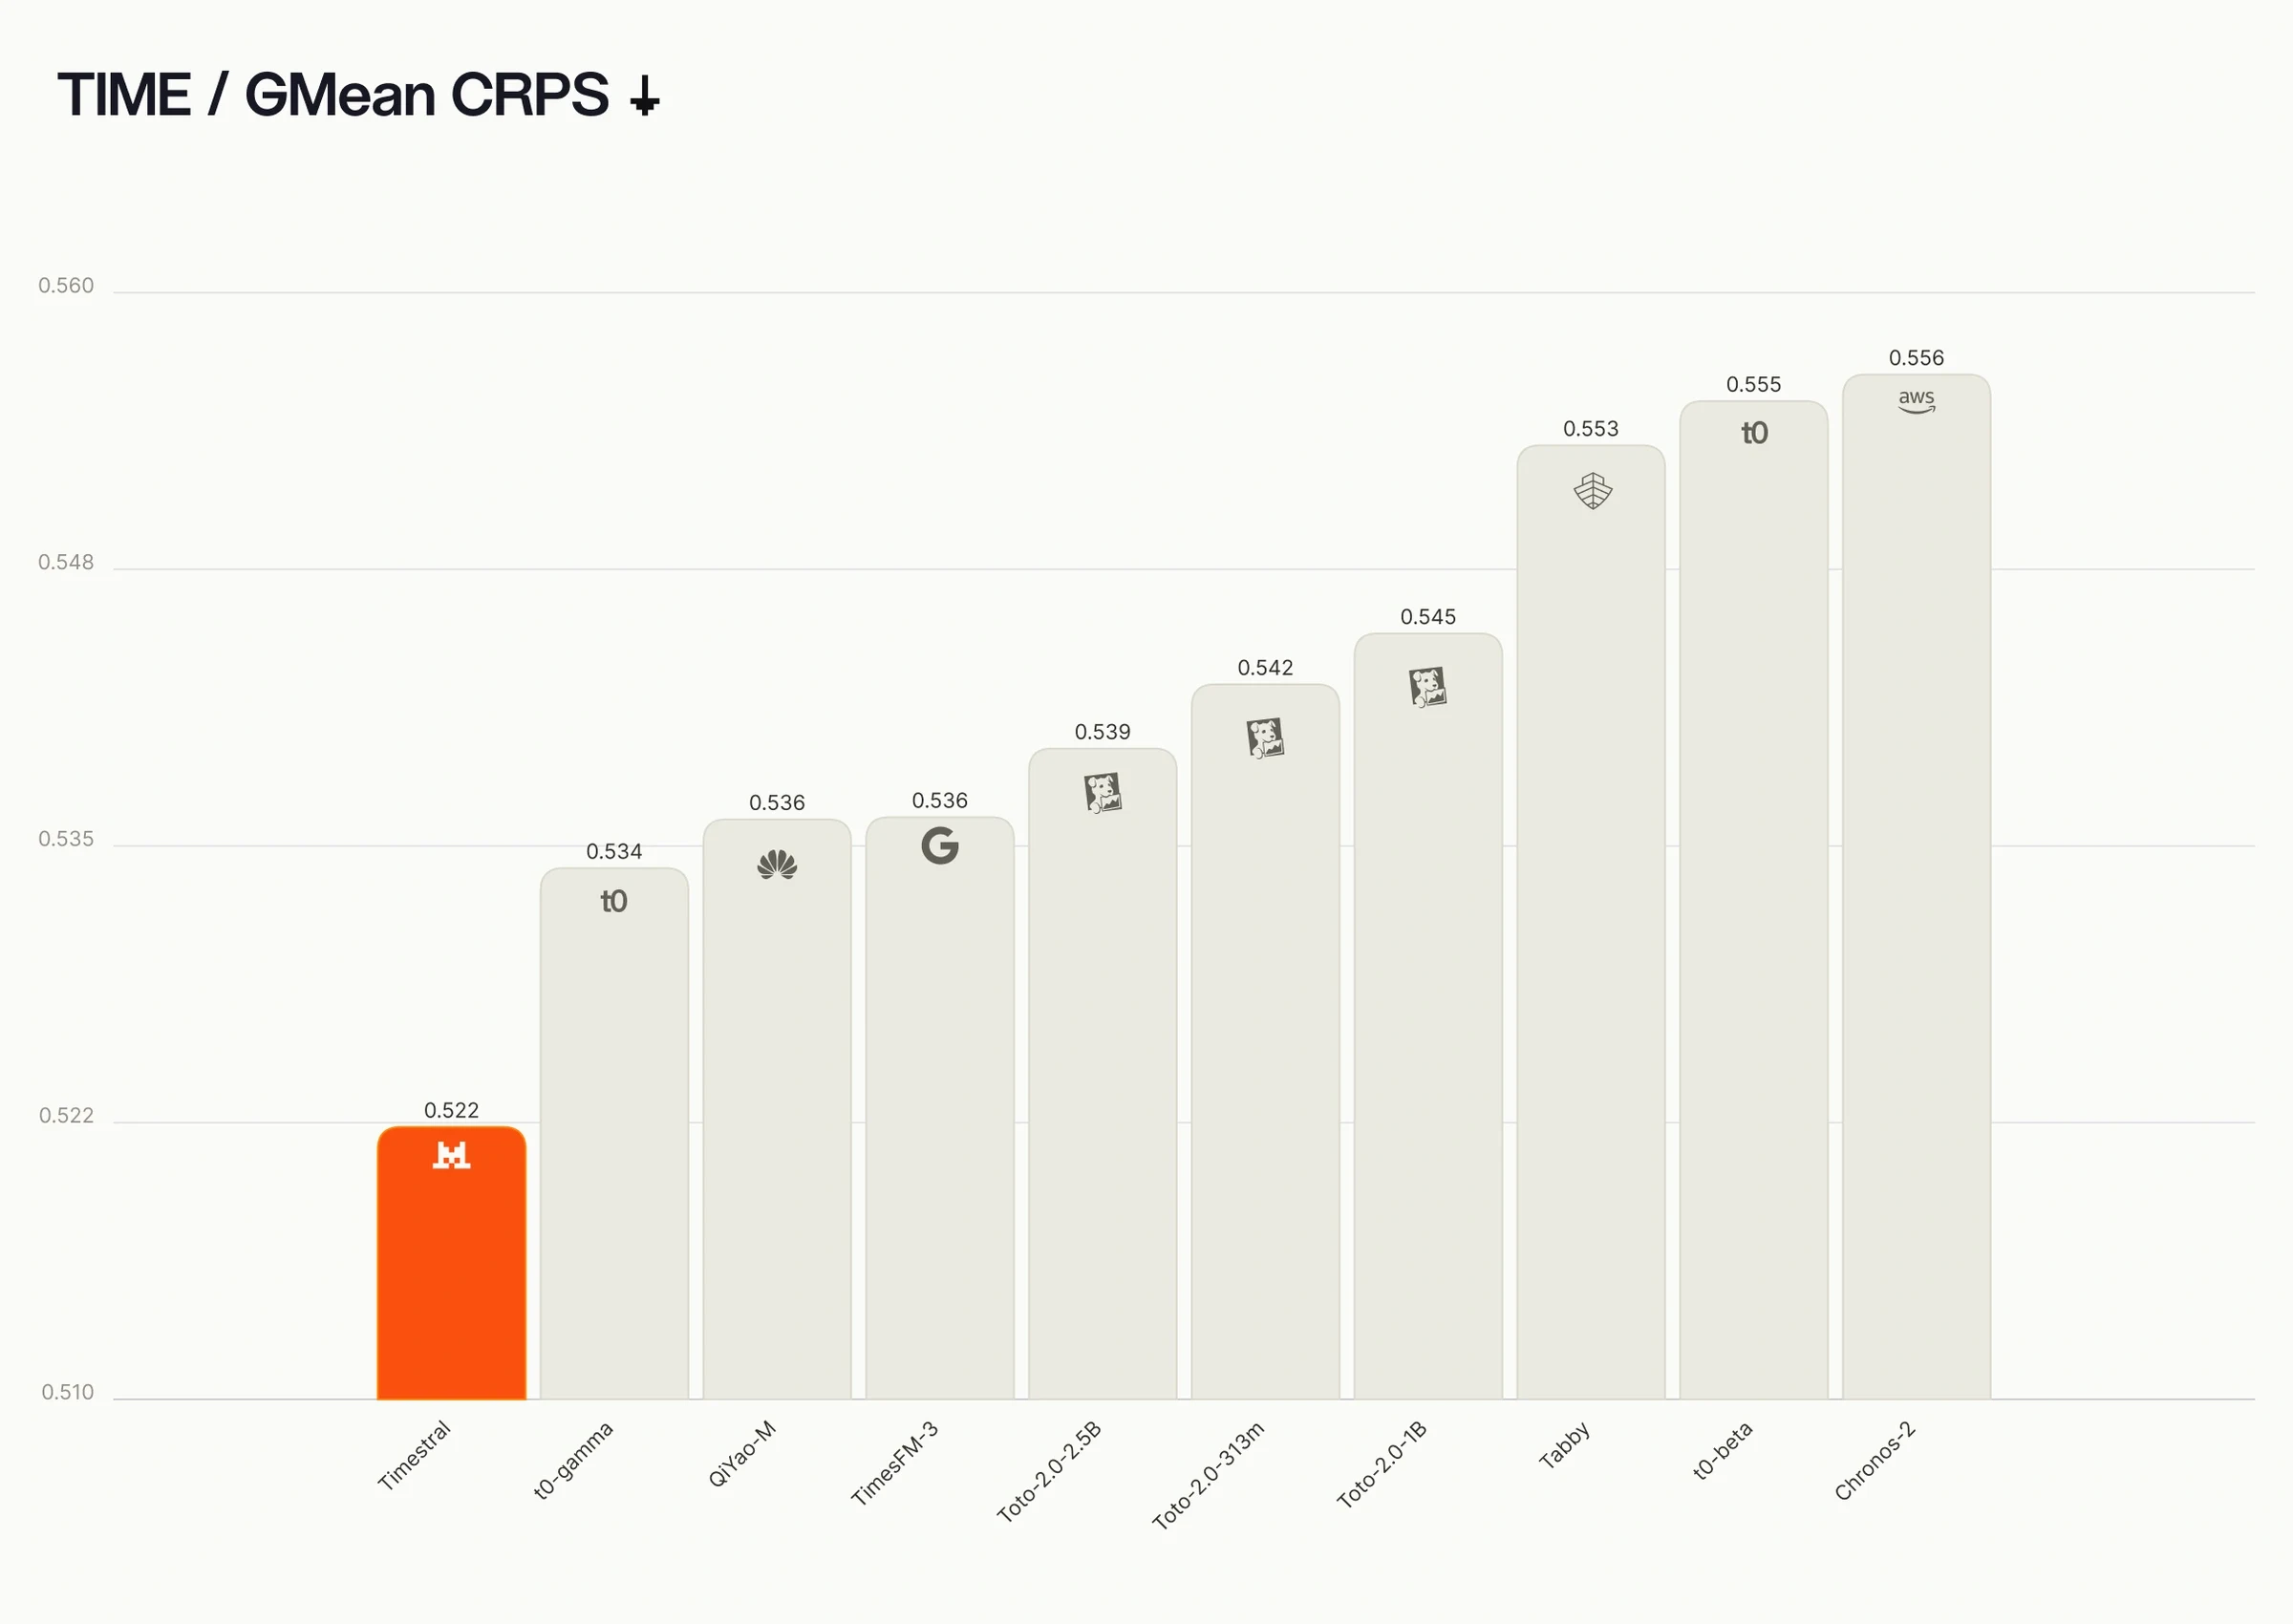
TIME, Top Ten der 35 Leaderboard-Einträge. Bei beiden Metriken ist niedriger besser.
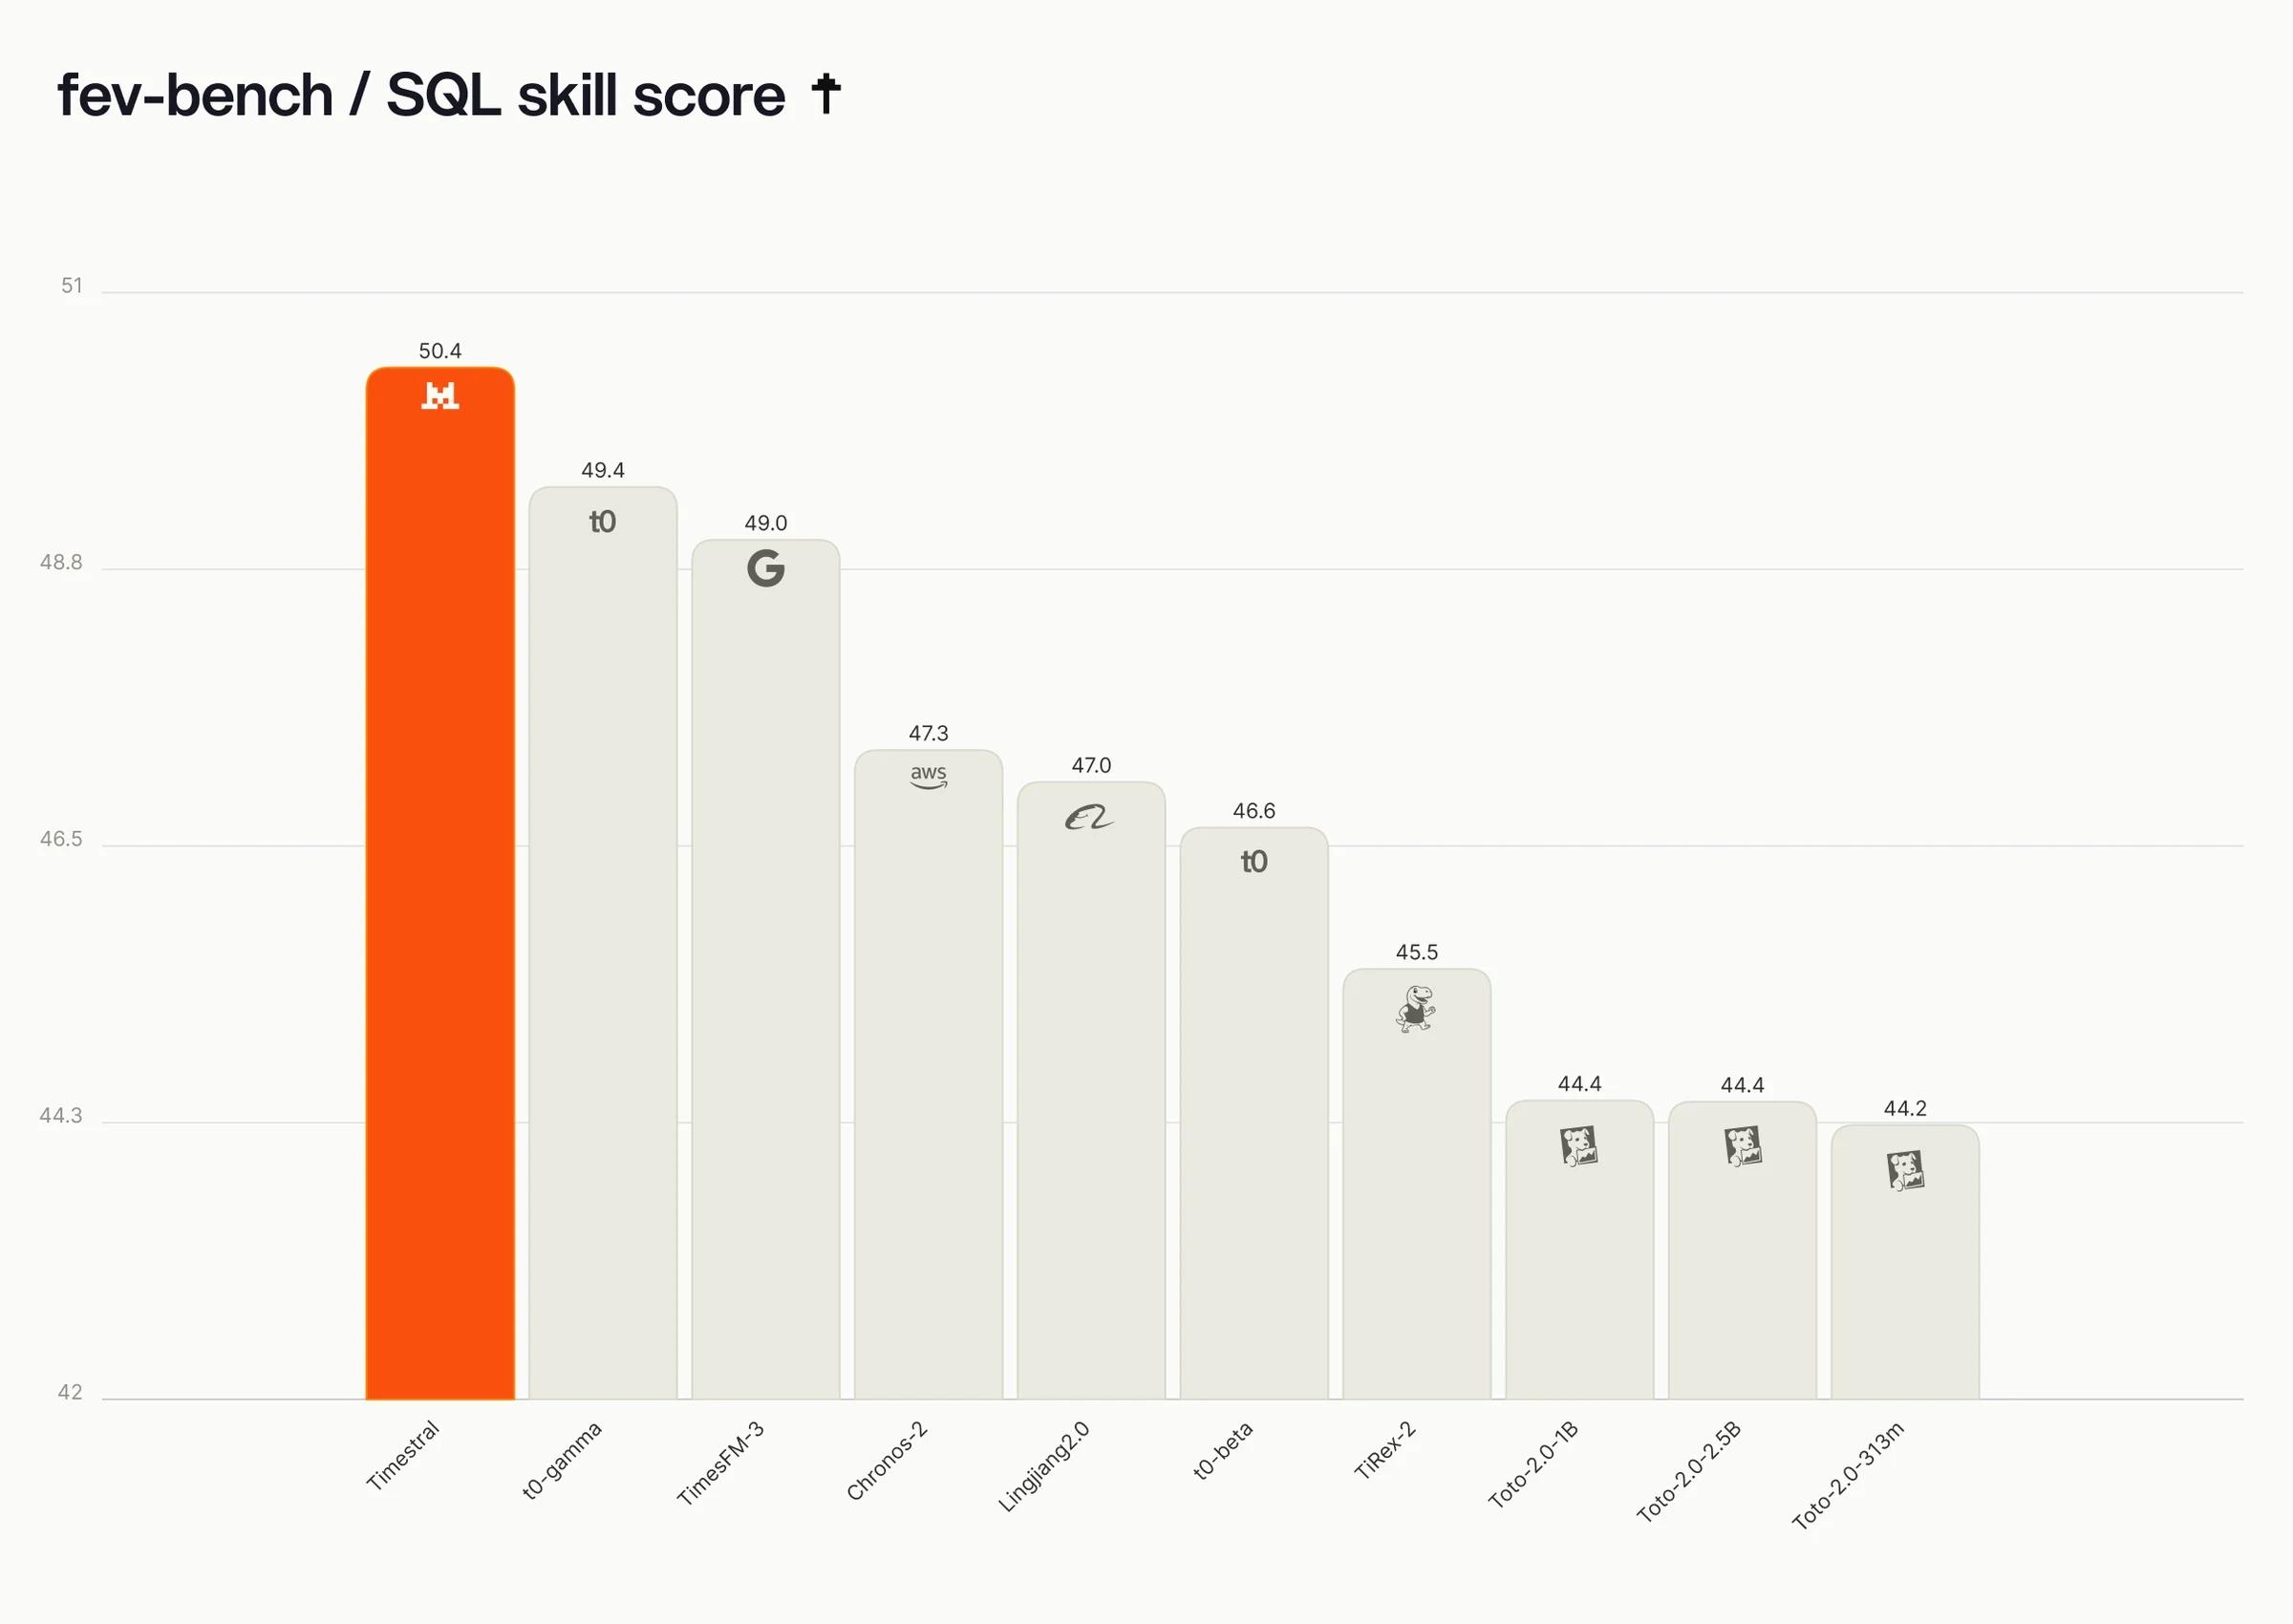
fev-bench, Top Ten der 37 Leaderboard-Einträge, nach SQL Skill Score. Höher ist besser.
Eine Modellfamilie, optimiert für jede Spezifikation
Timestral wurde als Familie von vier Modellen optimiert: 5M, 28M, 123M und 209M Parameter. Die größeren Modelle verbessern die Prognoseleistung, während die kleineren schneller und günstiger sind. Alle vier teilen sich dieselbe Architektur und Trainingsrezeptur. Jede Größe liegt auf der Pareto-Front von Genauigkeit versus Modellgröße: Für jede Modellgröße prognostiziert kein öffentliches Modell besser.
Score versus Modellgröße auf GIFT-Eval, TIME und fev-bench (dargestellt als 1 − skill score). Niedriger ist besser. Unser 28M-Modell schlägt Chronos-2, etwa viermal größer, auf GIFT-Eval und TIME. Unser 209M-Modell schlägt TimesFM-3 und Falcon-2.0 mit weniger Parametern.
Timestral benötigt für die Inferenz keine GPU. Auf einer Standard-Server-CPU mit 8 Threads dauert die Prognose eines Tages im Voraus aus drei Wochen 15-Minuten-Historie 10 ms mit dem 5M-Modell und 140 ms mit dem 209M-Modell. Kleinere Modelle tauschen etwas Genauigkeit gegen Geschwindigkeit: Das 28M-Modell ist fünfmal schneller als das 209M-Modell, und das 123M-Modell liegt innerhalb von 0,2 % des 209M-Scores bei drei Vierteln seiner Latenz.
Ein industrielles Beispiel
Betrachten Sie eine Industrieanlage mit Tausenden von Sensoren an ihrer Ausrüstung. Timestral kann die Prognosen für diese Daten auf verschiedene Arten verbessern.
Multivariate Prognosen. Die Vibration, Temperatur und der Druck einer Pumpe bewegen sich nicht unabhängig voneinander. Ein Anstieg des einen erklärt oder verursacht oft eine Änderung des anderen. Timestral modelliert verwandte Reihen gemeinsam und kann so diese Abhängigkeiten nutzen, anstatt jeden Sensor isoliert zu prognostizieren.
Probabilistische Prognosen. Ein einzelner vorhergesagter Wert zeigt möglicherweise nicht das volle Bild. Timestral sagt einen vollständigen Satz von Quantilen voraus, sodass Teams sehen können, wie breit die Unsicherheit ist, Alarm thresholds festlegen, die sie widerspiegeln, und Wartung anhand von Risiko statt einer einzelnen Zahl planen können.
Kategoriale Kovariaten. Einige Kovariaten nehmen Werte aus einer Menge von Kategorien an statt kontinuierlicher Zahlen, etwa der Wochentag oder der Zustand einer Maschine (laufend, stillstehend, in Wartung). Diese als Zahlen zu kodieren würde eine Ordnung oder Skala erzwingen, die sie nicht haben. Timestral nimmt sie direkt als kategoriale Eingaben entgegen, um Prognosen zu verbessern.
Known-future-Kovariaten. Einige Treiber des Sensorverhaltens sind im Voraus bekannt, etwa Produktionspläne, geplante Abschaltungen oder Wettervorhersagen. Timestral kann diese berücksichtigen, um die Prognosequalität zu verbessern, sodass eine geplante Laststeigerung erwartet und nicht als Überraschung markiert wird.
Vom Modell zum System
Timestral ist ein numerisches Modell, das innerhalb bestehender Monitoring-Pipelines laufen oder mit unseren Sprachmodellen in multimodalen agentischen Workflows kombiniert werden kann.
Im Werk könnte das so aussehen:
Timestral läuft kontinuierlich über die Sensorströme der Anlage und erkennt Anomalien, sobald sie auftreten.
Wenn es eine Anomalie an einer Pumpe meldet, bettet ein Agent die Signale ein und vergleicht sie mit Embeddings früherer Sensordaten, um ähnliche historische Ausfälle zu finden.
Der Agent startet dann Sub-Agents, um eine Ursachenanalyse durchzuführen, und greift dabei auf den Kontext dieser Anlage zurück, etwa Wartungsprotokolle, Schichtberichte und Bedienernotizen, Gerätehandbücher, frühere Arbeitsaufträge und Messwerte verwandter Geräte.
Der Agent erstellt auf Grundlage der Ergebnisse einen Diagnosevorschlag mit unterstützenden Belegen und möglichen nächsten Schritten.
Der Anlagenmanager erhält eine Diagnose und einen Plan, gestützt auf die Sensordaten, statt nur eine Warnung.
Zentrale technische Beiträge
Mehrere Ideen wurden kombiniert, um diese Ergebnisse zu erzielen. Jede wird im technischen Bericht im Detail beschrieben.
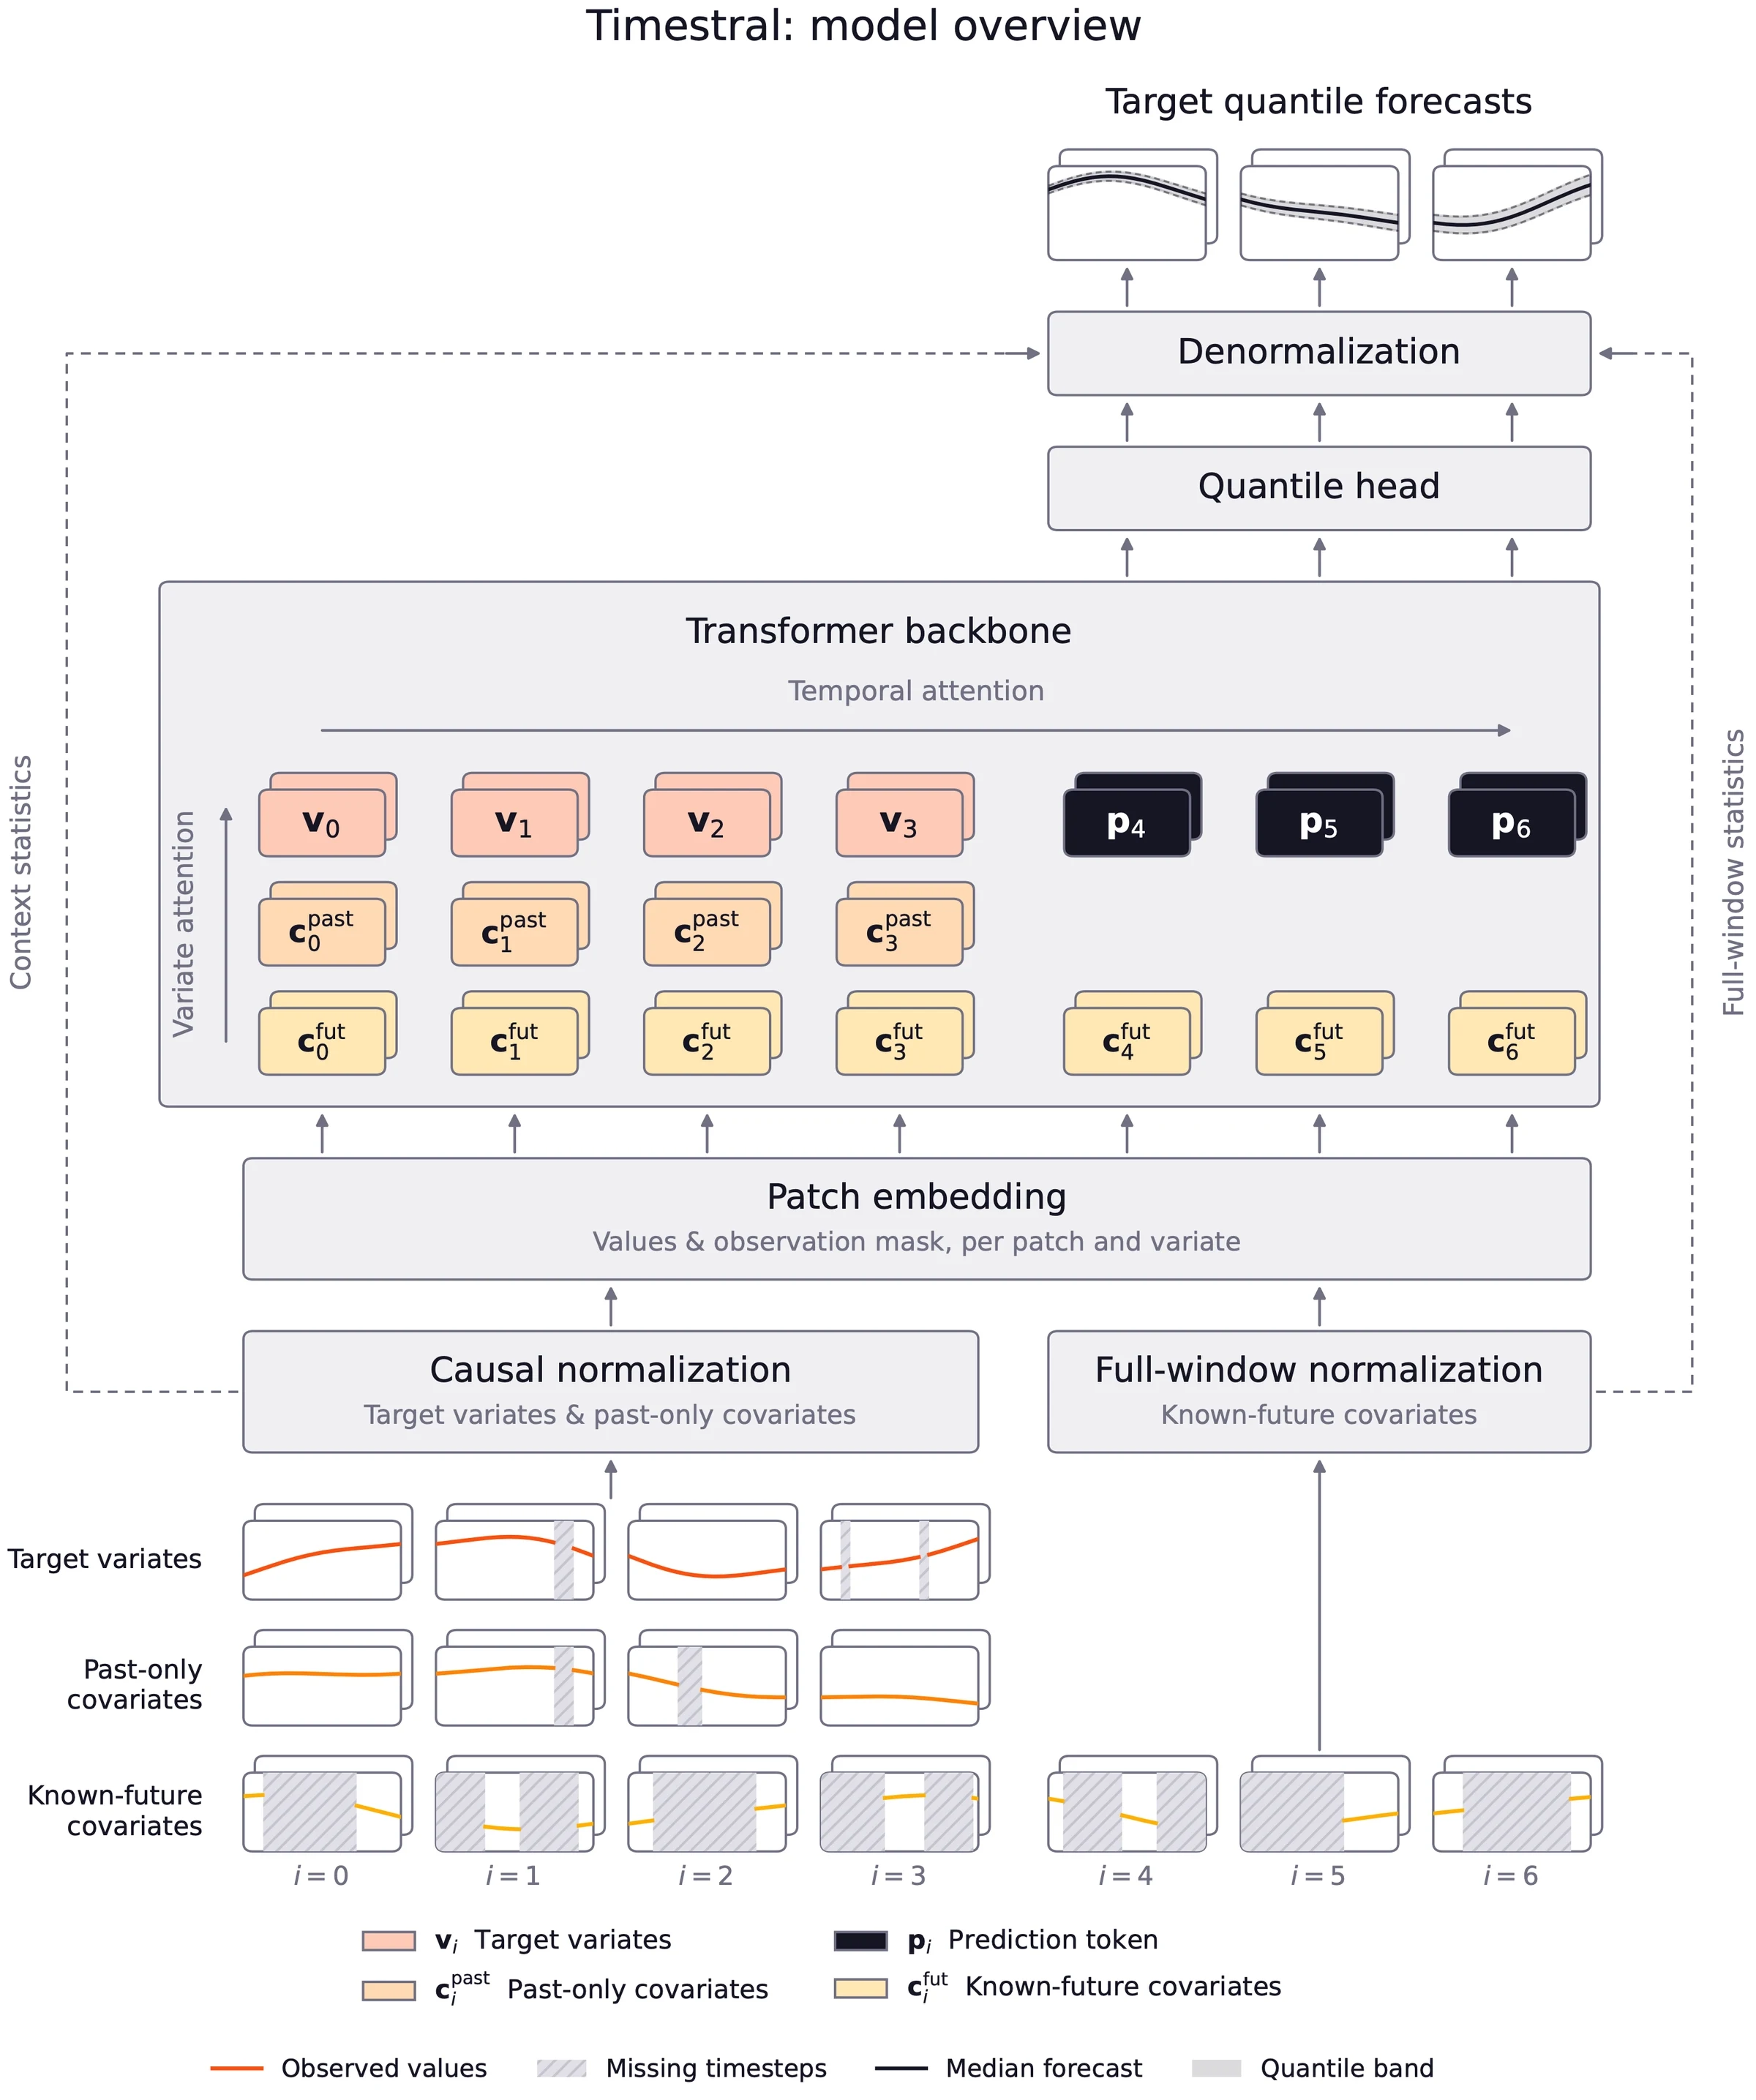
Entkoppelte Horizontprognose (Decoupled Horizon Forecasting). Kausale Decoder, die mit zusammenhängendem Patch-Masking trainiert werden, wie in Toto 2.0 und TimesFM-3, maskieren die zu prognostizierenden Werte, sodass diese wie fehlende Werte aussehen und auch als Kontext für spätere Prognosen verloren gehen. Unser Ansatz, DHF, trennt die beiden Aspekte: Die vollständige Historie bleibt in der Sequenz, und gelernte Prognosetokens lesen die vor ihnen liegende Historie. Jeder beobachtete Wert dient somit sowohl als Ziel als auch als Kontext, echte Lücken bleiben als fehlend markiert, und Trainingshorizontlängen und Data-Augmentation für fehlende Daten können unabhängig voneinander abgestimmt werden.
Kovariatenbewusste Aufmerksamkeit (Covariate-aware attention). Jeder Eingabedatenreihe wird eine Rolle zugewiesen: Zielvariable, nur-vergangene Kovariate oder bekannte-Zukunft-Kovariate. Kovariaten mit bekannter Zukunft sind über das gesamte Fenster sichtbar, während Ziele kausal bleiben, und Informationen fließen nur von den Kovariaten zu den Zielen. Timestral kann daher einen Feiertagskalender oder eine Wettervorhersage nutzen, ohne dass die eigene Zukunft eines Ziels in dessen Prognose hineinfließt.
Synthetik-zuerst-Daten. Der Großteil der Trainingsdaten war synthetisch. Wir generierten zunächst univariate Prozesse mit kohärenten zeitlichen Dynamiken, darunter Trends, Saisonalität und vielfältige Rauschmuster. Anschließend verwendeten wir einen multivariaten Synthesizer, um multivariate Datenreihen zu konstruieren, indem wir nichtlineare Abhängigkeiten zwischen diesen Prozessen einführten.
Zweistufiges Training. Timestral wird zunächst in großem Umfang auf rein synthetischen Daten mit einer Kontextgröße von 8192 vortrainiert und anschließend auf einer Mischung aus realen und synthetischen Daten mit einem 4x längeren Kontext nachtrainiert. Die Zielfunktion ist ein Pinball Loss über 21 Quantile, eine diskrete Approximation von CRPS.
Ein Modell, das sich anpassen lässt
Öffentliche Benchmarks messen die allgemeine Leistung, aber Produktionsdaten können sich in Verhalten und Struktur erheblich unterscheiden. Sie können sich auch im Laufe der Zeit verschieben, wenn Märkte das Regime wechseln, Ausrüstung altert und Nachfragemuster sich verändern. Der bleibende Wert liegt darin, ein Modell an Domänendaten anpassen und es weitertrainieren zu können, während sich die Verteilung verschiebt.
Für Organisationen, die weitergehen möchten, ist Timestral verfügbar über Mistral Forge, dieselbe Trainingspipeline, die wir für unsere Sprachmodelle verwenden. Sie unterstützt:
Zero-Shot-Inferenz ab Werk.
Architekturelle Erweiterungen, wie domänenspezifische Kovariaten.
Fine-Tuning auf proprietären Daten, Spezialisierung auf eine Domäne bei Bewahrung der allgemeinen Leistung.
Kontrolle über die Trainingsdaten, einschließlich Anpassung der Trainingsmischung, Wiederabspielen von Vortrainingsdaten und Generierung synthetischer Datenbeispiele, die die Zieldomäne widerspiegeln. Vollständige Kontrolle über die Daten stellt sicher, dass nichts, was wir backtesten, während des Vortrainings gesehen wurde.
Die vollständige Pipeline kann auf der Hardware unserer Kunden eingesetzt werden, einschließlich air-gapped Umgebungen.
Ausblick
Wir haben ein GitHub-Repository so dass Sie Timestral auf Ihren eigenen Daten ausführen können. Ein technischer Bericht mit den vollständigen Ergebnissen wird folgen. Für spezialisierte Prognoseprobleme oder eine Zusammenarbeit bei der Forschung kontaktieren Sie uns bitte.
Timestral | |
|---|---|
Typ | Zeitreihen-Foundation-Modell (TSFM) |
Parameter | 5M, 28M, 123M und 209M |
Kontextlänge | 32.768 Zeitschritte |
Ausgabe | Wahrscheinlichkeitsprognosen, 21 Quantile |
Eingaben | Multivariate Zielgrößen, nur-Vergangenheits- und bekannte Zukunfts-Kovariaten |
Deployment | On-Premises, VPC oder Air-Gapped |
Lizenz | Modified MIT |
Timestral
Neu
Mistrals Fundamentmodelle für Zeitreihen. State-of-the-Art-Wahrscheinlichkeitsprognosen, 5M–209M Parameter, läuft auf CPU.
Wahrscheinlichkeitsprognosen
Entdecken