
Immer aktive Agenten müssen zunehmend visuelle Informationen interpretieren, darüber nachdenken, Tools nutzen und handeln. Diese Workflows erfordern ein Modell, das multimodales Verständnis mit hochgenauer Ausführung kombiniert.
NVIDIA Nemotron 3.5 Super VL ist ein offenes, anpassbares multimodales Modell, das für langlebige Agenten entwickelt wurde und es Entwicklern ermöglicht, Genauigkeit und Effizienz für spezialisierte Workflows zu maximieren.
Es kombiniert Reasoning, Befehlsfolge (Instruction Following) und Tool-Nutzung mit Text-, Bild-, Dokument- und Videoverständnis in einem einzigen Modell, wodurch der Bedarf an separaten Text- und Vision-Modellen sinkt und die Aufrechterhaltung aufgabenrelevanter Kontexte über Workflow-Schritte hinweg erleichtert wird.
Die auf einer 120-Milliarden-Parameter-Mixture-of-Experts-Architektur (MoE) mit 12 Milliarden aktiven Parametern basierende Nemotron 3.5 Super VL bietet eine Balance aus Genauigkeit und Effizienz für spezialisierte, durchgängig aktive Agent-Aufgaben. Organisationen können sie mit NVIDIA NeMo mit ihren eigenen Daten, Tools, Richtlinien und Workflows nachtrainieren.
Innerhalb eines Systems von Modellen ist Nemotron 3.5 Super VL als standardmäßiges hochgenaues agentisches Ausführungsmodell mit nativem Dokument-, Bild- und Videoverständnis konzipiert. Es ergänzt NVIDIA Nemotron 3.5 Lightning für die Ausführung großer Textmengen und NVIDIA Nemotron 3 Ultra für die anspruchsvollsten reinen Text-Reasoning-Aufgaben.
Nemotron 3.5 Super VL erfüllt zwei praktische Anforderungen an multimodale, dauerhaft aktive Agenten:
- Natives visuelles Verständnis mit agentischer Ausführung: Das Modell kombiniert hochgenaues Reasoning und Tool-Nutzung mit Dokument-, Bild- und Videoverständnis und bewahrt dabei aufgabenrelevante Kontexte über spezialisierte Workflows hinweg.
- Effiziente, kontrollierbare Bereitstellung: Eine hybride Mamba-Transformer-Architektur, Multi-Token-Prediction und NVFP4-Quantisierung sollen die Generierungseffizienz verbessern und Spielraum für mehr gleichzeitige Langkontext-Sitzungen schaffen.
TL;DR: Über NVIDIA Nemotron 3.5 Super VL
- Architektur: 120B Gesamtparameter mit 12B aktiven Parametern in einem Mixture-of-Experts-Design
- Modalitäten: Text, Bilder, Dokumente und Video als Eingabe; Text als Ausgabe
- Optimierung: C-RADIOv4 Vision Encoder, hybride Mamba-Transformer-Architektur, Multi-Token-Prediction und NVFP4-Quantisierung
- Modellrolle: Hochgenaue agentische Ausführung mit nativem visuellen Verständnis für Systeme von Modellen
- Anpassung: Nachtraining mit NVIDIA NeMo unter Verwendung unternehmensspezifischer Daten, Tools, Richtlinien und Workflows
- Bereitstellung: NVIDIA NIM für optimiertes Production-Serving in Cloud- und Rechenzentrumsumgebungen
- Bereitstellungsziele: 1x GB10, B200, B300, RTX PRO 6000, H200 und 2x H100
- Verfügbarkeit:
High-Throughput-Inferenz mit vLLM ausführen
Nemotron 3.5 Super VL ist dafür vorgesehen, auf einer breiten Palette von NVIDIA-Plattformen ausgeführt zu werden. vLLM stellt die Serving-Schicht bereit, die benötigt wird, um das Modell in Produktions-Workflows zu bringen, einschließlich Continuous Batching, Prefix Caching, Speculative Decoding und einer OpenAI-kompatiblen API.
Der BF16-Checkpoint bietet eine unkomplizierte Basis für den Einsatz. NVFP4 ist ebenfalls zum Launch verfügbar für Umgebungen, die Inferenz mit niedrigerer Präzision nutzen können.
vLLM installieren
docker pull vllm/vllm-openai:v0.31.0

docker run --rm -it --gpus all --ipc=host --network=host \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --entrypoint /bin/bash \
  vllm/vllm-openai:v0.31.0
Das Modell bereitstellen
Die folgende NVFP4-Startkonfiguration ist ein Beispiel für ein 1× GB200-Setup. Validieren Sie sie auf der Zielhardware, bevor Sie sie verwenden.
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --served-model-name nemotron-3.5-super \
  --trust-remote-code \
  --max-model-len 114688 \
  --reasoning-parser nemotron_v3 \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 5
Sobald der Server läuft, können Anwendungen Prompts über einen OpenAI-kompatiblen Client senden:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="null")

response = client.chat.completions.create(
    model="nemotron-3.5-super",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Describe what happens in this video."},
                {
                    "type": "video_url",
                    "video_url": {"url": "https://example.com/clip.mp4"}
                },
            ],
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=4096,
)

print(response.choices[0].message.reasoning)  # thinking trace
print(response.choices[0].message.content)    # final answer
Langlebige Agentic-Workflows mit Speculative Decoding beschleunigen
Nemotron 3.5 Super VL unterstützt Multi-Token Prediction (MTP), um die Token-Generierung zu beschleunigen und dabei die Ausgabequalität des Zielmodells zu bewahren.
Nemotron 3.5 Super VL verfügt über integrierte Multi-Token-Prediction-Heads (MTP). Während der Dekodierung schlagen diese Heads zukünftige Tokens vor, und das Zielmodell verifiziert sie, wodurch sich die Anzahl der sequenziellen Generierungsschritte für längere Antworten verringert.
Zum Beispiel kann MTP auch mit drei spekulativen Tokens aktiviert werden:
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --served-model-name nemotron-3.5-super \
  --trust-remote-code \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 3
Gebaut für spezialisierte, stets aktive Agent-Workflows
Organisationen können Nemotron 3.5 Super VL mit NVIDIA NeMo an ihre Terminologie, Daten, Richtlinien, Tools und Workflows anpassen. Dies ermöglicht es, ein allgemeines multimodales Modell in eine spezialisierte Ausführungs-Engine für domänenspezifische Agent-Aufgaben umzuwandeln und dabei die Kontrolle über Modellverhalten und Datenverarbeitung zu bewahren.
Beispielhafte Anwendungsfälle
- Kundenservice: Mehrstufige Anfragen lösen, indem vom Kunden bereitgestellte Dokumente und Bilder interpretiert, Richtlinien angewendet und Service-Tools genutzt werden.
- Dokumentenintelligenz: Komplexe Dokumente interpretieren – einschließlich OCR, Tabellen, Diagrammen und Seitenlayouts –, um Informationen zu extrahieren und Zusammenfassungen oder Berichte zu erstellen.
- Unternehmensproduktivität: Mehrstufige Aufgaben abschließen, indem visuelle Informationen interpretiert, über diese hinweg geschlossen und Tools genutzt werden.
- Videoverständnis: Wichtige Informationen aus Videos extrahieren, um Suche, Inhaltsprüfung, Werbung, Einzelhandel und Vorfallanalyse zu unterstützen.
- Webrecherche: Websites durchsuchen, Informationen aus mehreren Quellen verknüpfen und Ergebnisse überprüfen.
Genauigkeit und Effizienz für multimodale Agent-Aufgaben
Nemotron 3.5 Super VL ist darauf ausgelegt, hohe Genauigkeit für spezialisierte multimodale Agent-Aufgaben zu liefern, während für jedes Token nur ein Teil seiner Gesamtparameter verwendet wird. Die hybride Mamba-Transformer-Architektur und Multi-Token-Prediction zusammen mit NVFP4-Quantisierung helfen, die Ausgabegenerierung zu beschleunigen.
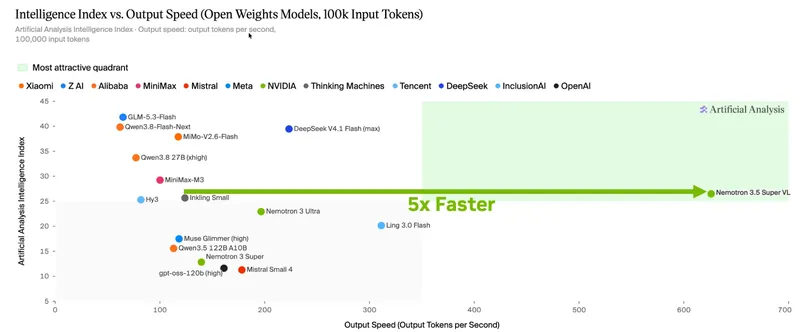
Wie in Abbildung 1 gezeigt, liefert dieses Modell auf einer einzelnen GPU bis zu 5x schnelleren Durchsatz für Agent-Aufgaben im Vergleich zu anderen offenen Modellen in seiner Größenklasse.
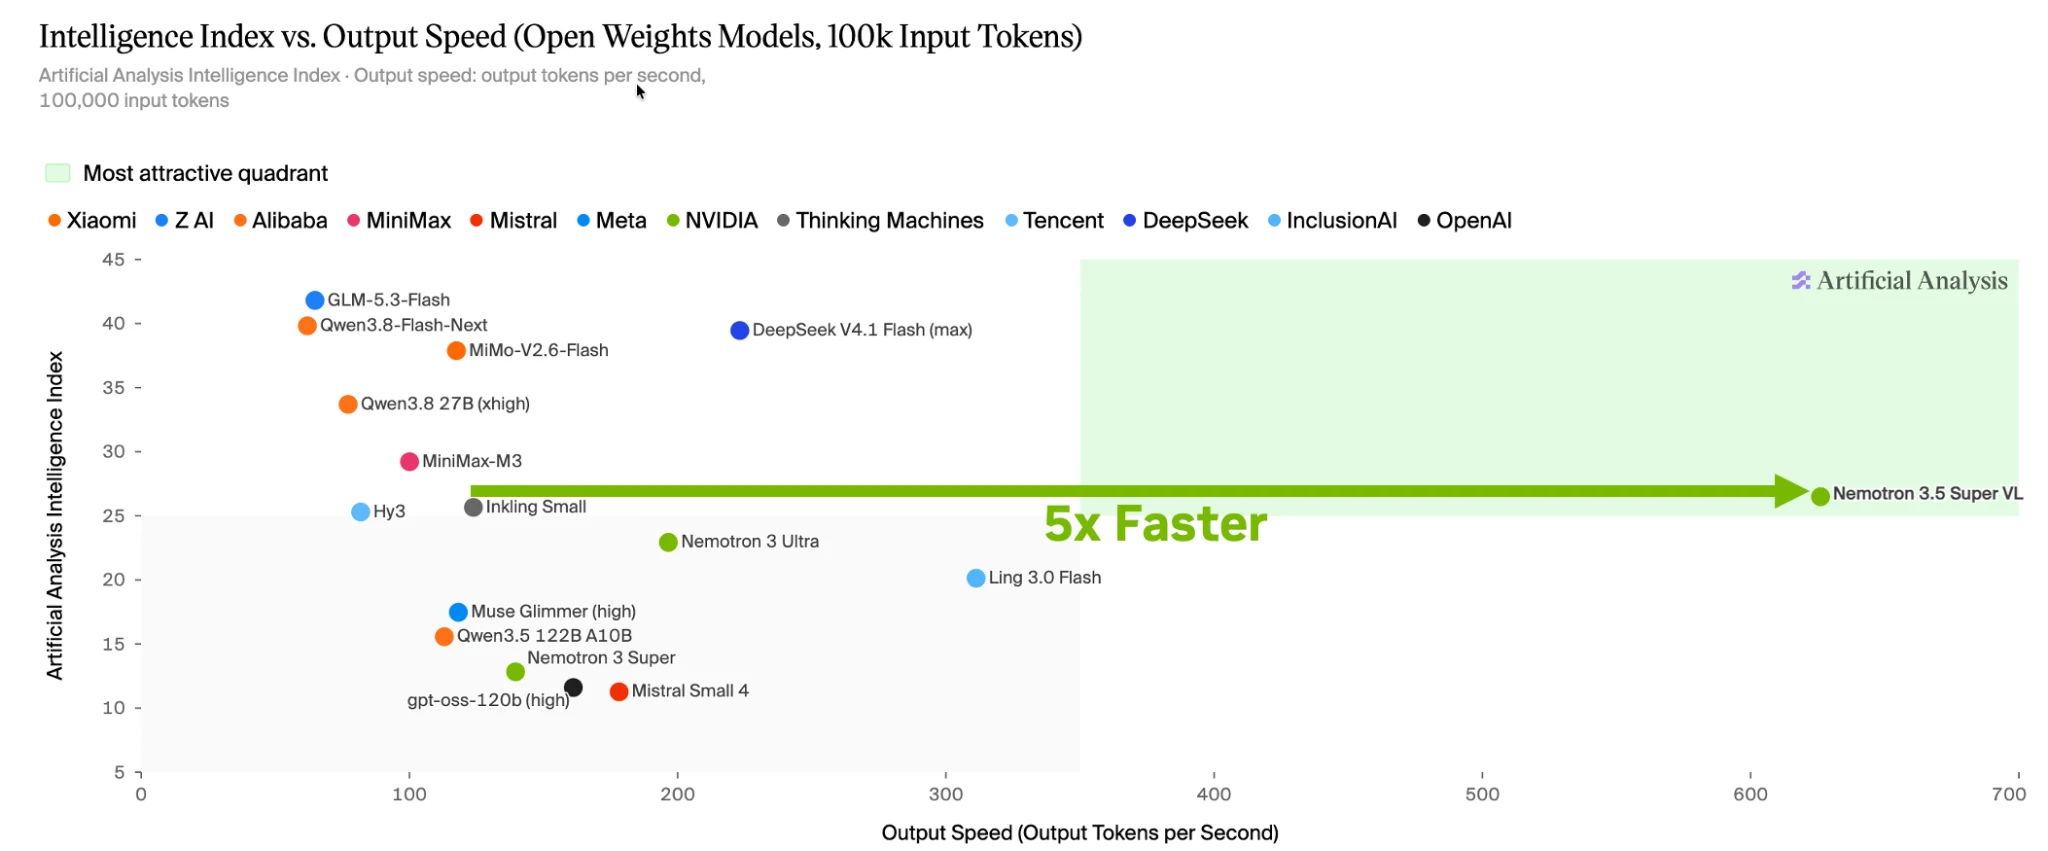
Abbildung 1. Nemotron 3.5 Super VL liefert über 600 TPS bei Agent-Aufgaben des Artificial Analysis Intelligence Index auf einem Baseten-Endpunkt.
Wie in Abbildung 2 gezeigt, erledigt Nemotron 3.5 Super VL Aufgaben 4x schneller im Vergleich zu anderen führenden offenen Modellen ähnlicher Größe.
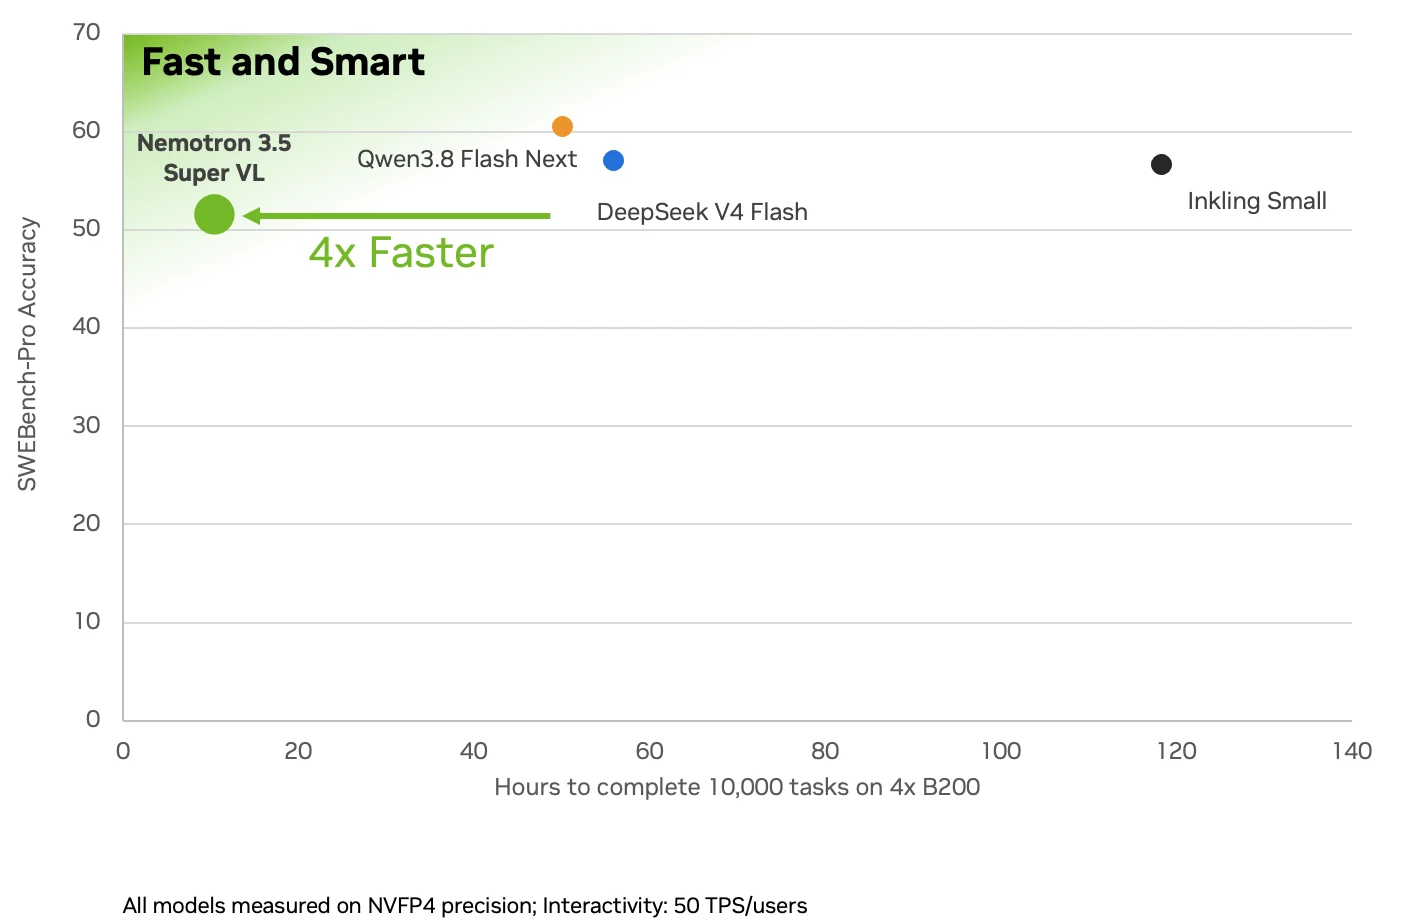
Abbildung 2. Nemotron 3.5 Super VL nutzt höheren Durchsatz und Token-Effizienz, um eine 4x schnellere Aufgabenerledigung zu erreichen.
Zur Einordnung zeigt Abbildung 3 einen DGX Spark-Vergleich für das verwandte Modell Nemotron 3.5 Super. Das Diagramm misst nicht Nemotron 3.5 Super VL.
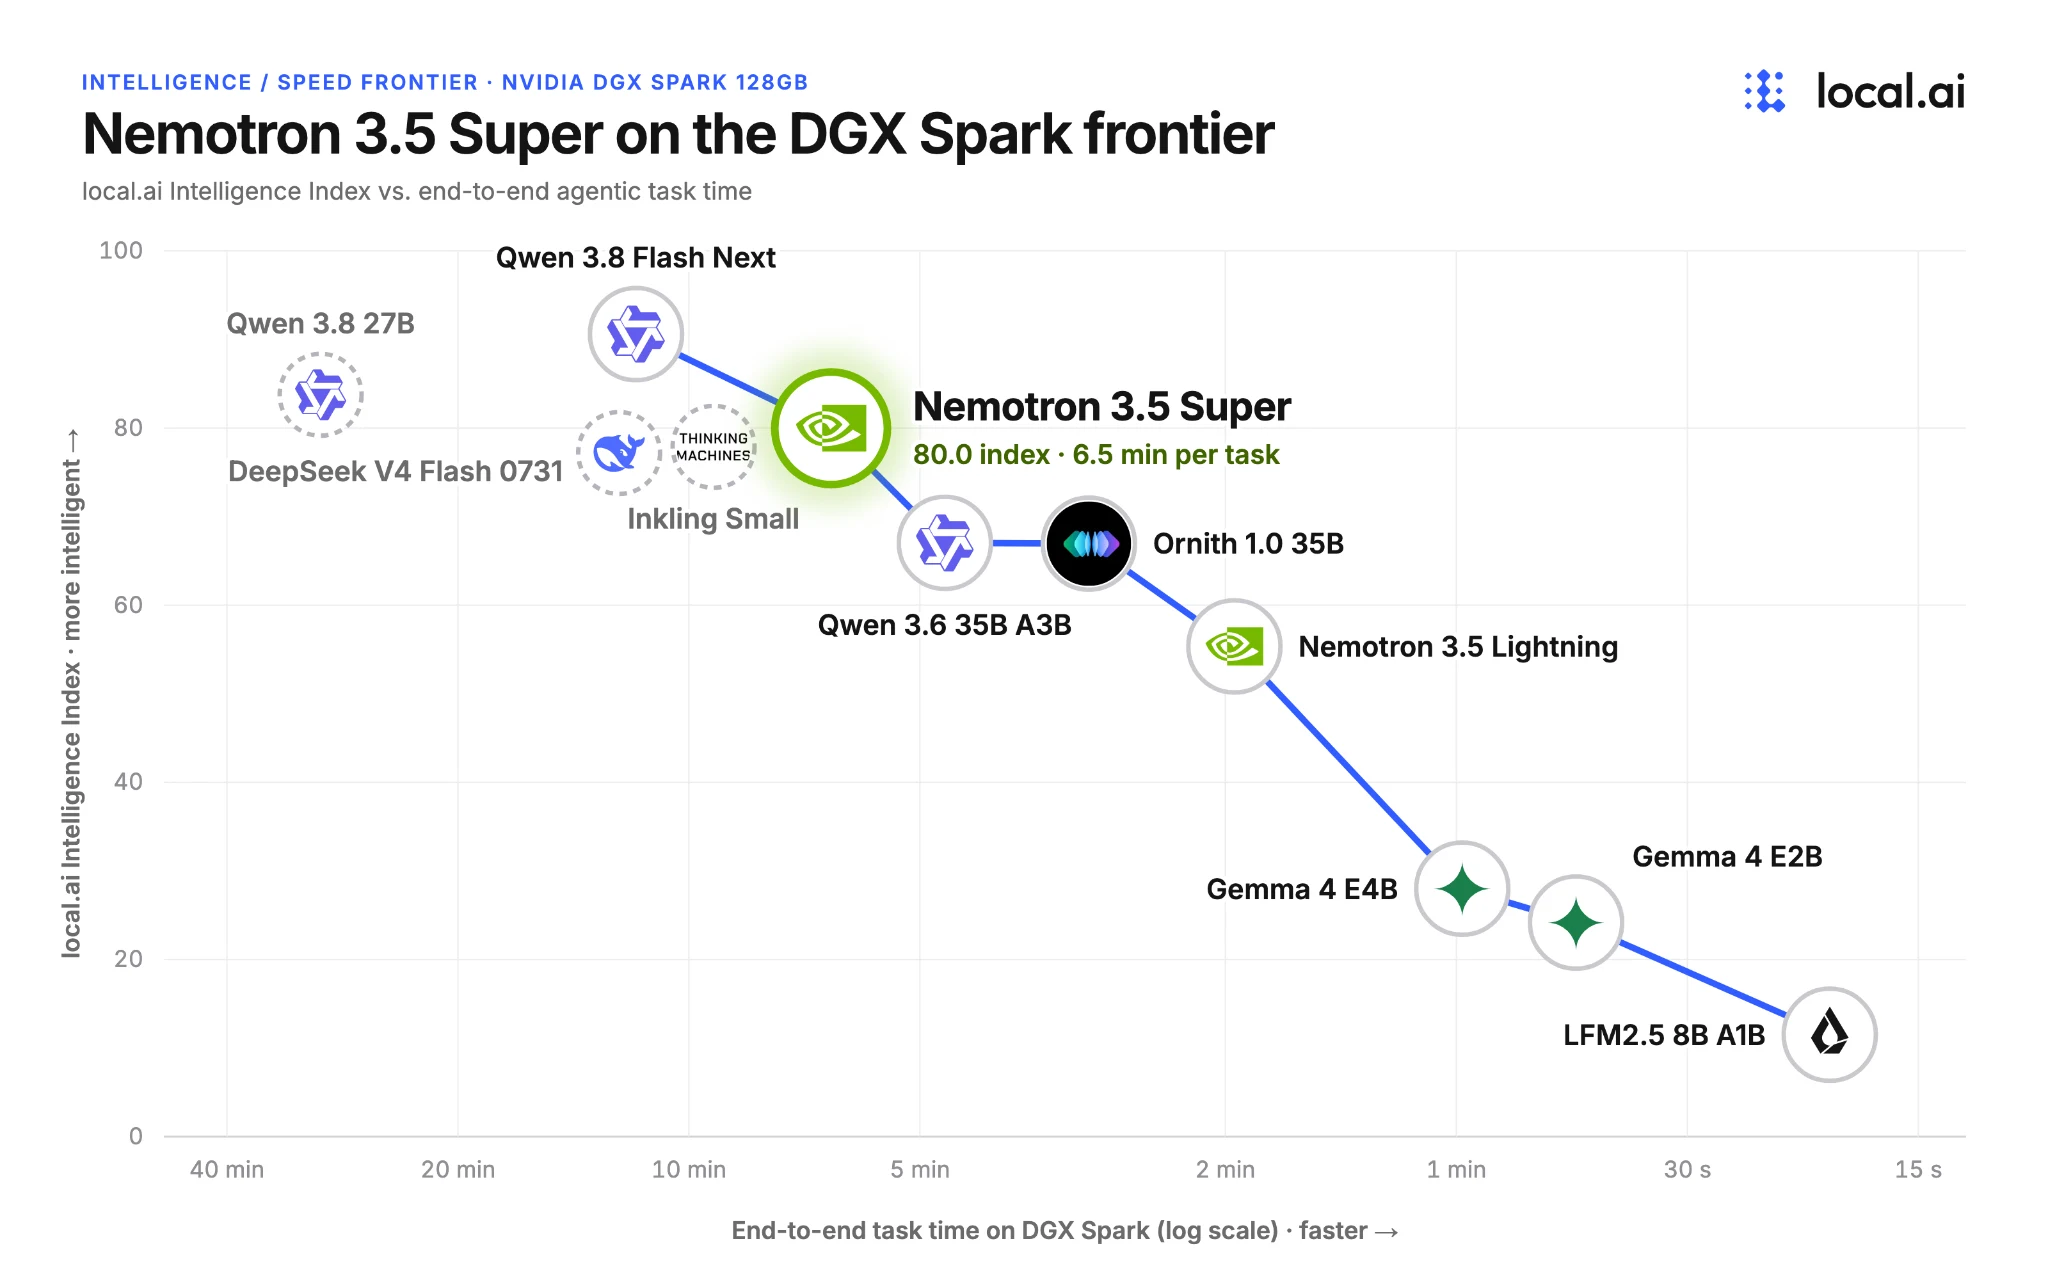
Abbildung 3. Nemotron 3.5 Super an der DGX Spark-Effizienzgrenze.
Erste Schritte
Bereit, Agenten zu bauen, die sehen, schlussfolgern und handeln können?
- Laden Sie die Modellgewichte von Hugging Face herunter: BF16 und NVFP4
- Führen Sie Nemotron 3.5 Super VL mit vLLM aus, indem Sie die Getting-Started Cookbook
Danksagungen
NVIDIA: Nirmal Kumar Juluru, Anusha Pant, Faradawn Yang, Pen Chung Li, Alex Steiner, Ran Zilberstein, Nave Assaf, Amir Klein