
In jedem Gespräch mit Führungskräften aus Unternehmen höre ich dasselbe. Sie möchten, dass Agents mehr tun, aber sie vertrauen ihnen nicht an, es immer richtig zu machen.
Das ist berechtigt. Dieselbe Kreativität und Autonomie, die Agents nützlich macht, macht sie schwer vertrauenswürdig. Gibt man einem Agenten eine Aufgabe, findet er seinen eigenen Weg, sie zu erledigen, und wählt Werkzeuge und Schrittfolgen, die kein Entwickler vorgeschrieben hat. Führt man dieselbe Aufgabe zweimal aus, nimmt er möglicherweise jedes Mal einen anderen Weg. Ein Test, der heute besteht, sagt wenig darüber aus, was der Agent morgen tut.
Die übliche Antwort ist eine Person in der Schleife, die alles genehmigt, was der Agent tut. Das funktioniert im kleinen Maßstab, aber wenn Agents mehr Arbeit übernehmen, stapeln sich die menschlichen Freigaben und die Ermüdung bei der Prüfung setzt ein. Menschen, die alles überprüfen sollen, hören auf, die wichtigen Dinge zu erkennen. Vorsicht wird zum Engpass, und Agents, die weit mehr leisten könnten, sitzen untätig bei der wertvollen Arbeit, die mehr Wirkung erzielen könnte.
Die Lösung besteht darin, den Agenten eigenständig handeln zu lassen, wenn seine Aktionen überprüfbar sind, und das menschliche Urteilsvermögen den Entscheidungen vorzubehalten, die es benötigen. Wenn Agents Arbeitsaufgaben mit höheren Einsätzen übernehmen, etwa Finanztransaktionen, wird eine falsche Aktion zunehmend schädlicher. Organisationen brauchen das Vertrauen, einem KI-Agenten wichtige Arbeit zu übergeben, im Wissen, dass er sich innerhalb der gesetzten Grenzen hält, selbst wenn niemand zusieht. Dieses Vertrauen muss aufgebaut werden.
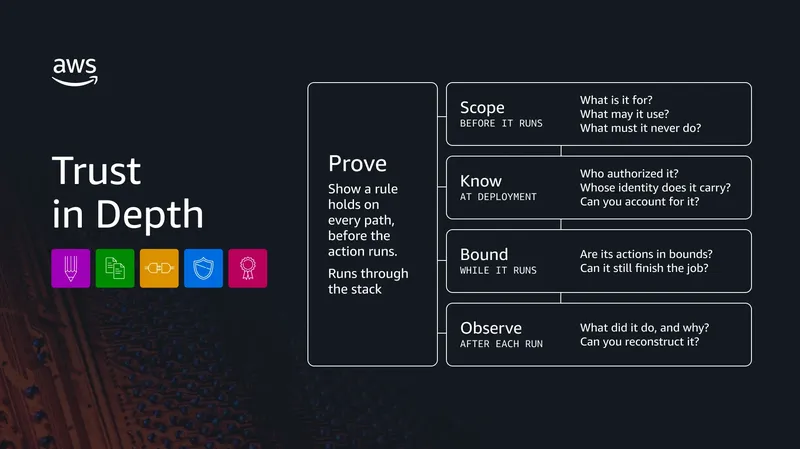
Inhaltsfilterung, Tests und Überwachung erfüllen jeweils einen wichtigen Zweck, aber keine dieser Fähigkeiten kann allein versprechen, dass sich ein Agent beim nächsten Lauf korrekt verhält. Vertrauen entsteht aus unabhängigen Schichten, die sich gegenseitig verstärken – dieselbe mehrschichtige Disziplin, die die Industrie seit zwei Jahrzehnten als Defense in Depth praktiziert, auf einen neuen Zweck ausgerichtet. Wo Defense in Depth begrenzt, was schiefgehen kann, erweitert dies, was man sicher erlauben kann. AWS nennt es Trust in Depth.
Trust in Depth: Vertrauen, das Sie überprüfen können
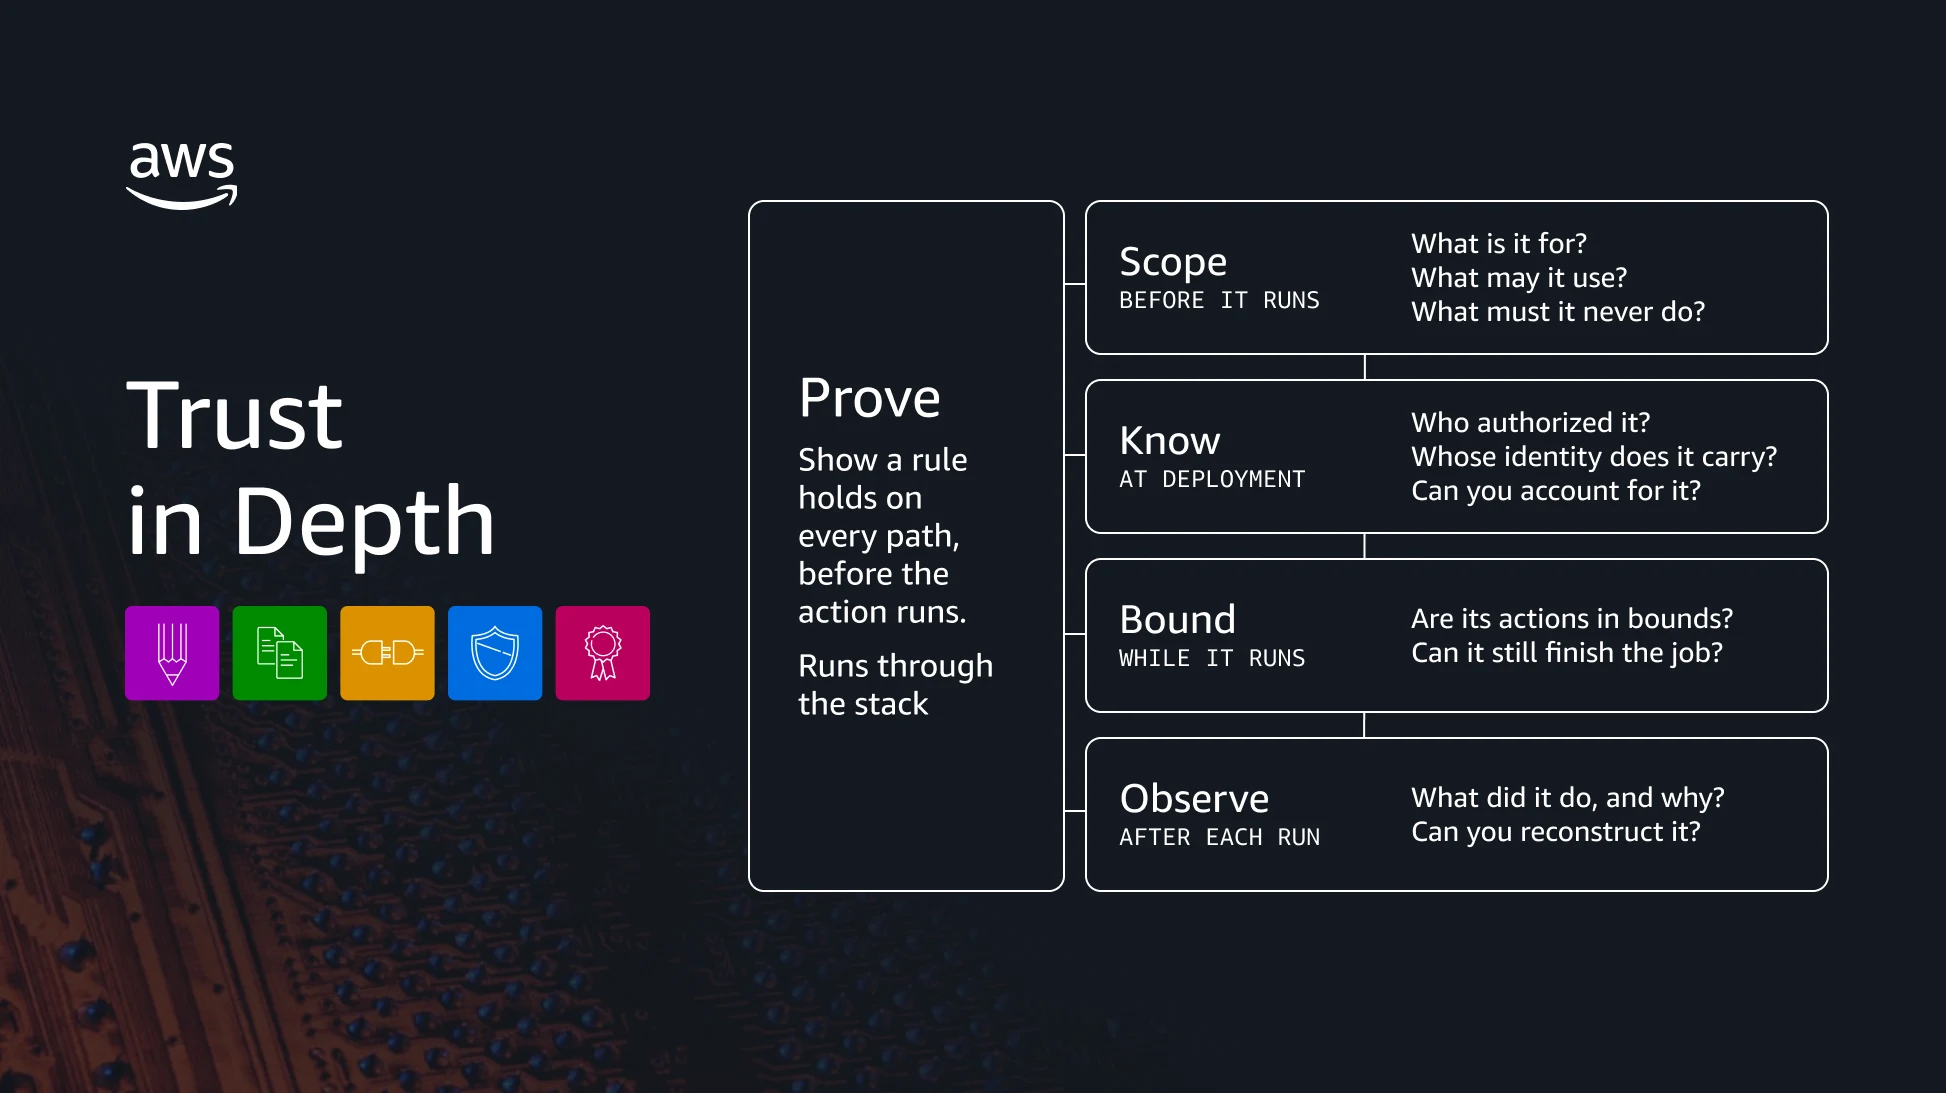
Sie bauen Vertrauen auf, indem Sie eine Reihe von Fragen zu unterschiedlichen Zeitpunkten im Lebenszyklus des Agenten beantworten:
- Scope, bevor er ausgeführt wird: Wofür ist dieser Agent gedacht, welche Fähigkeiten erfordert die Aufgabe, und was darf er niemals tun?
- Know, bei der Bereitstellung: Wer hat ihn autorisiert, welche Identität trägt er, und können Sie jeden Agenten verantworten, der in Ihrem Namen handelt?
- Bound, während er ausgeführt wird: Bleiben seine Aktionen innerhalb der von Ihnen gesetzten Grenzen, und kann er die Aufgabe trotzdem erledigen?
- Observe, nach jedem Lauf: Kö Sie rekonstruieren, was der Agent getan hat und warum, und daraus lernen?
Bei diesen Fragen lassen sich manche Anforderungen als präzise Regeln ausdrücken, während andere Urteilsvermögen erfordern. Ein Unternehmen könnte verlangen, dass nur ein Manager Zugriffe genehmigen kann, oder dass die Anmeldung eines Mitarbeiters blockiert werden muss, bevor sein Postfach geteilt werden kann. Andere Erwartungen, wie etwa ein freundlicher Ton oder der angemessene Umgang mit einer sensiblen Situation, hängen vom Kontext und vom menschlichen Urteilsvermögen ab.
Bei präzise definierten Regeln zeigt das Testen, ob die Kontrollen in den von Ihnen antizipierten Fällen funktionieren, aber ein Agent nimmt Wege, die Sie nicht vorgesehen haben. Die Technologie, die weiter geht, ist automated reasoning, die mathematische Logik, die prüft, ob eine Regel in jedem möglichen Fall gilt. Sie kann feststellen, dass eine Regel auf jedem Pfad gilt, der von einer präzisen Beschreibung des Systems und seiner Annahmen abgedeckt wird, oder den genauen Fall aufdecken, in dem sie versagt. Dieses Ergebnis ist ein Beweis, und er ist nur so gut wie die Regeln und Annahmen dahinter – weshalb die schwierigste Arbeit stattfindet, bevor der Agent ausgeführt wird.
AWS setzt automated reasoning seit mehr als einem Jahrzehnt in der Produktion ein, von Identity and Access Management (IAM) mit mehr als 2.1 Milliarden Anfragen pro Sekunde bis hin zu kritischen Systemen wie dem AWS Nitro Hypervisor, Amazon S3 Block Public Access und dem VPC Reachability Analyzer. Jetzt bringen wir es zu Agents. Überall dort, wo die Regeln eines Agenten präzise formuliert werden können, kann automated reasoning sie überprüfen.
Allerdings lässt sich nicht jede Regel präzise formulieren. „Nur ein Manager kann Zugriffe genehmigen“ lässt sich beweisen. „Halte einen freundlichen Ton“ nicht. Wo ein Beweis nicht anwendbar ist, begrenzen Sie den Zugriff und die Aktionen des Agenten, bewerten Sie sein Verhalten und leiten Sie echte Mehrdeutigkeit an eine Person zur Beurteilung weiter. Gewähren Sie mehr Autonomie, wenn Sie festgestellt haben, dass die relevanten Regeln durchgesetzt werden, der Agent die Aufgabe zuverlässig erfüllt und Fehler erkannt und behandelt werden können.
Hier ist, was jede Trust-in-Depth-Schicht von Ihnen verlangt und wie AWS Ihnen hilft, sie zu beantworten.
Begrenzen Sie Ihren Agenten auf genau das, was die Aufgabe erfordert
Vertrauen beginnt, bevor ein Agent ausgeführt wird, und genau hier sollten Sie den größten Aufwand investieren. Probleme, die hier erkannt werden, lassen sich kostengünstig beheben. Scoping bedeutet zu entscheiden, welche Arbeit der Agent übernimmt, auf welche Werkzeuge, Daten und Dienste er zugreifen darf, welchen Regeln er folgen muss und welche Entscheidungen bei einer Person bleiben.
„Das Problem des Kunden lösen“ sagt, was erreicht werden soll, nicht wie der Agent handeln darf, um es zu erreichen. Der Agent benötigt weiterhin Grenzen, was er sehen darf, was er tun darf und wann er anhalten und nachfragen muss. Geben Sie ihm nur den Zugriff, den seine Aufgabe erfordert, und nicht mehr. Achten Sie auf Fähigkeiten, die niemand absichtlich gewährt hat, diejenigen, die mit einem Werkzeug oder einer Rolle gebündelt sind. Gewähren Sie eine Admin-Rolle für eine Aufgabe, kann der Agent Berechtigungen in Ihrer gesamten Umgebung erben.
Das Scoping beginnt bereits in der Build-Phase, und zwar damit, wie Sie den Agenten definieren. Kiro, das agentische Coding-System, bringt Strenge und ausgereifte Engineering-Praktiken in die Build-Phase von Agenten. Es verwandelt übergeordnete Absichten in strukturierte, spec-getriebene Anforderungen und nutzt automatisiertes Reasoning, um Widersprüche, Mehrdeutigkeiten und Lücken aufzudecken, bevor überhaupt Code geschrieben wird. Kiro leitet außerdem property-basierte Tests ab, die die Implementierung über ein breites Spektrum an Eingaben hinweg gegen diese Anforderungen prüfen und Fehler aufspüren, die nur schwer zu erkennen sind. Strands bietet ein Open-Source-Toolkit zur Definition des Modells, der Anweisungen und der Werkzeuge eines Agenten sowie eine verwaltete Laufzeitumgebung für dessen Betrieb. Welches Framework Sie auch wählen: Die Verantwortung, den Auftrag des Agenten und seine Grenzen zu definieren, bleibt dieselbe.
Der nächste Schritt besteht darin, diese Grenzen in Regeln zu übersetzen, an die Sie den Agenten halten können. Amazon Bedrock AgentCore stellt Governance-Kontrollen bereit, um Agenten sicher zu skalieren, und regelt, was der Agent tut. Mithilfe von Policies in Bedrock AgentCore beschreiben Sie in natürlicher Sprache, welche Tools, APIs und Daten der Agent erreichen darf, und automatisiertes Reasoning prüft die Policy auf Lücken – etwa eine Regel, die zu weitreichende Berechtigungen gewährt – sowie auf Widersprüche, die dazu führen, dass eine Regel nie erfüllt werden kann, bevor sie in Kraft tritt.
Das Scoping Ihres Agenten ist der schwierige Teil, denn die Überführung menschlicher Absicht in eine dauerhafte, durchsetzbare Policy erfordert Präzision und Vollständigkeit. Es ist jedoch auch der Teil, der sich am meisten auszahlt. Alles baut darauf auf, was Sie hier festlegen, und je präziser die Policy, desto mehr kann Ihr Agent sicher eigenständig erledigen.
Kennen Sie jeden Agenten, der in Ihrem Namen handelt, und dessen Autorität
Sie können nicht steuern, was Sie nicht sehen. Teams erstellen Agenten schneller, als jemand sie verfolgen kann, und ein Agent, den niemand kennt, ist ein Agent, den niemand kontrolliert. Jeder Agent benötigt eine eigene Identität, die bei jeder Aktion überprüft wird. Keine Aktion sollte ohne Zuordnung bleiben. Wenn etwas schiefgeht, können Sie feststellen, welcher Agent was getan hat und wer es autorisiert hat.
AWS Agent Registry bietet einen verwalteten, freigegebenen Katalog der Agenten, Model Context Protocol (MCP)-Server, Tools und Skills in Ihrer gesamten Organisation. Administratoren verwenden Genehmigungs-Workflows, um zu steuern, was auffindbar wird, und zu entfernen, was den Anforderungen an Sicherheit, Compliance und Qualität nicht mehr genügt. Sowohl Personen als auch Agenten können finden und wiederverwenden, was bereits existiert, anstatt es neu zu erstellen. Aber ein Katalog zeigt Ihnen nur, was existiert. Sobald die Agenten bekannt sind, stellt AgentCore jedem Agenten eine eigene Identität aus und überprüft sie bei jeder Anfrage, sodass jede Aktion auf einen bestimmten Agenten zurückverfolgt werden kann, der unter einer bekannten Autorität handelt. So wissen Sie, dass Sie jeden Agenten kennen, der in Ihrem Namen handelt.
Begrenzen Sie, was Ihr Agent sagt und tut, innerhalb der von Ihnen gesetzten Grenzen
Grenzen sind wichtig, weil ein Agent 10 Schritte ausführen kann, die Sie genehmigt haben, und dennoch ein Ergebnis erreichen kann, das niemand beabsichtigt hat. Er kann sensible Daten offenlegen, vom Thema abweichen oder zulässige Aktionen auf eine Weise kombinieren, die Ihre Policies verbieten. Grenzen können in beide Richtungen fehlschlagen. Zu weit gefasst, kann der Agent tun, was er nicht sollte. Zu eng gefasst, kann er seinen Auftrag gar nicht erfüllen. Lassen Sie den Agenten also wählen, wie er seine Aufgabe verfolgt, aber verlassen Sie sich nie darauf, dass er seine eigenen Grenzen durchsetzt. Diese Grenzen definieren die Grenzen des Agenten und gehören in die Umgebung um den Agenten herum – deterministisch durchgesetzt und über die gesamte Sequenz von Aktionen hinweg bewertet, nicht Schritt für Schritt.
Hier greift die Policy, die Sie im Bereich Scope definiert haben. Policy in AgentCore setzt sie bei jedem Tool-Aufruf durch, der über das AgentCore Gatewaygeleitet wird, einen sicheren Eingangspunkt für Agenten, Tools und Modelle. Da die Durchsetzung außerhalb des Reasonings des Agenten liegt, bleiben dieselben Prüfungen auch wirksam, wenn der Agent fehlerhaft ist, manipuliert wird oder einem Prompt Injection-Angriff ausgesetzt ist: Er kann keine Kontrolle abschalten, die er nicht selbst ausführt. Auch die Autorität muss nicht fest bleiben. Da das Risiko einer Aufgabe sich im Verlauf ändert, wägen temporal policies ab, was in einer Sitzung bereits geschehen ist, und passen die Berechtigungen an, während die Arbeit fortschreitet. Amazon Bedrock Guardrails regelt, was der Agent sagt und was ihm mitgeteilt wird. Es filtert schädliche oder themenfremde Inhalte heraus und schwärzt sensible Daten. Automated Reasoning checks gehen weiter und beweisen, dass eine Antwort mit der von Ihnen gesetzten Policy übereinstimmt – nicht mit der Interpretation des Modells.
Grenzen steuern auch, was ein Agent überhaupt erreichen kann: welche Dateien er berühren darf, welche Dienste er aufrufen darf und welche Zugangsdaten er verwenden darf. Strands Box, eine Open-Source-Sandbox, setzt diese Grenzen von außerhalb der Anweisungen des Agenten durch, sodass der Agent mit echten Tools und Daten arbeiten kann, aber nur das erreicht, was Sie erlauben. Dieselben Grenzen gelten vom ersten lokalen Entwicklersitzung bis in die Produktion, sodass ein Agent in der Produktion nicht tun kann, was er in der Entwicklung nicht konnte.
Beobachten Sie, was Ihr Agent getan hat, und verbessern Sie ihn dann
Auch wenn Scoping, Identität und Grenzen vorhanden sind, kann ein Agent in Millisekunden reagieren, ohne Fehler und mit grünen Dashboards, und trotzdem das Falsche tun. Er hat möglicherweise die falschen Informationen abgerufen, das falsche Tool gewählt oder einen Pfad verfolgt, den niemand erwartet hat. Ein gesundes System ist nicht dasselbe wie eine erfolgreiche Aufgabe. Um den Unterschied zu erkennen, müssen Sie nachvollziehen, was der Agent tatsächlich getan hat: den Kontext, den er erhalten hat, die Tools, die er aufgerufen hat, die angewendeten Richtlinienentscheidungen und das Ergebnis. Tests vor der Bereitstellung bleiben unerlässlich. Die Produktion liefert Belege über das Verhalten unter realen Bedingungen und gibt Betreibern, was sie benötigen, um zu untersuchen, einzugreifen und zu verbessern.
Amazon CloudWatch Omni wurde für kontinuierliche Beobachtung entwickelt. Es erfasst jeden Trace und stellt jeden Schritt, den ein Agent unternommen hat, von Modellaufrufen bis zu Toolaufrufen, auf einer Timeline dar, die ein Team untersuchen kann. Die integrierten Evaluatoren bewerten Agent-Antworten hinsichtlich Qualitäten, die Standard-Monitoring verfehlt, wie Korrektheit, Treue zur Quelle und ob der Agent das richtige Tool gewählt hat. Und die Traces, in denen ein Agent falsch lag, werden zum Datensatz, gegen den Sie die Korrektur testen, sodass der Betrieb eines Agents und seine Verbesserung auf dieselben Belege zurückgreifen.
Wie Trust in Depth in der Praxis aussieht
Eine Managerin bittet einen Helpdesk-Agenten, Sam zu deaktivieren, einen Account Manager, der das Unternehmen verlässt. Der Agent muss Sams Zugriff entfernen, sein Postfach an seinen Nachfolger übertragen und die Lizenz freigeben, die das Unternehmen nicht mehr benötigt. Aber Sams E-Mails können auch Beweise für einen Kundenstreit enthalten. Die falsche Reihenfolge könnte dazu führen, dass Sam nach seinem Ausscheiden noch Zugriff hat, oder diese Beweise gefährden. Sicherheit, Messaging, Recht und Finanzen haben jeweils Anforderungen, die der Agent einhalten muss, obwohl niemand den vollständigen Workflow vorgeschrieben hat.
Zwei Regeln bestimmen die Reihenfolge. Sams Anmeldung muss blockiert werden, bevor sein Postfach umgewandelt und mit seinem Nachfolger geteilt werden kann. Vor der Änderung seiner E-Mail-Lizenz muss der Agent nach einem Legal Hold prüfen, einer Anforderung, Unterlagen für einen Streit aufzubewahren, und bestätigen, dass die Änderung diese Unterlagen geschützt hält.
Scope. Bevor der Agent ausgeführt wird, schreibt das Team diese Regeln als Policies in AgentCore. Jede Policy erfordert, dass der vorausgesetzte Schritt bereits erfolgreich für Sams Konto abgeschlossen wurde, bevor der nächste Schritt ausgeführt werden kann. Der Agent erhält genau sechs Tools: Anmeldung blockieren, nach Legal Holds suchen, einen Hold anlegen, ein Postfach umwandeln, dem Nachfolger Zugriff geben und eine Lizenz ändern. Er erhält kein Tool zum Löschen des Kontos, weil das geteilte Postfach das Konto benötigt.
Know. Der Agent besitzt seine eigene Identität, sodass jede Änderung an Sams Konto zu ihm zurückverfolgt werden kann.
Bound. Der Agent versucht, Sams Postfach in ein geteiltes Postfach für Priya, die Nachfolgerin, umzuwandeln. Eine Policy in AgentCore, durchgesetzt am AgentCore Gateway, blockiert den Aufruf: Sam kann sich noch immer anmelden, und die Umwandlung des Postfachs würde sein Passwort nicht ändern, sodass seine alten Zugangsdaten es weiterhin öffnen würden. Der Agent blockiert Sams Anmeldung, wandelt dann das Postfach um und gibt Priya Zugriff. Danach geht er zur eigentlichen Anfrage der Managerin über, die Lizenz freizugeben, aber das Gateway blockiert auch das, weil niemand Rechtsabteilungs-Hold-Liste geprüft hat. Der Agent prüft und stellt fest, dass die Rechtsabteilung verlangt, Sams E-Mails für einen Kundenstreit aufzubewahren. Er legt den Hold an, bestätigt, dass er wirksam ist, und ändert dann Sams Lizenz auf eine, die diesen Schutz unterstützt. Das Unternehmen kann die größere Lizenz zurückfordern und die Beweise bleiben erhalten.
Observe. Jeder Schritt wird aufgezeichnet: was der Agent zu tun versuchte, was die Regeln entschieden haben, der Hold und das Ergebnis.
Der Agent hat die Aufgabe abgeschlossen, ohne dass eine Person jeden Schritt genehmigte. Seine Berechtigungen begrenzten, was er ändern konnte, seine Identität machte diese Änderungen nachverfolgbar, und Policies hielten ihn davon ab zu handeln, bevor die erforderlichen Schutzmaßnahmen vorhanden waren. Die aufgezeichneten Schritte ermöglichten es dem Team zu überprüfen, dass Sams Zugriff blockiert war, seine Nachfolgerin das Postfach nutzen konnte und die erforderlichen Beweise geschützt blieben.
Was möglich wird, wenn Agenten vertraut wird
AWS bringt diese Ebenen zusammen, damit Sie einen Agenten auf seine Aufgabe beschränken, wissen können, welche Agenten für Sie handeln, begrenzen können, was sie tun und sagen, sehen können, was sie getan haben und sich im Zeitverlauf verbessern, und beweisen können, dass Ihre Regeln gelten, wo immer sie sich präzise formulieren lassen. Keine einzelne Ebene allein erwirkt dieses Vertrauen. Zusammen sind sie Trust in Depth, und sie machen aus einem fähigen Agenten einen Agenten, dem man vertrauen kann, wichtige Arbeit zu erledigen.
Sie ziehen die Grenzen: was ein Agent eigenständig tun darf, was die Genehmigung einer Person erfordert und wann er stoppen muss. Das befreit Ihre Mitarbeitenden für das, was nur Menschen können: schwierige Abwägungen treffen, Grauzonen klären und die Entscheidungen treffen, die Sie bewusst in menschlicher Hand behalten möchten. Wenn sich Belege dafür häufen, dass ein Agent sich innerhalb dieser Grenzen hält, können Sie seine Verantwortung erweitern oder einschränken.
Bei AWS glauben wir, dass jede Organisation, die Agenten einsetzt, auf jeder Plattform, diese vier Fragen mit Belegen beantworten können sollte, und mit Beweisen, wo immer diese anwendbar sind. Das ist die Messlatte, die AWS für unsere Kunden ansetzt, und diejenige, zu der wir die Branche auffordern, sich zu verpflichten. Defense in Depth machte es sicher, Systeme mit der Welt zu verbinden. Trust in Depth macht es sicher, Agenten darin autonom handeln zu lassen.
Beginnen Sie mit einem Agenten, einem Workflow und einer Grenze, die Sie beweisen können. Erweitern Sie dann, wenn das Vertrauen verdient ist.
Um mit der Umsetzung durchsetzbarer Regeln zu beginnen, erkunden Sie Policy in Amazon Bedrock AgentCore und Automated Reasoning checks in Amazon Bedrock Guardrails.