
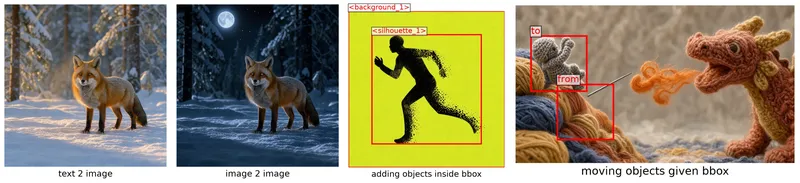
Black Forest Labs FLUX.3 Image Klein ist da und läuft in Diffusers vom ersten Tag an. Ein Modell beherrscht Text-to-Image und Multi-Reference Image-to-Image und bringt etwas Neues mit: Layout-Steuerung. Sie schreiben Bounding Boxes in den Prompt, um anzugeben, wo jeder Teil des Bildes platziert werden soll oder welche Teile eines Referenzbildes verschoben werden.
Beide offenen Checkpoints sind in der FLUX.3 Image Klein Sammlung:
| Checkpoint | Was es ist | Standardeinstellungen |
|---|---|---|
black-forest-labs/flux-3-image-klein |
Time step distilled, für schnelle Inferenz | 16 Schritte, kein CFG |
black-forest-labs/flux-3-image-klein-base |
Basismodell | 50 Schritte, CFG |

Sie können direkt in den Hugging Face Space gehen und sofort einige Bilder generieren!
TL;DR
- Ein Modell für Text-to-Image, Multi-Reference Image-to-Image und Bounding-Box-Layout-Steuerung.
- Der distillierte Checkpoint erzeugt ein 1024 × 1024 Bild in etwa 2 Sekunden auf einer H100.
- NVFP4- und FP8-Gewichte laden mit
from_single_file, für kleinere GPUs. - LoRA-Trainingsskripte für Text-to-Image und Bildbearbeitung.
- Wird als Modular Diffusers Pipeline ausgeliefert, sodass Sie Blöcke herausnehmen oder eigene hinzufügen können.
Inhalt
- Erste Schritte
- Was FLUX.3 kann
- Basismodell und quantisierte Varianten
- LoRA-Finetuning
- Was der Betrieb kostet
- Die Architektur
- Modular Diffusers
- Ausprobieren
Erste Schritte
Installieren Sie die neueste Version diffusers und transformers (für den Qwen3-VL-Textencoder):
pip install -U diffusers transformers
Laden Sie den destillierten Checkpoint und generieren Sie ein Bild:
import torch
from diffusers import ModularPipeline

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein")
pipe.load_components(dtype=torch.bfloat16)
pipe.to("cuda")

pipe(prompt="a red fox", output="images")[0].save("fox.png")
Was FLUX.3 kann
Text-zu-Bild
FLUX.3 reagiert am besten auf eine vollständige Szenenbeschreibung mit dem Motiv, dem Umfeld, dem Licht, der Komposition und dem Stil. Der offizielle Prompting-Leitfaden von Black Forest Labs enthält weitere Tipps. Das distillierte Checkpoint erzeugt standardmäßig ein 1024 × 1024 Bild in 16 Schritten. Übergib height, width, oder num_inference_steps , um sie zu ändern.
prompt = (
    "A wide-angle wildlife photograph of a red fox standing alert in a snow-covered forest clearing at golden hour. "
    "The fox is centered in the frame, its thick orange winter coat contrasting with the fresh white snow, breath "
    "visible in the cold air. Snow-laden pine trees fill the softly blurred background, and low warm sunlight rakes "
    "across the scene from the left, casting long blue shadows."
)

fox = pipe(
    prompt=prompt,
    generator=torch.Generator().manual_seed(0),
    output="images"
)[0]
fox.save("fox.png")
 |
|---|
| Text zu Bild |
Bild-zu-Bild
Übergib ein (oder mehrere) Referenzbild(er) mit dem image Argument. Schreibe den Prompt als Bildunterschrift des Bildes, das du willst, mit der enthaltenen Änderung.
prompt = (
    "The same red fox in the same snow-covered forest clearing, now at night under a full moon: cool blue "
    "moonlight, deep shadows, stars visible through the pine branches, the fox's eyes catching the light."
)
night = pipe(
    prompt=prompt,
    image=fox, # from the previous text to image example
    generator=torch.Generator().manual_seed(0),
    output="images",
)[0]
night.save("night.png")
 |
|---|
| Bild zu Bild |
Bei mehreren Referenzen beziehe dich im Prompt darauf als <ref_image_0>, <ref_image_1>, ... in der Reihenfolge, in der sie an image:
red_fox = pipe(prompt="a red fox", generator=torch.Generator().manual_seed(0), output="images")[0]
bench = pipe(prompt="a wooden bench", generator=torch.Generator().manual_seed(0), output="images")[0]

combined = pipe(
    prompt="The fox from <ref_image_0> sitting on the wooden bench from <ref_image_1> in a snowy setting.",
    image=[red_fox, bench],
    output="images",
)[0]

combined.save("combined.png")
 |
 |
 |
|---|---|---|
<ref_image_0>übergeben werden: ein roter Fuchs |
<ref_image_1>: eine Holzbank |
Der Fuchs auf der Bank |
Layout-Steuerung
Füge nach der Bildunterschrift eine JSON-Liste von Regionen hinzu. Jede Region hat eine id, eine bboxund eine desc, und die Bildunterschrift erwähnt sie als <id>.
Boxen werden als
[y_min, x_min, y_max, x_max], y zuerst, auf einer Skala von 0 bis 1000 geschrieben. Da die Skala normalisiert ist, funktioniert dieselbe Box bei jeder Bildgröße.
Platzieren von Regionen in einem neuen Bild
layout_prompt = (
    "Minimalist graphic illustration featuring a black silhouette of a person <silhouette_1> centered against a "
    "solid, vibrant chartreuse background <background_1>. The figure is captured in a dynamic, mid-stride running "
    "pose, facing toward the left side of the frame. "
    '[{"id": "background_1", "bbox": [0, 0, 1000, 1000], "desc": "A flat field of neon yellow-green with a subtle '
    'paper texture and fine, organic grain."}, {"id": "silhouette_1", "bbox": [150, 150, 850, 850], "desc": "A '
    "black silhouette of a person in motion, made of dense stippled ink. The leading edges are solid; the trailing "
    'arm and leg dissolve into coarse square pixels and scattered dots."}]'
)

runner = pipe(prompt=layout_prompt, generator=torch.Generator().manual_seed(0), output="images")[0]
 |
|---|
Die desc jeder Region wird innerhalb ihrer bbox |
Regionen innerhalb eines Referenzbildes verschieben
Bei Bearbeitungen gibt jede Region an, woher ihr Inhalt kommt aus (src_bbox im Referenzbild) und wohin er geht (tgt_bbox in der Ausgabe). Eine Region mit denselben beiden Boxen bleibt, wo sie ist.
Dieses Beispiel verschiebt den gestrickten Ritter nach oben und nach links und fixiert den Hintergrund, die Klippe, die Nadel, den Drachen und das Feuer:
from diffusers.utils import load_image

knight_image = load_image("knight_orig.png")
edit_prompt = (
    "In <ref_image_0>, move the miniature grey amigurumi knight figure <knight_1> upwards and to the left along the "
    "yarn cliff <cliff_1>. Keep the rest of the image completely unchanged, preserving the blurred yarn backdrop "
    "<backdrop_1>, the large knitted dragon <dragon_1>, and the fiery orange thread <fire_1>. "
    '[{"id": "knight_1", "from": "ref_image_0", "src_bbox": [500, 150, 850, 350], "tgt_bbox": [194, 55, 544, 255], '
    '"desc": "A miniature amigurumi knight crocheted from thick grey woolen yarn."}, '
    '{"id": "backdrop_1", "from": "ref_image_0", "src_bbox": [0, 0, 1000, 1000], "tgt_bbox": [0, 0, 1000, 1000], '
    '"desc": "A soft, out-of-focus backdrop of cream and indigo knitted yarn."}, '
    '{"id": "cliff_1", "from": "ref_image_0", "src_bbox": [300, 0, 1000, 450], "tgt_bbox": [300, 0, 1000, 450], '
    '"desc": "A steep cliff of stacked yarn skeins in mustard, terracotta, and indigo."}, '
    '{"id": "needle_1", "from": "ref_image_0", "src_bbox": [420, 250, 550, 450], "tgt_bbox": [420, 250, 550, 450], '
    '"desc": "An oversized polished steel tapestry needle."}, '
    '{"id": "dragon_1", "from": "ref_image_0", "src_bbox": [100, 600, 950, 1000], "tgt_bbox": [100, 600, 950, 1000], '
    '"desc": "A large, fluffy knitted dragon in terracotta and mustard yarn."}, '
    '{"id": "fire_1", "from": "ref_image_0", "src_bbox": [350, 400, 650, 650], "tgt_bbox": [350, 400, 650, 650], '
    '"desc": "Curled puffs of fiery orange angora thread suspended in mid-air."}]'
)

moved = pipe(prompt=edit_prompt, image=knight_image, generator=torch.Generator().manual_seed(0), output="images")[0]
 |
|---|
Der Ritter bewegt sich von seiner src_bbox zu seiner tgt_bbox, und der Rest der Szene bleibt an Ort und Stelle |
Basismodell und quantisierte Varianten
Basismodell
Alles oben Genannte verwendet den destillierten Checkpoint. Der Basis-Checkpoint läuft 50 Schritte mit classifier-free guidance, und er ist derjenige zum Fine-Tuning (siehe LoRA-Feinabstimmung).
pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein-base")
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
pipe.to("cuda")

pipe.guider = pipe.guider.new(guidance_scale=5.0)  # optional
image = pipe(prompt=prompt, output="images")[0]
Single-File-Format-Checkpoints
Black Forest Labs liefert den Transformer auch als einzelne Datei, in bf16 und in zwei quantisierten Formaten: fp8r (rowwise FP8) und nvfp4. Laden Sie eines davon mit from_single_file, und laden Sie dann die anderen Komponenten namentlich, damit der bf16-Transformer nicht ebenfalls heruntergeladen wird.
from diffusers import BFLQuantizationConfig, Flux3Transformer2DModel, ModularPipeline

model_id = "black-forest-labs/flux-3-image-klein-base"
variant = "fp8r"  # or "nvfp4"

transformer = Flux3Transformer2DModel.from_single_file(
    f"https://huggingface.co/{model_id}/blob/main/variants/{variant}/model.safetensors",
    config=model_id,
    subfolder="transformer",
    quantization_config=BFLQuantizationConfig(compute_dtype=torch.bfloat16),
    dtype=torch.bfloat16,
)

pipe = ModularPipeline.from_pretrained(model_id)
pipe.load_components(dtype=torch.bfloat16)
pipe.update_components(transformer=transformer)
pipe.to("cuda")
Für die unquantisierte Einzeldatei verwenden Sie https://huggingface.co/{model_id}/blob/main/model.safetensors und lassen quantization_config.
| Variante | Schnelle Kernels auf | anderen GPUs |
|---|---|---|
fp8r |
Compute Capability 8.9+ (Ada, Hopper, Blackwell) | Die Gewichte werden in jedem Schritt dequantisiert: weniger Speicher, keine Geschwindigkeitssteigerung |
nvfp4 |
Blackwell, mit flashinfer-python und flashinfer-cubin bei derselben Version |
Wie oben |
LoRA-Finetuning
FLUX.3 funktioniert sowohl für Text-to-Image als auch für Image-to-Image, was es zu einer hervorragenden Grundlage für benutzerdefinierte LoRAs macht. diffusers liefert DreamBooth-LoRA-Trainingsskripte für beide Aufgaben mit (Sie können auch trainieren mit Ostris' AI Toolkit).
Hier ist ein Text-to-Image-Beispiel, das einen Tarot-Karten-Stil aus dem multimodalart/1920-raider-waite-tarot-public-domain -Datensatz lernt, ausgelöst mit trtcrd:
accelerate launch train_dreambooth_lora_flux3_klein.py \
  --pretrained_model_name_or_path="black-forest-labs/flux-3-image-klein-base" \
  --dataset_name="multimodalart/1920-raider-waite-tarot-public-domain" \
  --caption_column="caption" \
  --instance_prompt="trtcrd" \
  --output_dir="trained-flux3-tarot-lora" \
  --mixed_precision="bf16" \
  --resolution=1024 \
  --use_aspect_ratio_buckets \
  --train_batch_size=1 \
  --rank=16 \
  --lora_alpha=16 \
  --learning_rate=1e-4 \
  --lr_scheduler="constant" \
  --max_train_steps=1500 \
  --validation_prompt="a trtcrd of a cat, tarot style" \
  --validation_epochs=25 \
  --seed=0 \
  --push_to_hub
Um den Speicherverbrauch zu reduzieren, fügen Sie einige Optimierungs-Flags hinzu:
  --gradient_checkpointing \
  --cache_latents \
  --use_8bit_adam
--gradient_checkpointingberechnet Aktivierungen im Backward-Pass neu (weniger VRAM, etwas langsamer),--cache_latentskodiert die Bilder vor und gibt den VAE frei, und--use_8bit_adamhält die Optimizer-States in 8-bit.
Ein paar Stellknöpfe sind einen Experimentierversuch wert. Das Raster unten trainiert denselben Tarot-Stil mit verschiedenen LoRA-Ranks und Optimizern; die Adapter sind auf dem Hub unter diffusers-modular/flux3-tarot-lora. Weitere Trainingsfunktionen und Konfigurationen sind in der DreamBooth FLUX.3 README.

dokumentiert. Für instruktionsbasiertes Bearbeiten trainiert das Image-to-Image-Skript (train_dreambooth_lora_flux3_klein_img2img.py) auf (Referenzbild, Zielbild, Instruktions)-Tripeln, wobei die Referenz im Prompt angesprochen wird als <ref_image_0>.
Siehe die DreamBooth FLUX.3 README für alle Optionen und das vollständige Image-to-Image-Beispiel.
Was der Betrieb kostet
In diesem Abschnitt sprechen wir über den Speicherverbrauch und die Geschwindigkeit der Generierung der Modelle.
Speicher
| Name | peak allocated (nach dem Laden) GiBs | peak allocated (nach der Inferenz) GiBs |
|---|---|---|
| nvfp4 (RTX6000) | 13.4 | 15.3 |
| fp8r (H100) | 14.35 | 16.27 |
| bf16 (H100) | 18.80 | 20.72 |
Wenn Sie weniger Speicher haben:
- Lade einen quantisierten Transformer.
- Führe den Text-Encoder separat aus und gib ihn frei. Er läuft nur einmal pro Bild, vor der Denoising (siehe Einmal kodieren, vieles generieren).
- Aktiviere automatisches CPU-Offloading, das jede Komponente nur dann auf die GPU verschiebt, während sie läuft (das haben wir nicht gebenchmarkt)
from diffusers import ComponentsManager, ModularPipeline

manager = ComponentsManager()
manager.enable_auto_cpu_offload(device="cuda")

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein", components_manager=manager)
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
# no pipe.to("cuda"): the manager handles device placement
Geschwindigkeit
End-to-End-Zeiten für den destillierten Checkpoint (16 Schritte), gemittelt über drei Läufe nach einem Warmup:
| Workflow | Ausgabegröße | Zeit | Spitzenspeicher |
|---|---|---|---|
| Text-to-Image | 1024 × 1024 | 1,93 s | 23.8 GiB |
| Image-to-image, eine 1024 × 1024 Referenz | 1024 × 1024 | 3.87 s | 23.8 GiB |
| Layout-Bearbeitung (der Springer), eine 1360 × 768 Referenz | 1360 × 768 | 4.10 s | 23.8 GiB |
Eine einzelne NVIDIA H100 80GB, kein Offloading, Standard-Attention-Backend.
Ein Referenzbild verdoppelt die Zeit ungefähr. Referenz-Tokens treten derselben Sequenz bei wie der Text und das generierte Bild, sodass eine 1024 × 1024 Referenz 4,096 Tokens zu jedem Transformer-Aufruf hinzufügt
 |
|---|
| Gestapelte Balken der Tokens pro Transformer-Aufruf: text-to-image 4,256 Tokens; image-to-image 8,272; layout text-to-image 4,336; layout image-to-image 8,800 |
Die Architektur
Lassen Sie uns das Modell Stück für Stück öffnen. Das Modell nimmt drei Arten von Tokens auf:
- Text
- das verrauschte Bild das generiert wird
- und optionale Referenzbilder
Von Pixeln zu Tokens
FLUX.3 ist ein Latenzraum-Flow-Modell zur Bildgenerierung. Das bedeutet, dass der Denoiser Latenzen als Eingaben nimmt und Latenzen als Ausgaben erzeugt. Wir verwenden einen VAE, um die Latenzen zurück in Pixel zu dekodieren. FLUX.3 verwendet dieselbe VAE-Architektur wie Flux.2.
Der FLUX.2 VAE komprimiert ein Bild in jede Richtung um das 8-fache auf 32 Kanäle, und dann wird jedes 2 × 2 Patch dieser Latenz in ein einzelnes Token mit 128 Kanälen gepackt.
Also deckt ein Token ein 16 × 16 Pixel großes Patch ab, und ein 1024 × 1024 Bild wird ein 64 × 64 Raster aus 4,096 Tokens. Das verrauschte Bild beginnt als zufälliges Rauschen in genau dieser Form. Ein Referenzbild durchläuft denselben VAE-Encoder und denselben Packvorgang und behält seine eigene Größe.
Vom Prompt zu Tokens
Der Text-Encoder ist Qwen3-VL, ein Vision-Language-Modell. FLUX.3 nimmt nicht nur dessen letzte Schicht. Es liest die Hidden States von acht seiner 36 Schichten (Schichten 4, 8, …, 32) und stapelt sie, sodass jedes Text-Token zu einem 8 × 2560 = 20,480-dimensionalen Vektor wird, bevor eine lineare Schicht es auf die Breite des Transformers von 3072 projiziert.
Dies gibt dem Transformer Merkmale aus mehreren Tiefen des Sprachmodells, nicht nur aus dessen letzter Schicht. Der Prompt wird auf ein Vielfaches von 80 Tokens aufgefüllt, und der Transformer beachtet auch das Padding, weshalb die Pipeline einen Prompt pro Aufruf verarbeitet.
Zwei Stufen
Der Transformer verarbeitet die Tokens in zwei Stufen:
- Stufe 1: Per-Mode-Blöcke. Jeder Stream durchläuft 5 Blöcke mit eigenen Gewichtungen. Text hat seine eigenen Blöcke, das verrauschte Bild hat seine eigenen, und die Referenzbilder haben ihre eigenen.
- Stufe 2: gemeinsame Blöcke. Die Streams werden zu einer Sequenz zusammengefügt,
[text | image | reference], die 28 Blöcke durchläuft, die sich einen einzigen Satz von Gewichtungen teilen.
Die beiden Stufen unterscheiden sich darin, wer auf wen achten darf.
In Stufe 1 achtet jeder Stream nur auf sich selbst, sodass jede Art von Token zuerst auf ihre eigene Weise verfeinert wird. In Stufe 2 achtet alles auf alles, wobei das Bild vom Text und von den Referenzen lernt. Zum Vergleich: Die Double-Stream-Blöcke von FLUX.2 geben Text und Bild ebenfalls separate Gewichtungen, lassen sie aber von Anfang an aufeinander achten. FLUX.3 hält die Streams zuerst vollständig getrennt und führt sie dann zusammen.
Am Ende werden die Text- und Referenz-Tokens einfach verworfen. Nur die Bild-Tokens durchlaufen die Ausgangsschichten, die vorhersagen, wie man sie einen Schritt in Richtung eines sauberen Bildes bewegt.
Innerhalb eines Blocks
Jeder Block hat, in beiden Stufen, dieselbe Form. Attention und der MLP laufen parallel auf derselben normalisierten Eingabe, und ihre Summe wird zum Residual-Stream zurückaddiert.
Jeder Block beginnt mit einem LayerNorm, der keine eigene gelernte Skalierung oder Verschiebung besitzt. Skalierung, Verschiebung und Gate stammen stattdessen aus einer Zeitschritt-Einbettung (dies wird genannt Modulation). Innerhalb der Attention werden die Queries und Keys RMS-normalisiert und erhalten rotary position embeddings (RoPE), die wir unten betrachten.
In einem gemeinsamen Block teilen sich alle Token dieselben Gewichte, aber Text-, Bild- und Referenztoken erhalten jeweils ihre eigene Skalierung, Verschiebung und Gate.
def block(x, shift, scale, gate):      # shift, scale, gate come from the token's timestep embedding
    h = layer_norm(x)                  # no learned scale or shift
    h = (1 + scale) * h + shift
    q, k, v = to_q(h), to_k(h), to_v(h)
    q, k = rope(rms_norm(q)), rope(rms_norm(k))
    out = attention(q, k, v) + mlp(h)  # parallel, MLP is SwiGLU
    return x + gate * out
Jeder Token erhält seinen eigenen Zeitschritt
In FLUX.1 und FLUX.2 moduliert eine einzige Zeitschritt-Einbettung jeden Token. In FLUX.3 hängt die Modulation von der Art des Tokens ab.
Die verrauschten Bildtoken werden durch den aktuellen Zeitschritt moduliert t. Die Text- und Referenztoken werden immer durch den Zeitschritt 0moduliert, was bedeutet: „sauber, hier gibt es nichts zu denoisieren“. Selbst eine Referenz, die dem Ergebnis fast identisch erscheint, wird daher als gegebener Kontext markiert und nicht als etwas zu Generierendes.
Der destillierte Checkpoint ist eine flow map. Ihm wird außerdem der Zeitschritt mitgeteilt, zu dem jeder Schritt springt. Dieser zweite Zeitschritt erhält seine eigene Einbettung, die zur Modulation jedes Tokens addiert wird, sodass jeder seiner 16 Schritte einen größeren Sprung machen kann.
Positionen in vier Dimensionen
Attention allein weiß nicht, wo sich ein Token befindet (dieses Phänomen wird Permutationsäquivarianz genannt). RoPE behebt das, indem es jede Query und jeden Key um einen Betrag rotiert, der von der Position des Tokens abhängt. FLUX.3 verwendet vier Positionsachsen, (t, h, w, l) (Zeitschritt, Höhe, Breite, Länge der Sequenz), und gibt jeder ein Viertel (32 Dimensionen) jedes 128-dimensionalen Attention-Kopfs:
| Token | t: Zeitschritt | h: Höhe | w: Breite | l: Länge der Sequenz |
|---|---|---|---|---|
| Texttoken i | 0 | 0 | 0 | i |
| Bildtoken bei (row, col) | 0 | row / 2 | col / 2 | 0 |
| Referenz k bei (row, col) | 0 | row / 2 | col / 2 | −(k + 1) |
Texttoken ordnen sich entlang lan, wie Wörter in einem Satz. Das Bild und die Referenzen sind 2D-Gitter in (h, w), voneinander getrennt entlang l. Da eine Referenz dieselben (h, w) Koordinaten wie die Ausgabe verwendet, hat „dieselbe Stelle in der Referenz“ eine präzise Bedeutung für das Modell, und genau darauf src_bbox / tgt_bbox beruht die Bearbeitung.
Die Denoising-Schleife
FLUX.3 ist ein Flow-Matching-Modell. Die Generierung beginnt bei reinem Rauschen, und bei jedem der 50 Schritte sagt der Transformer eine Geschwindigkeitvoraus. Dies ist die Richtung vom Rauschen zu einem sauberen Bild. Der Scheduler macht einen Schritt entlang dieser Richtung.
Bei jedem Schritt kann man auch die aktuelle Schätzung des Modells für das endgültige Bild ablesen. Das Dekodieren dieser Schätzung bei einigen Schritten zeigt, wie das Bild Gestalt annimmt:
 |
 |
||||
|---|---|---|---|---|---|
| Schritt 1 | Schritt 5 | Schritt 10 | Schritt 15 | Schritt 25 | Schritt 50 |
Der Fuchs, seine Pose und das Licht stehen bereits bei Schritt 10 fest, während der Rauschpegel noch bei 0.97 liegt. Die schneebedeckten Äste und die Textur des Fells erscheinen erst in den letzten Schritten. Der Scheduler von FLUX.3 verwendet eine große Zeitverschiebung (6.93), die den Rauschpegel für den Großteil des Ablaufs hoch hält: 44 der 50 Schritte finden oberhalb von σ = 0.5 statt. Wir haben diese Abbildung erstellt, indem wir einen kleinen Block zur Pipeline hinzugefügt haben, was uns zu Modular Diffusers führt.
Wenn du neu bei Flow Matching bist, haben wir ein Anfänger freundliches Tutorial und ein Video für dich, um zu verstehen, wie es funktioniert.
Modular Diffusers
FLUX.3 wird als eine Modular Diffusers Pipeline ausgeliefert.
Siehe die Workflows
Du kannst die Workflows auflisten und die genauen Blöcke jedes einzelnen ausgeben, ohne irgendwelche Gewichte zu laden.
from diffusers import Flux3AutoBlocks

blocks = Flux3AutoBlocks()
print(blocks.available_workflows)
# ['text2image', 'image_conditioned']

print(list(blocks.get_workflow("text2image").sub_blocks))
# ['text_encoder', 'denoise.input', 'denoise.prepare_latents', 'denoise.set_timesteps',
#  'denoise.prepare_rope_inputs', 'denoise.denoise', 'denoise.after_denoise', 'decode']
get_workflow() löst die auto-Branches auf und liefert dir die schlichte Abfolge der Schritte, die ausgeführt werden. print(blocks.get_workflow("image_conditioned").doc) gibt die Komponenten, Eingaben, Standardwerte und Ausgaben dieses Workflows aus.
Einmal kodieren, vieles generieren
Nimm den Text-Encoder heraus, kodiere den Prompt einmal, gib ihn frei und generiere aus den zwischengespeicherten Embeddings.
import torch
from diffusers import ModularPipeline

model_id = "black-forest-labs/flux-3-image-klein-base"

blocks = ModularPipeline.from_pretrained(model_id).blocks
text_blocks = blocks.sub_blocks.pop("text_encoder")  # `blocks` now starts at the VAE encoder

text_pipe = text_blocks.init_pipeline(model_id)
text_pipe.load_components(dtype=torch.bfloat16)
text_pipe.to("cuda")

state = text_pipe(prompt=prompt, negative_prompt="")  # no guider here, so ask for the negative embeddings

prompt_embeds = state.get("prompt_embeds")
negative_prompt_embeds = state.get("negative_prompt_embeds")

del text_pipe
torch.cuda.empty_cache()

image_pipe = blocks.init_pipeline(model_id)  # no text encoder to load
image_pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
image_pipe.to("cuda")

for seed in range(3):
    image = image_pipe(
        prompt_embeds=prompt_embeds,
        negative_prompt_embeds=negative_prompt_embeds,
        generator=torch.Generator().manual_seed(seed),
        output="images",
    )[0]
    image.save(f"{seed}.png")
Füge einen Schritt innerhalb der Schleife hinzu
Die obige Denoising-Abbildung stammt von einem zusätzlichen Block, der bei jedem Schritt die Schätzung des Modells vom sauberen Bild aufzeichnet:
from diffusers.modular_pipelines import Flux3AutoBlocks, InputParam, ModularPipelineBlocks, OutputParam


class Flux3PreviewStep(ModularPipelineBlocks):
    model_name = "flux3"

    @property
    def inputs(self):
        return [InputParam("latents"), InputParam("noise_pred")]

    @property
    def intermediate_outputs(self):
        return [OutputParam("x0_previews", type_hint=list)]

    @torch.no_grad()
    def __call__(self, components, block_state, i, t):
        if i == 0:
            block_state.x0_previews = []
        sigma = t / 1000  # timesteps are sigmas scaled to [0, 1000]
        block_state.x0_previews.append(block_state.latents - sigma * block_state.noise_pred)  # x0 = x_t - sigma * v
        return components, block_state


blocks = Flux3AutoBlocks()
denoise_loop = blocks.sub_blocks["denoise"].sub_blocks["text2image"].sub_blocks["denoise"]
denoise_loop.sub_blocks.insert("preview", Flux3PreviewStep(), 1)  # between "denoiser" and "after_denoiser"

pipe = blocks.init_pipeline(model_id)
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
pipe.to("cuda")

out = pipe(prompt=prompt, generator=torch.Generator().manual_seed(0), output=["x0_previews", "images"])
Probier es aus
- Modelle: FLUX.3 Image Klein collection
- Dokumentation: FLUX.3 in Diffusers
- Fine-Tuning: DreamBooth LoRA scripts
- Prompting: Black Forest Labs prompting guide
Etwas mit FLUX.3 gebaut? Teile deine LoRAs und Pipelines auf dem Hub. Wir würden sie gern sehen! 😎