NVIDIA veröffentlicht Nemotron 3.5 Super und Nemotron 3.5 Bolt
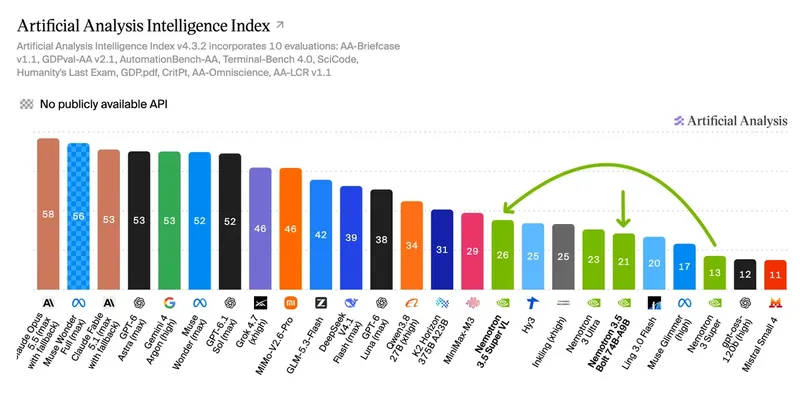
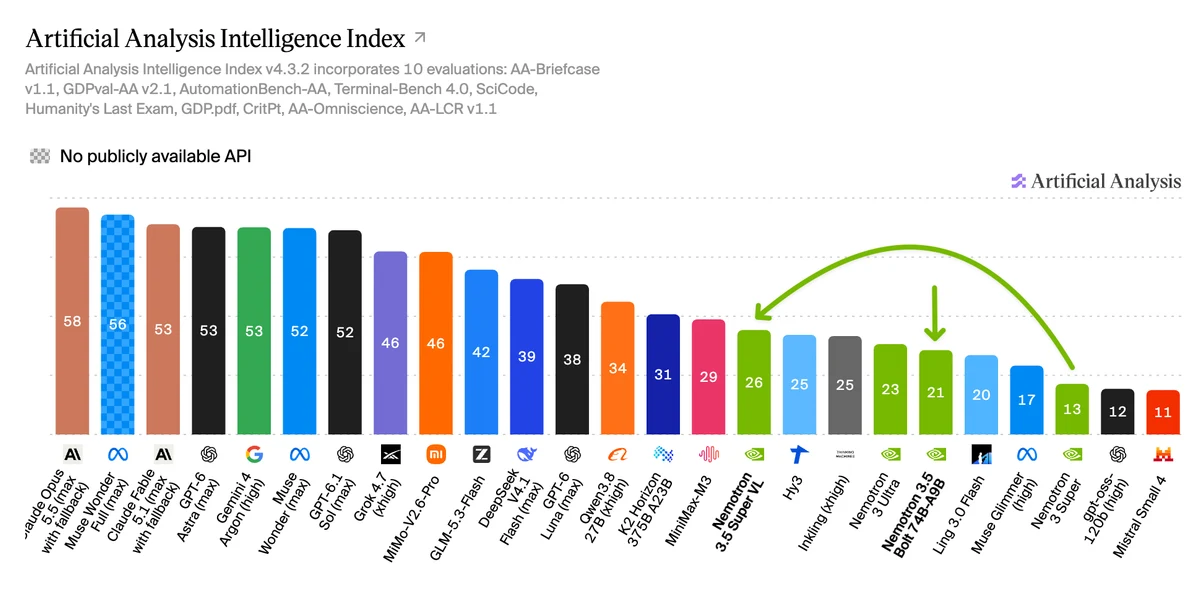
Modellseite ansehenNvidias Nemotron 3.5 Super VL ist nun das führende US-Open-Weight-Modell mit einem Wert von 26 im Artificial Analysis Intelligence Index
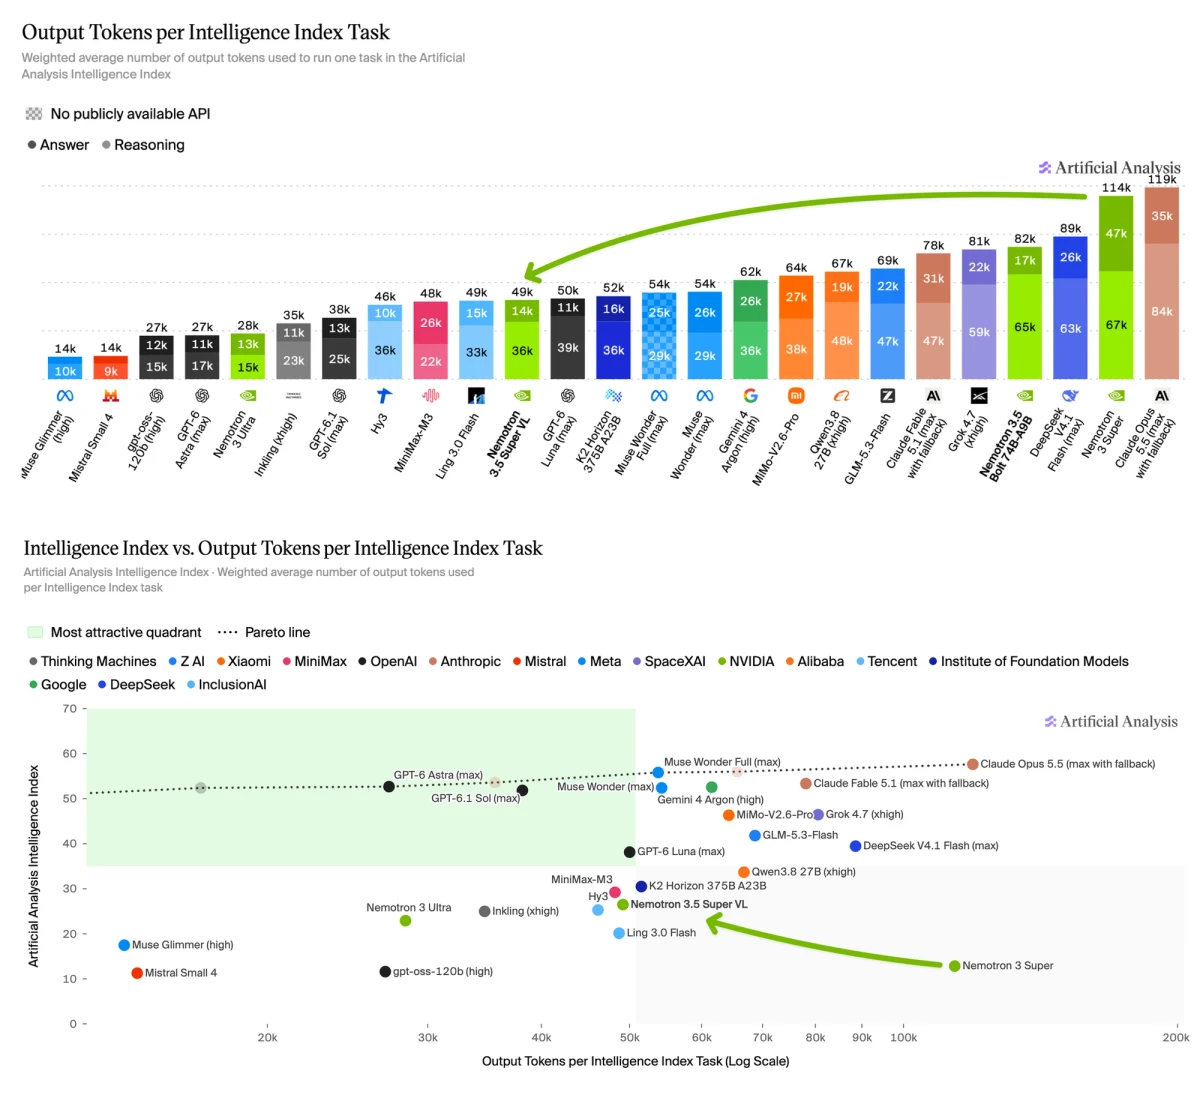
Nemotron 3.5 Super VL erreicht die doppelte Intelligenz seines Vorgängers Nemotron 3 Super (13) und verbraucht dabei ~60% weniger Output-Tokens pro Aufgabe
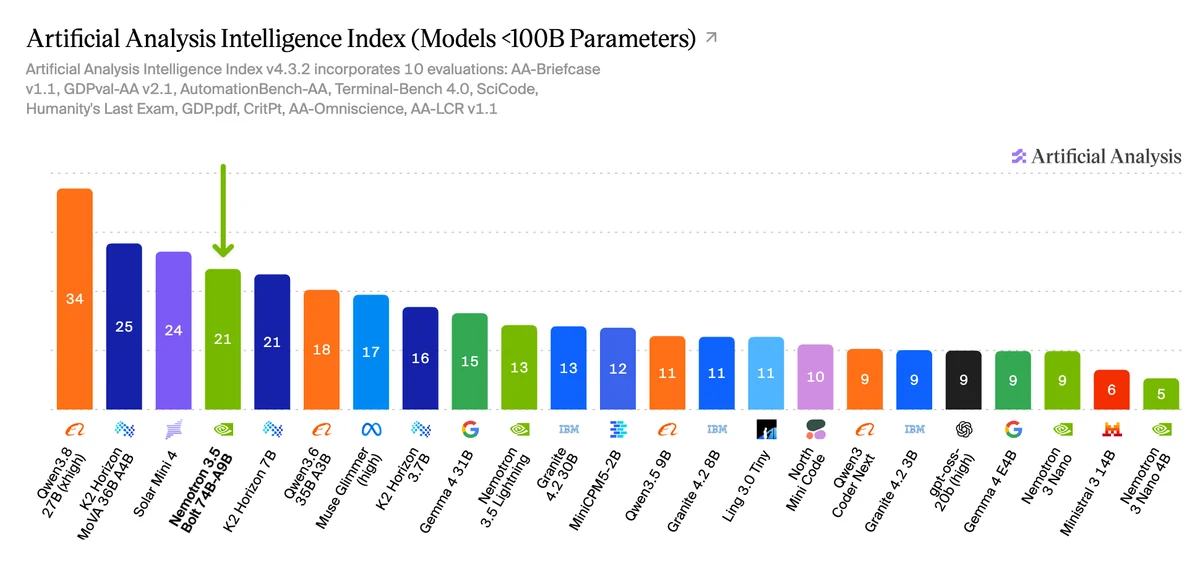
Es erscheint zusammen mit Nemotron 3.5 Bolt 74B-A9B, dem ersten Modell der neuen Bolt-Familie, das 21 Punkte im Intelligence Index erreicht
Wichtigste Erkenntnisse:
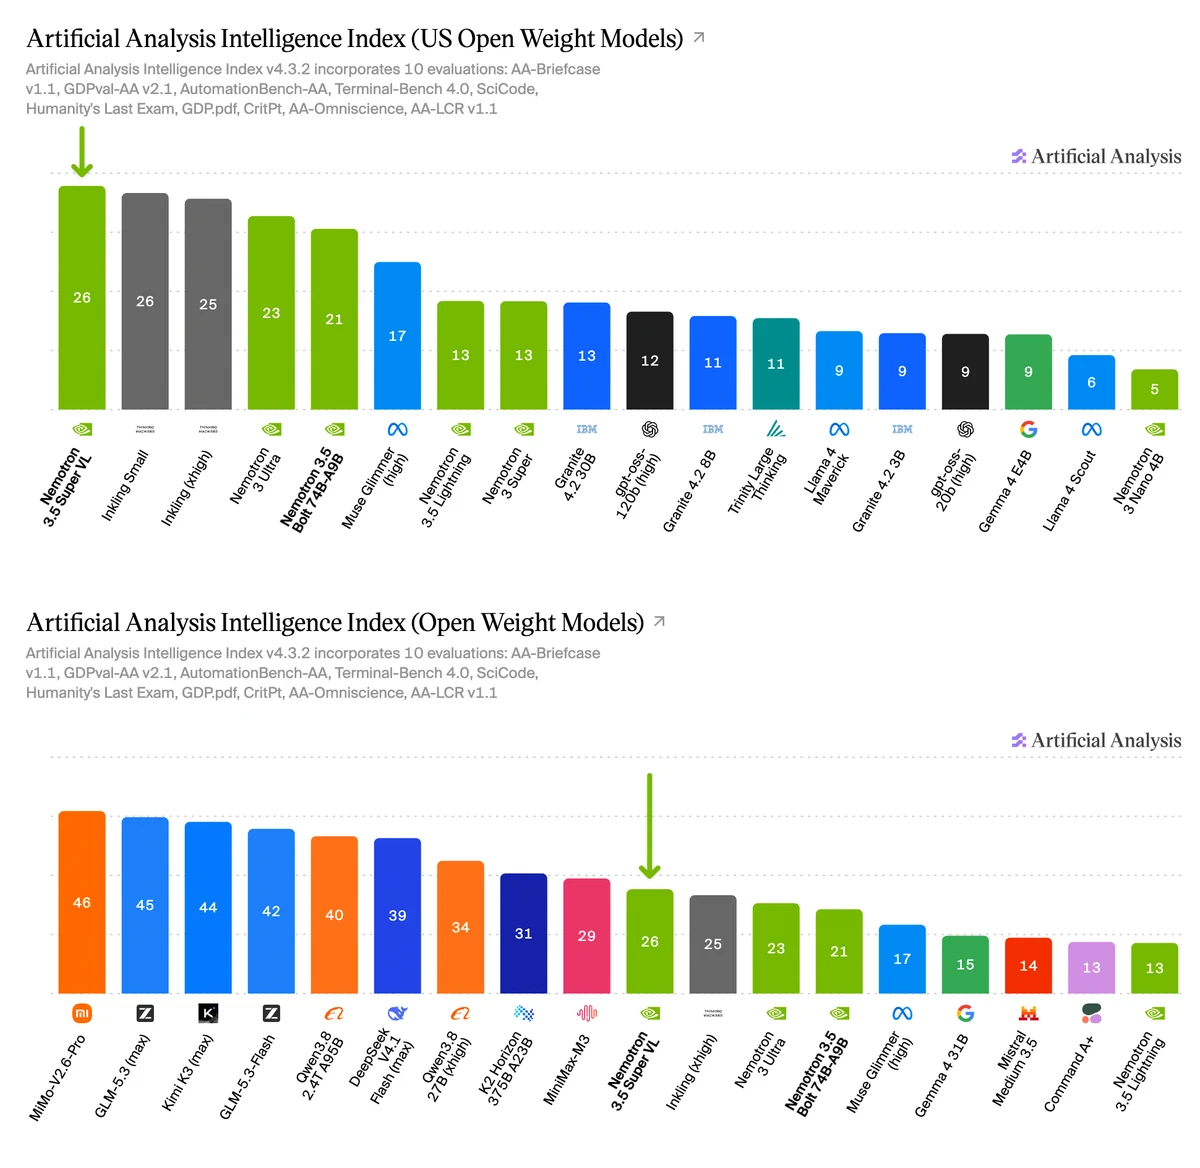
➤ Führendes US-Open-Weight-Modell: Nemotron 3.5 Super VL erzielt 26.5 und verdrängt damit Thinking Machines' Inkling Small (25.7) sowie NVIDIAs Nemotron 3 Ultra (23) und Metas Muse Glimmer (17)
➤ Bolt liegt nur 2 Punkte hinter Ultra: Nemotron 3.5 Bolt 74B-A9B erreicht 21, 1.5 Punkte hinter Nemotron 3 Ultra 550B A55B (23). Es hat etwa ein Siebtel von Ultras Gesamtparametern (74B vs 550B) und ein Sechstel seiner aktiven Parameter (9B vs 55B)
➤ Super 3.5 nahezu verlustfrei in NVFP4: Nemotron 3.5 Super VL erscheint in NVFP4 und liegt im Intelligence Index innerhalb von 0.1 Punkten seiner BF16-Gewichte, wobei keine Komponente sich um mehr als 2.6 Punkte bewegt
Details zu Nemotron 3.5 Super VL
- Kontextfenster: 1M Tokens
- Modalitäten: Vision- und Texteingabe; Textausgabe
- Parameter: 120B / 12B
Details zu Nemotron 3.5 Bolt 74B-A9B
- Kontextfenster: 256k Tokens
- Modalitäten: Vision- und Texteingabe; Textausgabe
- Parameter: 74B / 9B
Nemotron 3.5 Super – US-Open-Weight-Spitzenreiter
Nemotron 3.5 Super VL ist das am höchsten bewertete Open-Weights-Modell aus den USA mit 26 Punkten im Intelligence Index. Es verdrängt Thinking Machines' Inkling Small (26) und übertrifft NVIDIAs bisheriges Flaggschiff Nemotron 3 Ultra (23) sowie Metas Muse Glimmer (17)
Trotz dieses Fortschritts liegen die USA bei Open-Weights-Intelligenz noch hinter den Vereinigten Arabischen Emiraten (K2 Horizon 375B A23B, 31) und China (MiMo-V2.6-Pro, 46) zurück.
Nemotron 3.5 Super – Token-Nutzung
Nemotron 3.5 Super VL verwendet 46k Ausgabe-Tokens pro Intelligence-Index-Aufgabe, ~60% weniger als sein Vorgänger Nemotron 3 Super (114k) und weniger als K2 Horizon 375B A23B (52k) und MiMo-V2.6-Pro (64k)
Trotz einer deutlichen Steigerung der Token-Effizienz liegt Nemotron 3.5 Super bei der Intelligence Index vs. Output Tokens per Task-Frontline noch spürbar zurück
Nemotron 3.5 Super - Ausgabegeschwindigkeit
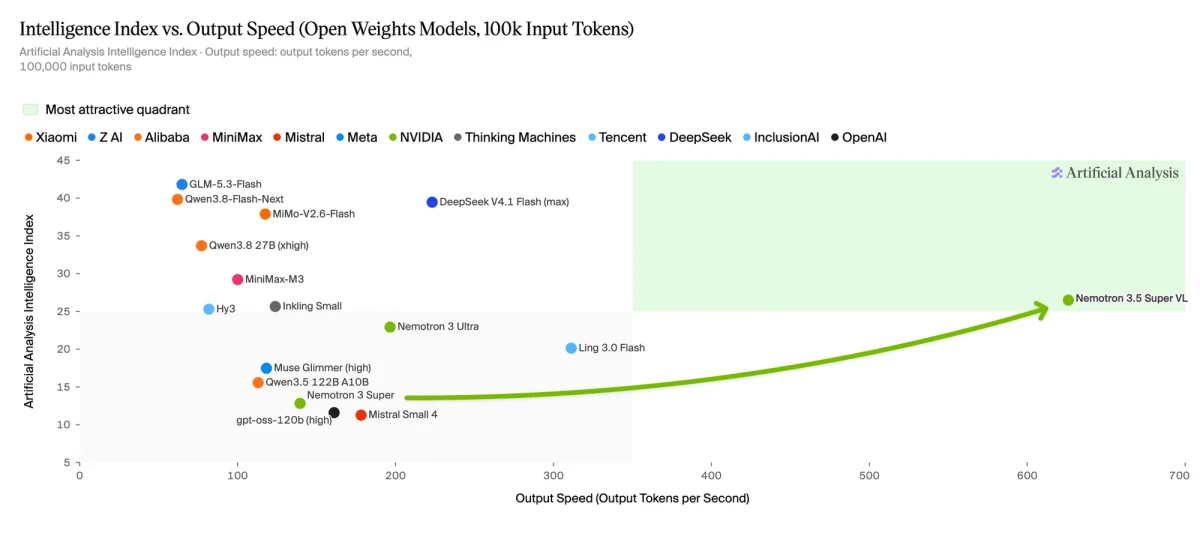
Gemessen an einem Pre-Release-Endpunkt von @DeepInfra mit NVFP4-Gewichten erreicht Nemotron 3.5 Super VL eine Ausgabegeschwindigkeit von ~630 Tokens/s mit 100k-Token-Prompts. Das ist das schnellste Modell mit einem Intelligence-Index-Wert von 20 oder mehr, das wir bei dieser Prompt-Länge gemessen haben
Das ist ~5x Inkling Small (124 Tokens/s), ~2.7x Nemotron 3 Ultra (235) und ~4.5x Nemotron 3 Super (140). Zudem liefert es sein erstes Token in 1.8s, gegenüber 4.4s bei Nemotron 3 Ultra und 8.5s bei Inkling Small
Nemotron 3.5 Bolt
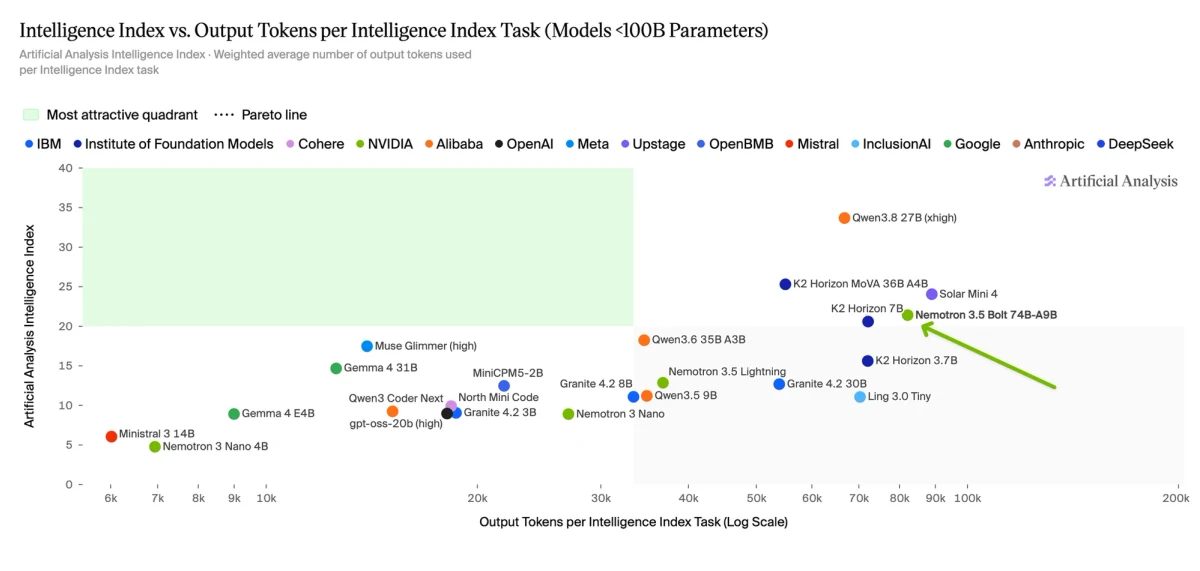
Nemotron 3.5 Bolt 74B-A9B ist das erste Modell in NVIDIAs neuer Bolt-Familie. Es erreicht 21.4 auf dem Intelligence Index und belegt damit den 4. Platz unter Modellen mit weniger als 100B Parametern sowie den ersten Platz unter US-Modellen in dieser Klasse
Bolt liegt 8.6 Punkte über Nemotron 3 Super (12.8) bei 39% weniger Gesamtparametern. Gegenüber Nemotron 3 Ultra führt es bei AutomationBench-AA (15.5% vs 3.0%) und AA-Briefcase (912 vs 874 Elo), liegt aber bei AA-LCR (70% vs 79%) und Humanity's Last Exam (25% vs 28%) zurück
Nemotron 3.5 Bolt - Token-Verbrauch
Nemotron 3.5 Bolt 74B-A9B verwendet 82k Ausgabe-Tokens pro Intelligence-Index-Aufgabe, das 1,8-fache von Nemotron 3.5 Super VL (46k) und das 2,9-fache von Nemotron 3 Ultra (28k), jedoch immer noch 28% weniger als Nemotron 3 Super (114k).