IT之家 Meldung vom 15. Oktober: NVIDIA kündigte das offene multimodale Modell Nemotron 3.5 Super VL an, das sich an KI-Agenten richtet, die dauerhaft laufen und mehrstufige Aufgaben ausführen müssen.
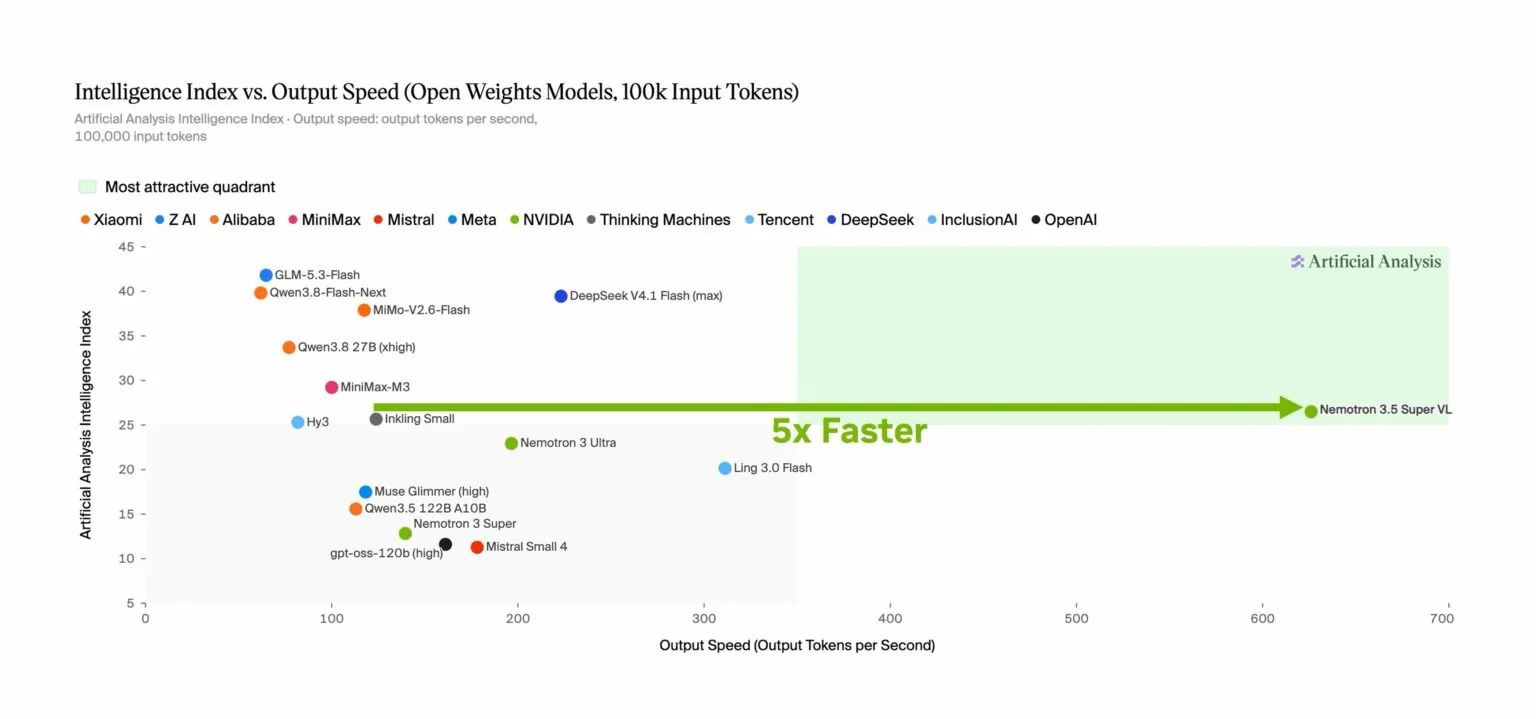
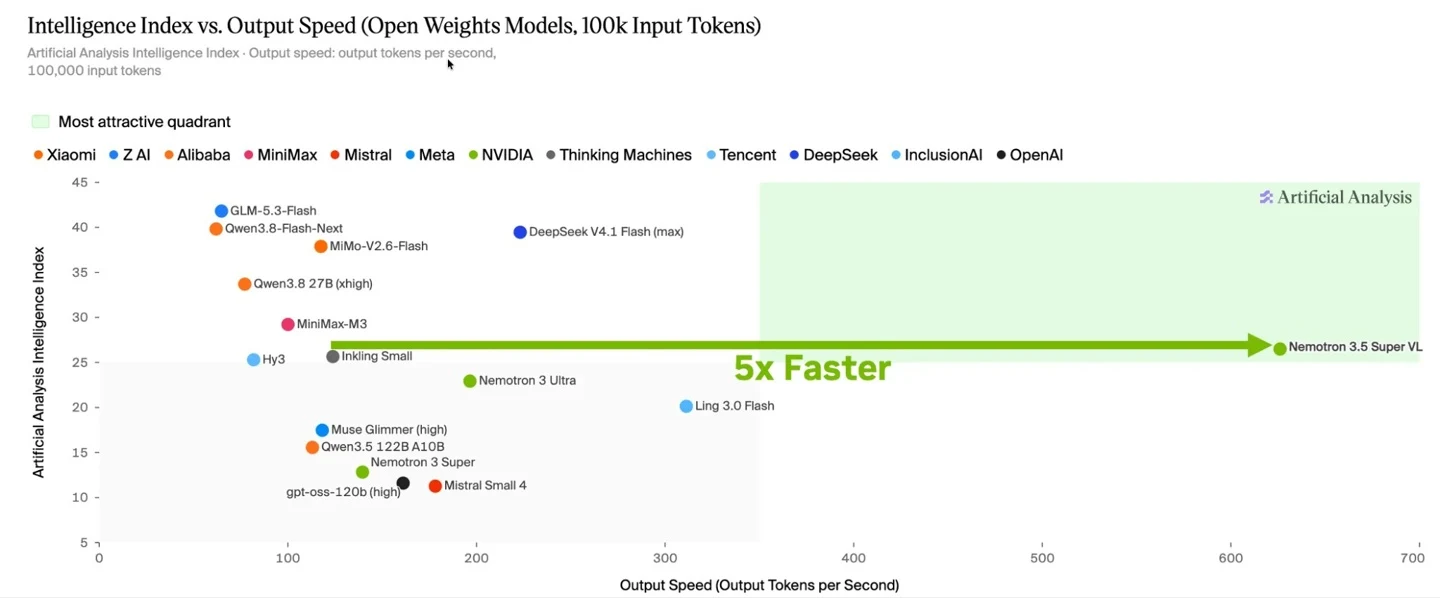
Das Modell verwendet eine Mixture-of-Experts-Architektur (MoE) mit insgesamt 120 Milliarden Parametern, davon 12 Milliarden aktive Parameter. Laut Nvidia erreicht der Durchsatz des Modells bei der Ausführung von Agenten-Aufgaben auf einer einzelnen GPU bis zu das 5-fache anderer offener Modelle ähnlicher Größe.
Nemotron 3.5 Super VL vereint laut Angaben Schlussfolgerung, Instruktionsbefolgung und Tool-Aufruf-Fähigkeiten mit der Fähigkeit zum Verständnis von Text, Bildern, Dokumenten und Video in einem einzigen Modell und kann für Szenarien wie Code-Tests und Debugging, websiteübergreifende Informationssuche, Dokumentenanalyse, Erkennung von Cybersicherheitsbedrohungen sowie das Durchsuchen von Videoinhalten eingesetzt werden. Entwickler können mit der NVIDIA-NeMo-Toolkette ein Post-Training mit eigenen Daten, Tools, Richtlinien und Arbeitsabläufen durchführen und das Modellverhalten an geschäftliche Anforderungen anpassen.
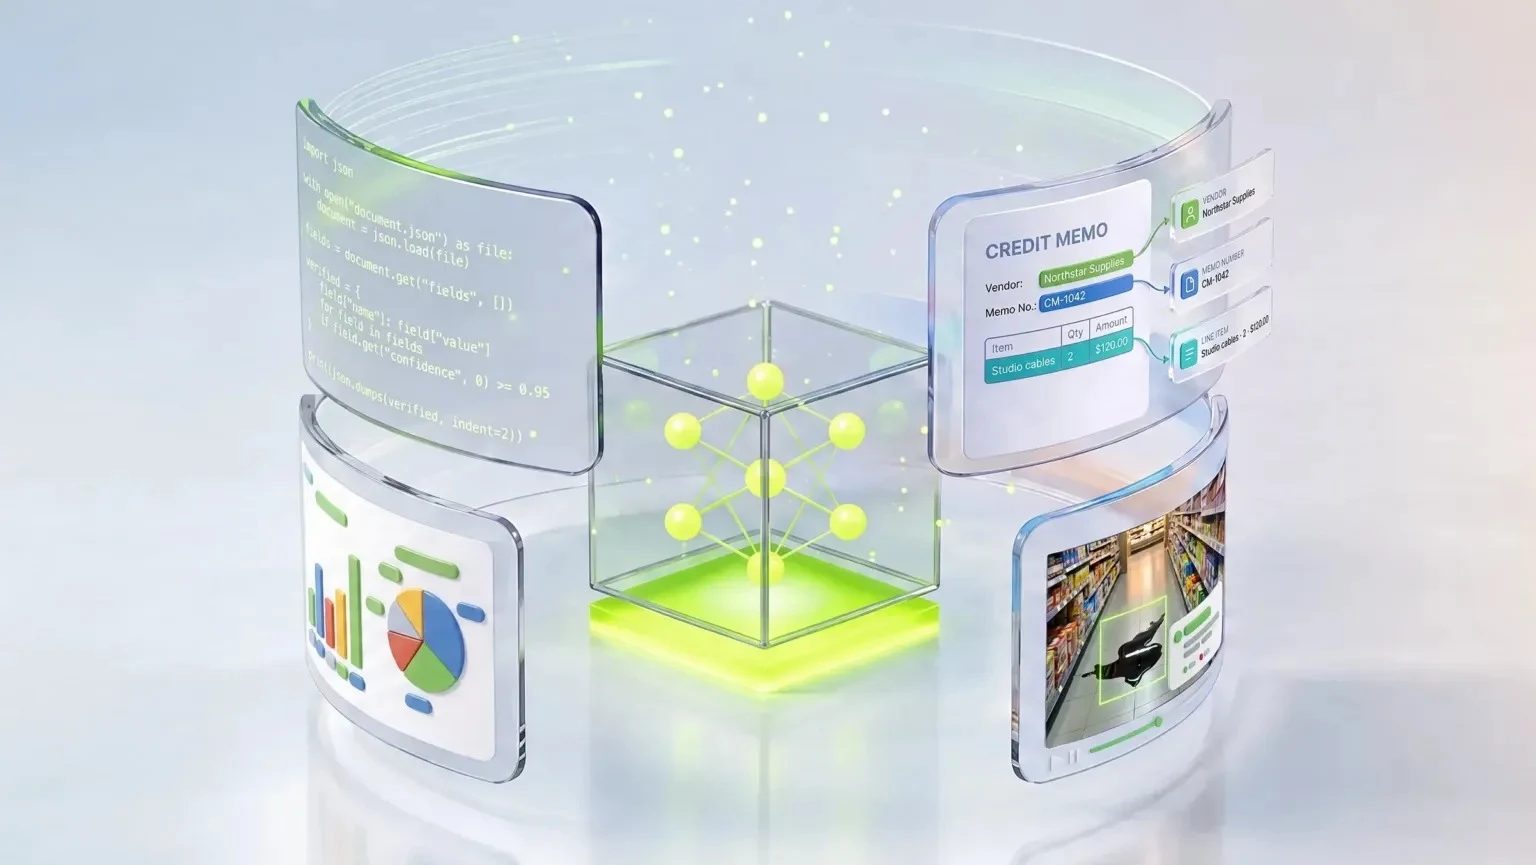
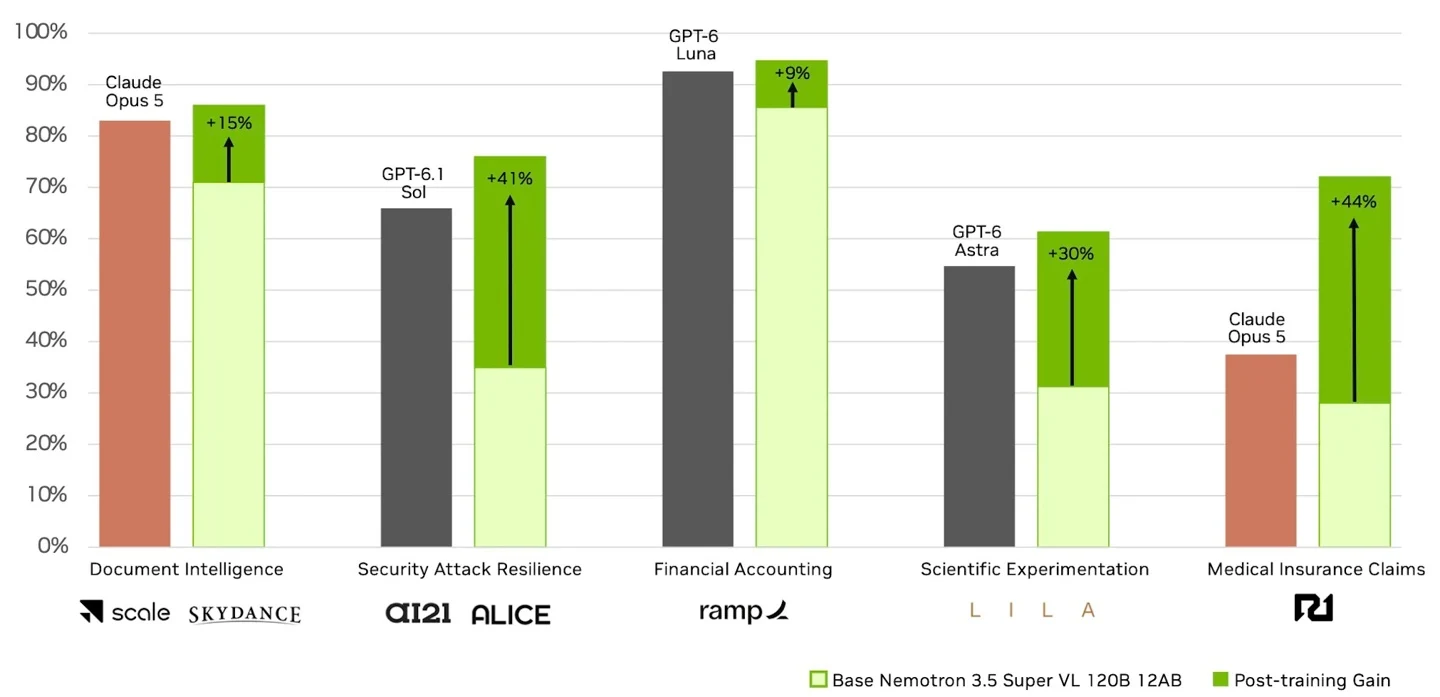
NVIDIA legte zugleich mehrere Fälle kundenspezifischer Anpassungen für Unternehmen offen. So hat der KI-DatenTechnikanbieter Scale AI für das Medien- und Unterhaltungsunternehmen Skydance Corporation einen Agenten zur Verarbeitung von Lieferantenkrediten angepasst; die Inferenzkosten der zugehörigen Workloads sollen voraussichtlich um 97.5 % sinken und die Latenz um 80 %.
Die Finanzoperationsplattform Ramp wandelt Belegbilder in strukturierte JSON-Daten mit Händler-, Datums- und Zahlungsinformationen um; der Durchsatz soll voraussichtlich um bis zu 50 % steigen und die Latenz um 90 % sinken. AI21 hat gemeinsam mit dem KI-Sicherheitsunternehmen Alice ein Modell für Threat Intelligence und Schwachstellenanalyse angepasst; die Genauigkeit der zugehörigen Aufgaben stieg um 40 %.
Bei den Modellbewertungen gibt NVIDIA an, dass Nemotron 3.5 Super VL im CharXiv-Benchmark für Diagramm-Reasoning 80.8 % erreichte und damit über den 63 % von Nemotron 3 Nano Omni liegt; in Kombination mit einer Python-Code-Interpretation erreicht das Modell 84 %.
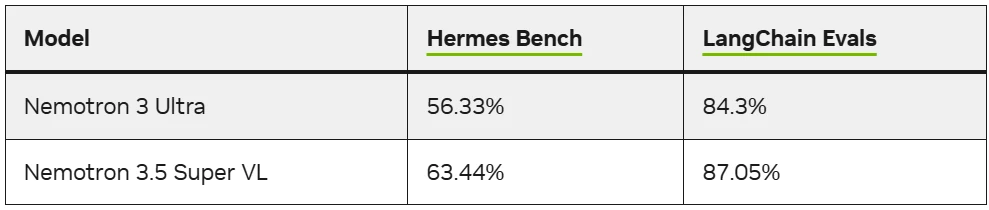
In den Verhaltensbewertungen Hermes Bench und LangChain erzielte das Modell 63.44 % bzw. 87.05 % und lag damit über den 56.33 % und 84.3 % von Nemotron 3 Ultra. NVIDIA erklärt außerdem, das Modell gehöre auf der OCRBench v2-Rangliste zu den leistungsstärksten offenen Modellen.
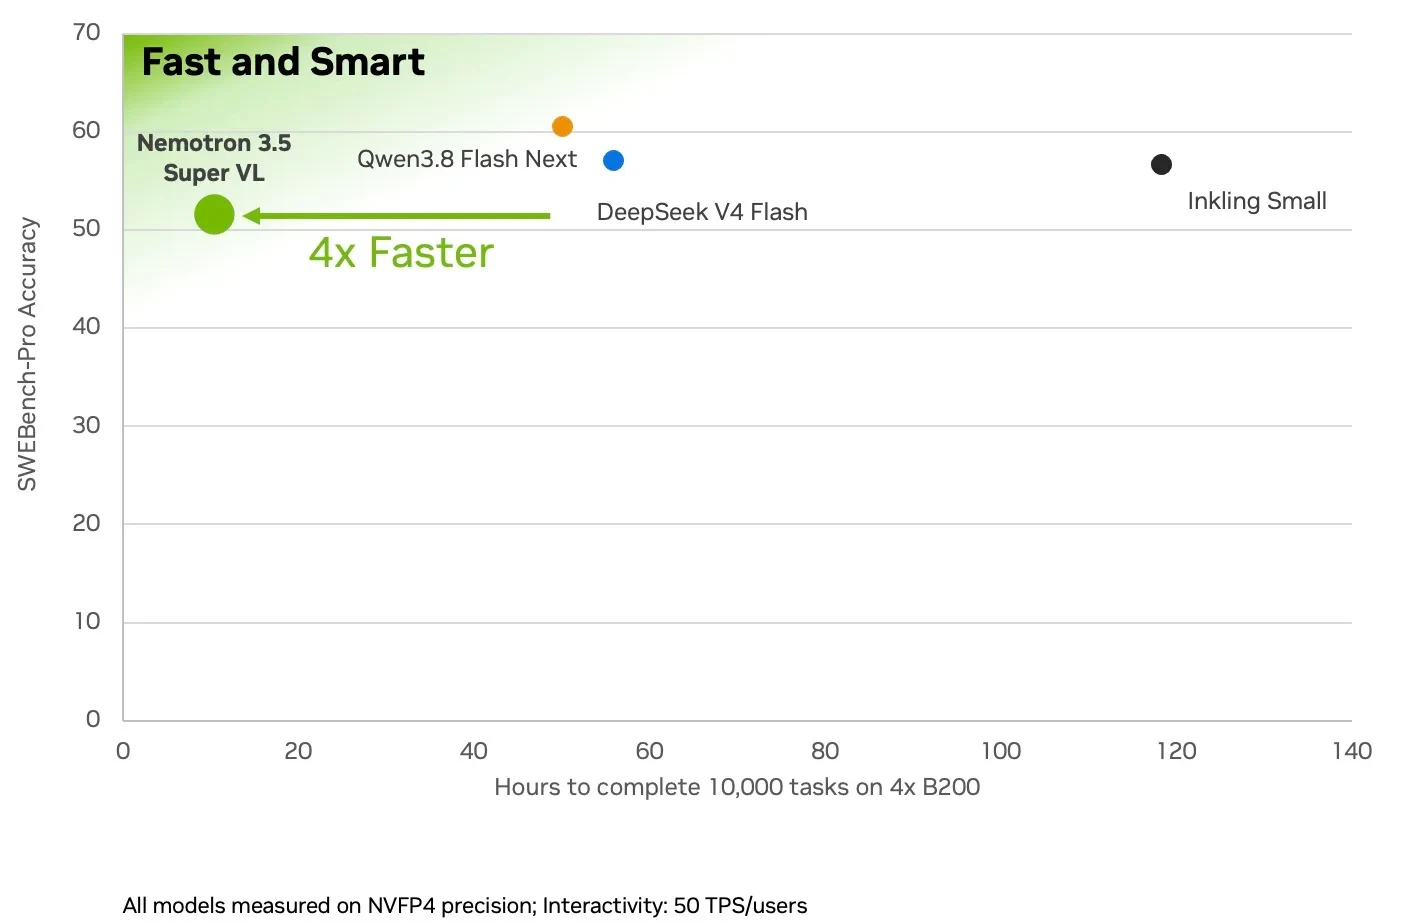
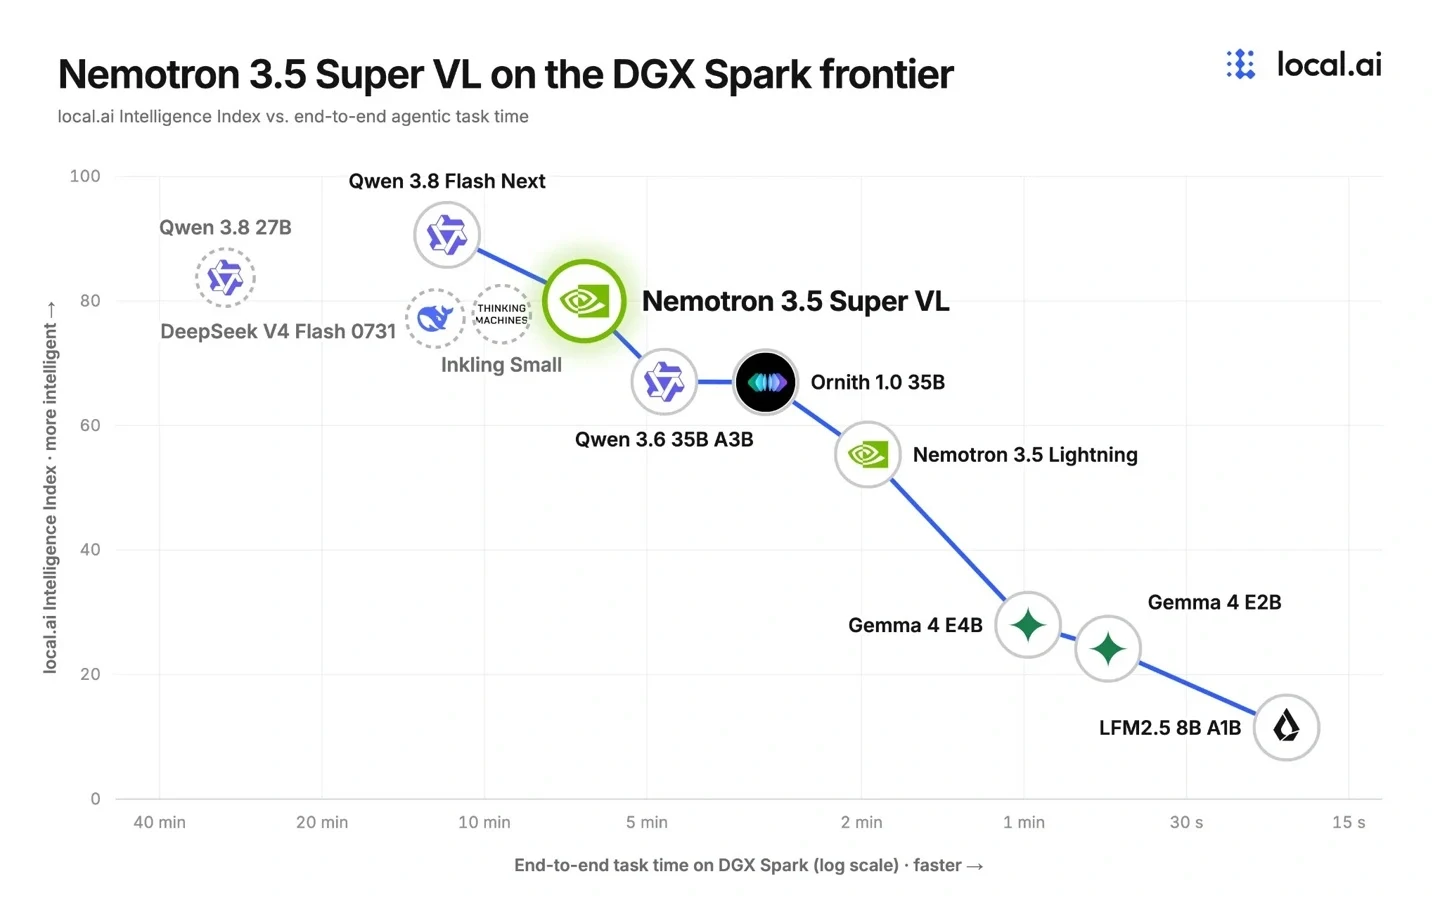
Um den Inferenzaufwand zu senken, setzt Nemotron 3.5 Super VL Techniken wie Speculative Decoding, gemischte Präzision und Kontextwiederverwendung ein. Nach Angaben von NVIDIA kann die LiLiCorr-Speculative-Decoding-Methode die Token-Generierungsgeschwindigkeit auf dem DGX Spark auf bis zu das 2.3-Fache steigern. Das Modell unterstützt zudem NVFP4-Quantisierung und verwendet auf der NVIDIA-Blackwell-Architektur 4-Bit-Gewichte und 4-Bit-Aktivierungen; auf Nicht-Blackwell-Plattformen verwendet derselbe Checkpoint 4-Bit-Gewichte und 16-Bit-Aktivierungen.
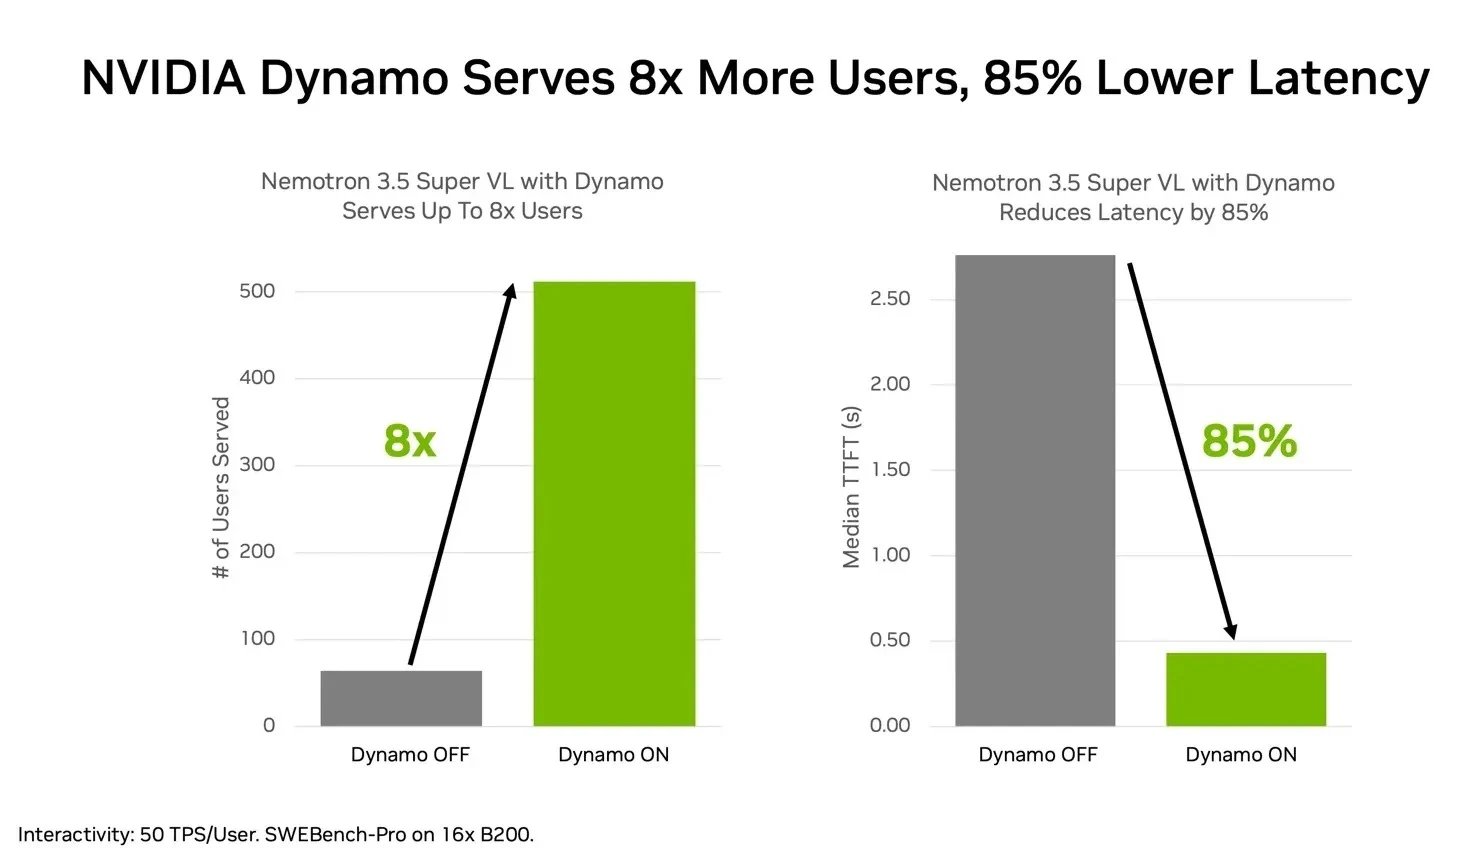
NVIDIA stellte außerdem Deployment-Optimierungen für verteilte Inferenz vor. Nach den veröffentlichten Daten kann NVIDIA Dynamo unter Testbedingungen mit 16 NVIDIA-B200-GPUs und 50 Token pro Sekunde pro Nutzer in Kombination mit cache-bewusstem Routing, Sitzungsaffinität und KV-Cache-Offloading bis zu 8-mal so viele Nutzer bedienen und die Latenz bis zum ersten Token um 85 % senken.
Die Veröffentlichung umfasst zudem Gewichte für Basismodelle, nachtrainierte Modelle und NVFP4-quantisierte Modelle sowie Trainingsrezepte, Datensätze und Reinforcement-Learning-Umgebungen.
NVIDIA erklärte, Nemotron 3.5 Super VL habe im Pretraining und kontinuierlichen Pretraining insgesamt etwa 26 Billionen Token verwendet, im Post-Training etwa 3.8 Millionen Samples, und das Reinforcement Learning sei in Dutzenden Umgebungen durchgeführt worden. Die neu offengelegten Datensätze decken Bereiche wie Agenten-Tool-Aufrufe, Finanz-Reasoning, Instruktionsbefolgung, lange Kontexte, Fairness und visuell-sprachliches Verständnis ab.
Neben Super VL hat NVIDIA auch zwei Endgeräte-Modelle Nemotron 3.5 Bolt vorgestellt. Nemotron 3.5 Bolt 74B-A9B 24GB nutzt eine MoE-Architektur mit insgesamt 74 Milliarden Parametern und 9 Milliarden aktivierten Parametern und wurde durch native 2-Bit-Quantisierung auf 24 GB komprimiert; es richtet sich an lokale Agenten-Aufgaben und unterstützt llama.cpp, vLLM, Ollama, Unsloth und LM Studio. Nemotron 3.5 Bolt E4B 4GB ist für Szenarien wie lokale Sprachassistenten, interaktive Charaktere und eingebettete Oberflächen gedacht und soll am 23. Oktober erscheinen.
IT之家 hat bemerkt, dass Nemotron 3.5 Super VL und Bolt 74B-A9B 24GB bereits offen zugänglich sind und Entwickler über Kanäle wie Hugging Face, OpenRouter und ModelScope auf die entsprechenden Modellressourcen zugreifen können. Super VL kann auf DGX Spark, DGX Station, RTX-Systemen, in Rechenzentren oder in der Cloud bereitgestellt werden; Bolt E4B 4GB soll am 23. Oktober veröffentlicht werden.