

Google möchte, dass das Gemini 4 Argon-Modell das einzige KI-Modell ist, das Roboter benötigen
 Jonathan Kemper
Sehen Sie das LinkedIn-Profil von Jonathan Kemper
Oct 15, 2026
 Google Deepmind
Schlüsselpunkte
- Gemini 4 Argon ist G固les Versuch eines einzelnen KI-Modells, das Roboter steuert, interaktive 3D-Lernszenarien erstellt und Trainingsdaten bewertet.
- Von einfachen Eingaben wie Fotos oder Skizzen erstellt das System Simulationsmodelle, in denen Roboter ihre Bewegungen vor der tatsächlichen Nutzung im Realworld ausüben können.
- Die Demos benötigen weiterhin detaillierte menschliche Anleitung und Unterstützung. Argon ist über Google’s bezahlte Entwicklerzugangprogramme verfügbar.
Mit Gemini 4 Argon bietet Google ein einzelnes Modell für den gesamten Robotik-Prozess an. Es steuert Roboter, baut virtuelle Übungswelten und bewertet Trainingsvideos. Doch die Beispielanweisungen zeigen, wie viel menschliche Unterstützung das Modell immer noch benötigt.
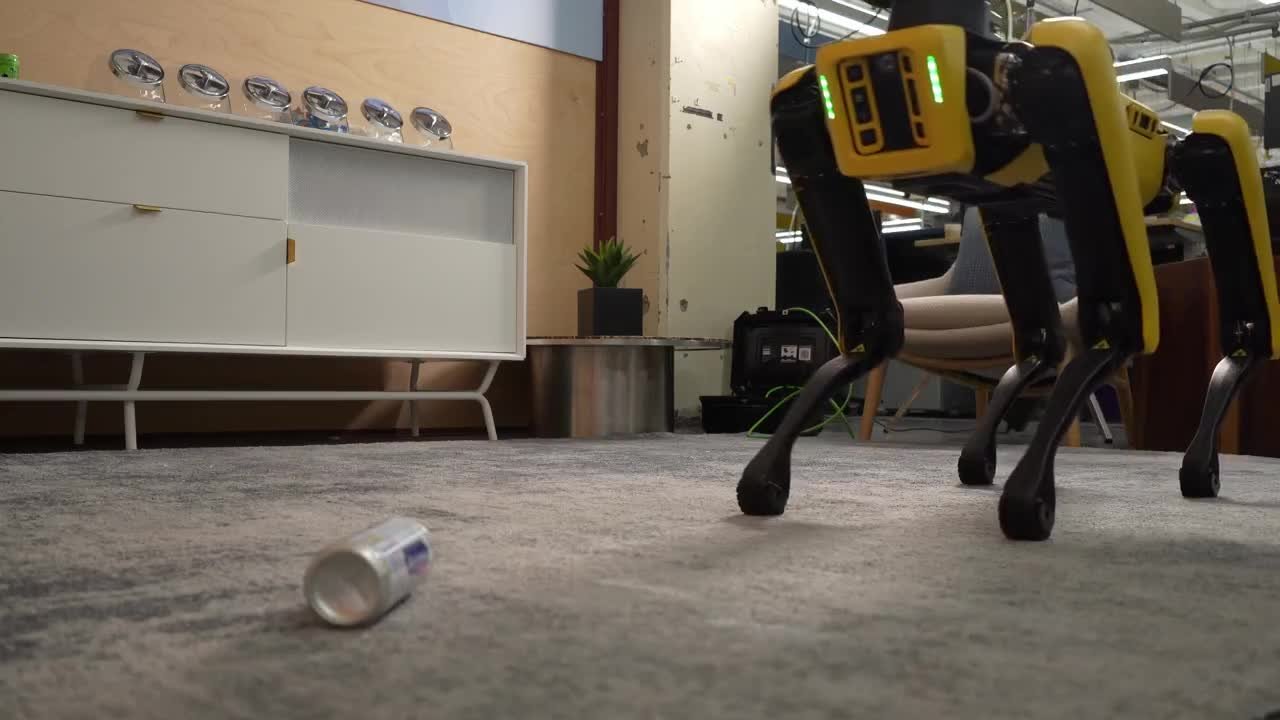
Ein Spot-Robot von Boston Dynamics soll Dosen mit Soda in einen Mülleimer werfen. Bevor er auf den echten Pedal tritt, erstellt Gemini 4 Argon eine virtuelle Kopie des Mülleimers, und der Roboter übt das Balancieren auf drei Beinen innerhalb dieser Simulation. Erst dann versucht er die Aufgabe mit echter Hardware. Bevor die Dose fallen kann, überprüfen zwei zusätzliche AI-Agenten, ob der Fuß und der Greifer richtig positioniert sind.
So zeigt Google die Fähigkeiten seines Neuestes Modell für Robotikaufgaben. Argon ist dafür konzipiert, die räumlichen Beziehungen besser zu verstehen, Steuercode zu schreiben und Videos aus physikalischer Sicht zu interpretieren. Google betrachtet das Modell als ein allgemein verwendbares Werkzeug, das alles abdeckt – von der Steuerung einzelner Roboter bis zur Rekonstruktion veröffentlichten Forschungsergebnisse – und bezeichnet es als einen weiteren Schritt hin zu „physischer AGI“, ein Ziel, das sie und ihr AI-Unternehmen DeepMind verfolgen. jahrelang weitergehend.

Eine einzige Foto wird zu tausenden Trainingsläufen
Die Spot-Demo folgt einem Muster, das in vielen Beispielen von Google auftritt: Argon verwendet Simulationen, um Aufgaben vorzubereiten, sie zu überprüfen oder Trainingsdaten zu erzeugen. Aus einer einzigen Foto von einem Tisch mit Partyspielzeug baute das Modell eine virtuelle Repräsentation auf, einschließlich eines weichen Plüschhüters. Es entwickelte 77 Aufgaben – von dem Rechtshalten umgestürzter Gegenstände bis zum Aufräumen des Tisches – und erzeugte mehr als 4.500 Trainingsepisoden für ein Kontrollmodell. Bei der Testung auf dem echten Roboter stieg die Erfolgsrate von 56 auf 75 Prozent und die Ausführungszeit sank von 35 auf 24 Sekunden.

Argon kann auch aus anderen Quellen stammen. Aus einer Aufnahme eines teleoperierten Robots wird eine Simulation erstellt, die genauso aussieht und dieselben Kräfte messen kann wie das echte Roboterteil. Aus einem Video in Erstperson-Ansicht eines Menschen, der eine Greifaufgabe ausführt, wird das Modell die Bewegungen der Hand und der Finger auf einen fünf-fingrigen virtuellen Humanoiden abbilden.
Auch ein Skizzieren mit einer Ballpoint-Tinte funktioniert. Ein Bild zeigt einen humanoiden Roboter, der eine Pyramide aus Kisten mit einem Ball zerstört, und Argon macht daraus eine Simulation, die die Wurfbewegung berechnet, um alle sechs Kisten umzustürzen, ohne dass der Roboter umfällt.

Argon leitet ein AI-Video-Modell, damit es Robotaktionen planen kann
Eine Demo spielt ganz aus einem von der KI erstellten Video. Gemini Omni ist ein Video-Weltmodell, das Clips erstellt, die zeigen, wie eine Szene sich verändert, wenn etwas passiert, und Argon fungiert als Regisseur. Er schreibt zeitgestellte Anweisungen, die beschreiben, was die Hände tun sollen, wie zum Beispiel ein Scrabble-Tile in die Mitte des Tisches zu schieben. Gemini Omni erstellt ein Video aus diesen Anweisungen, und Argon überprüft anschließend einzelne Bilder und passt den nächsten Befehl an. Das Ziel ist es, fünf verstreute Buchstaben-Tiles so anzuordnen, dass „ARGON“ entsteht, und nach 33 Schritten sind sie in der richtigen Reihenfolge.

In einer separaten Demonstration mit einem einfachen Roboterarm musste Argon einen Lego-Block in eine Holzkiste platzieren und seine eigene Leistung im Laufe der Zeit verbessern. Wenn die Versuche fehlschlugen, forderte das Programm Argon auf, seine eigenen Protokolle und Kamerabilder zu überprüfen, den Grund herauszufinden und nach dem Anwenden einer bestätigten Lösung erneut zu versuchen. Die erste Ausführung dauerte knapp eine Minute, die zweite war mit 23 Sekunden viel schneller – obwohl der Block den Rand der Kiste berührte. Beim dritten Versuch landete er nach etwa 17 Sekunden genau in der Mitte.

Google möchte außerdem, dass Argon Forschung erbringt. Bei einem einzigen Prompt pro Artikel wird die veröffentlichte Robotik-Experimente in interaktive Simulatoren umgewandelt, die im Browser laufen. Google sagt, dass bisher 68 solche Sandboxes entwickelt wurden, darunter Robotensoccer und ein humanoider Roboter auf einem Skateboard.
Der ERQA-Benchmark (Embodied Reasoning Question Answering) testet, wie gut AI-Modelle physische und räumliche Probleme in 3D-Umgebungen verstehen und lösen können. Der Test umfasst 400 Fragen ohne Hilfswerkzeuge, sodass die Modelle alles allein durch Rechenvorgänge lösen mussten. Laut Google erreichte Argon 87 Prozent – das ist mehr als alle anderen neuen Modelle. Der Zweite Platz ging an Claude Opus 5.5 mit 82,3 Prozent, etwa fünf Prozentpunkte hinter Argon. GPT-6 Astra erreichte 81 Prozent und Claude Fable 5.1 lag bei 74 Prozent, also 13 Punkte zurück.

Der AA-Robotics Benchmark von Artificial Analysis, der einen Tag später veröffentlicht wurde, erzählt eine andere Geschichte. In diesem Test kontrollieren Sprachmodelle direkt einen echten Roboterarm bei acht Aufgaben, und Argon belegt den dritten Platz mit 55 von 100 Punkten, hinter GPT-6 Astra mit 69 und GPT-6.1 Sol mit 65.
Argon überprüft auch die Qualität der Trainingsdaten
Neben der Steuerung von Robotern und der Erstellung Simulationen soll Argon auch Trainingsdaten bewerten. In einem Video, das etwas mehr als zwei Minuten dauert und zeigt, wie ein Zweikörper-Robot ein Origami-Fuchs falten, teilt das Modell die Aktion in Unterschritte auf und markiert Pausen sowie fehlerhafte Greifbewegungen. Diese Abschnitte werden dann während des Trainings weniger gewichtet. In einem weiteren Video über menschliche Ring-Sortierer zeichnet Argon den Weg, den die Aufgabe nimmt, Störungen oder Rückfälle.
Google zeigte außerdem einen spielerischeren Beispielfall, der um ein klassisches Gewichtungsrätsel beruht. Unter zwölf ähnlich aussehenden Kugeln ist eine schwerer oder leichter als die anderen. Argon erstellte eine Simulation mit zwei Roboterarmen und einer Waage, indem es die Neigung der Waage allein anhand von Kamerabildern misst. Es findet die ungewöhnliche Kugel in drei Gewichtungen oder weniger.
Das echte Gerüst befindet sich in den Prompts
Google veröffentlichte detaillierte Beispielanweisungen für die Demos und brachte einige der größeren Behauptungen in eine realistischere Perspektive. Bei der Reparatur eines umgekippten Bechers, was als „zero-shot“ bezeichnet wird, erhält Argon ein Kamerabild mit einer Zentimeter-Grid-Unterlage und vorbereitete Befehle wie „greifen“ oder „niedrigen, bis zum Kontakt“. Für die Simulationen gibt es lange Verbotslisten, um das Modell daran zu hindern, Abkürzungen zu nehmen, wie zum Beispiel einfach die gemessenen Sensorwerte zu kopieren. Google teilt in der Blogpost nicht die Scheiternraten für einzelne Demos mit, und die 75-prozentige Erfolgsrate wird nicht erwähnt, auf wie viele Gesamtanläufe sie basiert.

Argon ist jetzt in Google AI Studio und dem Entwicklungsumfeld Antigravity verfügbar, aber nur für Google AI Ultra Abonnenten. Entwickler können das Modell auch über die bezahlte Version der Gemini API zugänglich machen.
Google hatte Gemini 4 Argon nur wenige Tage zuvor weltweit veröffentlicht. Für die Robotik hatte das Unternehmen bereits Gemini Robotics-ER 1.6 eingeführt, ein Modell für räumliche Wahrnehmung und Aufgabenplanung. Die Ausbildung in virtuellen Umgebungen ist auch nicht neu: das Startup World Labs zeigte, wie echte Szenen in virtuelle Ausbildungswelten umgewandelt werden können, während Nvidias DreamDojo robotische Handlungen als Videos simuliert. Was die Vorgehensweise von Google auszeichnet, ist der Anspruch, Simulation, Kontrolle und Bewertung alle mit demselben Modell zu bewältigen.
AI-News ohne Hype – von Menschen zusammengestellt
Abonnieren Sie THE DECODER, um eine Werbefreie Lektüre, einen wöchentlichen AI-Newsletter, unseren exklusiven „AI Radar“-Frontier-Report sechsmal jährlich, den vollen Archivzugang und Zugang zur Kommentarspalte zu erhalten.
Quelle: Google