
Highlights
- Architektur: 816B Parameter insgesamt, 42B aktiv pro Token mit einem 1M Kontextfenster.
- Quantisierung: Meta hat das Modell sowohl in BF16 als auch in NVFP4 veröffentlicht. MXFP4-Gewichte wurden von AMD veröffentlicht.
- Multimodal: Native Bild- und Videowahrnehmung durch denselben Perception Encoder wie Muse Glimmer, mit zusätzlicher Audio-Unterstützung.
- Parallelität: Tensor Parallelism und Pipeline Parallelism auf Nvidia und AMD. EP, TEP, DEP und PD-Disaggregation auf Nvidia. Erste Unterstützung auf TPU ist ebenfalls verfügbar.
- Speculative Decoding: Wir haben ein DSpark-Draft-Modell trainiert, das auf CUDA und ROCm unterstützt wird und die Modellleistung beschleunigt, getestet auf dem SPEED-Bench.
Verwendung
Vorgefertigte Images sind für beide Anbieter verfügbar:
- Nvidia: vllm/vllm-openai:muse-spark-open
- AMD: vllm/vllm-openai-rocm:muse-spark-open
Beachten Sie, dass das Modell erst als nächtliches PyPI-Wheel verfügbar sein wird, nachdem der Code (PR #61879) überprüft und gemerged wurde, was in der Regel etwa eine Woche dauert.
# Rust frontend is recommended
export VLLM_USE_RUST_FRONTEND=1

vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
    --tensor-parallel-size 8 \
    --enable-expert-parallel \
    --max-model-len 1048576 \
    --reasoning-parser muse \
    --tool-call-parser muse \
    --enable-auto-tool-choice \
    --speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
So verwenden Sie dieses Modell mit reinem Text:
  curl http://localhost:8000/v1/chat/completions \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "meta-models/Muse-Spark-Open-816B-A42B-NVFP4",
      "messages": [{"role": "user", "content": "Refactor this module."}],
      "reasoning_effort": "xhigh"
    }'
Für multimodale Wahrnehmung:
 curl http://localhost:8000/v1/chat/completions \
   -H 'Content-Type: application/json' \
   -d '{
     "model": "meta-models/Muse-Spark-Open-816B-A42B",
     "messages": [{"role": "user", "content": [
       {"type": "image_url", "image_url": {"url": "https://example.com/screenshot.png"}},
       {"type": "video_url", "video_url": {"url": "https://example.com/demo.mp4"}},
       {"type": "audio_url", "audio_url": {"url": "https://example.com/clip.wav"}},
       {"type": "text",      "text": "What is happening here, and when?"}
     ]}]
   }'
Implementierungsdetails
Modellarchitektur
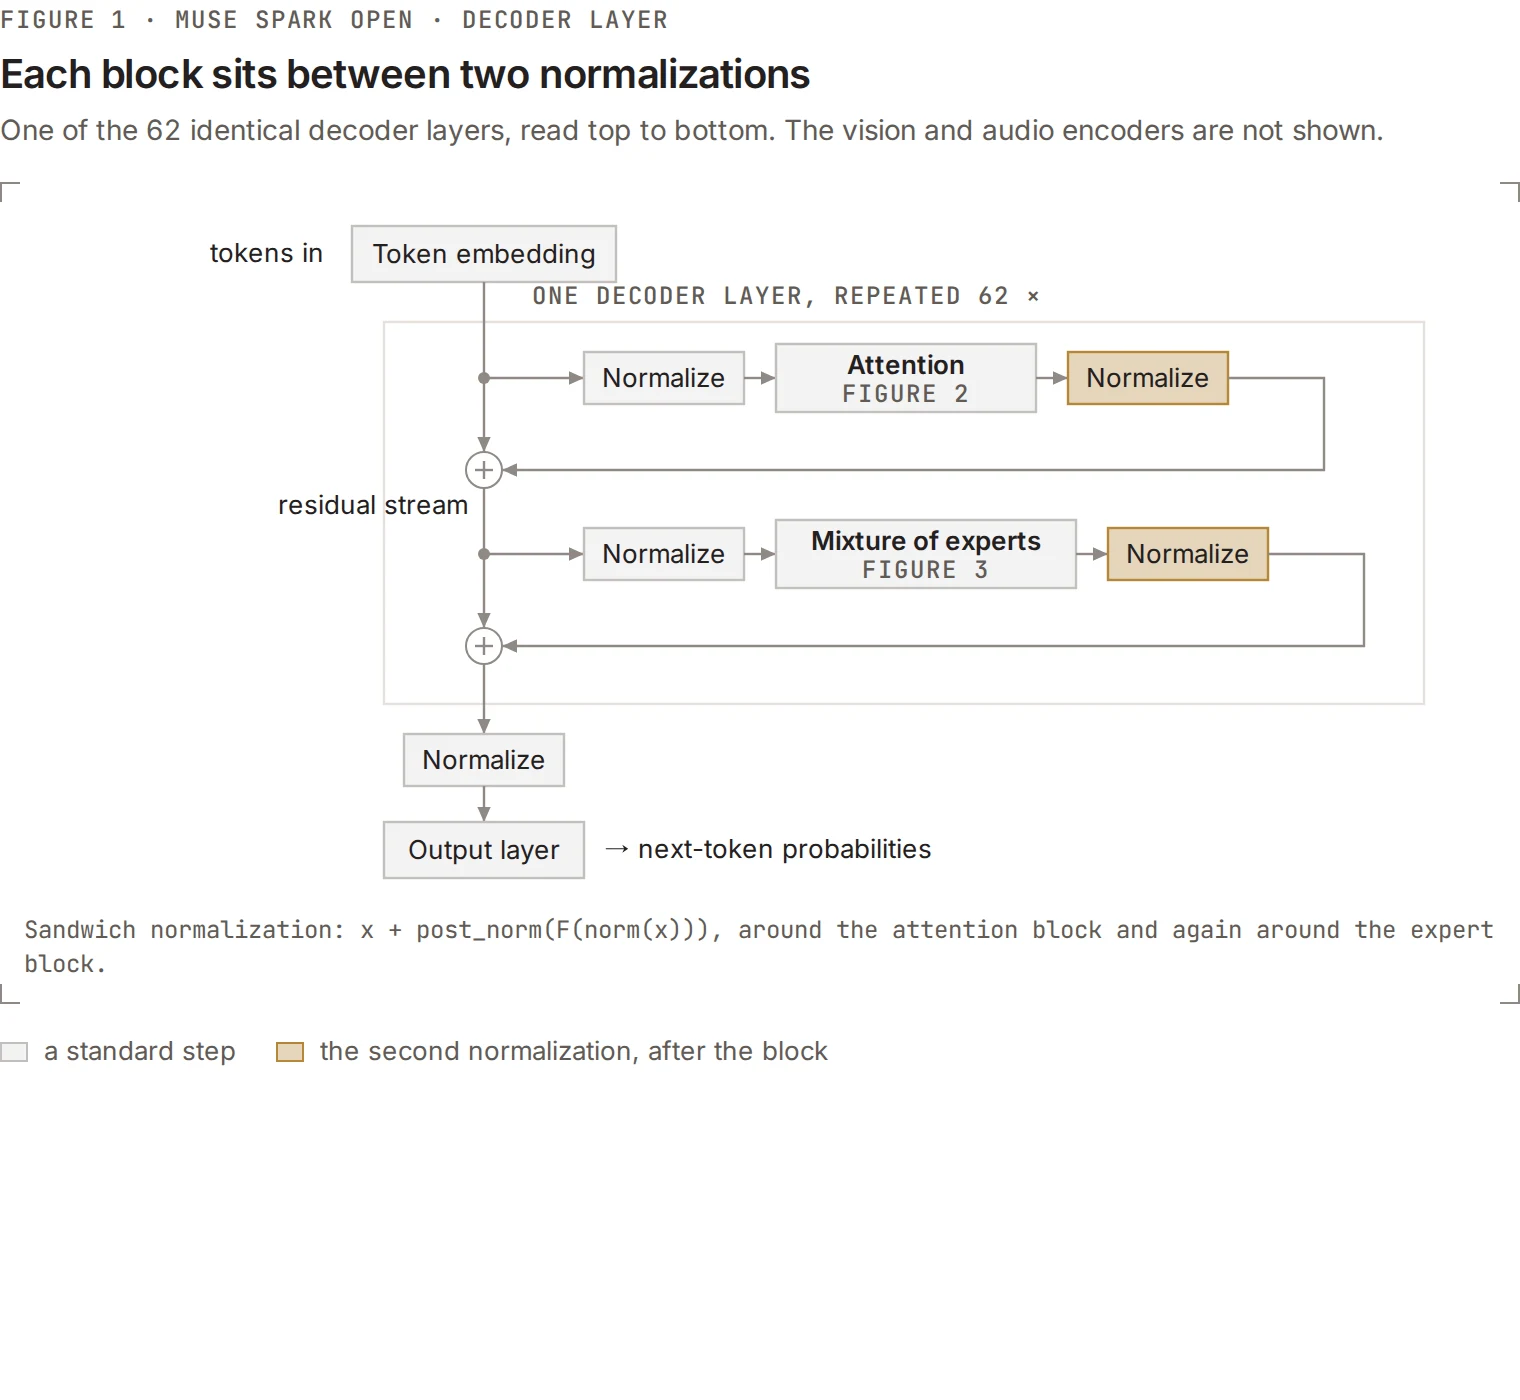
Muse Spark Open ist ein Mixture-of-Experts-Modell mit 816B Parametern insgesamt, einschließlich des Text-Decoders, dazu ein 2B Vision-Encoder und ein kleiner Audio-Encoder. Der Decoder hat 62 Schichten, und jede einzelne davon ist eine Mixture-of-Experts-Schicht. Hier ist die Verteilung der Gewichte:
| Teil | Größe |
|---|---|
| 256 Experten pro Schicht | 799 B |
| Attention | 13.5 B |
| MoE-Latent-Projektionen | 4.2 B |
| Einbettungs- und Ausgabeschicht | 3,3 Mrd. |
| Vision-Tower (separat) | 1.9 B |
Die Modellarchitektur ähnelt der von Muse Glimmer. Für alle, die Muse Glimmer noch nicht verwendet haben: Es gibt einige Dinge in dieser Modellarchitektur, die einen genaueren Blick wert sind.
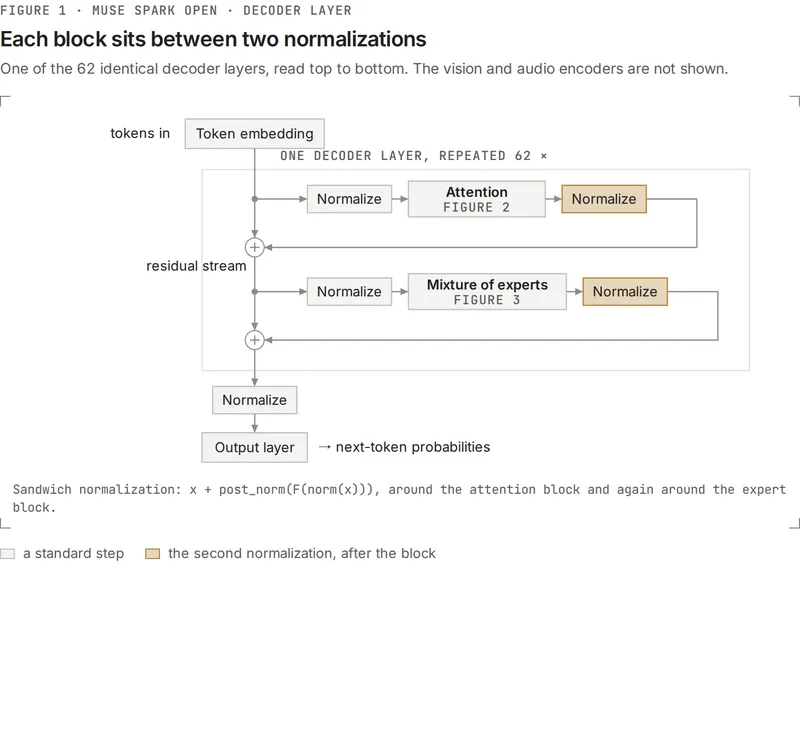
Sandwich-Normalisierung. Die meisten Decoder legen eine Normalisierungsschicht vor jeden Block, was x + F(norm(x)) ergibt. Muse Spark Open platziert, ähnlich wie Muse Glimmer, eine davor und eine danach – wie die zwei Scheiben eines Sandwiches, bei dem der Block dazwischen liegt –, was x + post_norm(F(norm(x))) ergibt
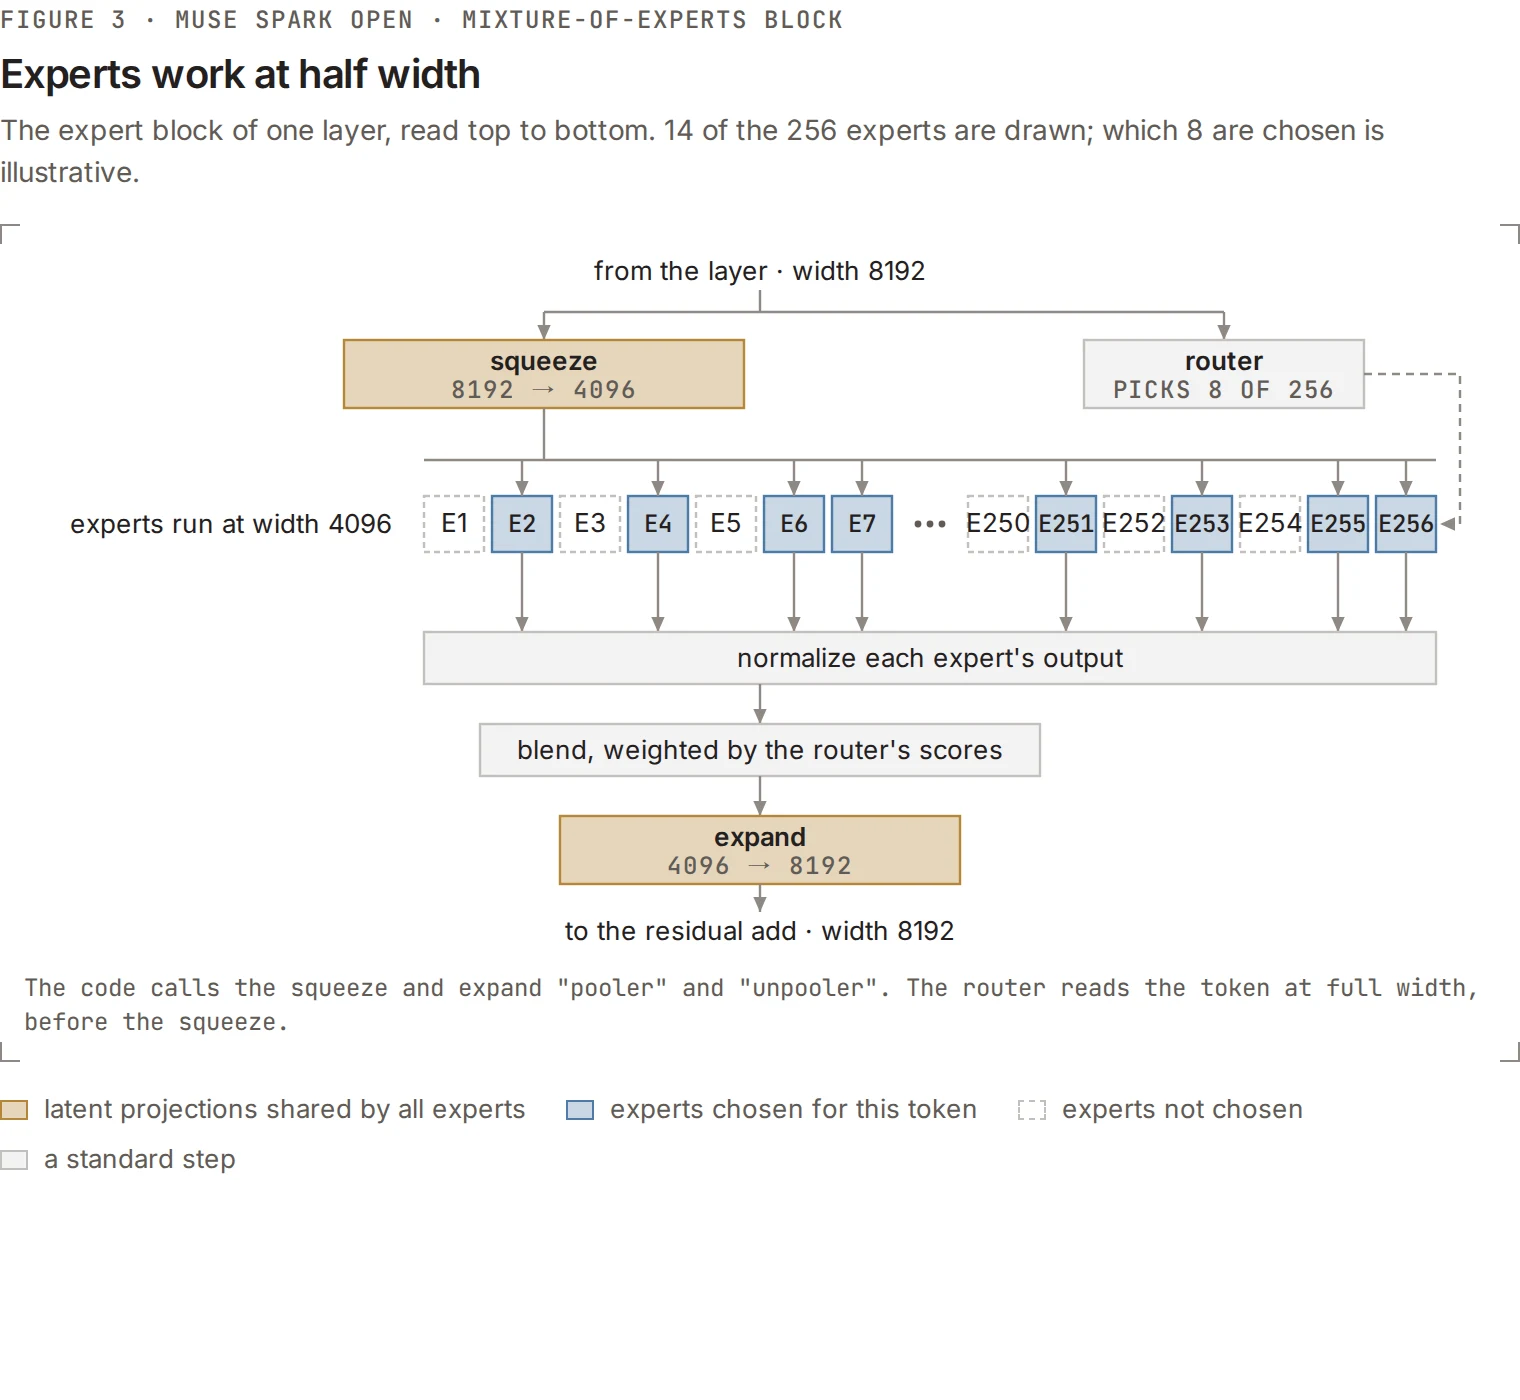
Latentes MoE. Jede Mixture-of-Experts-Schicht (MoE) trägt zwei zusätzliche Matrizen, die von allen 256 Experten dieser Schicht gemeinsam genutzt werden. Der Code nennt sie Pooler und Unpooler, wobei keine von beiden im üblichen Sinne poolt; stattdessen sind beide gelernte Projektionen, um die Dimensionen zusammenzudrücken und wieder zu erweitern. Der Pooler ist eine 8192 × 4096 Matrix, die die Breite jedes Tokens halbiert, bevor es die Experten erreicht; der Unpooler stellt danach die volle Breite wieder her. Die Experten arbeiten daher vollständig bei 4096 statt 8192, was die Anzahl der in den beiden Expertenprojektionsschichten erforderlichen Parameter effektiv halbierte.
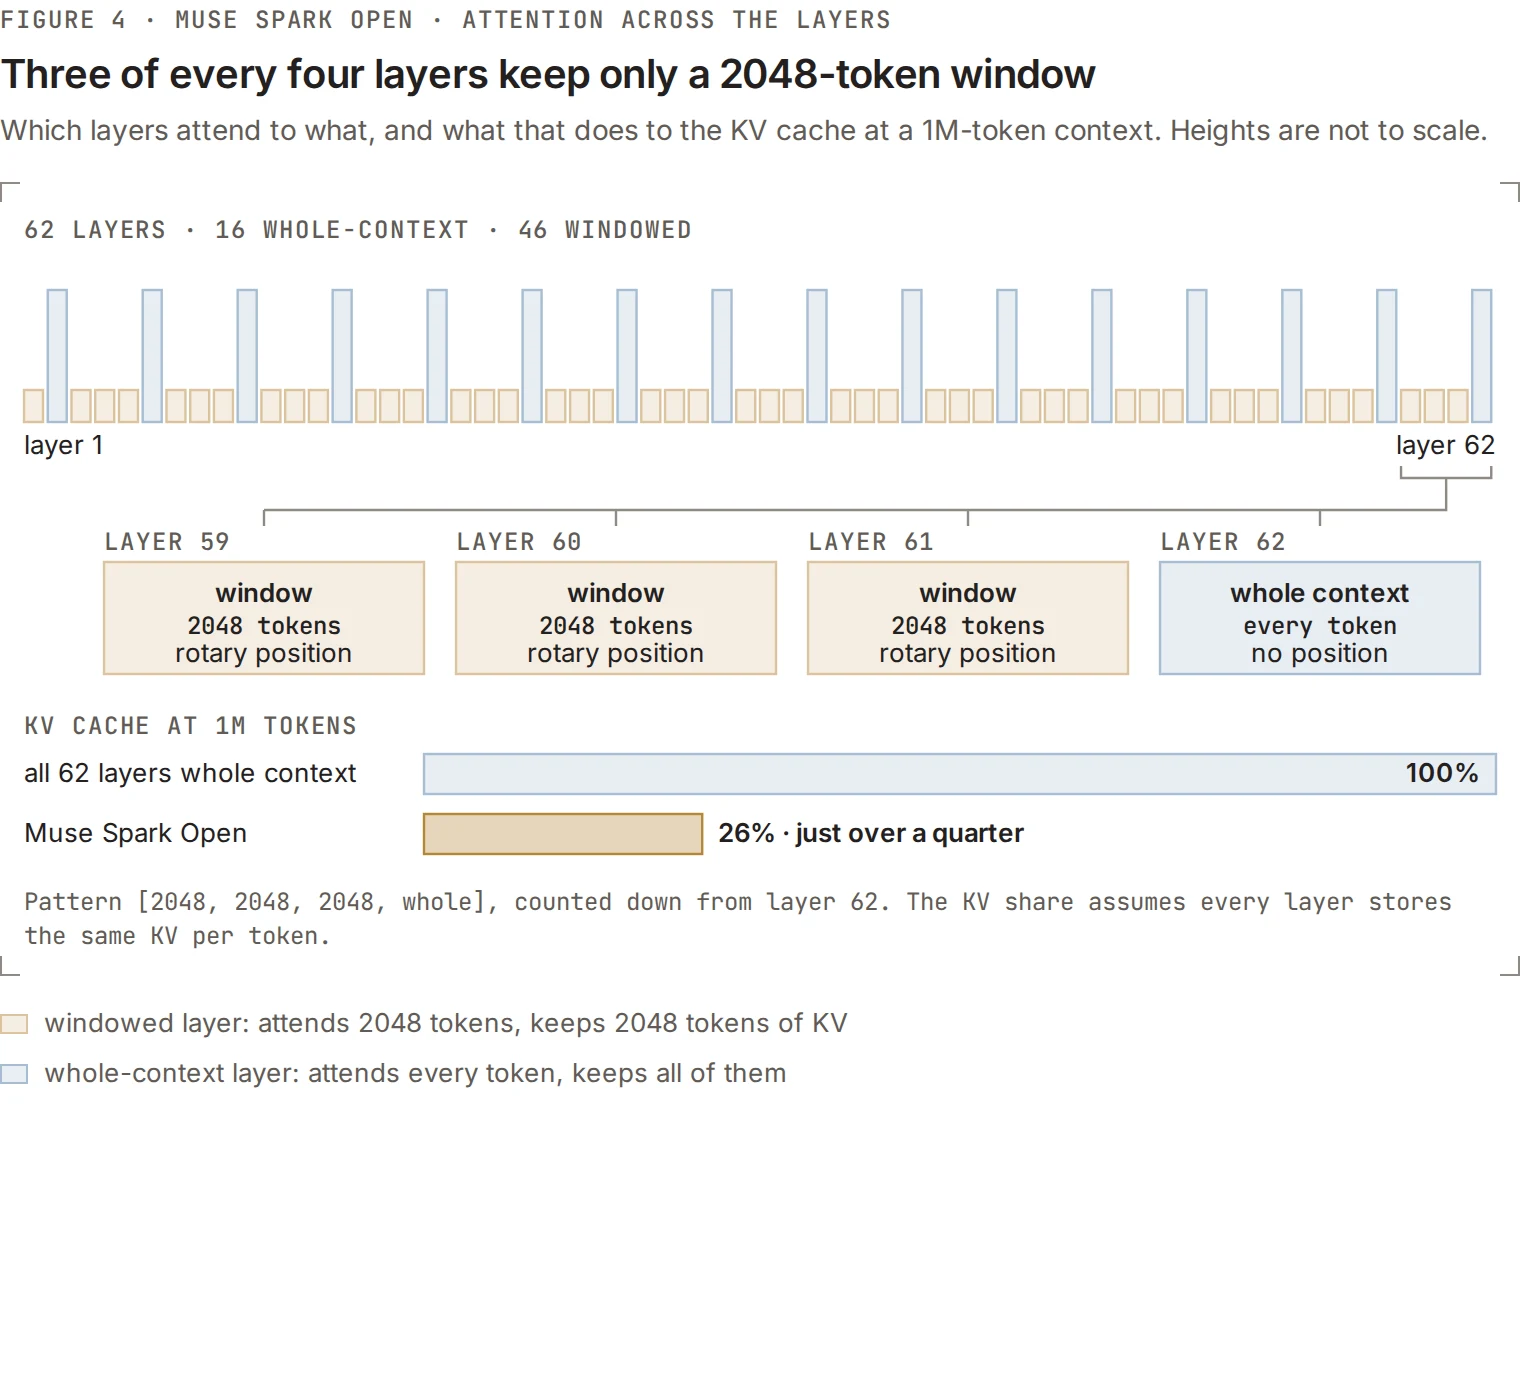
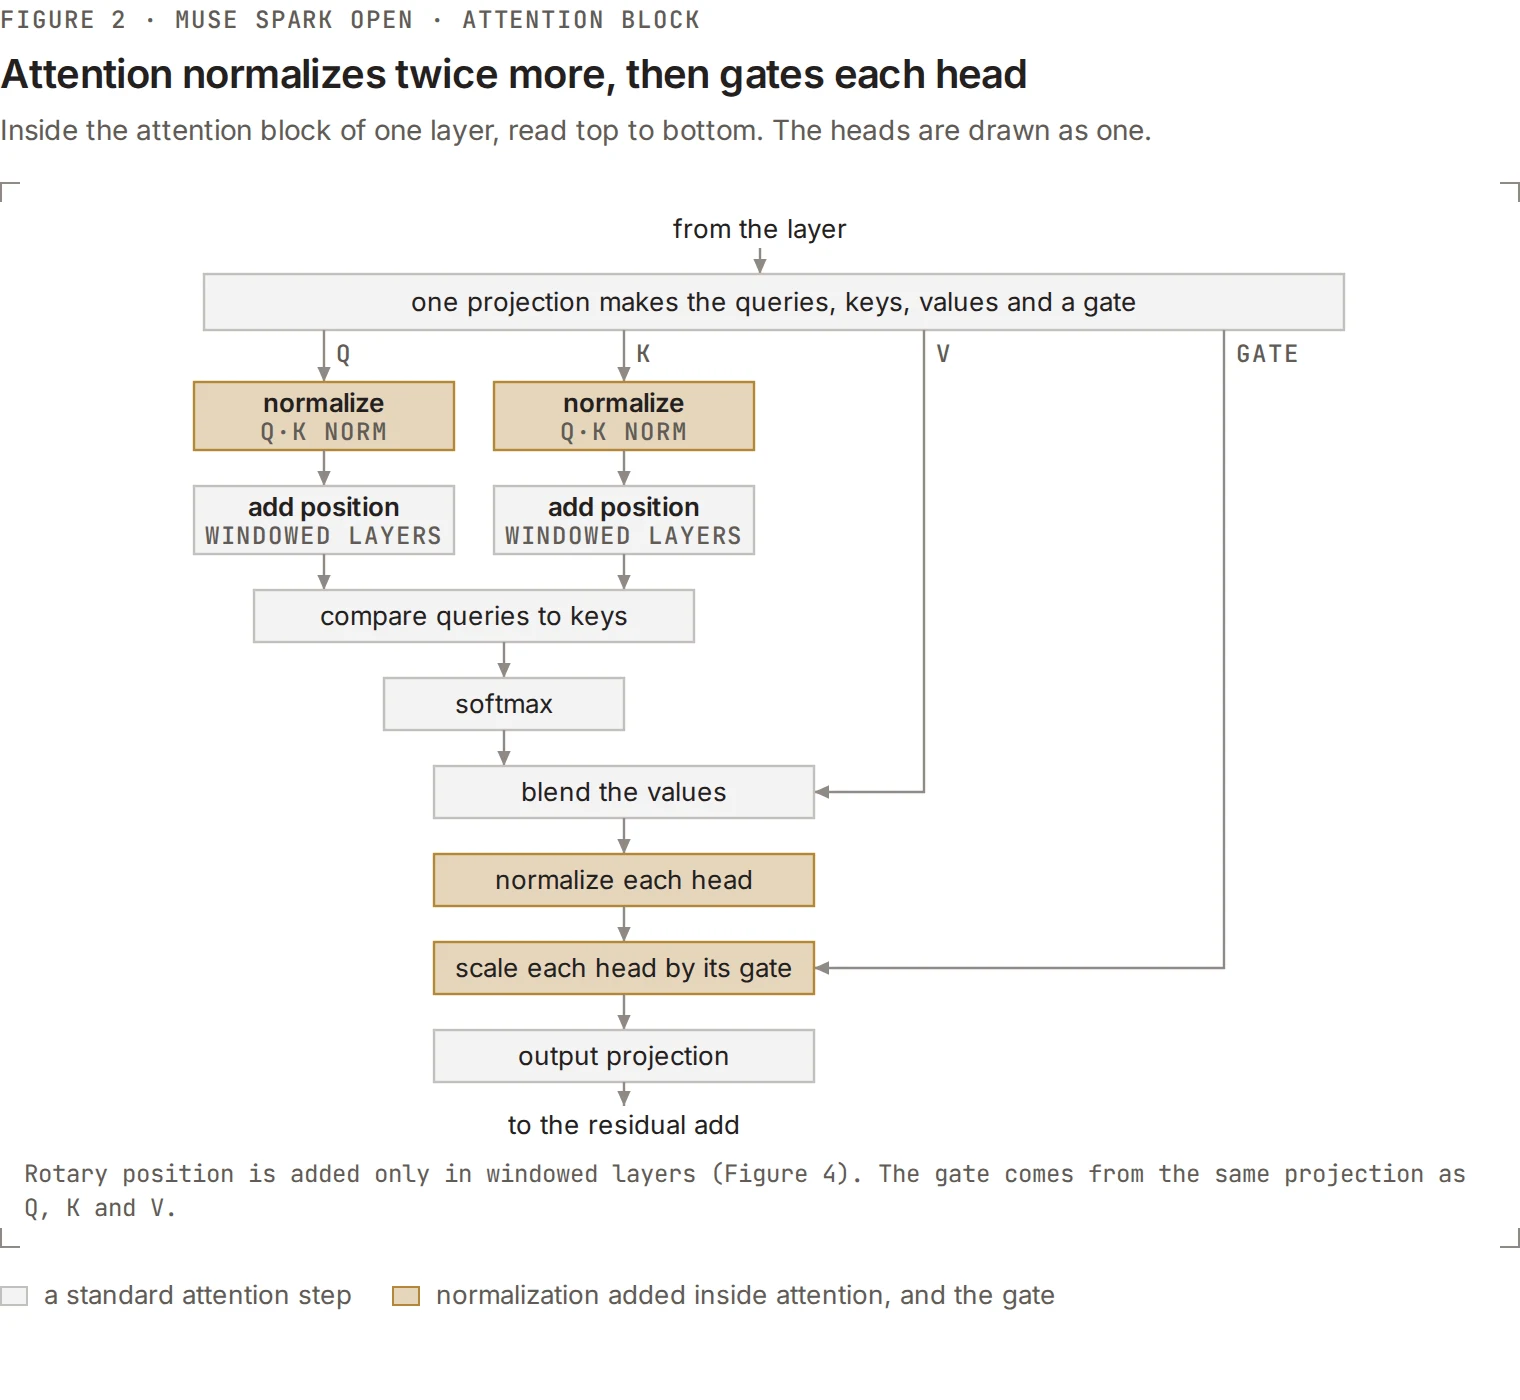
Hybride Attention. Die Schichten wechseln zwischen Full Attention und Sliding Window Attention (SWA) in einem sich wiederholenden Zyklus von 4, wobei drei auf ein 2048-Token-Fenster achten und die vierte den gesamten Kontext betrachtet. Der Zyklus ist am Ende des Stacks verankert, sodass die letzte Schicht immer eine Full-Attention-Schicht ist. Über 62 Schichten ergibt das 46 schmale Schichten und 16 breite, wobei die schmalen Schichten nur aktuelle KV halten. Bei 1M Token bringt das den Cache auf knapp über ¼ dessen, was durchgehend volle Aufmerksamkeit benötigen würde. Das macht die 1M-Kontextlänge erschwinglich.
Vision-Encoder. Muse Spark Open verwendet denselben Perception Encoder wie Muse Glimmer, einen 2B-Parameter-Tower, der Bilder in ihrer nativen Auflösung liest, anstatt sie auf ein Quadrat zu skalieren. Videos laufen durch denselben Encoder: Frames werden zur Ladezeit als eine Reihe von gesampelten Videoframes genommen, mit einem im Prompt tokenisierten Zeitstempel.
Audio-Encoder. Audio wird als rohe Wellenform bei 24 kHz gelesen, und alle 1920 Samples, d. h. 80ms, werden durch eine Reihe von Transformationen zu einem Token. Der gesamte Audio-Encoder umfasst nur 118M Parameter. Beachten Sie, dass die Audiospur eines Videos nicht verarbeitet wird. Um dem Modell sowohl die Bilder als auch den Ton eines Clips zu geben, senden Sie das Video und den extrahierten Ton als zwei separate Inhaltsteile in derselben Anfrage.
DSpark
Um die Muse Spark Open-Inferenz auf vLLM zu beschleunigen, haben wir einen Speculator mit DSpark trainiert, einem speculativen Dekodierungsalgorithmus, der Block-Diffusion nutzt, um in einem einzigen Durchlauf bis zu sieben Draft-Token vorzuschlagen. Confidenzbasiertes Scheduling trägt dazu bei, auch bei großen Batch-Größen erhebliche Beschleunigungen aufrechtzuerhalten, wo speculative decoding traditionell abnehmende Erträge bietet, wie in den folgenden Ergebnissen gezeigt.
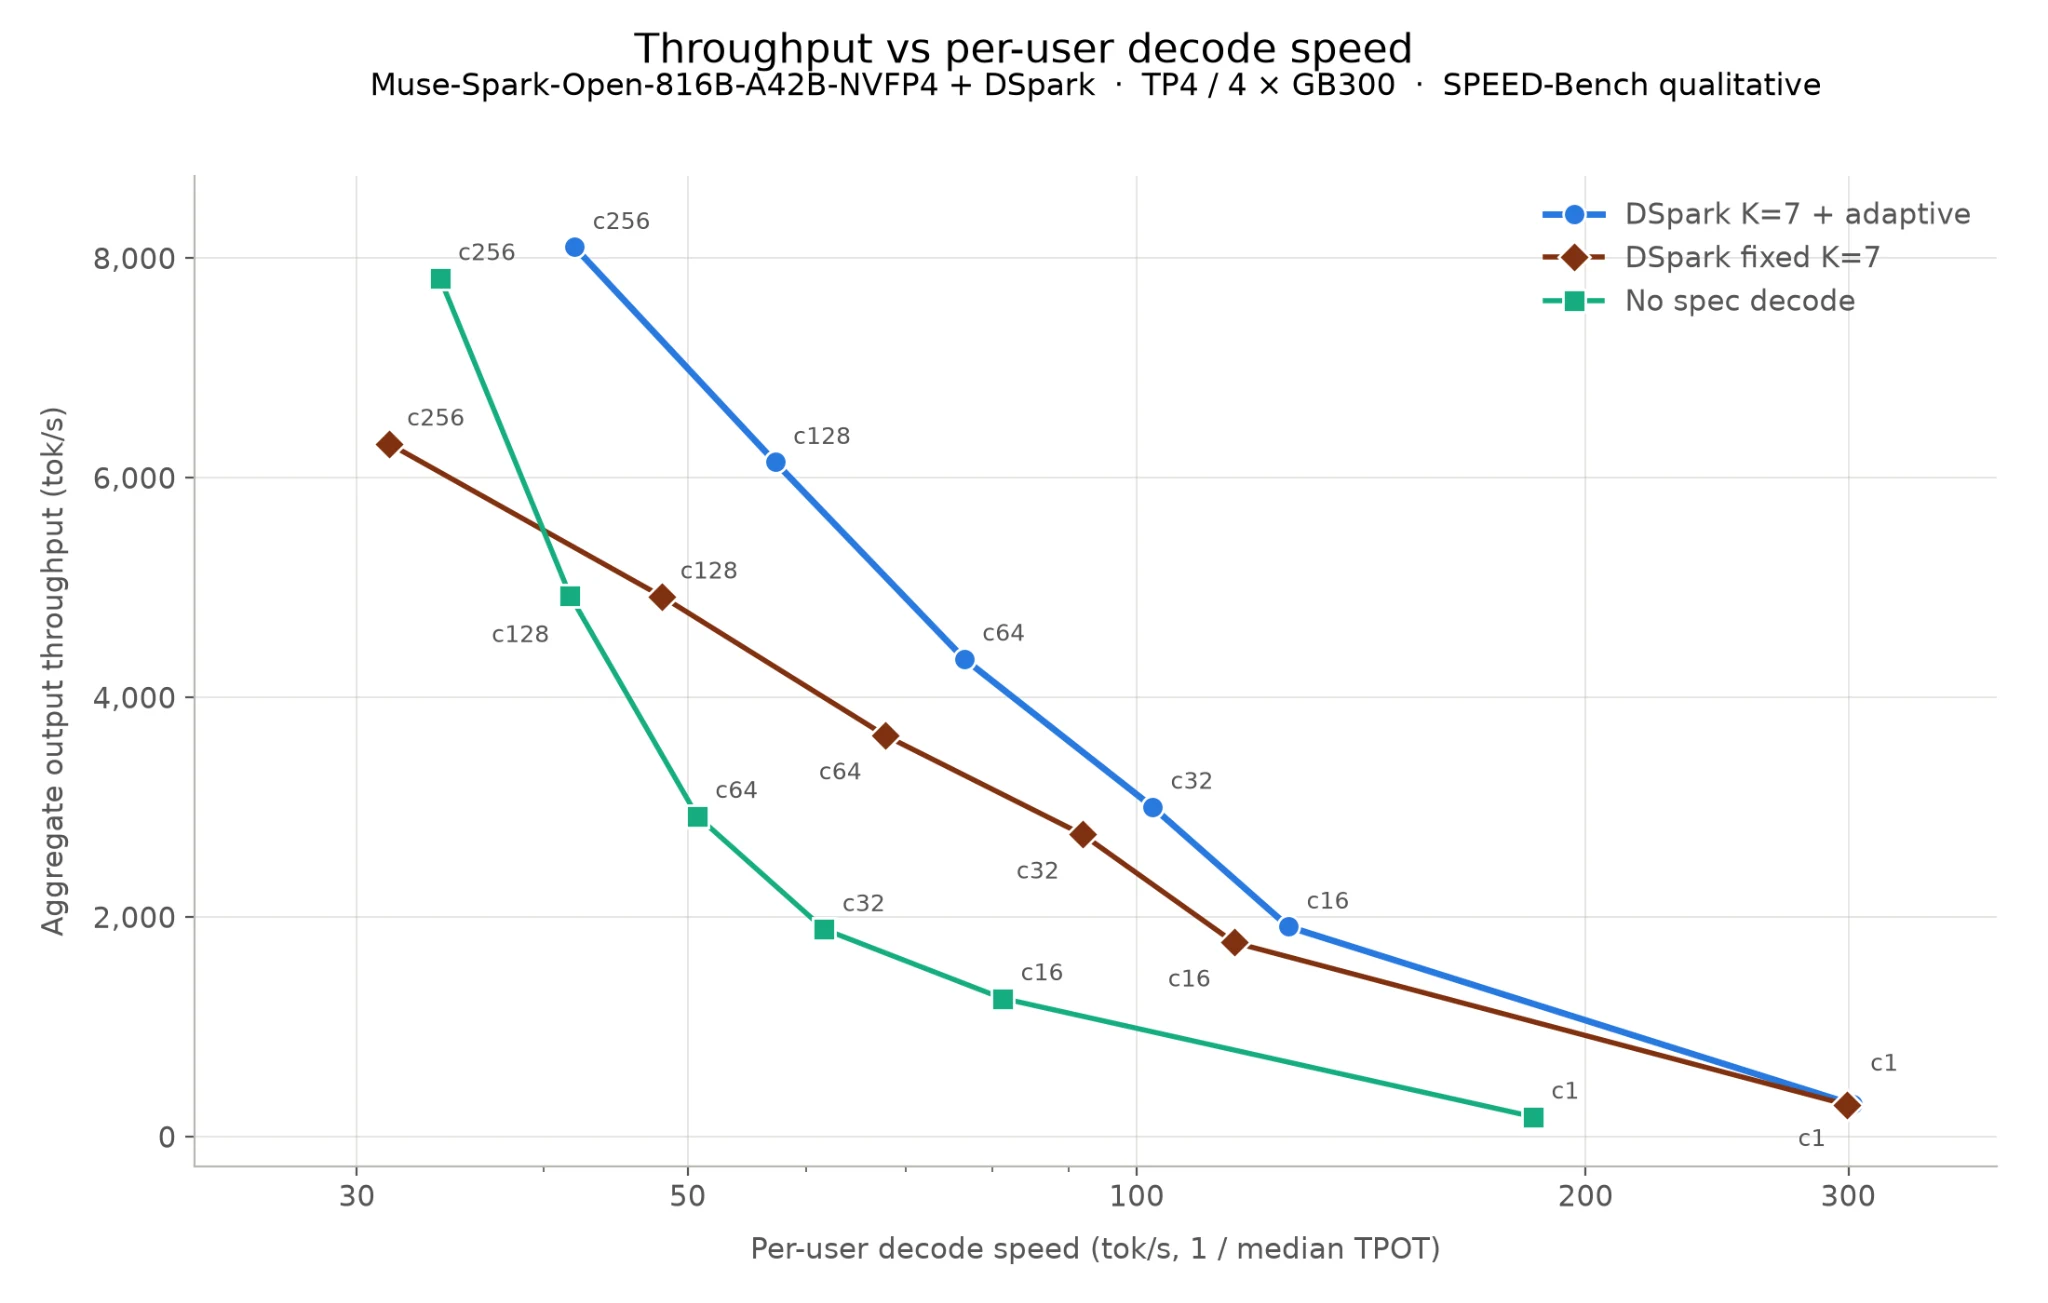
Unser Speculator nutzt ebenfalls die Sliding-Window-Attention von Muse Spark Open, um das Drafting leichtgewichtig zu halten, selbst bei einem Kontext von 1M Token. Zusammen machen diese Entscheidungen ihn gut geeignet für Produktions-Workloads über einen weiten Bereich von Batch-Größen und Kontextlängen.
Um es zu aktivieren, fügen Sie dies beim Start des Servers hinzu:
--speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'Nvidia
Das Nvidia-Team verbesserte die Muse Spark Open-Inferenz über FlashInfer und vLLM hinweg durch fusionierte Normalisierungs-, Gating- und Residual-Kernel; fusionierte MoE-Finalisierung mit Tensor-Parallel-Kommunikation und RMSNorm; eine neue Low-Latency-BF16-GEMM-Implementierung und reduzierten Kompilierungsaufwand; TEP-Pooler/Unpooler-Sharding mit fusionierten MNNVL-Collectives; eine TF32-Router-GEMM, gespeist vom FP32-Ausgang der Norm; sowie Verbesserungen bei Datenbewegung, Hardware-Unterstützung und Laufzeit-Zuverlässigkeit.
AMD
Dank des AMD-Teams unterstützen wir das Modell jetzt auch auf AMD Instinct™ MI355X GPUs, sowohl im FP8- als auch im MXFP4-quantisierten Format, was eine verbesserte Inferenzleistung und Deployment-Effizienz bietet. Beachten Sie, dass ROCm derzeit sowohl Tensor-Parallelism als auch Pipeline-Parallelism unterstützt.
TPU
Wir haben Unterstützung für Muse Spark Open auf TPU auf Basis von TorchTPU hinzugefügt. Bitte kontaktieren Sie uns oder Google für den Codezugriff. Wir haben außerdem Megakernels für Muse Spark Open gebaut. Mit DSpark speculative decoding (Akzeptanzlänge = 6) erreichen sie über 650 Tokens/Sek. auf 4 TPU v7 Chips und über 960 Tokens/Sek. auf 8 Chips. Ohne speculative decoding liefern sie weiterhin über 270 bzw. 350 Tokens/Sek.
Reinforcement Learning in vLLM
vLLM unterstützt LoRA RL auf Muse Spark Open ab Tag 0 und dient als Rollout-Engine mit Verl FSDP2 als Trainer. vLLM dient das ursprüngliche NVFP4-Checkpoint mit dem LoRA-Adapter, der darüber angewendet wird. Der Trainer läuft auf einer BF16-Dequantisierung derselben Gewichte und aktualisiert nur den Adapter (Rank 32, Alpha 64), der Attention, die MoE-Latenzprojektionen und alle gerouteten Experten abdeckt. Er repliziert auch das MoE-Routing des Rollouts (R3), und nach jedem Schritt wird nur der Adapter zurück zu vLLM synchronisiert.
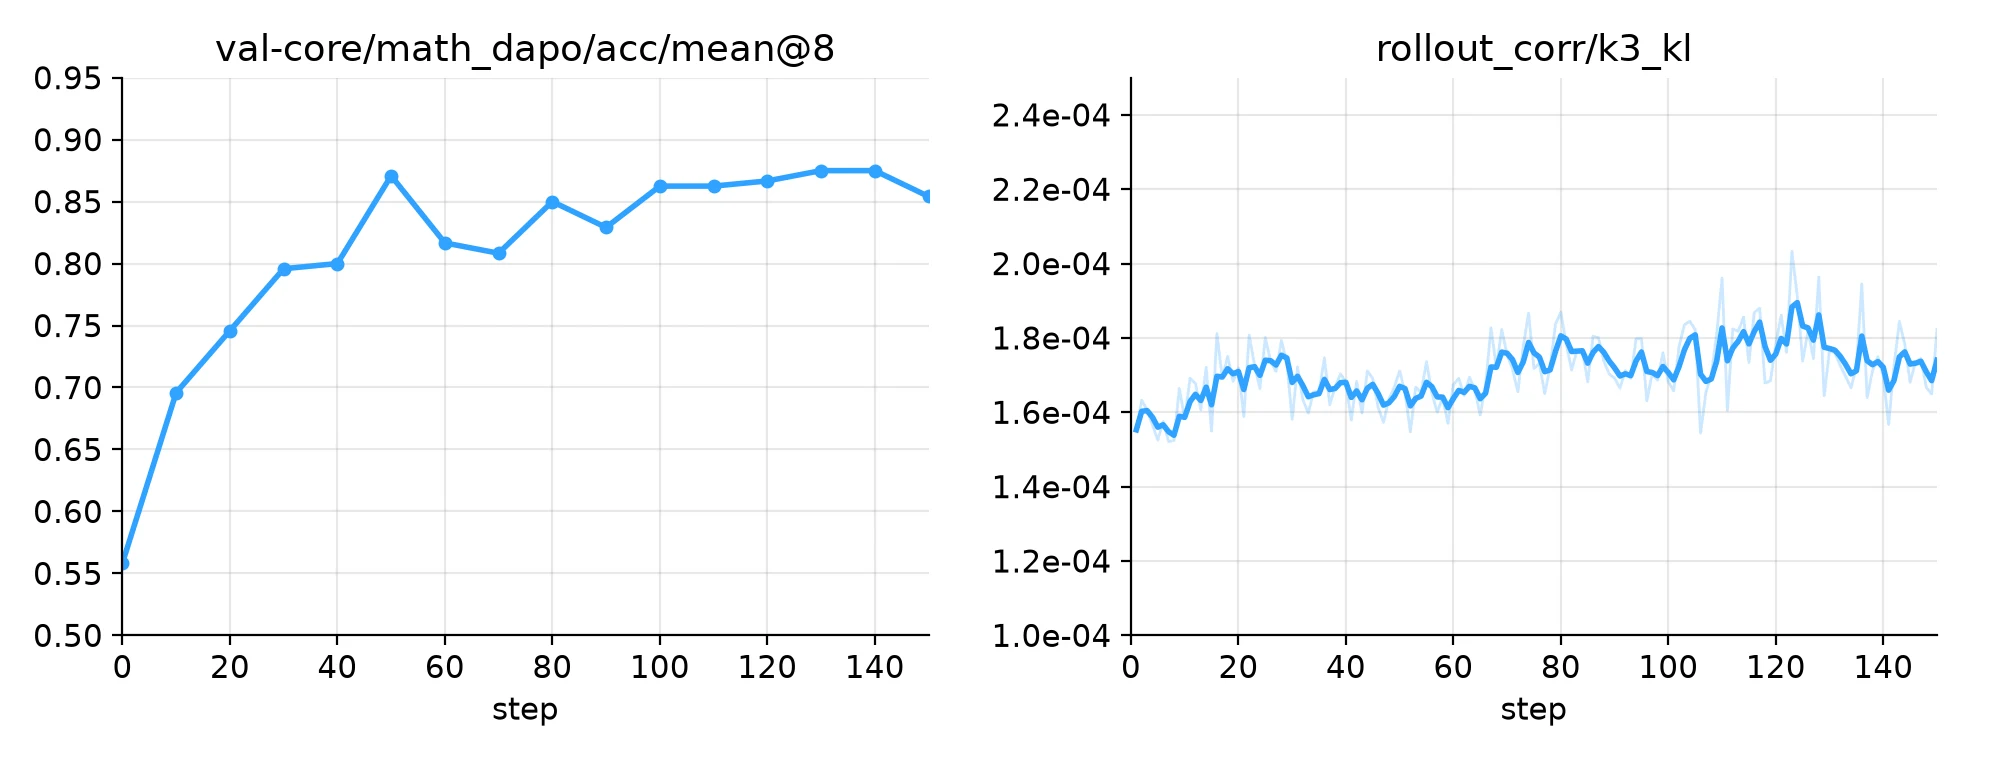
Wir haben mit GRPO auf DAPO-Math-17K für 150 Schritte auf 16 GB300 GPUs trainiert und für jeden von 32 Prompts pro Schritt 8 Antworten mit bis zu 4K Tokens pro Antwort gesampelt. Die Genauigkeit auf AIME-2024 (mean@8) stieg von 0.56 vor dem Training auf 0.85 am Ende des Laufs. Während des gesamten Laufs blieb die k3 KL zwischen den Log-Wahrscheinlichkeiten des Trainers und von vLLM nahe 2×10⁻⁴. Weitere Details finden Sie in https://github.com/verl-project/verl/pull/8257. Im vLLM-Ökosystem nutzt Titan RL ebenfalls vLLM als Rollout-Engine, um Day-0-RL-Unterstützung bereitzustellen.
Danksagung
Wir danken den Teams bei Meta Superintelligence Labs und der vLLM-Community aufrichtig für die enge Zusammenarbeit bei der Bereitstellung des Day-0-Supports für Muse Spark Open auf vLLM. Wir danken außerdem Inferact für das Training des DSpark-Speculators und die TPU-Integration sowie NVIDIA und AMD für ihre wichtigen Hardware-Optimierungen.
Mitwirkende:
- Inferact: Jie Li, Zifeng Mo, Zixi Qi, Jeff Ma, Ziqi Zhao, Dakai An, Ao Shen
- Meta: Beto de Paola, Sidhartha Reddy Potu
- Nvidia: Cyrus Chang, Duncan Moss, Marek Pikulski, Seong Hee Lee
- AMD: Andy Luo, Hongxia Yang, Haichen Zhang