
Luyu, aus Guifeisi
Quantenbit | Öffentlicher WeChat-Account QbitAI
Unfassbar! Schon wieder ist der alljährliche Singles' Day da...
An alle, die im E-Commerce arbeiten: are you ok? Meine Freundin hält es nicht mehr aus und bombardiert mich ständig mit Nachrichten:
Gibt es gute, benutzerfreundliche?KI-ArbeitstoolSuche Empfehlungen? Dringend, dringend, dringend, am besten jemand, der die Arbeit gut macht und auch lange durchhält.
Weißt du was, ich bin neulich tatsächlich auf einen wahren Schatz gestoßen.
Ant Ling, das neu von Ant Group als Open Source veröffentlicht wurde,Ling-3.1-flash„…meine wöchentlichen Arbeitsberichte und Themenzusammenfassungen erledige ich komplett damit.“
u1s1 – ich habe Claude Code, Codex und andere auch benutzt, aber am Ende mussten ich feststellen, dass die inländischen Modelle mir doch besser gefallen.
InsbesondereLerche, im Alltag unauffällig, weder bei Parametern noch bei Rankings im Wettbewerb, aber wenn es wirklich ans Arbeiten geht, ist es äußerst verlässlich.
Laut den offiziellen Angaben konzentriert sich dieses Modell auf genau eine Sache:Die Aufgaben in echten Arbeitsabläufen zu Ende zu bringen.
Nehmen wir den E-Commerce-Bericht vom Anfang: Der Chef sagt nur einen Satz wie「Fasse die Ergebnisse der diesjährigen großen Promo-Aktion zusammen」– und auf den Beschäftigten lastet dann die Arbeit, Material zu suchen, Daten zu prüfen, den Fortschritt zu verfolgen und daraus Excel-Tabellen und Präsentations-PPTs zu erstellen …
Hinter einem Geschäftsvorfall steht oft eine Zusammenarbeit über viele Zwischenschritte, und erschwerend kommt hinzu, dass die Daten verstreut in verschiedenen Dateien und verschiedenen Tools versteckt sind.
Bildquelle: Offizieller WeChat-Account von Bailing
Ling-3.1-flash ist ein aus genau solchen realen Anforderungen hervorgegangenes professionelles Modell mithoher Intelligenz-Effizienz-Relation.
Kurz gesagt will es beweisen: Schön formulierte Antworten sind nur zweitrangig – entscheidend ist, dass die Aufgabe abgeliefert wird.
Für Aufgaben der realen Welt gebaut
Um so kleinteilige Aufgaben wie eine Promo-Analyse bewältigen zu können, muss das Modell über mehrere Abläufe hinweg kontinuierlich voranschreiten. Das Design des Modells Ling-3.1-flash lässt sich entlang dieser Aufgabenkette verstehen.
Das erste Problem, das das Modell lösen muss, istDie Lieferziele sauber herunterbrechen。
Nutzer geben vielleicht nur einen vagen Ein-Satz-Befehl, tatsächlich zu liefern ist jedoch ein ganzes Set an Berichtsmaterialien – das Modell muss selbst die relevanten Unterlagen ausfindig machen, beurteilen, was fehlt und was benötigt wird, und dann auf Grundlage der Zwischenergebnisse weiter vorgehen.
Ling-3.1-flasharbeitet genau so.
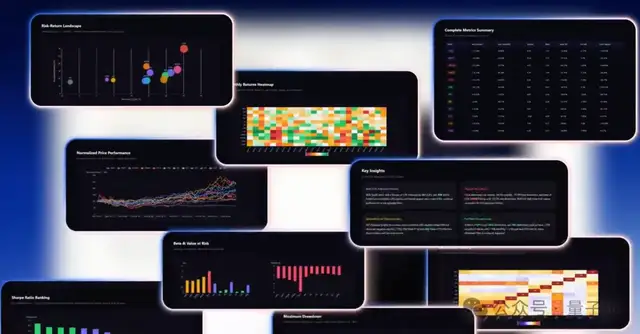
Es verbindet Anforderungsverständnis, Aufgabenzerlegung, Informationsintegration, Tool-Aufrufe und Ergebnisprüfung und kann über Webseiten, Dokumente, Tabellen und Code-Umgebungen hinweg arbeiten.
Zivil kann es Excel und PPT erstellen, militärisch – pardon: praktisch – auch Code generieren und testen.
Und! Diese Fähigkeiten haben bereits eine ziemlich konkreteUmsetzungsform。
Ling-3.1-flash wurde bereits in den Desktop-Kollaborations-Agent-Client von Ant intern integriert,„Xiaohu“wobei das Modell die Aktionen anleitet und die Ausführungsumgebung es tatsächlich Dateien lesen, Programme ausführen und Ergebnisse schreiben lässt.
Das ist durchaus ein Gedanke, von dem man sich eine Scheibe abschneiden kann: Wir können Xiaohu zwar noch nicht nutzen, aber unsere eigenenOffice-Agentin Kombination mit Ling-3.1-flash dürften als Kombination wohl ebenfalls gut funktionieren.
Wenn die Aufgabe fortschreitet, werden die Materialien und der historische Kontext deutlich anschwellen, und die Rechenaufwand steigt entsprechend mit.
Zu diesem Zeitpunkt ist Ling-3.1-flash' …Hybrid-Architekturvon Ling-3.1-flash die entscheidende Rolle.
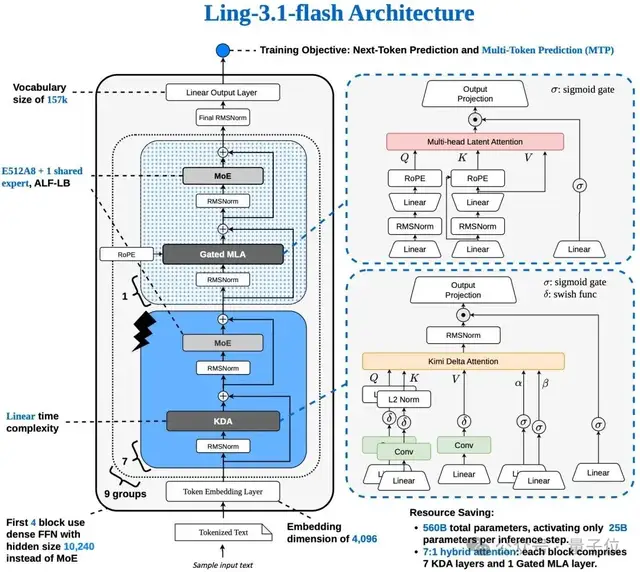
Das Modell besitzt etwa 560B Gesamtparameter, von denen pro Token etwa25Baktiviert werden. Unter Bewahrung der Wissenskapazität hat Ling-3.1-flash die pro Schritt tatsächlich an der Berechnung beteiligte Gewichtungsgröße reduziert.
Bei der Aufmerksamkeitsstruktur führt es die Architektur von Ling-3.0-flash fort und erhöht den Anteil anlinearer Attentionweiter.
Es verwendet einen Aufbau aus 7 KDA-Schichten in Kombination mit 1 Gated-MLA-Schicht, wobei KDA die Sequenzverarbeitung mit linearer Zeitkomplexität übernimmt; pro 8 Schichten bleibt 1 Gated-MLA-Schicht erhalten, um eine globale Aufmerksamkeitsverbindung aufrechtzuerhalten.
Das Kontextfenster des Modells kann maximal erreichen1M, kann mehr Dokumente, Code und historische Aufgaben auf einmal aufnehmen und reduziert den Aufwand für manuelles Aufteilen und wiederholtes Hin- und Herschieben von Informationen.
Gleichzeitig konfiguriert das Modell 512 Routing-Experten, von denen jedes Token 8 auswählt, und ruft gleichzeitig 1 gemeinsamen Experten auf.
Diese Art vonHybrides lineares Modell mit sparsamem MoEAnsatz, der nur ein einziges Ziel verfolgt: dass das Modell bei langanhaltender Ausführung keine Fehler macht und zugleich die Rechenleistung nicht ausbrennt.
Darüber hinaus arbeitet das Team aktiv daran, die Einstiegshürden für die Bereitstellung zu senken: Durch Quantisierung mit gemischter Präzision wurde der Speicherbedarf der Modellgewichte von etwavon 534 GB auf 292 GB reduziert, und in der entsprechenden Hopper-Testkonfiguration wurden die für die Bereitstellung erforderlichen GPUs vonvon 8 Karten auf 4 Karten reduziert。
Für konkrete Geschäftsanwendungsfälle bietet das Team außerdem eine Parallel-Inferenz-Lösung für lange Kontexte (PCP/DCP) an und stärkt zudem dieJSON Schemader Unterstützung, die es dem Modell erleichtert, lange Materialien zu verarbeiten und sich an bestehende Geschäftsschnittstellen anzubinden.
Abgesehen von der Architektur muss sich zeigen, ob es ein Maultier oder ein Pferd ist – das entscheidet letztlich ein echter Testdurchlauf in der Praxis.
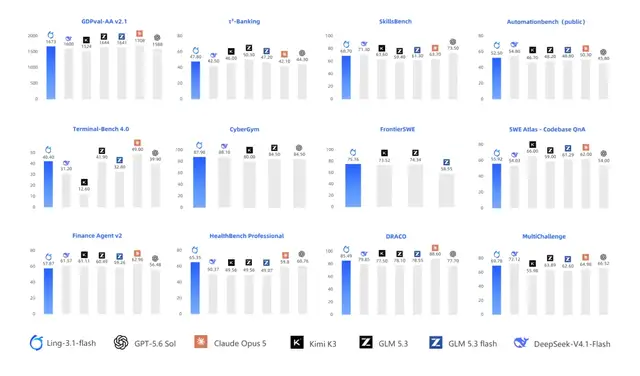
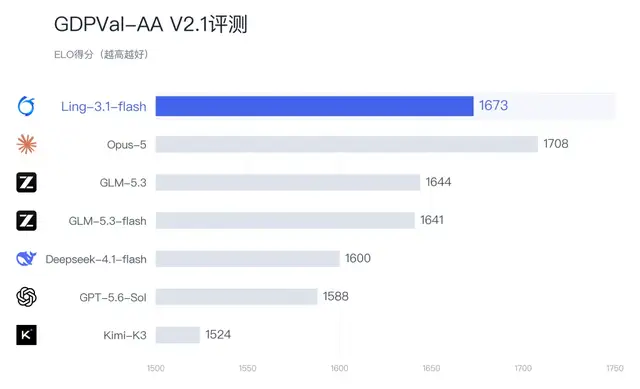
inBewertung von BüroaufgabenIn GDPVal-AA V2.1 erreicht Ling-3.1-flash einen ELO-Score von 1673 und zeigt damit Wettbewerbsfähigkeit bei der Bearbeitung mehrstufiger Arbeitsaufgaben.
Bildquelle: offizielles WeChat-Konto von Bailing
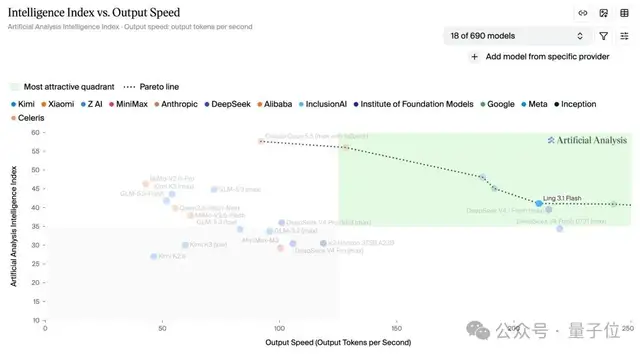
Gleichzeitig ergab der kürzlich veröffentlichte Test vonArtificial Analysis, dass Ling-3.1-flash einen Intelligenz-Index von 41 aufweist, eine Ausgabegeschwindigkeit von etwa 210 Token pro Sekunde erreicht und der gemischte Abrufpreis bei etwa 0,19 US-Dollar pro Million Token liegt – damit bietet es für Szenarien mit hoher Abrufhäufigkeit eine Option, die Intelligenzniveau, Generierungseffizienz und Abrufkosten miteinander vereint.
Im HealthBench Professional-Test im medizinischen Szenario behauptete sich Ling-3.1-flash ebenfalls relativ führend.Auch bei der HealthBench Professional-Bewertung unter [...] bleibt Ling-3.1-flash ebenfalls relativ in Führung.
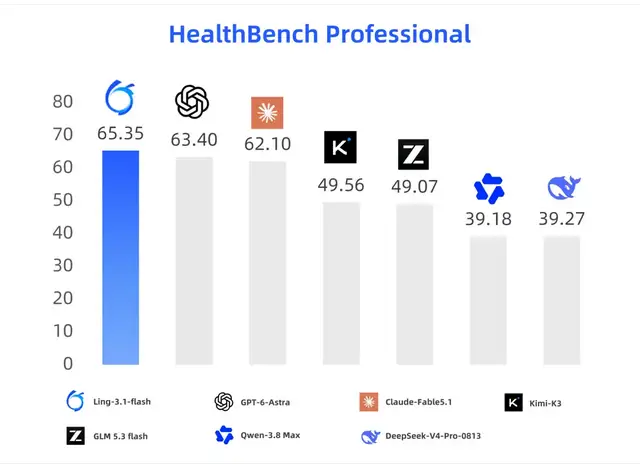
Darüber hinaus verfügt Ling-3.1-flash auch in Szenarien wie der Softwareentwicklung und Terminalbedienung über gewisse Fähigkeiten im Verstehen und Ausführen von Informationen.
Darüber hinaus verfügt Ling-3.1-flash auch in Szenarien wie der Softwareentwicklung und der Terminalbedienung über gewisse Fähigkeiten im Verstehen und in der Ausführung von Informationen.
Am Beispiel einer von Ant intern durchgeführten, lang andauernden Entwicklungsaufgabe für einen nativen Lua-Compiler: Der gesamte Prozess dauerte etwa 17 Stunden, in denen das Modell wiederholt entwickelte und korrigierte; die Bestehensquote der unabhängigen Tests betrug schließlich97.8%。
Praxistest von Ling-3.1-flash zeigt wahre Stärken
Der Praxistest von Ling-3.1-flash zeigt es deutlich
wahrseine Arbeit tatsächlich ist, legen wir direkt mit dem Praxistest los~
Für die erste Aufgabe nehmen wir zuerst eineDouble-11-E-Commerce-Aufgabeals Test, um es auszuprobieren.
Angenommen, du bist der E-Commerce-Verantwortliche des Aufbewahrungsmarken-Heimartiklers Ling. Anhand der Unterlagen musst du dem Chef einen Double-11-Aktionsplan für den Zeitraum vom 15. Oktober bis zum 11. November vorlegen, der direkt von den Teams für Betrieb, Content, Kundenservice und Lagerung weiter ausgeführt wird.
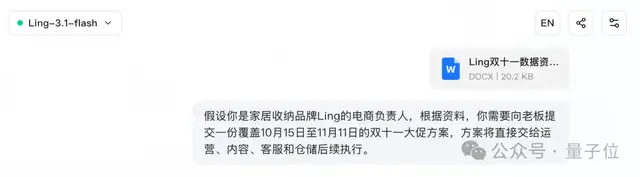
P.S. Die relevanten Datenunterlagen wurden mit Unterstützung von Codex generiert.
Nach Vorgabe der Geschäftsziele, Produktinformationen, Teamumstände und historischen Kanaldaten begann das Modell, die Unterlagen zügig zu sichten und den Aktionsplan zu entwerfen.
Zuerst führt das Modell eineMachbarkeitsbewertung der Ausgangsziele。
durch. Es hat sich die vom Chef aufgebaute Schimäre nicht direkt zu eigen gemacht, sondern unter frühzeitiger Erkennung von Einschränkungen wie nachlassender Grenzeffizienz der Werbung, Lagerbestand und Versandkapazität eine vergleichsweise realistische Schätzung für das Ausgangsziel abgegeben.
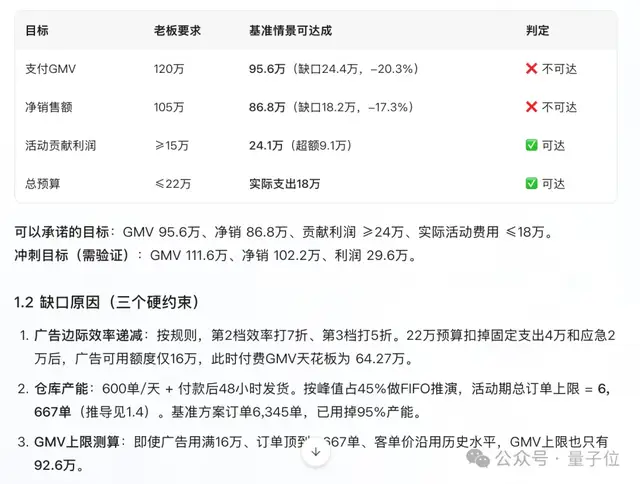
Gleichzeitig wurde auch ein entsprechenderAnpassungspfadangegeben, um abhängig Beschäftigten bei der Verteidigung gegenüber dem Chef zu helfen.
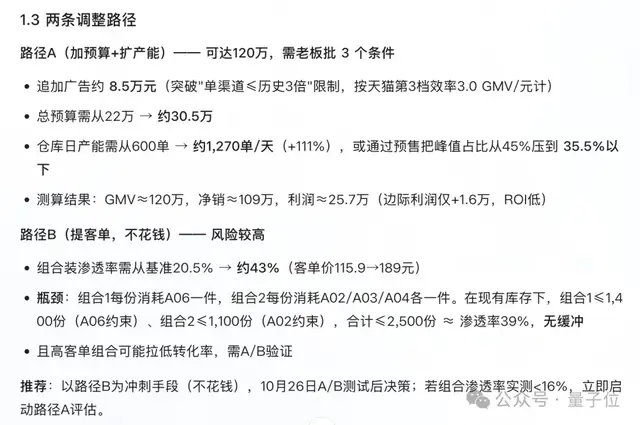
Betrachtet man das vom Modell erstellte Rabattkonzept für die Aktion, so halten die berechneten Schlüsselzahlen einerÜberprüfung durchaus stand。
Ob Produktkombinationstabelle oder detailliertes Kanalbudget – jede Zahl ist nachvollziehbar, was auf eine gewisse Datenanalysefähigkeit hindeutet.
Auch Ling-3.1-flash liefert detailliert einenphasenweisen Ausführungszeitplan, der sogar die jeweils erforderlichen Vorbedingungen für jede Phase umfasst.
Obwohl wir im Prompt nur den Aktionsplan bis zum Tag des Double 11 verlangt hatten, ergänzte das Modell eigenständig die nachfolgenden Schritte zur Nachbereitung und Gewinnberechnung.
Das ist wirklich herzlich und aufmerksam~
Auch dieTextausgabedes Modells ist ganz passabel, etwa diverse Call-to-Action-Formulierungen für Kurzvideos zur Kundenakquise oder Moderationsleitfäden für Livestreams – das sitzt einfach.
Bilder, Texte und Hooks sind komplett vorhanden – wir armen Arbeitspferde können die KI-Hausaufgaben einfach abschreiben, das spart Nerven und Mühe.
Abschließend führt das Modell sogar eigenständig eineKonsistenzprüfungdurch und kennzeichnet ausdrücklich, welche Daten noch vom Nutzer geprüft und welche Inhalte vom Nutzer bestätigt werden müssen – die Kontrolle über die endgültige Umsetzung des Plans bleibt letztlich stets in den Händen des Nutzers.
Neben der täglichen Büroarbeit istder medizinische Gesundheitsbereichauch eine Stärke von Ling-3.1-flash.
Wir geben dem Modell fiktive Blutwertdaten und eine vage Beschreibung der Symptome und möchten, dass es ein Kommunikationsblatt für den Arztbesuch erstellt.
Bei unzureichenden Informationentrifft Ling-3.1-flash keine direkte Beurteilung, sondern listet zunächst die Details auf, die der Nutzer ergänzen muss, und unterscheidet dann zwischen bekannten Fakten, unsicheren Punkten und Fragen an den Arzt.
Bei derAnleitungder Nutzer zur Ergänzung wichtiger Informationen gleicht es die neuen Inhalte mit den ursprünglichen ab und gelangt so zu einer professionelleren Konsultationsreferenz.
Bemerkenswert ist, dass das Modell im Denkprozess stets dasRote-Linie-Warnprinzipbetont: Es erinnert die Nutzer laufend daran, Veränderungen ihres Gesundheitszustands zu beachten und rechtzeitig ärztliche Hilfe aufzusuchen, und gibt keine expliziten Medikamentenanleitungen.
Im Verlauf dieses Prozesses übernimmt es eher die vorbereitende Unterstützungsarbeit für den Arzt.
Allerdings weist Ling-3.1-flash auch einige kleine Bugs auf: Wenn man dem Modell auf einen Schlag einen langen Textblock vorsetzt,verliert die Aufmerksamkeit des Modells manchmal die Richtung。
So ist etwa ein Double-Eleven-Großaktion-Konzept an sich eine sehr komplexe und langwierige Aufgabe; hier empfiehlt es sich eher, schrittweise zu liefern, etwa zuerst die Daten mit einem Skript aufzubereiten und dann das Konzept zu erstellen – also Schritt für Schritt vorzugehen.
Auch bei der Ein-Satz-Generierung gibt es AnpassungsgrenzenWenn das aktuelle Ergebnis nicht zufriedenstellend ist, ist es für Nutzer oft effizienter, den Umsetzungsgedanken und die Liefer-Spezifikation erneut zu präzisieren, als weiter aufs Glück zu setzen.
Und dieaktuelle Version verfügt über kein natives visuelles Verständnis, weshalb man selbst ein vorgeschaltetes visuelles Modell zur Verarbeitung benötigt; die Kosten des gesamten Prozesses steigen dadurch ebenfalls.
Insgesamt hängt es von der Aufgabe ab, ob das Modell brauchbare Ergebnisse erzielen kann.
Bailing dringt als Erster in echte Aufgabenströme vor
Nachdem wir das Modell selbst besprochen haben, lohnt sich ein Blick zurück aufBailing: Es trifft tatsächlich präzise die Schwachstellen der Branche.
In diesem Jahr dreht sich im Kreis der großen Modelle fast alles um Coding und Ranglisten.
Doch wenn das Getümmel einen gewissen Grad erreicht, stellen immer mehr Menschen eine grundlegendere Frage: Ist Coding die einzige Prüfungskammer für AGI?
Die Einschätzung von Bailing-Leiter Xiting auf der Bund-Konferenz lautet:Coding ist nicht die einzige Prüfungskammer。
Seiner Ansicht nach zielt Bailing weiterhin darauf ab, Aufgaben der realen Welt zu bedienen und die Modellfähigkeiten von der technischen Ebene zu lösen, umdie Modelle anhand echter Aufgaben zu bewerten。
Deshalb hat Bailing die 3.0-Serienmodelle genau in die zwei Bereiche platziert, in denen Fehler am wenigsten verzeihbar sind:Finanzen und Gesundheitswesen。
LingFinist ein Finanzmodell mit hoher Intelligenz-Effizienz, das die Effizienz im Finanzwesen ausgehend von der Branchenanalyse neu strukturiert; das Modell für medizinische GesundheitsversorgungLingSantehingegen erkundet medizinisches Wissens-Raisonnement, evidenzbasierte Suche und Standardabläufe.
Dabei bringt Ling-3.0-flash-Fin (124B Gesamtparameter, 5.1B aktiviert) KI in echte Arbeitsabläufe der Investitionsforschung und verbindet die komplette Aufgabenkette von der Recherche über die Analyse bis zur Erstellung von Forschungsergebnissen.
In anspruchsvollen Aufgaben der Investitionsforschung spielt es in der Liga der 3T-Frontier-Modelle, die Gesamtleistung des Finanz-Agents liegt bei Open Source in Führung, und bei Schlüsselaufgaben hält es mit Frontier-Modellen wie GPT-5.4 mit.
Ling-3.0-flash-Sante bringt die hohe Intelligenz-Effizienz in medizinische Szenarien und erreicht mit 124B Parametern die beste Leistung unter Modellen unter 1.6T,die Gesamtleistung ist mit mehreren Flaggschiff-Modellen vergleichbar。
Bildquelle: offizielles WeChat-Konto von Bailing
Verglichen mit den Basismodellen handelt es sich hierbei nicht um einfache Branchen-Finetunings, sondern darum, die Modelle wirklich in komplexe Arbeitsumgebungen zu integrieren und kontinuierlich zu verfeinern und zu prüfen.
Auf einer größeren Ebene tut Bailing noch etwas Branchenführendes: Sie definiert den Begriff„Effizienz“neu.
Bisher sprach die Branche stets von derRechen-Effizienz, also davon, wie viel Rechenleistung verbraucht wurde und wie hoch die Effizienz ist.
Bailing verknüpfte als Erste Recheneffizienz, Parameter-Effizienz und Token-Effizienz miteinander und betont dieIntelligenz-Effizienz。
der Modelle – dieser Begriff fand schnell Widerhall in der Branche: Auch Anthropic und OpenAI haben in den letzten sechs Monaten nach und nach spezialisierte Fähigkeiten für Finanzen und Gesundheitswesen vorgestellt.
So hat Anthropic im letzten MonatClaude for Financial Advisorsvorgestellt, das Konnektoren und Aufgaben-Skills um konkrete Arbeitsaufgaben herum organisiert – auch dies eine weitere Form der Einbindung professioneller Abläufe.
Zugegebenermaßen lässt sich über den Ausgang dieses Richtungsstreits noch lange nicht sprechen, doch„das Eintreten in echte Arbeitsabläufe“entwickelt sich von der Entscheidung eines einzelnen Unternehmens zu einem Branchentrend.
Auch dieses Jahr ist für Bailing ein entscheidendes Jahr auf dem Weg von der Modellfähigkeit zum Aufgabenwert.
Durch Ling-3.1-flash ist Bailings weiterer Weg bereits vorgezeichnet:
Nach oben, um die Leistungsobergrenze von Agents für Entwickler weiter anzuheben;nach unten, um die Nutzungshürde für gewöhnliche Nutzer weiter zu senken und das bessere Intelligenz-Effizienz-Verhältnis in echte Problemlösungsfähigkeit umzuwandeln;nach außen, um die fachliche Spezialisierung der Modelle weiter zu vertiefen und im echten Durchbruch zu ermöglichen.
Es ist erkennbar, dass die Art und Weise, wie sich Modelle beweisen, gerade den Gang wechselt, doch alles hat gerade erst begonnen.
Ling Studio:
https://ling.tbox.cn
OpenRouter:
https://openrouter.ai/inclusionai/ling-3.1-flash
HuggingFace:
https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope:
https://modelscope.cn/models/inclusionAI/Ling-3.1-flash