
IT之家 Meldung vom 16. Oktober: Ant Bailing kündigte gestern die Open-Source-Veröffentlichung des Modells Ling-3.1-flash an. Ling-3.1-flash hat insgesamt etwa 560B Parameter, wobei pro Token etwa 25B aktiviert werden, und unterstützt Kontexte von bis zu 1M.
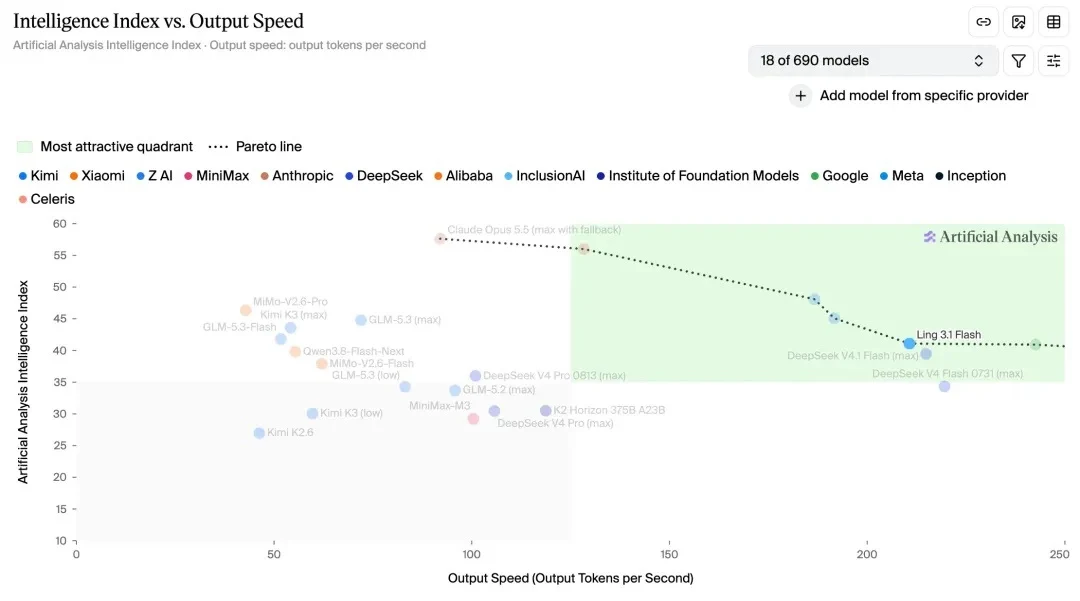
In den öffentlichen Bewertungen von Artificial Analysis erreichte Ling-3.1-flash einen Intelligenzindex von 41 und eine Ausgabegeschwindigkeit von etwa 210 Token pro Sekunde.
Für die lokale Bereitstellung quantisierte das Team die routed experts mit MXFP4, während die dense-Schichten in block-FP8 verbleiben; der Speicherbedarf der Gewichte sank von etwa 534GB auf 292GB. In der entsprechenden Hopper-GPU-Testkonfiguration sank die Dienstbereitstellung von 8 Karten auf 4 Karten, sodass Teams mit Server-GPUs das Modell mit weniger Karten betreiben können; der tatsächliche Bedarf variiert jedoch je nach Kontext, Parallelität und Dienstkonfiguration.
Für die Verarbeitung langer Materialien bietet das Team eine Parallel-Inferenzlösung für lange Kontexte (PCP / DCP); Tool-Aufrufe unterstützen nun besser JSON Schema, was die Anbindung an bestehende Geschäftsschnittstellen erleichtert.
Unternehmens-Wissensfragen und Büroassistenten müssen häufig zuerst längere Materialien lesen, während die Nutzer dennoch schnell eine Antwort sehen möchten. Das Team reduziert den Inferenzaufwand durch Operator-Fusion und DSpark Speculative Decoding: In simulierten Produktionsanfragen mit durchschnittlich etwa 25.47K Token Eingabe, etwa 224 Token Ausgabe und einer Cache-Trefferquote von 76%,in der 8-Karten-Hopper-Konfiguration betrug die durchschnittliche Zeit bis zum ersten Token 604 Millisekunden, und der durchschnittliche Abstand zwischen aufeinanderfolgenden Ausgabe-Token betrug 3.28 Millisekunden. Dies liefert einen Testreferenzwert für die interaktive Reaktion nach der Eingabe langer Materialien.
Bei Geschäftssystemen, die kontinuierlich Dienste bereitstellen, muss außerdem bewertet werden, wie viele Anfragen eine einzelne Instanz innerhalb eines festen GPU-Budgets bewältigen kann. Bei einer durchschnittlichen Eingabe von etwa 8.5K Token und einer Ausgabe von etwa 800 Token im 4 Hopper-Karten mit durchschnittlich etwa 8.5K Token Eingabe und etwa 800 Token Ausgabe erreichte das Modell etwa 1.36 QPSund erfüllte gleichzeitig die Testbedingungen, dass die Zeit bis zum ersten Token bei P50 unter 3 Sekunden und der Abstand zwischen aufeinanderfolgenden Ausgabe-Token bei P90 unter 70 Millisekunden liegt. Dies dient als Referenz für die Kapazitätsplanung eigener Bereitstellungen.
Zum Online-Erlebnis: Für Ling-3.1-flash gilt derzeit ein zeitlich begrenzter Rabatt von 2.5 折 (75% Rabatt), die Preise nach Rabatt lauten wie folgt:
OpenRouter(Preise in USD): Eingabe 0.075 USD; Ausgabe 0.225 USD; Cache-Lesezugriff 0.015 USD.
Ling Studio(Preise in CNY): Eingabe 0.5 Yuan; Ausgabe 1.5 Yuan; Cache-Lesezugriff 0.1 Yuan.
IT之家 fügt den Open-Source-Link an:
Hugging Face:https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope:https://modelscope.cn/models/inclusionAI/Ling-3.1-flash
Verwandte Lektüre:
Werbehinweis: Die im Artikel enthaltenen externen Weiterleitungslinks (einschließlich, aber nicht beschränkt auf Hyperlinks, QR-Codes, Passwörter usw.) dienen der Weitergabe weiterer Informationen und der Einsparung von Auswahlzeit; die Ergebnisse dienen nur als Referenz. Alle Artikel von IT之家 mit externen Links enthalten diesen Hinweis.