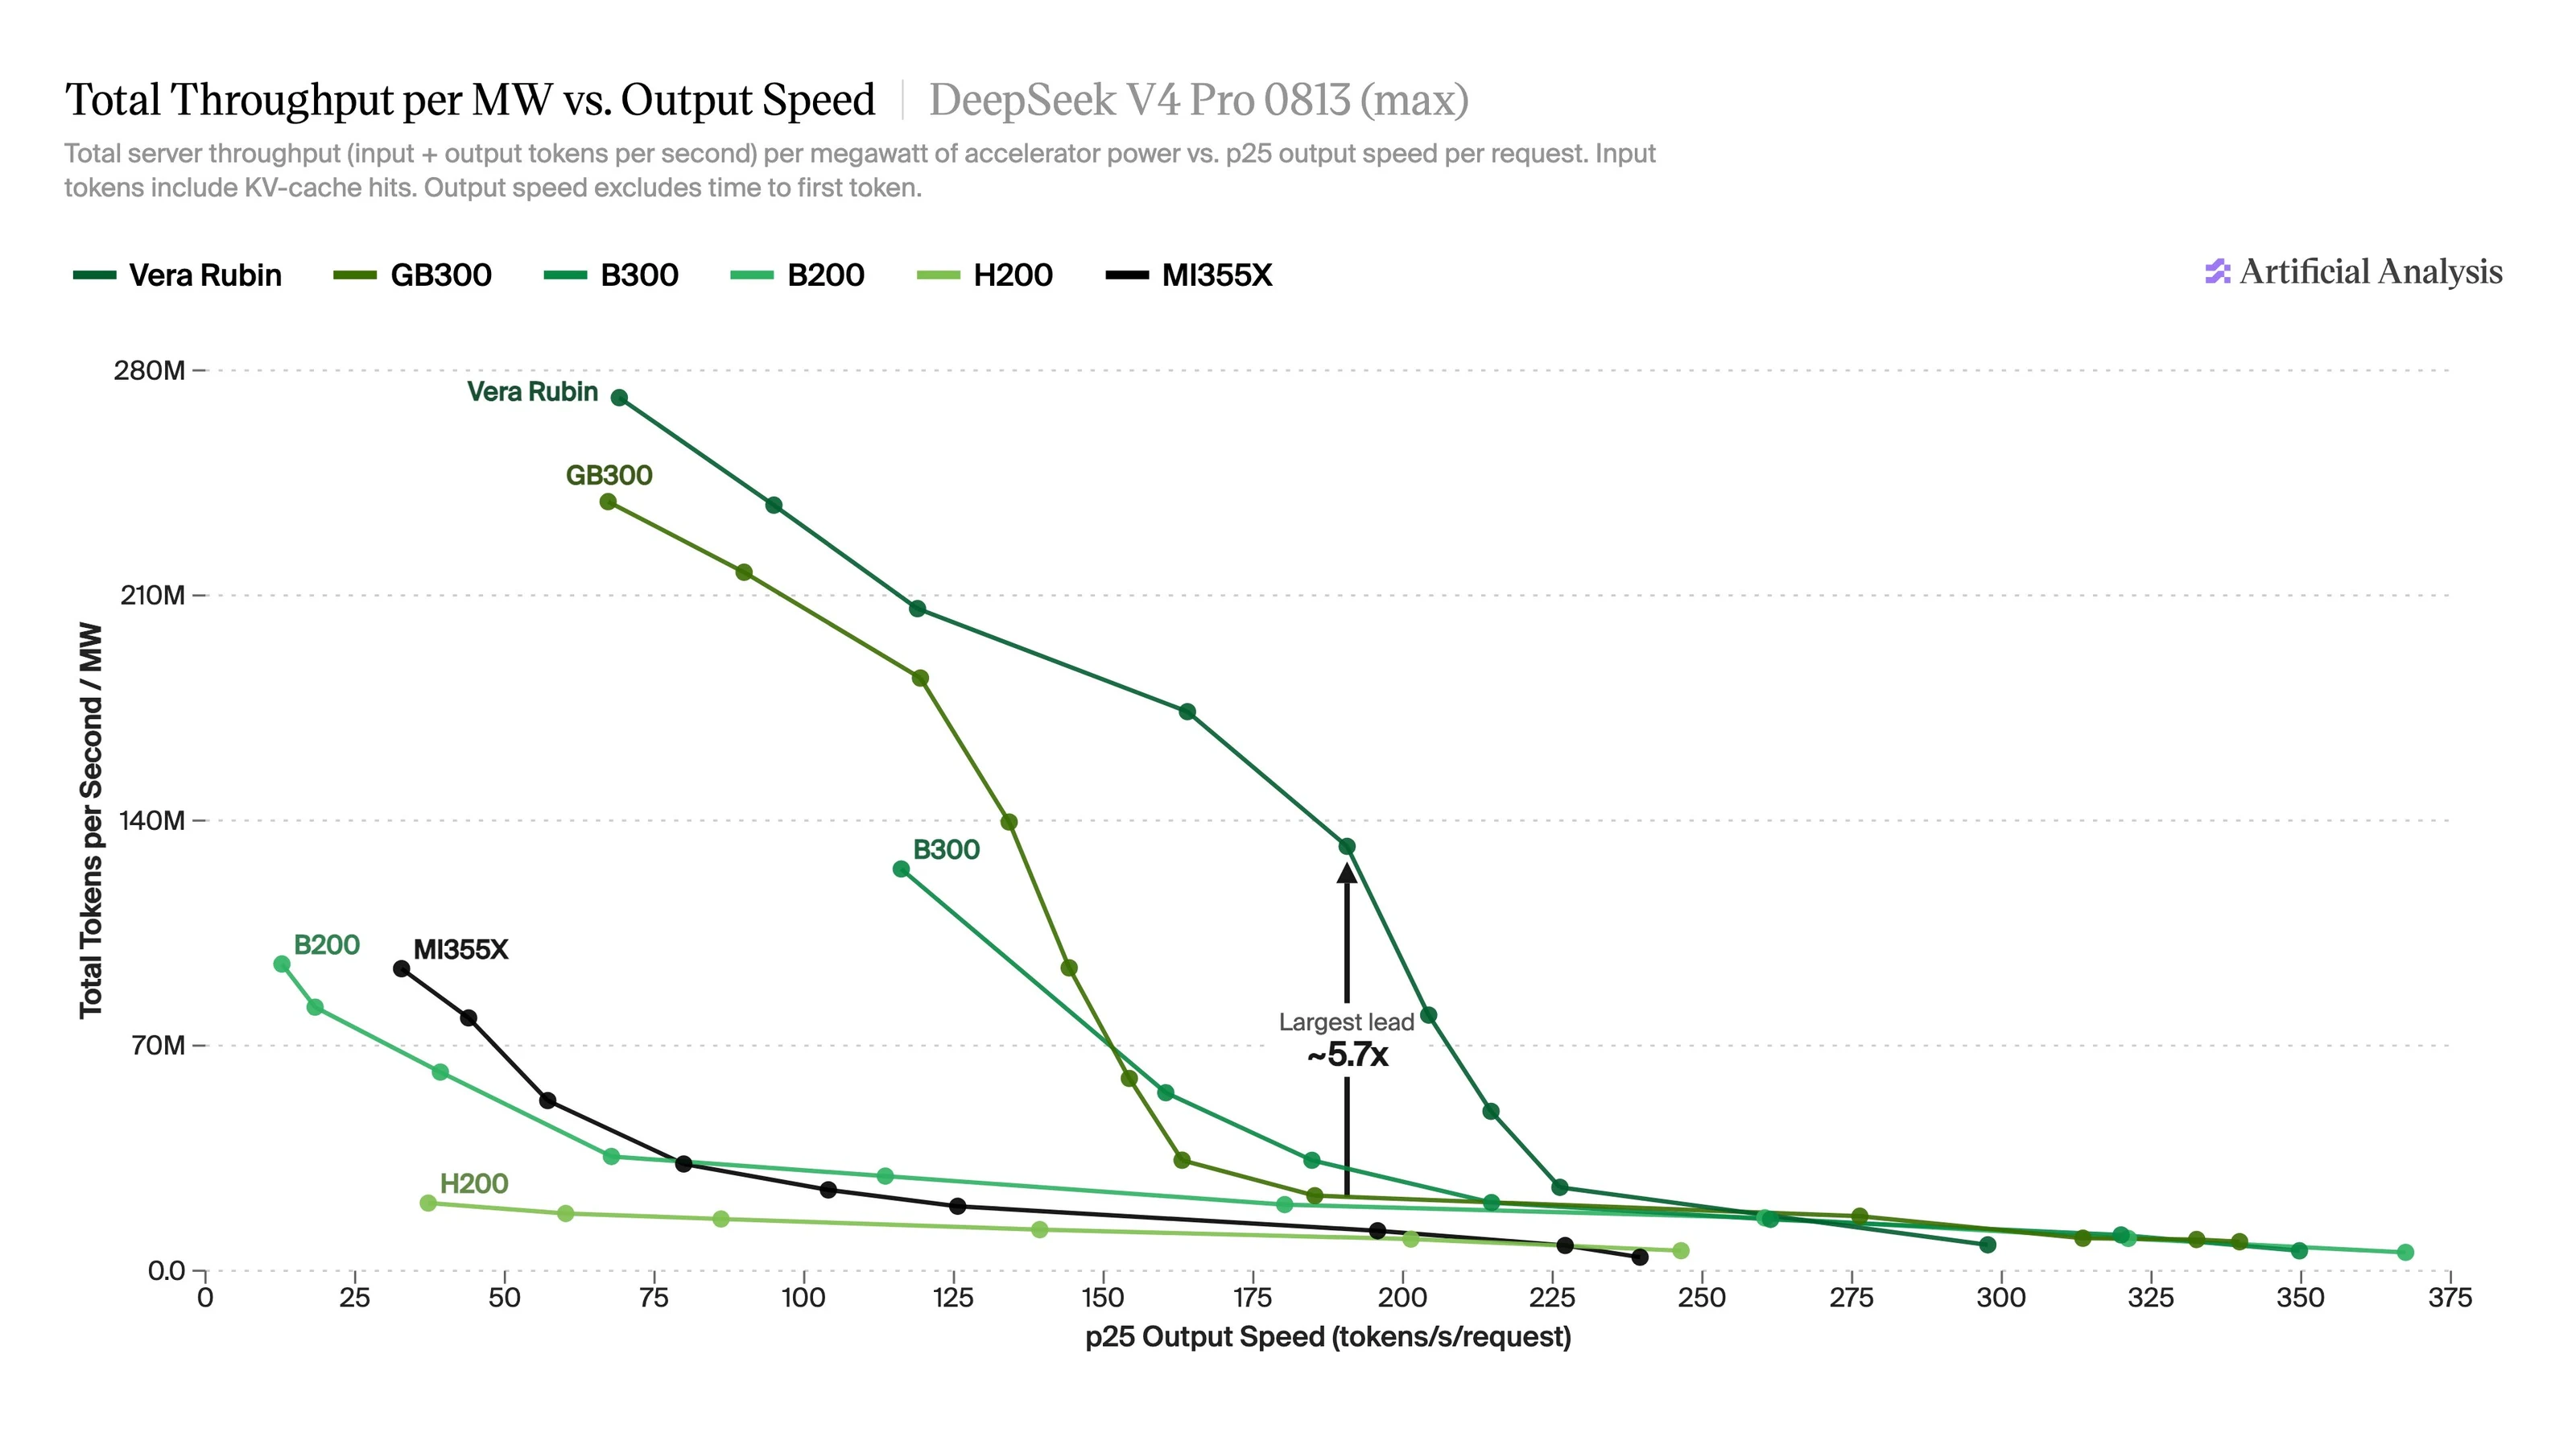
Die Anfangsergebnisse für NVIDIAS Vera Rubin NVL72 sind jetzt auf AA-AgentPerf verfügbar, mit bis zu ~5,7-mal mehr Gesamtanwendungsgeschwindigkeit pro Megawatt als das Vorgängermodell GB300 NVL72 auf DeepSeek V4 Pro, ~5,4-mal mehr auf DeepSeek V4.1 Flash, ~3,0-mal mehr auf GLM-5.2 und ~2,8-mal mehr auf Kimi K3
Vera Rubin ist NVIDIAs Nachfolgerin von Blackwell, und Vera Rubin NVL72 ist ihr Rack-System mit 72 Rubin-GPUs und 36 Vera-CPUs. Jeder Rubin-GPU verfügt über die gleichen 288 GB an Speicher wie Blackwell Ultra, aber mit 2,4-mal mehr Speicherbandbreite, 1,7-mal mehr NVLink-Bandbreite und 2,3-mal mehr Dichte durch NVFP4-Rechenleistung. NVIDIA hat alle Ergebnisse von Vera Rubin eingereicht, die mit TensorRT-LLM und vLLM unter NVIDIA Dynamo ausgeführt wurden.
AA-AgentPerf ist unser Benchmark für die Leistung von Agenten. Er wiederholt echte Agenten-Programmiersitzungen, einschließlich langen gespeicherten Kontexten und Verzögerungen bei Toolanrufen, um eine realistische Messung der Leistung bei täglichen Agentenarbeiten zu ermöglichen. Wir messen den Gesamtsystemdurchsatz pro Megawatt der gemessenen GPU-Leistung sowie die Ausgabengeschwindigkeit pro Agent (p25 bei allen Anfragen) bei unterschiedlichen Konkurrenzniveaus, um den Widerspruch zwischen Systemnutzung und individuellem Benutzer-Erlebnis zu zeigen.
Anfängliche Ergebnisse:
➤ Der Leitwert von Vera Rubin ist am größten bei höheren Geschwindigkeiten pro Benutzer, wobei der Durchsatz von GB300 nachlässt. Auf dem DeepSeek V4 Pro kostet die Umstellung von ~120 auf ~165 tok/s pro Benutzer für GB300 81% seines Durchsatzes pro MW, im Vergleich zu 16% für Vera Rubin
➤ Bei maximaler Durchsatz sind die beiden Systeme näher beieinander: Bei Vera Rubin beträgt die Leistung 272M Tokens/s pro MW auf DeepSeek V4 Pro, während es bei GB300 239M Tokens/s beträgt (1,14x). Auf DeepSeek V4.1 Flash liegt die Leistung bei 571M Tokens/s, gegenüber 395M Tokens/s (1,45x). Bei GLM-5.2 beträgt die Leistung 272M Tokens/s, gegenüber 201M Tokens/s (1,35x), und bei Kimi K3 70M Tokens/s, gegenüber 56M Tokens/s (1,26x). Wir erwarten, dass der Unterschied zwischen den Systemen zunimmt, da die Kernels von Vera Rubin und andere Serversoftware optimiert werden.
➤ Vera Rubin setzt die schnellsten Geschwindigkeiten pro Benutzer auf unserer Rangliste für DeepSeek V4.1 Flash (906 tok/s, das schnellste Ergebnis für jedes Modell), GLM-5.2 (408 tok/s) und Kimi K3 (255 tok/s).
Glückwunsch @nvidia zu den starken Ergebnissen!
Lesen Sie die vollständige Analyse: https://artificialanalysis.ai/articles/vera-rubin-nvl72-agentperf