
Blick hinter die Kulissen der Kimi-K3-Optimierung: die Engpässe verstehen und die Entscheidungen nachvollziehen, die die Inferenz beschleunigt haben
In diesem Artikel- AgentX: Arbeitslast und Ergebnisse
- Im Inneren von Kimi K3: Experten, Attention und rezurrenter Zustand
- 1. Cache: Konversationszustand zur Wiederverwendung verfügbar halten
- 2. MoE: doppelte Arbeit über GPUs hinweg entfernen
- 3. Speicherverkehr: Operationen fusionieren und unnötige Kopien entfernen
- 4. MLA: schnelleres Long-Context-Decoding mit AMD-AITER-Assembly
- 5. KDA: Prefill und spekulative Verifikation parallelisieren
- 6. Spekulatives Decoding: festlegen, wie viele Tokens entworfen werden
- Was als Nächstes optimiert werden sollte
- Beiträge und Danksagungen
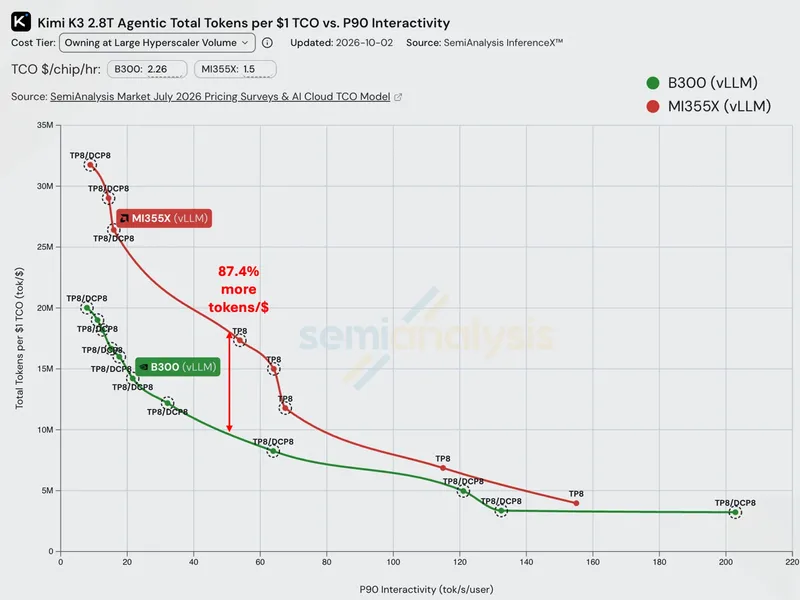
Auf AgentX liefert ein AMD-Instinct-MI355X-System mit acht GPUs, das Kimi K3 mit vLLM bedient, 24.4% mehr Tokens pro Sekunde insgesamt pro GPU als NVIDIA HGX B300 bei 50 Tokens/s/User P90-Interaktivität. Nach dem Total-Cost-of-Ownership-Modell des Benchmarks liefert es 87.4% mehr Tokens pro Dollar.
In diesem Beitrag schlüsseln wir die Technik hinter Kimi K3 auf AMD Instinct MI355X auf und verbinden die Serving-Entscheidungen von vLLM mit den GPU-Kernels und der darunterliegenden Hardware. Wir erklären, warum die Optimierungen funktioniert haben, und entwickeln das Verständnis, um verschwendete Arbeit zu erkennen, Engpässe zu identifizieren und die nächste Optimierung in Ihrem eigenen Inferenz-Stack zu finden.
Interaktivität ist der Kehrwert der P90-Antwort-Inter-Token-Latenz und schließt die Zeit bis zum ersten Token aus. Die Gesamtzahl der Tokens umfasst wiederverwendete Eingaben und generierte Ausgaben.
Quelle: SemiAnalysis InferenceX, Snapshot vom 9. Oktober 2026. Vergleichskonfigurationen.
Die publizierten Peak-Werte der Dense-Matrix betragen 10.1 PFLOP/s MXFP4 für AMD Instinct MI355X und 13.5 PFLOP/s FP4 für NVIDIA B300. Beide verfügen über 288 GB HBM3E und 8 TB/s SpitzenSpeicherbandbreite. Das Erreichen dieser Serving-Leistung spiegelt kontinuierliche Software-Engineering-Arbeit von AMD und Mitarbeitern aus der vLLM-Community wider.
AgentX: Arbeitslast und Ergebnisse
Der öffentliche AgentX -Benchmark spielt reale Coding-Agent-Sitzungsverläufe mit synthetischen Tokens ab und behält Anfragelängen, Timing- und Prefix-Sharing-Muster bei. Die Arbeitslast bietet über 96% theoretische Prefix-Wiederverwendung bei unbegrenztem Cache. Spekulative Läufe verwenden eine feste synthetische Akzeptanz-Referenz.
At 50 Token/s/Benutzer P90-Interaktivität, der AMD Instinct MI355X liefert ungefähr 7,567 Gesamt-Tokens/s/GPU, verglichen mit 6,083 beim NVIDIA HGX B300, ein 24.4%-Durchsatzvorteil. Unter Verwendung des von SemiAnalysis modellierten TCO von $1.50 gegenüber $2.26 pro GPU-Stundebeziehungsweise entspricht das 18.16 Millionen gegenüber 9.69 Millionen Gesamt-Tokens pro Dollar TCO: 87.4% mehr Tokens pro Dollar.
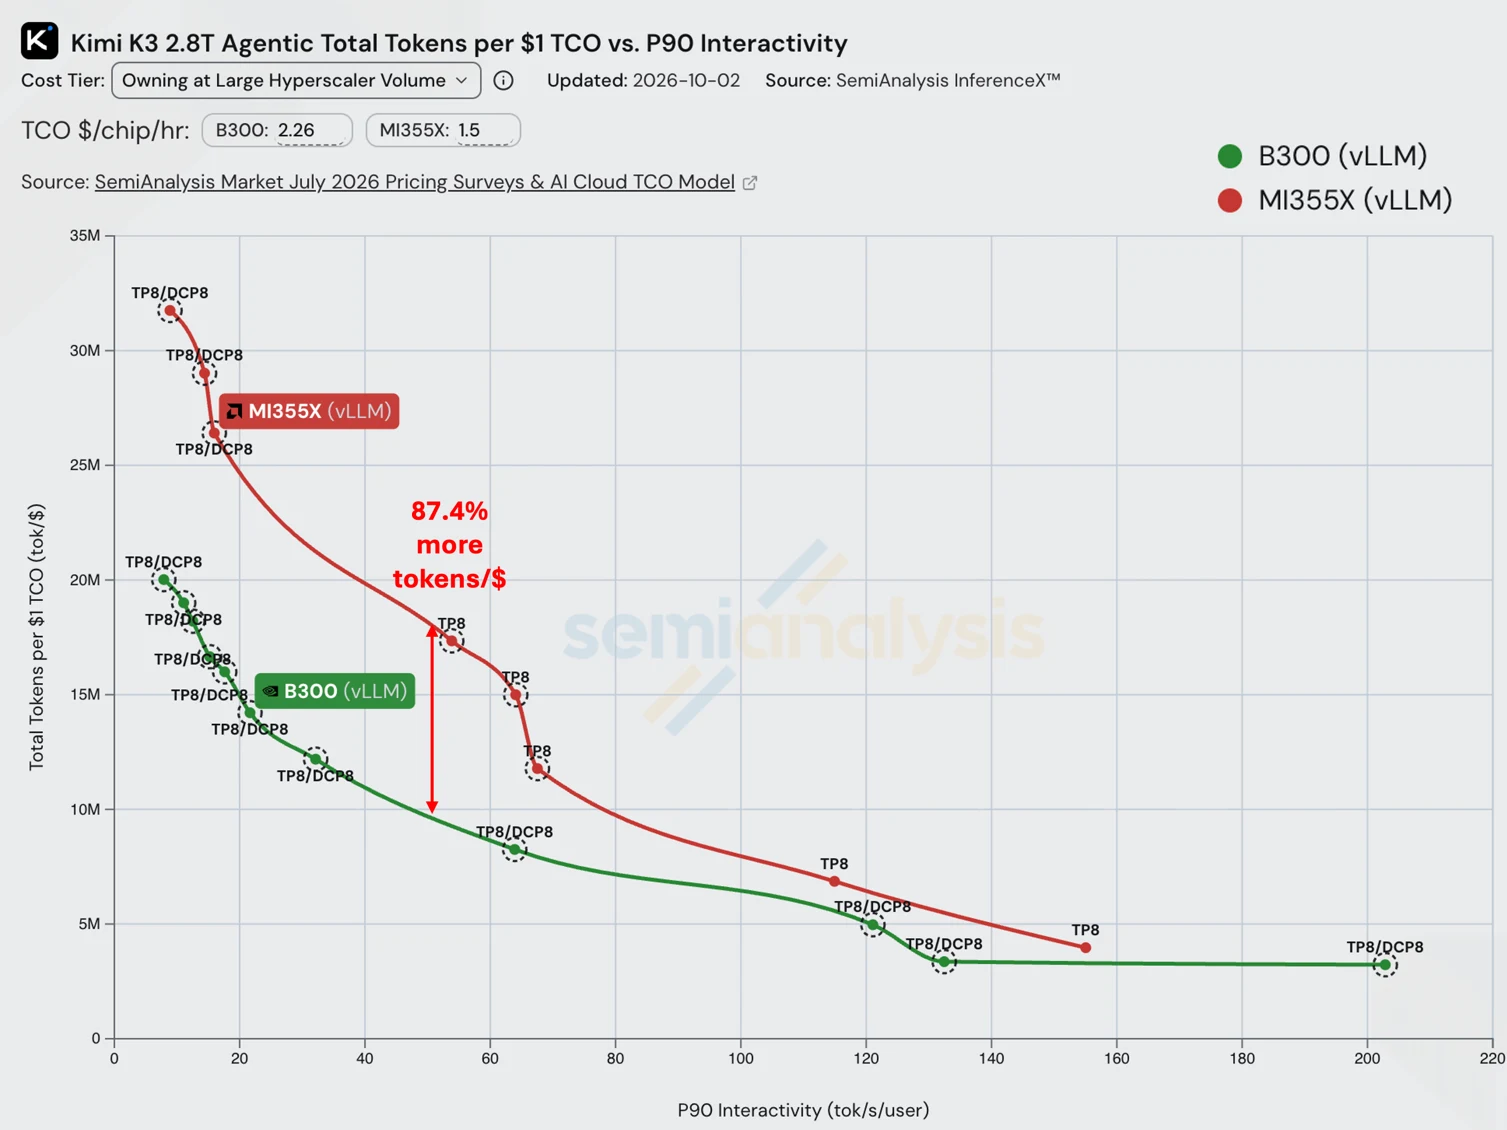
SemiAnalysis InferenceX öffentliche Kurven, mit der 50-Token/s/Benutzer-Zielmarke als Beschriftung. Benchmark-Hinweise.
Die öffentlichen Kurven vergleichen vollständige Serving-Stacks. Die Messungen neben jeder Optimierung stammen aus separaten Tests und erklären einzelne Mechanismen unter ihren angegebenen Konfigurationen.
In Kimi K3: Experten, Aufmerksamkeit und rekurrenter Zustand
Ein wiederkehrender Agenten-Zug kann den größten Teil seines Präfixes wiederverwenden, aber die Verarbeitung einer kurzen Fortsetzung berührt dennoch drei Arten von Daten.
Kimi K3 verwendet zwei Arten von Attention. Seine 24 MLA-Schichten behalten einen komprimierten KV-Verlauf, der mit dem Gespräch wächst. Eine neue Abfrage konsultiert diesen Verlauf weiterhin. Seine 69 KDA-Schichten führen stattdessen Zustandsmatrizen mit festen Dimensionen fort und aktualisieren sie, sobald neue Token eintreffen. Modellkonfiguration.
In MoE-Schichten wählt ein Router Expertennetzwerke aus, um jedes Token zu transformieren. Ihre Gewichte werden anfragenübergreifend geteilt.
MLA behält mehr Verlauf bei, während das Gespräch wächst. KDA aktualisiert einen Zustand mit fester Dimension; das Zurückbehalten früherer Checkpoints bedeutet, zusätzliche Kopien dieses Zustands zu speichern.
Über mehrere Züge hinweg: Cache-Wiederverwendung und Offloading (Abschnitt 1).
Innerhalb eines Modellschritts: Expertprojektionen, Kernel-Übergaben und MLA/KDA-Scheduling (Abschnitte 2–5).
Wahl der Draft-Tiefe: festgeschriebene Ausgabe versus Kosten eines vollständigen Zyklus (Abschnitt 6).
1. Cache: Gesprächszustand zur Wiederverwendung verfügbar halten
DCP reduziert doppelten Verlauf im GPU-Speicher; CPU-Offloading bewahrt wiederverwendbaren Zustand außerhalb davon auf.
DCP: den Verlauf über GPUs hinweg teilen
Unter TP8 verarbeitet jede GPU 12 der 96 MLA-Query-Köpfe von Kimi K3, speichert jedoch den gesamten komprimierten KV-Verlauf. Tensor-Parallelismus teilt die Köpfe, ohne den Cache zu teilen.
Mit achtfachem Decode-Context-Parallelismus (DCP8)speichert jede GPU ein Achtel der zwischengespeicherten Positionen. Während des Dekodierens tauschen die GPUs Abfragen aus, berechnen gegen ihren lokalen Verlauf und führen ihre Teilergebnisse zusammen.
Zwei GPUs veranschaulichen dieselbe Partition, die von TP8/DCP8 verwendet wird. Diese zusätzliche Aufteilung gilt für den MLA-Verlauf; der KDA-Zustand behält seine bestehende Partition über die Köpfe hinweg.
Jedes Teilergebnis trägt Normalisierungsinformationen, damit die Zusammenführung die Shards korrekt gewichten kann. #51705 erweitert den ROCm-AITER-DCP-Pfad auf Multi-Token-Verifizierung.
Für eine Konversation mit 142,000 Tokens beträgt die geschätzte MLA-Nutzlast 24 Layer × 142,000 Positionen × 576 FP8 Bytes ≈ 1.96 GB pro GPU. DCP8 reduziert diese auf etwa 245 MB, vor Allokations-Overhead. Jede GPU verarbeitet achtmal so viele Köpfe gegen ein Achtel des Verlaufs, wodurch die führende Attention-Arithmetik im Wesentlichen unverändert bleibt.
CPU-Offloading: Zustand aufbewahren, der nicht mehr in den HBM passt
Wenn der Zustand nicht mehr in den GPU-Speicher passt, bewahrt das native vLLM-CPU-Offloading der AMD-Rezepturden MLA-Verlauf und KDA-Checkpoints im Host-DRAM auf.
Ein Cache-Treffer erfordert übereinstimmende Wiederaufsetzpunkte. Wenn der MLA-Verlauf Token 3,072 erreicht, der neueste kompatible KDA-Checkpoint aber bei 2,048 liegt, muss die Anfrage bei 2,048 fortsetzen und das verbleibende Präfix neu berechnen.
Ein brauchbarer Wiederaufsetzpunkt benötigt kompatiblen Zustand über alle erforderlichen Layer hinweg. Die Positionen sind illustrativ.
Das Speichern des Attention-Block-Schwanzes zusammen mit dem KDA-Checkpoint bringt ihre Wiederaufsetzpositionen in Übereinstimmung (#54736). Die Wiederherstellung dieses Zustands tauscht eine Übertragung zurück zur GPU gegen eine vermiedene Präfix-Neuberechnung. Sobald eine Anfrage fortgesetzt wird, können ihre neuen Tokens dennoch mehrere GPUs dieselbe Berechnung wiederholen lassen.
2. MoE: doppelte Arbeit über GPUs hinweg entfernen
Auf einer einzigen GPU gibt die Routed-Expert-Ausgabeprojektion den vollständigen Vektor zurück, den ihr Konsument erwartet. Im ursprünglichen ROCm-Pfad gaben eine frühere Reduktion und Normalisierung allen acht GPUs dieselbe latente Eingabe, und jede hielt die vollständigen Gewichte. Dieselbe Projektion lief daher achtmal.
Die Ausgabekoordinaten können auf die GPUs verteilt werden, aber jeder Rank benötigt weiterhin das vollständige Ergebnis. Kimi K3 hat bereits ein All-Reduce für seine Shared-Expert-Partialwerte.
Jede GPU fügt nur die von ihr besessenen Routed-Ausgaben zu ihrem Shared-Expert-Partialwert hinzu. Das vorhandene All-Reduce setzt das vollständige Ergebnis zusammen, ohne ein neues kollektives Element (#51253). Die ROCm-Implementierung baut auf der entsprechenden CUDA-Strategie auf.
Zwei GPUs veranschaulichen die Zuständigkeit für Ausgabekoordinaten. Beide Pfade verwenden ein vorhandenes All-Reduce und liefern jeder GPU dasselbe vollständige Ergebnis.
Jede Ausgabekoordinate erhält ihren Routed-Beitrag genau einmal. Die vollständigen Projektionsgewichte bleiben repliziert.
Der Ausgabedurchsatz stieg in dem PR-Test auf acht AMD Instinct MI355X GPUs bei TP8 um 3.05–4.91%, über Nebenläufigkeit 8–128 mit zufälligen 8K-Eingabe-/1K-Ausgabe-Anfragen und deaktiviertem Präfix-Caching.
GPU-Speicher freigeben, um mehr zwischengespeicherten Zustand zu halten
Jeder Rank berechnet jetzt nur seine zugewiesenen Projektkoordinaten, während er die vollständigen Gewichte behält.
Das Laden nur derjenigen Zeilen, die jeder Rang tatsächlich verwendet, gibt etwa 3.85 GiB pro GPU über 92 MoE-Layer bei TP8 frei (#59591). Die Berechnung des fused-Pfads bleibt gleich; der zusätzliche Platz kann MLA-History und KDA-Checkpoints aufnehmen.
Diese Änderung landete nach dem Image, das für das öffentliche Headline-Ergebnis verwendet wurde. Ein separates AgentX-Experiment fand weniger als 1 % höheren Durchsatz bei Concurrency 32 und 48, aber 28.9 % bei 70, wobei die berichtete Prefix-Cache-Hit-Rate von 74.8 % auf 80.1 % stieg.
Separate #59591-Messungen: acht AMD Instinct MI355X GPUs, TP8/DCP8, FP8 KV, 30-Minuten-Läufe, kein CPU-Offload oder Speculative Decoding. Die Punkte zeigen die berichteten Läufe; die Unsicherheit bei Wiederholungsläufen wurde nicht berichtet.
Der größere Gewinn bei hoher Concurrency ist mit Cache-Druck vereinbar. Ein Vergleich beider Implementierungen bei gleicher Cache-Kapazität würde helfen, diesen Effekt zu isolieren.
Mehr zu Expert-Routing und 4-Bit-Aktivierungen.
3. Speicher-Traffic: Operationen verschmelzen und unnötige Kopien entfernen
Innerhalb jeder GPU ist der nächste Blickpunkt die Datenmenge, die zwischen Kernen übergeben wird.
Kimi K3s Single-Token-KDA-Pfad lief drei Compute-Kernel und zwei Ausgabekopien. Die Faltung lief vor einem Kernel, der bereits Q/K-Normalisierung, Decay- und Beta-Gates sowie das rekurrente Update verschmolz; die Ausgabenormalisierung lief danach. Der fused-HIP-Pfad führt diese Operationen in einem einzigen Launch aus und schreibt direkt in den Zielbuffer (#50654).
Zwischenübergaben bleiben auf dem Chip. Faltungshistory und rekurrenter Zustand gehen weiterhin in den GPU-Speicher für das nächste Token.
Single-Token-, nicht-spekulatives KDA-Decode in #50654. Davor wird der fused-Triton-Normalisierungspfad verwendet. Die Zählungen folgen dem Quellcode; Projektionen liegen außerhalb des Blicks. Lese- und Schreibzugriffe auf gespeicherte Zustände bleiben bestehen.
AttnRes mischt frühere Layer-Block-Ausgaben mit dem laufenden Residual. Die Kombination dieser Mischung mit RMSNorm hält die temporäre Mischung in Registern (#50593). Das für spätere Layer gespeicherte laufende Residual behält seine BF16-Rundung; die Mischung bleibt bis zur Normalisierung in FP32. Tests verlangen exakte persistente Updates und erlauben numerische Toleranzen für die normalisierte Ausgabe.
Mit der AttnRes-Fusion stieg der Ausgabedurchsatz um 14.2 % auf acht AMD Instinct MI355X GPUs bei TP8, mit 100K-Eingabe/1K-Ausgabe-Requests und deaktiviertem Prefix Caching. Die Latenz bei langen Prefills blieb praktisch unverändert.
Eingaben nur für Kernel kopieren, die sie verwenden
Der ROCm-Matrixmultiplikations-Dispatcher packte die Eingaben, bevor er einen Kernel auswählte. Wenn er den Fallback wählte, las dieser Kernel die ursprüngliche Eingabe und ließ die Kopie ungenutzt. Das Verschieben des Packens in die spezialisierten Zweige entfernte diese Kopien (#58566).
Das Profil machte die Verschwendung sichtbar: 69 unnötige Kopien pro Decode-Schritt, eine pro KDA-Layer. Jede bewegte nur 1,792 Bytes, dauerte aber etwa 4.8 Mikrosekunden. Diese Bytes schneller zu bewegen hätte kaum geholfen; der Launch-Overhead dominierte.
Im TP8-Profil des PR mit Concurrency eins, sechs Drafts und 384K-Kontext machen die entfernten Kopien 0.339 ms Kernel-Kopierzeit pro Schritt aus.
4. MLA: schnelleres Long-Context-Decoding mit AMD AITER-Assembly
Kimi K3 hat zwölf Query-Heads pro GPU bei TP8. Auffüllung auf sechzehn machte AMD AITERs Assembly-Decode-Pfad verfügbar. Im berichteten Long-Context-Test sank die Zeit pro Ausgabe-Token von 43,8 auf 23,6 Millisekunden.
Der Vergleich verwendete TP8 ohne DCP bei einer Concurrency von eins. Der Adapter in #50578 kopiert vier Query-Heads, packt sie in das Sechzehn-Head-Layout und verwirft deren Ausgaben. DCP8 präsentiert eine andere Form mit 96 Heads.
Dies bewahrt die Funktionsweise des Modells, weil jeder Query-Head unabhängig über die zwischengespeicherten Positionen attended. Das Hinzufügen eines weiteren Heads ändert die Softmax des ursprünglichen Heads nicht. In diesem Decode-Pfad wird nur das Query aufgefüllt; der gespeicherte komprimierte KV-Verlauf bleibt von derselben Größe.
Ein langes Gespräch gibt der Attention viel Arbeit, aber diese Arbeit muss auf die GPU verteilt werden. Im historischen Code, den wir untersucht haben, schränkte ein konservativer Scheduling-Hinweis den Gluon-Pfad auf eine Workgroup pro Anfrageein. Diese Workgroup verarbeitete dennoch die gesamte Konversation. Die Auffüllung machte AMD AITERs Assembly-Pfad verfügbar, mit einer anderen Richtlinie zur Aufteilung des Verlaufs in parallele Teile und zur Zusammenführung der Ergebnisse.
Historien-Partitionen sind die Arbeitspakete, die Workgroups innerhalb einer GPU zugewiesen werden. Zur Veranschaulichung sind vier dargestellt; die untersuchte Assemblierungs-Politik wählte sechzehn. Der KV-Speicher bleibt unverändert.
| Eingabe-/Ausgabe-Tokens | Originaler Gluon-Pfad | Gepolsterter Assemblierungspfad |
|---|---|---|
| 1K / 1K | 22,9 ms/Token | 22,8 ms/Token |
| 32K / 1K | 43,8 ms/Token | 23,6 ms/Token |
Vom PR gemeldete mittlere Zeit pro Ausgabe-Token: acht AMD Instinct MI355X GPUs, TP8, Nebenläufigkeit eins, MXFP4-Modellgewichte, BF16-Attention und gewöhnliche Ein-Token-Dekodierung.
Der Fall kurzer Eingaben ändert sich kaum; der Fall langer Eingaben reduziert die Zeit pro Ausgabe-Token nahezu um die Hälfte. Diese Serving-Messungen umfassen die Query-Vorbereitung und die Ausgabeverarbeitung.
5. KDA: Prefill und speculative Verification parallelisieren
MLA kann eine zurückgehaltene Historie auf Workgroups aufteilen. KDA stellt ein schwierigeres Scheduling-Problem dar: Jedes Token hängt vom vorherigen Zustand ab. Der fusionierte Prefill in #54038 bereitet die kombinierte Transformation jeder Tokengruppe vor, bevor deren eingehender Zustand bekannt ist.
Beispielsweise lassen sich „verdopple den Zustand halbiere ihn und addiere zwei“ und dann „halbiere ihn und addiere eins“ zu „nimm ein Viertel des Ausgangszustands und addiere zwei“ zusammenfassen. Diese Regel lässt sich berechnen, bevor der Ausgangszustand eintrifft.
KDA tut dies mit Matrixtransformationen. Ein geordneter Scan der Gruppenzusammenfassungen bestimmt den Ausgangszustand jeder Gruppe; anschließend spielen die Gruppen ihre Token parallel ab. Die Token-Reihenfolge bleibt erhalten, aber jede Gruppe wartet nicht mehr auf die Wiedergabe der vorherigen Gruppe.
Die Gruppierung fügt einen zweiten Durchlauf hinzu und erweitert den fusionierten Chunk-Pfad von zwei Launches auf vier. Sie hilft, wenn wenige Sequenzen oder Köpfe zu wenig parallele Arbeit bieten; andernfalls können die zusätzlichen Durchläufe mehr kosten, als sie einsparen.
Innerhalb jeder Gruppe hält der rekurrente Durchlauf den Zustand zwischen Chunks in Matrix-Akkumulator-Registern und vermeidet so einen Schreib- und Lesevorgang im globalen Speicher. Diagramm der Zustandsspeicherung.
Der fusionierte KDA lieferte in einem separaten Drei-Backend-Vergleich bei Eingabelängen von 4K und 16K 5,3–5,6 % mehr Eingabe-Durchsatz als Triton: acht AMD Instinct MI355X GPUs, TP8, Nebenläufigkeit 32, Prefix-Caching deaktiviert und Ein-Token-Ausgaben. Dies misst das vollständige Backend. Benchmark-Ergebnisse.
Kleinere Tiles für die speculative Verification verwenden
Kurze Verifikations-Batches benötigen eine andere Aufteilung. Bei TP8 hat jede GPU 12 KDA-Köpfe mit 128 Wertspalten. Die Aufteilung jedes Kopfes in vier Tiles mit je 32 Spalten startet nur 48 Workgroups auf 256 Compute Units. #58045 wechselt zu Vier-Spalten-Tiles und erhöht die Anzahl auf 384.
Jedes Tile besitzt andere Wertspalten und durchläuft dieselbe Token-Sequenz in Reihenfolge. Schmalere Tiles erhöhen die Anzahl der unabhängigen Workgroups von 48 auf 384.
In einem separaten Graph-Replay-Kerneltest auf einer AMD Instinct MI355X GPU (TP8-Dimensionen, eine Sequenz, vier Verifikationspositionen) sank die Zeit von 16,20 auf 5,61 Mikrosekunden pro Layer (2,89×). Dies umfasst schmalere Tiles, Ein-Wellen-Workgroups, Spezialisierung auf einheitliche Längen und angehobene tokeninvariante Arbeit. Zerlegte Batches behalten einen dynamischen Pfad; Tests vergleichen Ausgaben und rekurrenten Zustand.
6. Speculative Decoding: Festlegen, wie viele Tokens entworfen werden
Eine schnellere Verifikation kann verändern, wie viele Entwurfstoken eine Überprüfung wert sind. Die nutzbare Rate ist die committete Ausgabe geteilt durch die Gesamtzeit des vollständigen Draft–Verify–Commit-Zyklus.
Beispielsweise liefert die feste Akzeptanz-Referenz von AgentX 3.00 erwartete committete Token pro Zyklus mit drei Entwürfen und 3.36 mit vier, einschließlich des Wiederherstellungs- bzw. Bonustokens. Das sind 12% mehr committete Ausgabe pro Zyklus. Vier Entwürfe verbessern den Durchsatz nur, wenn der vollständige Zyklus weniger als 12% länger dauert als bei drei Entwürfen.
Veranschaulichender Vergleich unter der kontrollierten Akzeptanz-Referenz. Die 12%-Schwelle ist ein Kostenbudget; das Wachstum des vollständigen Zyklus wurde hier nicht gemessen.
Die öffentliche AMD-Rezeptur verwendet drei bis sieben Drafts mit DCP1 und deaktiviert Spekulation bei den größeren DCP8-Konkurrenzeinstellungen.
Was als Nächstes optimieren
Laufende Arbeiten zur Prefill/Decode-Disaggregierung liefern einen weiteren Ansatzpunkt: die Auslastungsbalance der Worker und ob Übertragungen abgeschlossen sind, bevor ihre Daten benötigt werden.
Für ein anderes Modell oder eine andere Workload sollte man von den eingesetzten Request-Formen ausgehen und drei Prüfungen vornehmen:
Ränge vergleichen. Berechnen mehrere GPUs dasselbe Ergebnis, bevor ein Kollektiv es zusammenführen könnte?
Puffer verfolgen. Hat jeder temporäre Tensor einen Konsumenten auf dem gewählten Pfad? Können die Daten auf dem Chip bleiben?
Unabhängige Arbeit zählen. Erzeugen die tatsächlichen Heads, Tokens und Tiles genügend Workgroups, um die Last zu verteilen?
Man messe die vollständige Anfrage mit der benötigten Antwortgeschwindigkeit und prüfe sowohl die Ausgaben als auch den gespeicherten Zustand. Ein schnellerer Kernel zählt, wenn er die Arbeit verkürzt, die das nächste Token blockiert.
Beiträge und Danksagungen
Die Kimi-K3-Arbeit umfasst mehr als 50 gemergte AMD/ROCm-bezogene vLLM-PRs von AMD, Embedded LLM und der breiteren Community, neben AITER-Entwicklung, Integration, Review und Benchmarking. Die Beiträge umfassen Attention, Rekurrenz, MoE, Quantisierung, Graph-Ausführung, Cache-Unterstützung und Plattformintegration.
Besonderer Dank gilt: Pin Siang Tan, Jun Kang Chow, Ye Hur Cheong, Hongxia Yang, Seungrok Jung, Bill He, Yichao Zhu, Hyukjoon Lee, Andy Luo, Mrinal Karvir, Richard Li, Sun Peng
Andy Friedrich, Ethan Yang, Tang Rui, Andreas Karatzas, Ankur Singh, Yihua Cheng, Badr Ba Sowid, Benjamin Chislett, Taoyu Zhu, Bill He, Bin Ding, Bowen Bao, Brandon Zhang, Chaemin Lim, Charles Wu, Chuan (Richard) Li, Felix Li, Cameron Quilici, Weishu Deng, Dewei Wang, Divakar Verma, Douglas Lehr, Edwin Lim, Yudong Pan, Elvir Crnčević, Fang Che, Fangzhou Ai, Xingran Fan, Fulu Li, Felix Marty, Canlin Guo, Summer Yang, Haichen Zhang, Yufeng He, He Liu, Hongxia Yang, Hyukjoon Lee, Yifan Qiao, James E T Smith, Jiahui Cao, Yanyuan Qin, Jonathan Chen, Juntian Liu, Shao-Chun Lee, Kedar Potdar, Kevin H. Luu, Kuan-Fu Liu, Kuntai Du, Kyle Sayers, @lalala-sh, @linnea-lin-00638949, Yinfeng Liu, Lucas Wilkinson, Gabriel Wu, Markus Hartikainen, Maithili Joshi, Jeff (Junze) Ma, Matthew Wong, Misha Goin, Micah Williamson, @minmengdie, Matvei Pashkovskii, Mathews Neha, Nicolò Lucchesi, Nick Hill, Nicholas Susanto, Oxana Korzh, Pei Zhang, @ppalanga, Peiran Qin, Qiuyang Yue, Rita Brugarolas, Rebecca Lee, Ryan Rock, Rohan Potdar, @Saddss, Samuel Shen, Sean Filimon, Seungrok Jung, Shantipriya Parida, Shanshan Shen, Shengnan Xu, Simon Danielsson, Siraj Shaikh, Stacy Roberts, Stefan Koncarevic, Asan Stefanski, Minghui Jiang, Tarık Saraç, Tun Jian Tan, Lingpeng Jin, Vansh Bhatia, Maksim Vedenev, Ye Hur Cheong, @wenwzhan, Wei Zhao, Xavier Aguilar, Xiaobing Zhang, Xiaohu Guo, Xin Li, Xudong Lyu, Yanxue Ren, Wentao Ye, Yongqin Wang, Riggins Chen, Chao Hong, Yuchen Shen, Matt Qin, Yichao Zhu, Roger Wang, Zheng Gong, Jiangyun Zhu, Zvi Grinberg, Yongye Zhu.
Benchmark-Hinweise
Serving-Konfigurationen an den Vergleichszielen
| P90-Interaktivität (Tokens/s/Nutzer) | AMD Instinct MI355X | NVIDIA HGX B300 |
|---|---|---|
| 30 und 50 | SimpleCPU-Offload; DCP8 / keine Drafts zu DCP1 / drei Drafts | Mooncake-Offload; DCP8 |
| 150 | Nur GPU; DCP1; fünf bis sieben Drafts | Mooncake-Offload; DCP8 |
Beide Systeme verwenden acht GPUs, TP8, FP4-Gewichte und FP8-KV. Die Werte werden innerhalb jeder veröffentlichten Offload- oder GPU-only-Serie bei übereinstimmender Interaktivität interpoliert; Konkurrenz, DCP und Draft-Tiefe können zwischen den eingegrenzten Läufen variieren. Das fixierte AMD-Rezept (YAML) und NVIDIA-Launcher geben die Image-Tags und alle Einstellungen an.
Das Replay verwendet den cc-traces-weka-062126 -Datensatz und einen fixierten AIPerf-Harness, wobei die Aufwärmphase ausgeschlossen ist und eine Stunde Profiling unter fixen synthetischen Akzeptanzkurvenerfolgt. Die Rezepte geben Seed, Sitzungsstart- und Warmup-Einstellungen an. Die heruntergeladene Datensatzrevision wird nicht aufgezeichnet. Closed-Loop-Replay kann unterschiedliche Mischungen abgeschlossener Anfragen erzeugen.
Software und Offload. Die Einreichungen verwenden vLLM 36768d1bf (AMD) und 5894fdf98 (NVIDIA). Die konfigurierten Host-Cache-Budgets betragen je GPU 224.875 bzw. 281 GB; Connector- und Image-Einstellungen finden sich in den verlinkten Rezepten.
Kosten. SemiAnalysis’ Large-Hyperscaler-Besitzmodell und veröffentlichte GPU-Kostenkonstanten Nehmen Sie 1.50 $ pro GPU-Stunde für AMD Instinct MI355X und 2.26 $ für NVIDIA HGX B300 an. Total tokens/$ = total tokens/s/GPU × 3,600 ÷ modellierte $/GPU-Stunde. Einige Kapital- und Auslastungsannahmen bleiben unveröffentlicht. Beim 50-Token-Interaktivitätsziel ergibt der Vergleich 46.6 % niedrigere modellierte Kosten pro Token.
Schnappschuss. SemiAnalysis InferenceX-Daten abgerufen am 9. Oktober 2026; Einreichungen datiert auf den 30. September 2026 (AMD) und den 16. August 2026 (NVIDIA). PR-Benchmarks verwenden die jeweils angegebenen Workloads; #59591 ist ein separates Experiment nach dem Hauptbild.
| Veröffentlichte Spezifikation, pro GPU | AMD Instinct MI355X | NVIDIA B300 GPU |
|---|---|---|
| Dichte Low-Precision-Matrix-Spitzenleistung | 10.1 PFLOP/s MXFP4 | 13.5 PFLOP/s FP4 |
| GPU-Speicher | 288 GB HBM3E | 288 GB HBM3E |
| Spitzenspeicherbandbreite | 8 TB/s | 8 TB/s |
Quellen: AMD Instinct MI355X, NVIDIA HGX B300, NVIDIA-Speicherspezifikationen. Benchmark-Details: AgentX-Methodik.
Technische Anmerkung: Experten-Routing und Präzision
Kimi K3 wählt pro Token 16 von 896 Experten aus, sodass auch eine umfangreiche Server-Batch wenige Zeilen pro Experte übrig lassen kann. Die resultierenden Experten-Tiles können Padding enthalten.
A4W4 reduziert einen anderen Teil des Datenverkehrs: Die Integration in #53940 ändert Aktivierungen von acht auf vier Bit, während die Gewichte vierbit bleiben. Der Gesamtverkehr umfasst auch BF16-Zwischenausgaben und Experten-Tile-Padding.
Technische Anmerkung: KDA-Präzision und On-Chip-Speicher
Jeder Chunk muss weiterhin die Abhängigkeiten zwischen seinen Tokens auflösen. Der Kernel kombiniert sie zu einer Transformation, die spätere Matrixprodukte anwenden können. Das wirft zwei praktische Fragen auf: welche Präzision das Ergebnis bewahrt und wie viel temporäre Daten auf den Chip passen?
Ein kleines Beispiel zeigt die Idee. Setzt man die früheren Korrekturen in die späteren ein, lässt sich jede Antwort direkt durch die bekannten Eingaben ausdrücken. Die entstehende Koeffiziententabelle hat die Kette der Abhängigkeiten bereits berücksichtigt:
In dieser skalaren Illustration wirkt Position eins über zwei Pfade auf Position drei: direkt mit −1/8; über Position zwei mit (−1/4) × (−1/4) = 1/16. Zusammen ergeben sie −1/16, den Eintrag unten links in der Tabelle. Die Nullen oberhalb der Diagonale spiegeln wider, dass spätere Positionen frühere nicht beeinflussen können.
Der echte Prolog berechnet die Inverse der 64×64-Abhängigkeitsmatrix innerhalb des Chunks. Spätere Matrixprodukte verwenden diese Transformation, um diese Abhängigkeiten zu berücksichtigen.
Die Zwischenwerte der Inversen können anwachsen und sich auslöschen. Zu frühes Runden verliert Information, die das Endergebnis benötigt. Die Implementierung verwendet AMDs native FP32-Matrixinstruktionenund behält FP32-Eingaben und -Akkumulation für die empfindliche Inverse bei. Nur die fertige Inverse wird für nachfolgende Produkte auf BF16 gerundet. Kernel-Implementierung.
Warum FP32-Akkumulation gerundete Eingaben nicht wiederherstellen kann
Betrachten Sie die Subtraktion von 256 von 256.5. Beide Eingaben sind in FP32 exakt. Bei dieser Größenordnung wird 256.5 bei der Konvertierung in BF16 auf 256 gerundet:
| Eingabegenauigkeit | Subtraktion in FP32 durchgeführt | Ergebnis |
|---|---|---|
| Die ursprünglichen FP32-Eingaben behalten | 256.5 − 256 | 0.5 |
| Die Eingaben zuerst auf BF16 runden | 256 − 256 | 0 |
Eine FP32-Subtraktion kann verlorene Information nicht wiederherstellen, bevor sie überhaupt beginnt. Diese Spielwertwerte veranschaulichen, warum die Inverse native 16×16×4 FP32-Matrixinstruktionen verwendet und sowohl Eingabe- als auch Akkumulationsgenauigkeit beibehält.
Ein FP4-Modell stützt sich ebenfalls auf Operationen mit höherer Präzision. Ihre Leistung hängt davon ab, diese numerischen Pfade effizient zu gestalten.
Der Prolog hat auch ein Local-Memory-Budget. AMD nennt seinen On-Chip-Shared-Scratch LDS. Q- und K-Tiles teilen sich den Speicher, weil sie zu unterschiedlichen Zeitpunkten benötigt werden; der dreieckige Input speichert nur seine zehn belegten 16×16-Blöcke. Die Workgroup fordert 79.5 KiBan, was auf 80 KiB, die Hälfte einer AMD-CDNA-4-Compute-Einheit, 160-KiB-LDS-Budgets einer AMD-CDNA-4-Compute-Einheit.
Die Zuweisung wird auf 1,280-Byte-Einheiten gerundet. Das illustrierte zusätzliche KiB überschreitet eine Residenzschwelle: Zwei Zuweisungen passen nicht mehr. Dies ist eine Kapazitätsberechnung; Register und andere Ressourcen können zusätzliche Grenzen auferlegen.
Testen Sie diese Schwelle, indem Sie genug ungenutztes LDS reservieren, um sie zu überschreiten, während die Kernel-Binärdatei unverändert bleibt. Ändert sich die Laufzeit kaum, trug die zusätzliche residente Workgroup für diese Shape wenig bei.
Zustand zwischen Chunks
Gruppenzusammenfassungen und Startzustände überschreiten weiterhin Kernel-Grenzen; angeforderte Checkpoints und der Endzustand werden gespeichert.
Zurück zum KDA-Serving-Ergebnis.
Disclaimer
Die in diesem Dokument enthaltenen Informationen dienen ausschließlich Informationszwecken und können technische Ungenauigkeiten, Auslassungen und Tippfehler enthalten. Die hierin enthaltenen Informationen können Änderungen unterliegen und können aus vielen Gründen ungenau werden, einschließlich, aber nicht beschränkt auf Produkt- und Roadmap-Änderungen, Änderungen an Komponenten- und Mainboard-Versionen, neue Modell- und/oder Produktfreigaben, Produktunterschiede zwischen verschiedenen Herstellern, Softwareänderungen, BIOS-Updates, Firmware-Upgrades oder Ähnliches. Jedes Computersystem birgt Risiken von Sicherheitslücken, die nicht vollständig verhindert oder abgemildert werden können. AMD übernimmt keine Verpflichtung, diese Informationen zu aktualisieren oder anderweitig zu korrigieren oder zu überarbeiten. AMD behält sich jedoch das Recht vor, diese Informationen zu überarbeiten und den Inhalt hiervon von Zeit zu Zeit zu ändern, ohne dass AMD verpflichtet ist, irgendjemanden von solchen Überarbeitungen oder Änderungen zu benachrichtigen. DIESE INFORMATIONEN WERDEN „WIE BESEHEN“ BEREITGESTELLT. AMD TRIFFT KEINE AUSLAGEN ODER GEWÄHRLEISTUNGEN IN BEZUG AUF DEN INHALT HIERVON UND ÜBERNIMMT KEINE VERANTWORTUNG FÜR UNGENAUIGKEITEN, FEHLER ODER AUSLASSUNGEN, DIE IN DIESEN INFORMATIONEN ERSCHEINEN KÖNNEN. AMD LEHNT SPEZIFISCH JEGLICHE STILL SCHWEIGENDEN GEWÄHRLEISTUNGEN DER NICHTVERLETZUNG VON RECHTEN, DER MARKTGÄNGIGKEIT ODER DER EIGNUNG FÜR EINEN BESTIMMTEN ZWECK AB. IN KEINEM FALL HAFTET AMD GEGENÜBER IRGENDEINER PERSON FÜR IRGENDEIN VERTRAUEN, DIREKTE, INDIREKTE, BESONDERE ODER ANDERE FOLGESCHÄDEN, DIE AUS DER VERWENDUNG VON IRGENDEINEN HIERIN ENTHALTENEN INFORMATIONEN ENTSTEHEN, SELBST WENN AMD AUSDRÜCKLICH AUF DIE MÖGLICHKEIT SOLCHER SCHÄDEN HINGEWIESEN WURDE. AMD, das AMD-Pfeil-Logo und Kombinationen davon sind Marken der Advanced Micro Devices, Inc. Andere in dieser Veröffentlichung verwendete Produktnamen dienen nur der Identifikation und können Marken der jeweiligen Unternehmen sein. © 2026 Advanced Micro Devices, Inc. Alle Rechte vorbehalten.