
Daten in Native-Script für 22 Sprachen, romanisierte Daten für zwölf Sprachen sowie ein wiederverwendbarer GPU-beschleunigter Pipeline für Übersetzung, Qualitätsbewertung und Reparatur.
Autoren: AI4Bharat — Mohammed Safi Ur Rahman Khan, Mitesh Khapra, Anoop Kunchukuttan. NVIDIA — Niket Agarwal, Raviraj Joshi, Anusha Kamath, Markus Kliegl, Yev Meyer, Sriharsha Niverty, Kiran Praveen, Utkarsh Vaidya.
Wir freuen uns, Nemotron-pretraining-Indic-v1 vorzustellen – etwa 2,8 Billionen Tokens in 22 indischen Sprachen – und dieses bald gemeinsam mit dem offenen, GPU-beschleunigten Datengenerationsprozess veröffentlichen. Es handelt sich um die 22 Sprachen, die in der indischen Verfassung aufgeführt sind: die ersten Sprachen für 97 % der Indern, also fast 1,2 Milliarden Bürger im Zensus von 2011. Entwickelt von NVIDIA in IIT Madras, dem führenden Ingenieurinstitut Indiens, und in seinem AI4Bharat-Labor, bietet diese Veröffentlichung Modelbauern ein neuartiges Ressource für den indischen Pretraining. Der Prozess umfasst die gesamte Generierungsmethode, einschließlich Anweisungen, LLM-Arbeitsabläufe und Qualitätskontrollen, sodass Entwickler ihn an ihre eigenen Quelldaten anpassen und mehr Daten für ihre Bedürfnisse generieren können.
AI4Bharat, das Forschungslabor für indische Sprachen am IIT Madras, entwickelt Open-Source-Datensätze und Modelle für indische Sprachen. Seine Ressourcen, wie Sangraha, ein offenes Pretraining-Korpus für 22 indische Sprachen, haben dazu beigetragen, die Grundlage für die open-Indic-Sprachmodellforschung zu schaffen. Unsere gemeinsame Open-Source-Veröffentlichung stellt eine erhebliche Erweiterung der offenen synthetischen Indic-Trainingsdaten dar, die der Gemeinschaft zugänglich sein wird. Sie bringt eine breite Mischung an katalogisiertem englischen Material ein, einschließlich Mathematik, Code und Fragen-und-Antwort-Inhalten, in indische Sprachen ein, sodass Teams mehr Trainingsmaterial erhalten, um Modelle zu entwickeln, die technische Konzepte erklären, Probleme lösen und Fragen in diesen Sprachen beantworten können. Jeder Datensatz verfolgt eine katalogisierte Quelldokumentation, und jede Ausgabe wird gegenüber ihrem Eingang überprüft, sodass der synthetische Text auf echten Informationen basiert bleibt.
Mitesh Khapra, der Leiter von AI4Bharat und der 2025 TIME100 AI Liste ist zu dem Kernproblem gekommen: Die Technologie für indische Sprachen liegt hinter der für Englisch, weil „wir nicht genügend Daten für indische Sprachen haben“. Wir beantworten diese Herausforderung mit mehr Daten und einer offenen Methode zur Erzeugung weiterer Daten.
Das Korpus berücksichtigt auch die Art und Weise, wie Menschen schreiben. Es enthält Daten in der Muttersprache für alle 22 Sprachen sowie romanisierte Texte für zwölf Sprachen, und umfasst 34 Sprachschriftkonfigurationen. Unsere Arbeitsprozesse kombinieren Dokumentebene-Übersetzung, Qualitätsprüfung und gezielte Korrekturen mit Kontrollen zur Erhaltung von Inhalten wie Gleichungen, Tabellen und Code. Diese Daten ergänzen natürlich den von Menschen verfassten Indischtext, der weiterhin für lokales Wissen und kulturellen Kontext unerlässlich ist.
Wir teilen die offene Generierungsmethode, damit die Gemeinschaft nicht nur die Daten nachbilden kann, sondern diese Arbeit weiter vorantreiben kann. Teams können das Corpus direkt verwenden, die Anweisungen und Qualitätsprüfungen anpassen oder eigene Quelldokumente in den Arbeitsprozess einbeziehen. Durch die Öffnung sowohl der Daten als auch des Prozesses zielt unser Ziel darauf ab, die großflächige Generierung indischer Daten zugänglicher zu machen und mehr Entwickler dazu zu bringen, zu stärkeren Modellen in indischen Sprachen beizutragen.
Fortgesetztes Pretraining für Nemotron 3.5 Super VL führte zu 10 Milliarden Indisch-Tokens, die aus einem Zweizeitsprachlichen Teil dieses Korpus und natürlichem Indischtext stammen. Unser technischer Bericht über das Modell umfasst die gesamte Geschichte. Wir planen, diese Korpus in zukünftigen Nemotron-Modellen weiterzu nutzen.
was ist im Korpus enthalten?
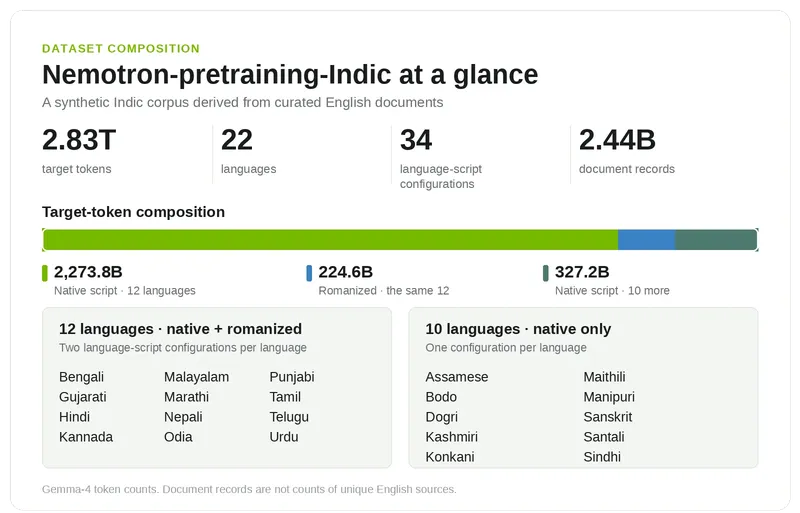
 Abbildung 1. Das Korpus enthält 2.601,0 Milliarden native-Sprache-Tokens und 224,6 Milliarden romanisiertes Tokens. Die Zahlen werden mit dem Gemma-4-Tokenizer erfasst. Die Dokumente enthalten Übersetzungen und Varianten der gemeinsam genutzten Quellen; es handelt sich nicht um die Anzahl einzelner englischer Dokumente.
Das Korpus enthält zwei Gruppen von Sprachkonfigurationen:
- Native-Script- und romanisierte Daten: Bengali, Gujarati, Hindi, Kannada, Malayalam, Marathi, Nepali, Odia, Punjabi, Tamil, Telugu und Urdu.
- Native-Script-Daten: Assamesisch, Bodo, Dogri, Kaschmisch, Konkani, Maithili, Manipuri, Sanskrit, Santali und Sindhi.
Hier beschreibt native-script das Schreibsystem: Der Text wird noch aus dem Englischen übersetzt. Romanisiert bedeutet, dass Texte in einer indischen Sprache in lateinischem Schriftbild geschrieben werden, nicht eine englische Übersetzung. Für jedes der zwölf dual-script-Sprachen umfasst die Romanisierung einen Teilbereich der anerkannten native-script-Übersetzungen.
Diese Unterscheidung ist wichtig bei der Erstellung einer Trainingsmischung. Natürliche und romanisierte Aufzeichnungen bieten unterschiedliche Schriftexponenz, können aber dasselbe zugrunde liegende Inhalt ausdrücken. Die Tokenzahlen beschreiben den erhaltenen Korpus, einschließlich akzeptierter Umformulierungen, und nicht das Tokenbudget einer Trainingsrunde. Die Zahlen hängen auch vom verwendeten Tokenizer ab, daher sollten die Korpusinventar und die Trainings-Tokenzahlen getrennt gelesen werden.
Von englischen Quelldokumenten zu indischen Trainingsdaten
Um dieses Korpus zu erstellen, beginnen wir mit Dokumenten aus 15 Nemotron-CC-v2 Subsets, die Webtext, Fragen und Antworten, Mathematik, Code und andere spezialisierte Inhalte umfassen. Wir verwenden NeMo Data Designer, NVIDIAs Open-Source-Framework zur Erzeugung synthetischer Daten, um Übersetzungen, Qualitätsprüfungen und gezielte Reparaturen durchzuführen. Im gesamten Workflow behalten wir jeden Quellidentifikator bei, damit Entwickler den Ausgangszustand des Dokuments zurückverfolgen können. Eine solche klare Herkunft ist Teil dessen, was offene Daten praktisch macht, um sie zu überprüfen und weiterzuentwickeln. Abbildung 2 zeigt den Workflow für zwölf Sprachen.
 Abbildung 2: Ein Vierstufen-Indisch-Synthetisierungsdatenpfad für zwölf Sprachen, implementiert mit NeMo Data Designer und Gemma-4-31B-it. Wir übersetzen englische Dokumente, bewerten die Qualität der Übersetzungen, reparieren Ausgaben mit niedrigem Score und konvertieren einen Teil der genehmigten Übersetzungen ins Lateinische Schriftzeichen. Die anderen zehn Sprachen verwenden den separaten Indisch-Übersetzungsworkflow, wie unten beschrieben.
Das zwölfsprachige Workflow
Für diese zwölf Sprachen übersetzen wir Dokumente vollständig, damit das Modell den Kontext zwischen Abschnitten, Tabellen und Gleichungen nutzen kann. Wir wählten Gemma-4-31B-it, indem wir Modelle an vollständigen Dokumenten verglichen, die Übersetzungsqualität und die Erhaltung des technischen Inhalts überprüften. Unsere Anweisungen unterscheiden den Prosainhalt, den es zu übersetzen ist, von dem Inhalt, den wir bewahren müssen, einschließlich Code, Gleichungen, URLs und Formatierung.
Nach der Übersetzung verwenden wir denselben Modell, um jedes Ergebnis gegen den englischen Ursprung zu bewerten. Eine Bewertungsmatrix, inspiriert von Multidimensional Quality Metrics (MQM), einem offenen Rahmenwerk zur Klassifizierung von Übersetzungsfehlern nach Art und Schwere, umfasst Bedeutung, Flüssigkeit, Terminologie, Stil und Formatierung. Wir behalten nur die Ergebnisse auf, die mindestens 75 von 100 Punkten erreichen (eine Bewertungsskala, nicht ein Genauigkeitsprozent). Für Ergebnisse mit niedrigerer Bewertung nutzen wir die Bewertungsfeedback, um Reparaturen vorzunehmen, und bewerten sie anschließend wieder gegen denselben Schwellenwert. Dieser Prozess hat 438,4 Milliarden Tokens aus nativ-schriftlichen und romanisierten Daten gerettet, die bereits im Gesamtcorpus enthalten sind. Beispiele von menschlichen Bewertungen und Tests mit absichtlich eingeführten Fehlern halfen dabei, Verluste und verbleibendes Englisch zu identifizieren, was unsere Prompts und Checks verbessert.
Akzeptierte nativ-schriftliche Übersetzungen bilden auch den Ausgangspunkt für die romanisierten Daten. Wir konvertieren einen Teilbereich in das lateinische Schriftzeichen und überprüfen jedes Ergebnis gegen seine nativ-schriftliche Eingabe. Dies trennt die Übersetzung von der Konversion des Schriftsystems. In unserer anfänglichen menschlichen Vergleichung führte diese zweistufige Methode zu weniger Halluzinationen und weniger verbleibendem Englisch als die direkte Erzeugung romanisierten Textes aus dem Englischen.
Das Ten-Language-Werkzeugflow
Für die anderen zehn Sprachen anpassen wir den Arbeitsablauf, um die Qualität langer Dokumente und die Stabilität der Übersetzung zu verbessern, wie sie in unseren Vergleichen festgestellt wurden. Wir übersetzen mit Indic Translate, einem Dokumentseitigen Übersetzungsmodell für Englisch und 22 indische Sprachen von Bodhan AI, einem gemeinnützigen Zentrum für KI in der Bildung, das bei IIT Madras betrieben wird. Gemma-4-31B-it bewertet anschließend jede Übersetzung im Vergleich zu ihrem englischen Ursprung. Für acht Sprachen verwenden wir den Ansatz des gesamten Dokuments. Bei längeren Santali-Dokumenten übersetzen wir die überlappenden Abschnitte und rekonstruieren das Dokument; bei Manipuri übersetzen wir in das Bengali-Schriftzeichen, bevor es in das Meitei Mayek, seine Mutterschrift, umgewandelt wird. Diese Arbeitsabläufe halten die Ergebnisse auf mindestens 75 von 100 Punkten fest und erzeugen nur Daten in der Mutterschrift, ohne eine basierende Rückgabe.
was sich nach dem fortgesetzten Pretraining von Indic verändert hat?
Der technische Bericht von Nemotron 3.5 Super VL vergleicht den Punkt auf dem Weg vor dem fortgesetzten Vortraining (CPT) mit dem Punkt nach dieser Phase. Das eingestellte Budget betrug 100 Milliarden Trainingstokens, wobei 10 Prozent (10 Milliarden tokens) für eine Mischung aus synthetischem und natürlichem Indic-Text verwendet wurden. Die restlichen 90 Prozent behielten die relativen Verhältnisse der vorherigen Trainingsmischung bei.
Die Punktzahlen stiegen bei allen fünf gemeldeten Indisch-Wissen- und -Rechensetzen: MILU, Indic MMLU-Pro, Indic ARC-Challenge, Indic ARC-Easy und Indic GSM8K.
 Abbildung 3. Nemotron 3.5 Super VL vor und nach der Indic-CPT-Phase. Die Leistungssprünge liegen zwischen 4,98 und 9,82 Prozentpunkten. Der Vergleich beruht auf einer Trainingsphase, die synthetische und natürliche Indic-Daten kombiniert, anstatt den Beitrag des synthetischen Korpus isoliert zu betrachten. Die Sprachausbeute variiert je nach Benchmark; es handelt sich dabei um Stufencheckpoints auf Ebene der Phase, nicht um einen Vergleich der endgültigen Modellversionen.
Quelle: Nemotron 3.5 Super VL technischer Bericht, Tabelle 2. GSM8K schließt Odia aus, da die Bewertung das Servierkontextlimit überschritt.
Diese Ergebnisse unterstützen das kombinierte synthetische und natürliche Indic-CPT-Rezept, während die Auswahl der Mischung für andere Modelle und Sprachen weiterhin untersucht werden muss.
Der begleitende indische Bericht untersucht die Quellmischungen, die Größe des synthetischen Datensatzes und die Beschäftigung mit Skripten unter Verwendung von durchgegangenen Daten für die zwölfsprachige Gruppe. Die Bewertung des gesamten Korpus, einschließlich der wiederhergestellten Überarbeitungen und der zehn anderen Sprachen, bleibt eine nächste Schritte für die kontrollierten Studien.
Breitere Indic-Fähigkeiten in Nemotron 3.5 Super VL
Jenseits der Ergebnisse des CPT-Phasenmodells – wie vergleicht das veröffentlichte Modell mit der vorherigen Generation? Abbildung 4 vergleicht Nemotron 3.5 Super VL mit Nemotron 3 Super hinsichtlich der Leistung im Indic-Task und der Sprachqualität. Diese Ergebnisse spiegeln den vollständigen Trainingsprozess des veröffentlichten Modells wider, einschließlich des Indic-CPT und des Post-Training-Verfahrens.
Nemotron 3.5 Super VL erzielt höhere Ergebnisse bei fünf von sechs Aufgabenbenchmarken, die sich auf Wissen, Logik, Mathematik, Code und Übersetzung beziehen. Die Anwendung von Anweisungen bei IFEval 1.5 sank um 2,04 Punkte. Auch in allen vier IndiVibe-Kriterien verbessert sich: Nützlichkeit, Flüssigkeit, Sprach- und Schriftgenauigkeit sowie angemessene Länge. IndiVibe ist das offene Benchmark von Sarvam AI für Assistenten-Stimuli in indischen Sprachen. Gemeinsam untersuchen diese Bewertungen sowohl, was das Modell kann, als auch, wie gut es in indischen Sprachen kommuniziert.
 Abbildung 4. Leistung des Indi-Tasks und Sprachqualität bei den Nemotron Super-Generationen. Links: sechs Task-Benchmarks. Rechts: vorläufige IndiVibe-verhältnisbewertungen, nicht direkte Siegesraten im direkten Vergleich. Die Etiketten zeigen die Veränderungen in Prozentpunkten an, außer bei WMT24++, wo chrF-Punkte verwendet werden. Weitere Details zu den Benchmarks und der Bewertung finden Sie im begleitenden Indi-Technischen Bericht.
Beginnen Sie mit dem Bau
Das Korpus laden
Beginnen Sie mit den Sprachen und Schriftarten, die Ihr Modell benötigt, untersuchen Sie ein Beispiel und prüfen Sie das Datensatzkartong und die Lizenz vor dem Trainieren. Die Konfigurationen verwenden Sprach-, Schrift- und Regionetags: zum Beispiel bedeutet hi-Deva-IN Hindi in Devanagari, während hi-Latn-IN romanisiertes Hindi darstellt.
Das Beispiel unten verlangt den Repositorie-Id von der Datensatzkarte, erkennt anschließend die verfügbaren Spalten und streamt ein Beispiel.
from datasets import get_dataset_split_names, load_dataset

dataset_id = input("Repository ID from the dataset card: ").strip()
config = "hi-Deva-IN"

splits = get_dataset_split_names(dataset_id, config_name=config)
print("Available splits:", splits)

data = load_dataset(
    dataset_id, name=config, split=splits[0], streaming=True
)
print(next(iter(data)))
Hugging Face Datasets unterstützt Streaming, sodass Leser die Daten ohne das Herunterladen des gesamten Korpus überprüfen können. Sobald die Veröffentlichung verfügbar ist, sollte eine Revision des Datensatzes festgelegt werden, um reproduzierbare Experimente durchzuführen.
Für eine erste Trainingsstudie vergleichen Sie Mischungen unter einem festen Token-Budget und notieren die Anteile von natürlicher/synthetischer sowie nativer/romanisiertem Sprache. Beobachten Sie die Ergebnisse pro Sprache zusammen mit der Aufrechterhaltung der Englischen Fähigkeiten und der Qualität der Sprache/ Schrift. Bei der Erstellung von verbleibenden Stichproben berücksichtigen Sie die aus derselben Quelle stammenden Daten in verschiedenen Sprachen und Schriftsystemen.
Um eine vollständigere Rezeptvorlage zu erstellen, kombinieren Sie das Korpus mit den nachtrainingsdaten von Nemotron, wie beispielsweise die Chat & Instruction oder Post-Training Blends Sammlungen. Für synthetische Daten, die speziell für Indien verwendet werden, setzen Sie NeMo Data Designer mit Nemotron-Personas-India ein, synthetische Personas in Englisch und Hindi, die auf realen Verteilungen für Indien basieren.
Anpassen des Generierungsrezepts
Der Open-Source-Nemotron Bharat-Übersetzungsplugin für NeMo Data Designer bietet Übersetzungs- und Bewertungsvorschläge, optional basierende Überarbeitungen, Dokumentenfensterung sowie Unterstützung für Skriptumwandlung. Nutzen Sie seine Konfigurationsreferenz, um Modelle und Sprachen auszuwählen, die Vorschläge an Ihr Bereich anzupassen und Überarbeitungsparameter einzustellen. Die begleitende Entwicklernotiz erklärt den Arbeitsablauf und die technischen Entscheidungen.
Beginnen Sie mit einer kleinen Auswahl aus Ihren eigenen Quelldokumenten. Überprüfen Sie die Übersetzungsqualität sowie die Erhaltung von Code, Mathematik und Formatierung, und verbessern Sie anschließend die Anweisungen und Prüfungen mit Übersetzern in der Muttersprache, bevor Sie die Umsetzung ausweiten. Betrachten Sie die Generierung und die Akzeptanz des Korpus als getrennte Schritte: Das Plugin gibt die Kandidaten und Bewertungen zurück, während Ihre Filterstrategie bestimmt, welche Aufzeichnungen in den Trainingskorpus gelangen.
Gesamtumfang und Einschränkungen
Die Übersetzung erweitert den Zugang zum ursprünglichen Material, ersetzt jedoch nicht den Text, der ursprünglich in indischen Sprachen geschrieben wurde, und garantiert auch keine Abdeckung des lokalen Wissens und der Kultur. Wir empfehlen, dieses Korpus mit geeignet gespeicherten natürlichen indischen Texten zu kombinieren und die resultierende Mischung für den gewünschten Einsatzfall zu bewerten.
Die Qualitätsbewertung ist hauptsächlich automatisiert und wird durch eine bewertete menschliche Überprüfung ergänzt, deren Abdeckung in den verschiedenen Sprachen variiert. Im zwölfsprachigen Arbeitsprozess (Abbildung 2) fungiert der Übersetzer auch als Richter. Der erhaltene Text kann immer noch Fehler enthalten, und im zehnsprachigen Arbeitsprozess ist eine größere Validierung durch Muttersprachler erforderlich. Die Überprüfung der Quell-ID-Identitäten entfernt Verarbeitungsduplikationen; es handelt sich dabei nicht um semantische Deduplikation ähnlicher Inhalte.
Neben dem Korpus entwickelt AI4Bharat am IIT Madras mit Unterstützung von NVIDIA die Indic-LLM-Eval-Suite, eine offene und dynamische Sammlung von Benchmarks für die Fähigkeiten indischer Modelle. Sie hilft den Modellbauern dabei, sowohl die Leistung bei Aufgaben als auch die Sprachqualität zu bewerten. Siehe den begleitenden Blogartikel: Better Models Need Better Benchmarks: Introducing Indic-LLM-Eval-Suite.
Erkunden Sie die Sprachkonfigurationen, testen Sie eine Trainingsmischung oder anpassen Sie das offene Rezept für einen neuen Bereich. Das Teilen der Ergebnisse pro Sprache sowie der Verbesserungen im Generierungsprozess kann der Gemeinschaft helfen, auf diesem Arbeiten weiterzuarbeiten.
Weitere Lektüren und Danksagungen
Die Begleitberichte Scaling Synthetic Pre-training Data and Evaluation for Indic LLMs und Nemotron 3.5 Super VL and Lightning technical report liefern den Korpusbericht, die Generierungsmethoden, die Experimente und die Bewertungsdetails. Die Bewertung ist der andere Teil dieser Arbeit. Für die Benchmark-Seite siehe den Begleitblog von AI4Bharat und NVIDIA Better Models Need Better Benchmarks: Introducing Indic-LLM-Eval-Suite.
Dieses Projekt vereint NVIDIA, IIT Madras, AI4Bharat und Bodhan AI. Wir erkennen auch die Beiträge an Modellen und Tools an, die im Prozess verwendet werden: Google’s Gemma, Bodhan AI’s Indic Translate und NeMo Data Designer. Weitere NVIDIA-Datenressourcen sind in der Nemotron Pre-Training Datasets-Sammlung verfügbar.