
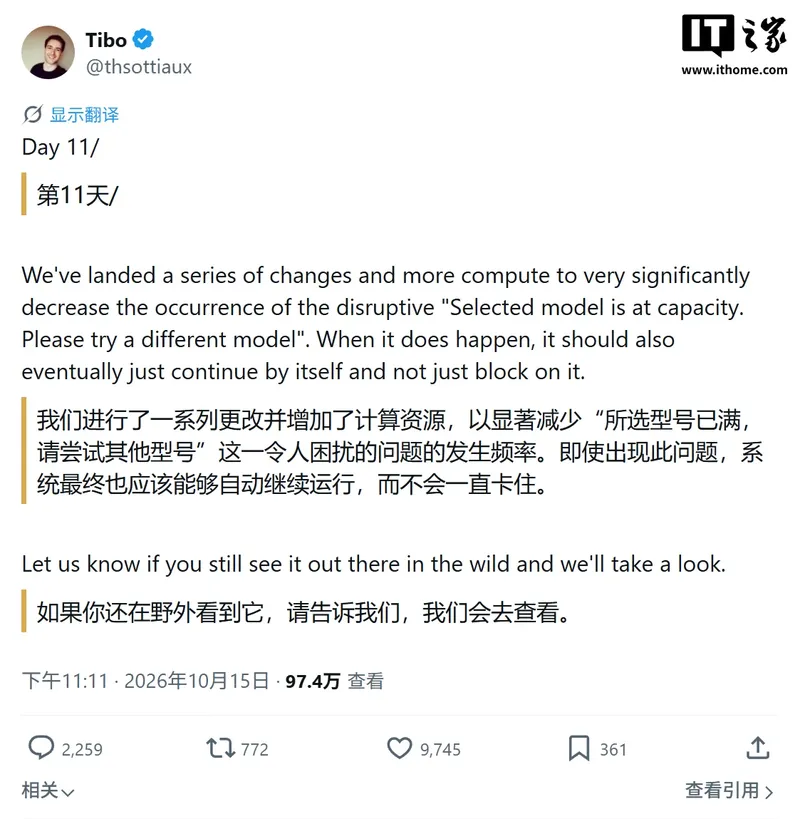
IT之家 Bericht vom 16. Oktober: @thsottiaux, der Leiter von Codex / ChatGPT bei OpenAI, veröffentlichte gestern (15. Oktober) auf der X-Plattform einen Tweet, in dem erstätigte, dass das Team eine Reihe von Änderungen implementiert hat und mehr Rechenleistung eingesetzt hat, um das Fehlerverhalten „gewählter Modelle, die den Kapazitätsgrenzen erreicht haben, bitte versuchen Sie andere Modelle“ zu beheben.
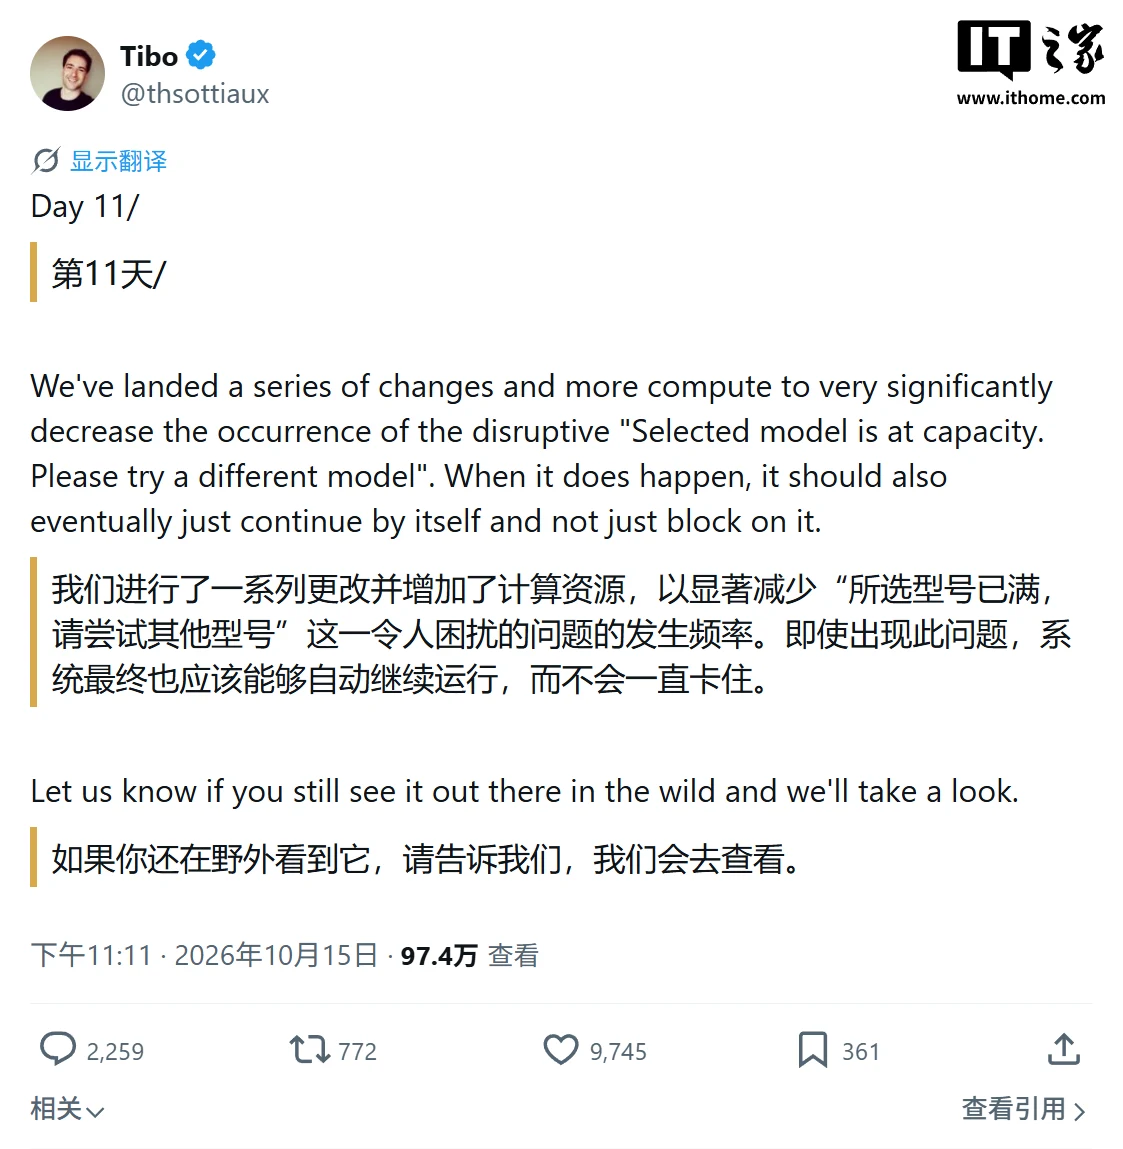
IT Home Anmerkung: Das Team von OpenAI führt derzeit das „28-Tage-Dauerhaft-Entwicklungsprogramm“ vor. In einer Bekanntmachung am 11. Tag wurde bekanntgegeben, dass eine Reihe von Verbesserungen sowie zusätzlichen Rechenleistungsoptionen verfügbar sind. Ziel ist es, die Häufigkeit des Fehlers signifikant zu reduzieren.
Bei der Rückmeldung zum Problem geht aus den öffentlichen Diskussionen hervor, dass das Problem nicht einfach darin besteht, dass das Modell tatsächlich voll ist. Einige Benutzer berichten, dass das Problem immer noch auftritt, selbst wenn die Abonnementskapazität ausreichend ist und sie zu verschiedenen Modellen wechseln; auch Entwickler vermuten, dass es mit Hintergrundanfragen, Sitzungszuständen oder Ressourcenumgebung zu tun hat.
In Bezug auf die Implementierung von Maßnahmen optimiert das OpenAI-Team das System und investiert mehr Rechenleistung, um Fehlermeldungen im Modellkapazitätssystem zu reduzieren. Wenn weiterhin Fehlermeldungen auftreten, soll die Aufgabe „endgültig automatisch fortgesetzt“ werden, anstatt in einem Fehlerzustand festzuhalten und auf eine Intervention des Benutzers zu warten. Das Team lädt außerdem Benutzer ein, die weiterhin Probleme haben, ihre Rückmeldungen zu geben, um die Fehler weiter untersuchen zu können.