
Beam von Reflection ist auf Hugging Face erschienen! Es ist das erste Modell des neuen US-Labors Reflection, und es ist offen! Es ist ein Mixture-of-Experts-Modell (MoEs) mit 501B Parametern (23B aktiv pro Token), unterstützt Text als Eingabe und hat ein Kontextfenster von 1M Tokenund wird unter der Apache 2.0 Lizenz veröffentlicht.
Beam ist fokussiert auf Coding und agentische Anwendungsfälle. Es ist für Teams gedacht, die ein Modell in Frontier-Größe auf ihrer eigenen Hardware, Infrastruktur oder Cloud betreiben und es an ihre eigenen Anwendungsfälle anpassen möchten. Beam wird mit einem eigenen dedizierten Open-Source-Harness auf Rust-Basis ausgeliefert, der die beste Leistung aus dem Modell herausholt.
Beam verfügt über eine native transformers-Implementierung sowie über Downstream-Bibliotheken wie vLLM und SGLang. Wir haben mit dem Reflection-Team zusammengearbeitet, um Ihnen Rezepte für Inferenz, SFT (supervised fine tuning) und RL (reinforcement learning) bereitzustellen, damit Sie mit diesem Modell für Ihre Bedürfnisse bauen können. Zusätzlich zum Day-0-Support in transformers, SGLang und vLLM zeigt dieser Beitrag, wie man es ausführt, wie man es post-trainiert und was wir damit gebaut haben.
TL;DR
- 501B-Parameter-MoEs-LLM mit 23B aktiv pro Token. 52 Layer, 256 Experten pro MoE-Layer, 8 geroutet pro Token.
- Text rein, Text raus mit Kontextfenster von 1M Token.
- Checkpoint-Formate: BF16, FP8, und NVFP4
- Reasoning, das über mehrere Züge hinweg im Kontext bleiben kann (
preserve_thinking), Tool-Calling mit einer dedizierten Grammatik. Das Modell unterstützt fünf Reasoning-Werte: "low", "medium" (Standard), "high", "xhigh" und "max".- Response-Template im Tokenizer.
- Speculative-Decoding-Drafter-Modell mit DFlash2
- Day-0-Bibliotheken: transformers, SGLang, vLLM. Full-Parameter-RL mit Miles.
- Wird ausgeliefert mit einem harness auf Rust-Basis.
- Apache 2.0.
Bauen mit Beam
Reflection wird $10,000 Hub-Credits an die besten Projekte vergeben, die Beam verwenden. Alles, was Sie tun müssen, ist, etwas zu bauen und es auf dem Hub zu teilen:
- Sie könnten eine Demo erstellen, die das Beam-Modell auf Spaces verwendet
- Sie könnten es für Ihre Lieblingshardware quantisieren
- Du könntest einen synthetischen Datensatz für dein Lieblingsproblem generieren
- Du könntest eine RL-Umgebung mit oder für Beam bauen
- Du könntest Beam benchmarken und die Ergebnisse teilen.
- Du könntest uns überraschen!
Wenn du etwas mit Beam baust, dann teile es auf dem Hub für die Chance, 10,000 $ zu gewinnen. Alles, was du tun musst, ist den Space, das Modell- oder Datensatz-Repository zu erstellen und es auf der Repository-Seite des Modells zu teilen. Wir werden alle Links sammeln, die besten auswählen und die Credits an deine Hub-Konten schicken.
Was ist Beam?
Beam ist ein reines Textmodell, das für Reasoning mit langem Kontext (1M Kontextlänge) und agentische Arbeit gebaut wurde. Es ist ein sparsames MoE-Modell, bei dem jeder Token von einem kleinen Teil des Netzwerks berechnet wird, sodass es mit der Geschwindigkeit eines viel kleineren Modells läuft und dabei die Kapazität eines großen behält.
Attention
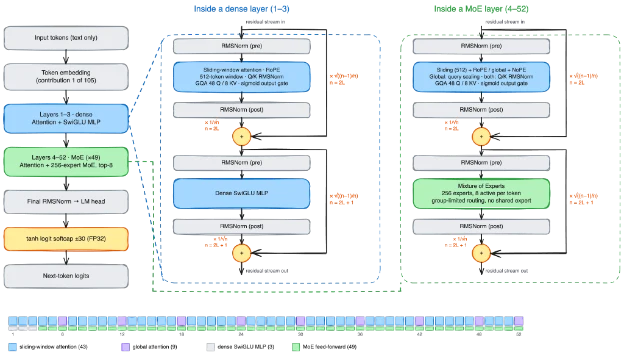
Der Decoder hat 52 Layer mit einer versteckten Größe von 5,120. Die meisten Layer verwenden Sliding-Window-Attention über die vorherigen 512 Token; jeder sechste Layer und der letzte Layer beachten den vollen Kontext. Das ergibt 43 Sliding-Window-Layer und 9 globale.
Innerhalb des Attention-Blocks (beide Layer-Typen)
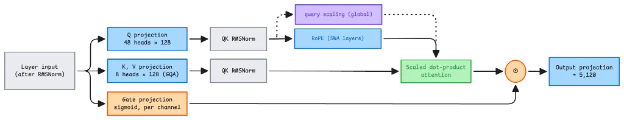
Die beiden Layer-Arten behandeln die Position unterschiedlich. Sliding-Window-Layer verwenden RoPE, da die relative Position innerhalb eines kurzen Fensters am wichtigsten ist. Globale Layer verwenden keine Positionskodierung. Stattdessen wird jede Query mit einem Skalierer multipliziert, der langsam mit der Anzahl der sichtbaren Token wächst, (1 + (pos + 1) / 2048) ** 0.1. Er wirkt als Temperatur: Das Softmax behält seine Präzision, während der Kontext länger wird, statt flach zu werden. Die Implementierung nennt dies skalierbares Softmax-Query-Scaling.
Die Attention verwendet Grouped-Query-Attention mit 48 Query-Köpfen und 8 Key-Value-Köpfen, mit RMSNorm auf Queries und Keys. Ein gelerntes Sigmoid-Gate, das aus der Layer-Eingabe berechnet wird, skaliert jeden Kanal jedes Kopfes vor der Ausgangsprojektion.
Mixture of Experts
Die ersten 3 Schichten verwenden ein dichtes SwiGLU-MLP. Die anderen 49 ersetzen es durch einen Mixture-of-Experts-Block mit 256 Experten, wobei jeder ein SwiGLU-MLP mit einer Zwischengröße von 2,560 bzw. etwa 39M Parametern ist. Die Experten halten 98.4 % der Parameter des Modells.
Der Router folgt dem gruppenlimitierten Schema von DeepSeek-V3. Er bewertet alle 256 Experten mit einer Sigmoid-Funktion, teilt sie in 8 Gruppen von je 32, behält die 4 besten Gruppen (rangiert nach der Summe der jeweils zwei besten Scores einer Gruppe) und wählt dann die Top-8-Experten darin aus. Beam verwendet dieselben Gruppengrößen wie DeepSeek-V3, aber keinen Shared Expert. Die Expertenausgaben werden mit normalisierten Router-Gewichten kombiniert und mit 2.5 skaliert.
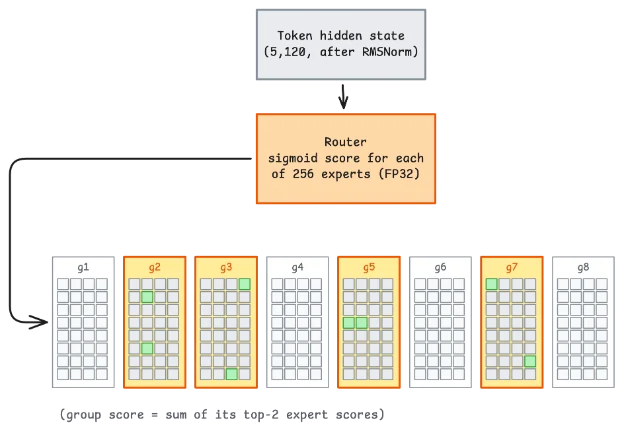
Pro Token laufen nur 8 Experten, daher berechnet das Modell jedes Token mit etwa 23B Parametern. Alle 256 Experten bleiben im Speicher, sodass für die Bereitstellung der Speicher eines 501B-Modells benötigt wird, aber mit der Geschwindigkeit eines 23B-Modells läuft. Der BF16-Checkpoint ist etwa 1 TB groß im safetensors-Format. Der NVFP4-Checkpoint speichert die meisten Parameter in 4-Bit-Präzision für NVIDIA-Blackwell-GPUs, einige Parameter bleiben der Genauigkeit halber in BF16. Auf dem Hub gibt es auch FP8-Checkpoints, die ideal für Chips der Hopper- und Ampere-Serie sind.
Wenn Sie Beam selbst bereitstellen möchten, sehen Sie sich die vLLM- oder SGLang-Rezepte unten an.
Residual Stream
Die Residual-Verbindungen sind der markanteste Teil. Ein Standard-Transformer fügt die Ausgabe jedes Sublayers mit dem Gewicht 1 zum Stream hinzu, sodass der Stream mit der Tiefe wächst.
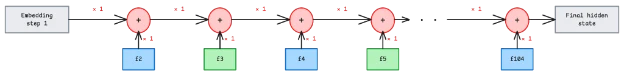
Beam zählt die Eingabe-Embedding als Schritt 1. Bei Schritt k fügt es die Sublayer-Ausgabe mit dem Gewicht 1/sqrt(k) hinzu und behält den bestehenden Stream mit dem Gewicht sqrt((k-1)/k). Die Quadrate der beiden Gewichte ergeben zusammen eins, sodass der Stream von der ersten bis zur letzten Schicht auf konstanter Skala bleibt. Nach allen 104 Additionen tragen jede Sublayer-Ausgabe und die Eingabe-Embedding dasselbe Gewicht im finalen Hidden State.
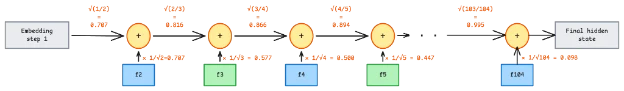
Jeder Sublayer wird außerdem davor und danach normalisiert, und die finalen Logits passieren einen tanh-Softcap bei ±30, berechnet in FP32. Die Implementierung legt fest, wo sie in FP32 rechnet: beim Router, beim SwiGLU-Produkt, bei den Norms, bei RoPE, bei der Query-Skalierung und beim Softcap.
Long Context
Hybride Attention eignet sich gut für lange Kontexte. Jede Schicht cache-t 2 x 8 KV heads x 128 dims = 2,048 Werte pro Token. Wenn alle 52 Schichten jedes Token behalten würden, würde der Cache um 208 KiB pro Token wachsen. Nur die 9 globalen Schichten behalten die gesamte Sequenz. Die 43 Sliding-Window-Schichten halten jeweils ein festes 512-Token-Fenster und hören auf zu wachsen. Der Cache wächst also um 36 KiB pro Token, etwa ein Sechstel der naiven Rate.
| Context | Wenn alle 52 Schichten global wären | Beam |
|---|---|---|
| 32K Token | 6.5 GiB | 1.2 GiB |
| 128K Token | 26 GiB | 4.6 GiB |
| Voller Kontext (1M) | 208 GiB | 36.08 GiB |
Diese Zahlen gelten pro Sequenz, in BF16, mit dem dynamischen Cache von transformers.
Benchmark-Ergebnisse
Hier sind die Benchmark-Ergebnisse über verschiedene Präzisionsstufen hinweg, wie vom Reflection-Team bereitgestellt.
| Beam (BF16) | Beam (FP8) | Beam (NVFP4) | |
|---|---|---|---|
| Agentic Coding / Terminal | |||
| DeepSWE v1.1 | 43.3% | 43.0% | 42.7% |
| SWE Bench Pro v2-Hard | 76.5% | 78.4% | 78.6% |
| SWE Bench Pro v1 | 66.1% | 65.9% | 65.6% |
| Terminal Bench v2.1 | 80.1% | 78.9% | 78.2% |
| SWE Atlas Codebase QnA | 31.8% | 32.2% | 31.4% |
| SWEBench Multilingual | 78.3% | 78.1% | 77.5% |
| SWEBench Verified | 81.6% | 80.2% | 80.7% |
| Reasoning | |||
| AIME 2026 | 97.7% | 98.0% | 97.5% |
| HLE (no tools) | 36.0% | 36.0% | 34.8% |
| HLE (with tools) | 51.1% | 51.1% | 51.1% |
| SciCode | 49.2% | 48.3% | 46.9% |
| CriPT AA | 16.3% | 17.4% | 15.4% |
| GPQA Diamond | 90.6% | 90.3% | 89.3% |
| LiveCodeBench | 88.3% | 88.1% | 87.4% |
| Tool Calling / Search | |||
| AutomationBench - nur öffentlicher Split | 39.3 | 38.2 | 39.8% |
| MCP Atlas | 80.8% | 81.5% | 80.5% |
| Tau3 Banking | 36.1% | 36.8% | 35.4% |
| BrowseComp w/ context management | 76.8% | 76.7% | 75.6% |
| DeepSearchQA w/ context management | 80.5% | 79.6% | 81.1% |
| General Capabilities | |||
| AA-LCR | 78.2% | 79.4% | 78.7% |
| LongBench v2 | 67.5% | 67.6% | 67.2% |
| IFBench | 79.6% | 80.7% | 79.2% |
| AA Omniscience (index) - nur öffentlicher Split | 10.8 | 8.8 | 9.8 |
Hardware Requirements
Der praktischste Weg, das Modell bereitzustellen, ist das Ausliefern des NVFP4-Checkpoints, der den Großteil der Qualität des bf16-Checkpoints beibehält. NVFP4 speichert einige Gewichte in 4 Bit, und auf diese Weise verkleinert es die 501B Parameter in BF16 von 1 TB auf ~280 GB. Blackwell-GPUs führen NVFP4 nativ aus, aber GPUs, die älter als Blackwell sind, wie die H200, können dies nicht. Die FP8-Checkpoints sind für GPUs geeignet, die älter als Blackwell sind.
Eine B200 verfügt über 180 GB HBM3e, sodass zwei davon (360 GB) die Beam-Gewichte halten können, mit wenig Raum für Aktivierungen und den KV-Cache. Planen Sie mit vier B200s (720 GB), was reichlich Raum für lange Kontexte und gleichzeitige Anfragen lässt. Sie können es auch auf einem vollständigen 8xB200-Knoten betreiben, oder auf zwei B300s mit jeweils 288 GB, oder sogar auf 8xRTX Pro 6000. Wenn Sie keine Blackwell-Hardware haben, nutzen Sie Inference Providers (serverless), um Reflection zu testen.
Inference Support
Beam wird mit Day-0-Unterstützung in transformers, SGLang und vLLM ausgeliefert.
Transformers
Installieren Sie die neueste Version von transformers.
pip install -U "transformers>=5.20.1"
Der einfachste Weg, Beam auszuführen, ist die Text-Generation-Pipeline:
from transformers import pipeline

pipe = pipeline(
    "text-generation", model="reflectionai/Beam-1.0-501B-A23B", device_map="auto"
)

messages = [
    {"role": "user", "content": "Write a limerick about Python exceptions."}
]
output = pipe(messages, max_new_tokens=2000)
output[0]["generated_text"][-1]
Die Pipeline gibt den gesamten Chat zurück. Die letzte Nachricht ist Beams Antwort, die bereits von der Response-Template geparst wurde.
Eine Ebene tiefer verwenden Sie AutoModelForCausalLM und AutoTokenizer.
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "reflectionai/Beam-1.0-501B-A23B"
tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype="auto", device_map="auto"
)
Chat
messages = [
    {"role": "system", "content": "You should only answer with a number."},
    {"role": "user", "content": "What is 17 * 23?"},
]

inputs = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
    reasoning_effort="medium" # by default
).to(model.device)

input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=2000)

tokenizer.parse_response(
    outputs[0][input_len:], prefix=inputs["input_ids"][0]
)
Beams Tokenizer enthält eine Response-Vorlage. parse_response liest sie und wandelt die rohe Ausgabe in ein Message-Dict um, mit dem Reasoning, der Antwort und etwaigen Tool-Aufrufen in separaten Feldern. Das erspart die übliche Regex zum Trennen von Reasoning, Antworten und Tool-Aufrufen. Und die Regeln werden mit dem Tokenizer ausgeliefert, sodass die geparste Struktur dem entspricht, worauf Beam trainiert wurde. Die Chat-Vorlage kann einen Teil des Assistant-Turns vorab schreiben, den der Parser sehen muss.
Tool-Aufrufe
Vollständiges Tool-Calling-Beispieldef get_weather(city: str, unit: str = "celsius"):
"""
Get the current weather for a city.
Args:
city: The city to look up.
unit: Temperature unit, "celsius" or "fahrenheit".
"""
...
tools = [get_weather]
messages = [
{"role": "user", "content": "I land in Paris tonight. Do I need a coat?"}
]
inputs = tokenizer.apply_chat_template(
messages,
tools=tools,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
).to(model.device)
input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=1000)
message = tokenizer.parse_response(
outputs[0][input_len:], prefix=inputs["input_ids"][0], tools=tools
)
message.get("tool_calls")
Übergeben Sie tools an parse_response ebenso. Beam schreibt Tool-Call-Argumente inline, in seiner eigenen XML-artigen Grammatik, sodass ein nacktes 7 eine Zahl oder ein String sein könnte. Mit den Tool-Schemas wandelt der Parser jedes Argument in seinen deklarierten Typ um.
Multi-GPU und Multi-Node
Beams Konfiguration definiert einen Expert-Parallelism-Plan. Expert Parallelism legt jeden Experten auf ein Gerät. Attention, die dichten Schichten, die Embeddings und der LM-Kopf werden auf jedem Gerät repliziert. Das sind 8B Parameter, bzw. 16 GB in BF16. Laden Sie das Modell mit einem DistributedConfig:
import os

from transformers import AutoModelForCausalLM
from transformers.distributed import DistributedConfig

model = AutoModelForCausalLM.from_pretrained(
    "reflection/Beam-1.0-501B-A23B",
    distributed_config=DistributedConfig(
        tp_size=int(os.environ["WORLD_SIZE"]), enable_expert_parallel=True
    ),
)
Starten Sie das Skript mit torchrun auf 16 H200 GPUs. Dann hält jede davon 78 GB an Gewichten. Mit 8 GPUs würde jede 139 GB halten, was auf einer 141 GB H200 keinen Platz mehr lässt. Die Anzahl der Geräte muss die Anzahl der Experten, 256, teilen.
vLLM
Beam hat Day-0-Unterstützung in vLLM. Der folgende Befehl serves das BF16-Checkpoint mit Tensor Parallelism über 16 GPUs (zwei 8x H200 Nodes) und stellt eine OpenAI-kompatible API bereit:
vllm serve reflection/Beam-1.0-501B-A23B --tensor-parallel-size 16 --served-model-name beam
Für schnellere Generierung fügen Sie DFlash2 Speculative Decoding hinzu. Ein kleines Drafter-Modell schlägt bis zu 15 Tokens im Voraus vor, und Beam prüft sie alle in einem einzigen Forward Pass, sodass jeder Schritt mehrere Tokens akzeptieren kann. Der Preis ist etwas zusätzlicher Speicher für den Drafter:
vllm serve reflection/Beam-1.0-501B-A23B \
  --tensor-parallel-size 16 \
  --speculative-config '{ "method": "dflash", "model": "reflection/dflash2-drafter-preview", "num_speculative_tokens": 15 }'
Beide Befehle starten einen OpenAI-kompatiblen Server, sodass Sie jeden OpenAI-Client auf http://localhost:8000/v1richten können. Weitere Serving-Konfigurationen finden Sie im vorgeschlagenen Beam-Rezept für vLLM.
SGLang
Beam hat auch Day-0-Unterstützung in SGLang. Wir empfehlen, es mit DFlash2 Speculative Decoding zu betreiben, was beide folgenden Befehle einschalten. Auf Blackwell passt das NVFP4-Checkpoint auf 4 B300s:
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-NVFP4 \
--served-model-name beam \
--tp 4 \
--attention-backend trtllm_mha \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
Auf Hopper GPUs verwenden Sie stattdessen das FP8-Checkpoint auf 8 H200s. Nur drei Flags ändern sich: das Checkpoint, die Tensor-Parallel-Größe (8 statt 4) und das Attention-Backend (fa3 statt trtllm_mha, das Blackwell benötigt):
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-FP8 \
--served-model-name beam \
--tp 8 \
--attention-backend fa3 \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
Inference Providers
Beam ist auf Hugging Face Inference Providers verfügbar, powered by Baseten, Fireworks und Together, mit weiteren, die bald folgen.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
)

completion = client.chat.completions.create(
    model="reflection/Beam-1.0-501B-A23B:auto",
    messages=[{"role": "user", "content": "What is the capital of France?"}],
)

print(completion.choices[0].message)
Inference Endpoints
Wir haben ein Beam-Rezept für Sie eingerichtet, das Sie mit einem Klick in Inference Endpoints aus dem Katalog in FP8 oder NVFP4deployen können, oder installieren Sie mit dem hf cli wie folgt:
hf endpoints catalog deploy --repo reflection/Beam-1.0-501B-A23B --name beam
Was wir getestet haben
Wir teilen einige Vibe-Evals von Reflection Beam-501B-A23B zu fünf Aufgaben, jeweils einmal mit niedrigem und hohem Reasoning-Aufwand über die Reflection-Plattform. Dies sind Vibe-Evals, keine Benchmarks. Wenn Sie vorhaben, Beam zu verwenden, ist dies eine großartige Möglichkeit, das Modell auszuprobieren und zu sehen, wie es sich bei bestimmten Anwendungsfällen verhält – und vor allem, wo es gewinnt und verliert.
Nachfolgend finden Sie einen Überblick über die Prompts, die wir ausgeführt haben, und die Output-Traces aus dem Hub. Die vollständigen Eingaben, Ausgaben, API-Nutzung, Task-Fixtures, Grader und Konversations-Traces befinden sich in diesem öffentlichen Hugging Face Bucket.
| Kategorie | Beschreibung des Prompts | Niedriges Reasoning (Tokens) | Hohes Reasoning (Tokens) |
|---|---|---|---|
| Mehrstufiger Tool-Aufruf | Erfüllen Sie ORD-742: Vergleichen Sie Bestände, Reservierungen, Zuschläge und Ankunftsdaten; reservieren Sie das günstigste geeignete Lager. | ✅ 544 | ✅ 811 |
| Abruf mit langem Kontext über eine Codebasis | Ableiten der Click-Befehlskonfiguration und zweier Aufrufergebnisse aus drei vollständigen Quelldateien; zitieren Sie sechs Implementierungssymbole. | 🔴 1,613 * | ✅ 5,007 |
| Terminal-Aufgabe in einer Sandbox | Inspectieren und Reparieren einer CSV-Ledger-CLI; alle Bugs beheben, Tests beibehalten, Tests und eine CLI-Prüfung ausführen. | ✅ 582 | ✅ 1,548 |
| Mathematisches Denken (AIME-Stil) | Wie viele acht-elementige Teilmengen von {1, …, 16} haben eine durch 17 teilbare Summe? Geben Sie eine Begründung an. | 🟠 829 † | ✅ 2,809 |
| Strukturierte Ausgabe | Konvertieren Sie ein ungeordnetes Revisionsprotokoll in striktes JSON: Patches zusammenführen, Stornierungen, Nullwerte, Daten, Währungen und Summen. | ✅ 1,040 | ✅ 2,088 |
* Lows Antwort mit langem Kontext enthielt das gesamte Codeverhalten und alle sechs Quellenzitate korrekt. Allerdings entsprach die Antwort nicht dem Format des Parsers, daher liegt dies teilweise an der Mehrdeutigkeit des Prompts.
† Low lieferte die richtige Antwort, ließ jedoch die verlangte Begründung weg. High lieferte einen korrekten Einheitswurzel-Beweis, der unabhängig überprüft wurde.
Verlassen Sie sich nicht nur auf unser Wort. Sehen Sie sich den bucketgenau an, schreiben Sie ihn für Ihren Anwendungsfall oder Ihr Projekt um und bringen Sie Beam an seine Grenzen.
Post-Training von Beam
Sie können Beam auf Ihre eigenen Anwendungsfälle fine-tunen. Hier teilen wir einige Beispiele in TRL und Miles, um Ihnen den Einstieg in supervised fine-tuning und reinforcement learning zu erleichtern.
SFT mit TRL
Der schnellste Weg, Beam an Ihre eigenen Daten anzupassen, ist supervised fine-tuning mit TRLs SFTTrainer. Um den Speicherbedarf beherrschbar zu halten, trainieren wir LoRA-Adapter mit PEFT, anstatt alle 501B Parameter zu aktualisieren:
Wir haben TRLs SFTTrainer verwendet, um Beam an ein einfaches Ziel anzupassen: sein Reasoning in der vom Nutzer gewünschten Sprache zu halten. Wir haben auf Multilingual-Thinking mit LoRA fine-getunt, wodurch eine kleine Menge an Adapter-Gewichten trainiert wird, während das Basismodell eingefroren bleibt.
Das Setup kombiniert Modell-Sharding beim Laden, Expert Parallelism, FlashAttention 4 und Sequence Packing. LoRA SFT passt auf einen einzelnen Knoten mit 8 B300 GPUs und erreicht etwa 19,000 Token pro Sekunde. Das entsprechende H100-Setup verwendet vier Knoten.
Nach einer Epoche von Multilingual-Thinking reasoningte Beam bei 16 von 16 zurückgehaltenen Prompts in der gewünschten Sprache, verglichen mit 3 von 16 beim Basismodell. Diese kleine Evaluierung misst die Einhaltung der Sprache, nicht die Korrektheit des Reasonings selbst.
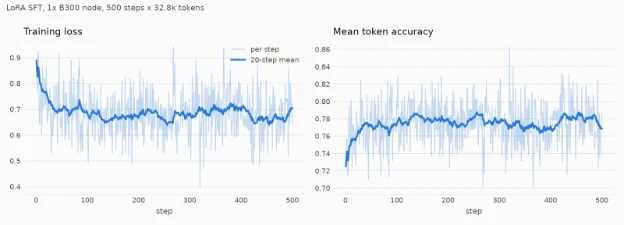
Training Loss (links) und mittlere Token-Genauigkeit (rechts) während eines separaten 500-Schritte-Runs auf einem Reasoning-Subset von open-r1/Mixture-of-Thought unter Verwendung eines 8-GPU-B300-Knotens. Diese Trainingsmetriken stammen aus dem offiziellen TRL example PR.
GRPO mit Miles
Reflection und RadixArk haben ein Rezept entwickelt, das das Modell mit GRPO in Miles in BF16 trainiert. Sie können das vollständige Modell aktualisieren oder mit LoRA Adapter trainieren, während die Basisgewichte eingefroren bleiben. Megatron trainiert, SGLang erzeugt die Rollouts, und Miles veröffentlicht die neuen Gewichte nach jedem Update an die Rollout-Engines. Wir haben das Rezept überprüft.
| Workload | Referenzkonfiguration |
|---|---|
| Inferenz / Eval, BF16 | 16x H200 pro Engine |
| Full-Parameter GRPO, BF16 (Miles) | 96x H200: 64 Train, 32 Rollout. Oder 64x H200 kolokalisiert. |
| LoRA GRPO, BF16 (Miles) | 32x H200: 16 Train, 16 Rollout. |
| Full-Parameter GRPO, BF16, 128-Token-Kontext (Miles) | 48x H200: 32 Training, 16 Rollout. Das Setup wurde von Reflection und RadixArk zuerst am echten Checkpoint validiert. |
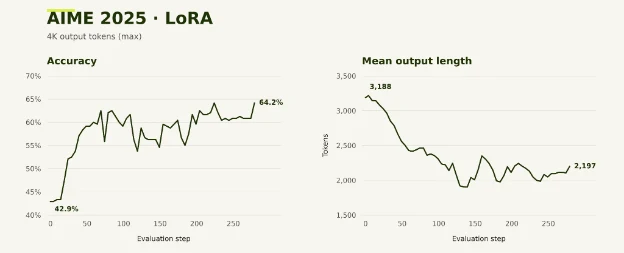
Das Rezept führt GRPO auf DAPO-Math-17K aus und evaluiert auf AIME25. Image bauen, Daten herunterladen und den Job an einen Ray-Cluster aus zwölf 8x H200-Knoten übergeben:
docker build -f docker/Dockerfile.beam -t miles-beam .

python scripts/run_beam.py prepare \
  --model-id reflection/Beam-1.0-501B-A23B \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets

export MASTER_ADDR=10.0.0.1
export RAY_ADDRESS=http://${MASTER_ADDR}:8265

python scripts/run_beam.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
Was in einem Rollout passiert:
Sample: 32 Prompts werden mit jeweils 8 Antworten an das Modell übergeben. Zwei SGLang-Engines bedienen die Rollouts auf jeweils 16 GPUs.
Score: die boxed Antwort wird gegen das Label geprüft, mit einer sanften Strafe für Antworten nahe am Längenlimit.
Update: ein Optimizer-Schritt auf allen 256 Samples. Gruppenrelative Vorteile mit truncated importance sampling, kein KL- oder Entropy-Penalty.
Trainieren Sie parallel: Tensor-Parallelismus 8, Expert-Parallelismus 8, Data-Parallelismus 8, mit Sequence Parallelism und vollem Recompute.
Optimierer: Adam mit konstanten 1e-6. Gradienten in BF16, Master-Gewichte in FP32, Momente in BF16. Der Optimizer-State wird über node-lokales NVMe gestreamt, daher benötigt jeder Trainer-Knoten 2 TB Scratch-Speicher.
Auswertung: AIME25 alle fünf Rollouts, acht Samples pro Aufgabe. Ein Checkpoint wird alle zwanzig gespeichert.
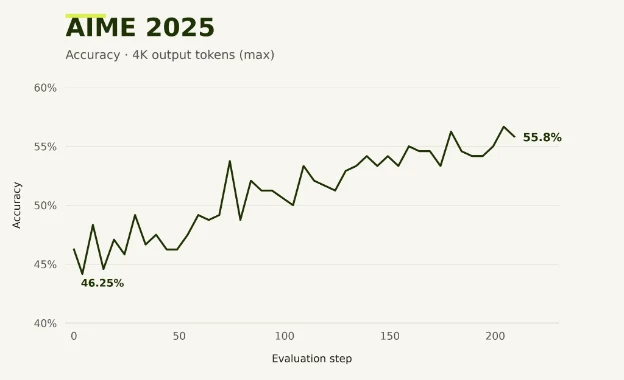
Der nächste Rollout wird generiert, während der aktuelle trainiert, sodass die Antworten einen Update hinterher sind. Fügen Sie --resume hinzu, um vom letzten Checkpoint fortzusetzen. execute-colocate führt dasselbe Rezept auf acht Knoten aus, wobei jede GPU abwechselnd trainiert und serving betreibt.
Trainieren mit LoRA
Sie können GRPO auch mit LoRA auf vier 8× H200-Knoten ausführen: 16 GPUs für Training und 16 für Rollouts. Das Rezept trainiert Rank-16-Adapter auf Beams Attention-, Dense-MLP- und Expert-Layern, während die Basisgewichte eingefroren bleiben. Nur die Adapter-Gewichte werden mit SGLang synchronisiert, und der Optimizer-State bleibt im GPU-Speicher, wodurch das NVMe-Offloading des Optimierers entfällt.
python scripts/run_beam_lora.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
Bauen mit Beam: Demos
Wenn Sie etwas mit Beam bauen, dann teilen Sie es auf dem Hub, um eine Chance auf 10,000 $ zu haben. Sie müssen nur einen Space-, Modell- oder Dataset-Repo erstellen und es auf der Repo-Seite des Modellsteilen. Um Sie zu inspirieren, hier ein paar Dinge, die wir gebaut haben.
Hey Beam, baue eine native lokale MacOS-Anwendung!
Bei Hugging Face lieben wir offene und lokale Modelle, die nativ auf ihrer Hardware laufen, aber das Bauen nativer Apps auf dem Mac kann schwierig sein! Sehen wir uns an, ob uns Beam helfen kann.
Wir haben Beam gebeten, eine native MacOS-Anwendung zu bauen, die Sprache in Text umwandelt und ihn bequem an Ihrem Cursor einfügt. Wir möchten MLX verwenden, um das Beste aus unserem Mac Metal herauszuholen, und das Parakeet-Modell für hervorragende Speech-to-Text-Funktionen.
Build BeamSpeak, a native macOS menu bar dictation app with a compact recording pill and no main window or account.

Use ⌘⇧Space to start and stop microphone recording, showing elapsed time, microphone level, and transcription status. Run speech recognition entirely locally using a Hugging Face model, preferably Parakeet v3 through MLX, and keep the model loaded between recordings. Paste the transcript into the original app if it remains focused and Accessibility permission is granted; otherwise copy it to the clipboard, preserving newer clipboard changes and never pressing Enter. Handle permissions, cancellation, silence, errors, a two-minute recording limit, and temporary audio cleanup. Deliver source code, a runnable BeamSpeak.app, setup instructions, and verification of offline transcription, the physical shortcut, microphone capture, and text delivery.
Wir haben Beam mit dem Pi-Coding-Harness verwendet, um die anfängliche native macOS-Menüleisten-App zu bauen, die Parakeet mit MLX ausführt. Der gespeicherte Lauf enthält Folge-Prompts; der finale Quellcode umfasst auch spätere Codex-Reparaturen. Der obige Prompt ist eine komprimierte Version der Build-Anforderungen.
Sie können sich den Agent-Trace ansehen, wie Beam dies in pi gebaut hat, in diesem Trace. Wenn Sie die Demo ausprobieren möchten, laden Sie den Quellcode herunter oder lesen Sie die Setup-Anweisungen.
Hey Beam, wie skalierst du mit mehreren Agenten?
Wir wollten sehen, ob Beam schnelleren Fortschritt erzielen kann, indem es eine Programmieraufgabe auf mehrere Agenten aufteilt. Wir haben Beam mit dem Open-Source-Pi-Coding-Agenten kombiniert und drei Setups verglichen: 1. ein Agent, der allein arbeitet, 2. fünf persistente Peers, die über ein gemeinsames Git-Repository kollaborieren, und 3. ein Lead-Agent, der Arbeit an asynchrone Subagenten delegiert. Der Harness lief auf Hugging Face Jobs mit Inferenz über Reflections Plattform-API.
Für die Aufgaben verwendeten wir ProgramBench: Die Agenten müssen ein Programm aus seiner kompilierten ausführbaren Datei und seiner Dokumentation nachbauen, ohne den Quellcode oder die Tests des Evaluators zu sehen. Jedes Setup hatte dasselbe Limit von 8M API-Tokens und ein Two-Hour-Solver-Limit pro Aufgabe, das sich seine Agenten teilten. Wir speicherten Implementierungs-Snapshots und evaluierten sie gegen feste, versteckte Test-Suiten aus dem ProgramBench-Tests-Dataset.
Unser Score-versus-Latenz-Diagramm zeigt den durchschnittlichen Anteil bestandener Tests. Die Zeitachse verwendet feste Referenzraten für Modell-Tokens plus gemessene Tool-Zeit, nicht die verstrichene Wanduhrzeit. Wir führten zunächst fünf Aufgaben aus. Die aktuelle Abbildung zeigt eine Post-hoc-Teilmenge aus jq, xsv, FIGlet und hexyl; ripgrep wurde in allen drei Setups ausgeschlossen, weil die Bewertung seiner gespeicherten Artefakte zu langsam war. Die veröffentlichten Ergebnisse behalten alle 15 ursprünglichen Episoden bei.
Sie können die Läufe in den Trackio-Dashboard, erkunden Sie die veröffentlichte Ergebnisdaten, und die Studien-Testumgebung.
Hey Beam, feintune ein Entscheidungsmodell für meine Codebasis!
Entscheidungsmodelle sind derzeit in aller Munde, weil sie superschnell und praktisch für viele Anwendungsfälle sind. Wir begannen mit Beam, fuhren dann mit GLM-5.3 in Pi fort, nachdem Beams Kontingent aufgebraucht war, um ein benutzerdefiniertes Entscheidungsmodell für die Triagierung von Entwicklerzwischenfällen zu trainieren und auszuwerten.
Wir wollten herausfinden, ob ein Coding-Agent eine Incident-Triage-Richtlinie in ein kleines, schnelles Entscheidungsmodell umwandeln kann. Die Aufgabe bestand darin, einen Entwickler-Incident zu lesen und das verantwortliche Team, dessen Schweregrad und ob jemand sofort benachrichtigt werden sollte, auszuwählen. Mit Unsloth haben wir Qwen3.5-0.8B fine-getunt, um diese Entscheidungen direkt zu bewerten.
Zuerst erstellte der Workflow einen synthetischen Datensatz mit 2.3k Incidents, aufgeteilt nach Incident-Clustern für Training, Kalibrierung und Tests. Wir trainierten einen LoRA-Adapter und einen Decision Head über drei Epochen, mit einem 4-bit Backbone, auf einem H100 80GB im Science Slurm Cluster.
Als Baseline gaben wir dem unadaptierten Modell die vollständige Triage-Richtlinie und das Ticket ohne Beispiele als Prompt und baten es, die drei Entscheidungen als JSON zu generieren. Auf denselben 320 synthetischen Testtickets hatte das fine-getunte Entscheidungsmodell alle drei Antworten zu 76.25% korrekt, gegenüber 4.69% beim prompted zero-shot. Die mittlere Ticket-Latenz sank von 1,218.06 ms auf 102.58 ms, eine 11.9-fache Beschleunigung.
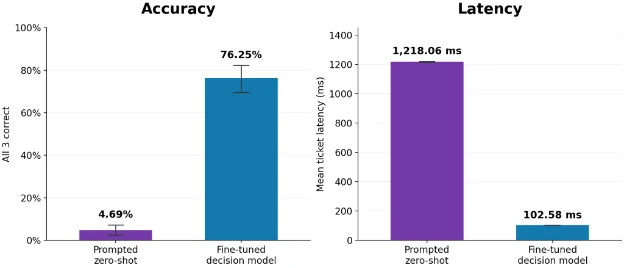
Wenn Sie dieses Experiment selbst ausprobieren möchten, schauen Sie sich den Artifact Bucket an, der die Daten, den Code, die Checkpoints und die Ergebnisse enthält.
Fazit
Beam ist ein offenes Modell mit 501B, das Sie auf Ihrer eigenen Hardware ausführen und verändern können. Beginnen Sie mit dem BF16 Checkpoint oder probieren Sie eine der Quants FP8, NVFP4. Wenn Sie etwas mit Beam bauen, teilen Sie es im Discussions-Tab.