
TL;DR: Reflections Beam ist ein MoE-Modell mit 501B Parametern und 23B aktiven Parametern pro Token. vLLM unterstützt es ab Tag 0 und optimiert es auf NVIDIA Blackwell:
- Vollständige Funktionsunterstützung. Reasoning, Tool Calling und strukturierte Ausgaben funktionieren sofort, und Sie können das Modell mit Tensor-, Daten- oder Expertenparallelität betreiben.
- Agentengetriebene Optimierung. Coding-Agents optimierten das Modell autonom und machten Batch-1-Decode 2.71× schneller und Prefill 1.87× schneller als unsere erste Implementierung.
- DFlash2 mit adaptiver Verifikation. Mit Beams DFlash2-Drafter erreicht eine einzelne Anfrage 708 Token/s auf TP8, mit einer Akzeptanzlänge von 3.7. Adaptive Verifikation, die bei jedem Schritt entscheidet, wie viele Draft-Token sich zu verifizieren lohnen, bringt 10 % mehr Durchsatz bei hoher Konkurrenz.
Zum Ausprobieren verwenden Sie unser Docker-Image vllm/vllm-openai:reflection-beam:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:reflection-beam \
  reflection/Beam-1.0-501B-A23B-NVFP4 \
  -tp 4 \
  --max-num-seqs 128 \
  --reasoning-parser beam \
  --tool-call-parser beam --enable-auto-tool-choice \
  --kv-cache-dtype fp8 \
  --attention-config '{"backend":"FLASHINFER"}' \
  --kernel-config '{"enable_flashinfer_autotune":false}' \
  --speculative-config '{
    "method": "dflash",
    "model": "reflection/Beam-1.0-501B-A23B-DFlash2",
    "num_speculative_tokens": 7,
    "attention_backend": "FLASH_ATTN"
  }'
Modellarchitektur
Beam ist ein MoE-Decoder mit 52 Schichten und Hidden Size 5120. Das MoE-Routing folgt DeepSeek-V3. Die Hauptunterschiede liegen in den Attention-Schichten und in der Normalisierung des Residual-Streams.
Abbildung 1: Beams Schichtenstapel und eine spärliche Decoder-Schicht. Gold markiert die Teile, die sich von einem standardmäßigen Pre-Norm-MoE unterscheiden. Vollbild öffnen.
Attention
- Hybride Sliding-Window- und NoPE-Schichten. 43 Schichten verwenden Sliding-Window-Attention über die letzten 512 Token, mit RoPE. Die anderen 9 (jede sechste Schicht, plus die letzte) beachten den gesamten Kontext mit keiner Positionskodierung (NoPE).
- SSMax auf NoPE-Schichten. Ohne RoPE flacht die Attention ab, wenn die Anzahl der Keys wächst. SSMax skaliert jede Query mit
(1 + p/2048)^0.1, wobeipdie 1-basierte Position ist, sodass die Softmax schärfer wird, während der Kontext wächst. - GQA mit Per-Head-Q/K-Norm. 48 Query-Heads, 8 KV-Heads, Head-Dim 128. Q und K werden pro Head mit RMS normalisiert, bevor RoPE oder SSMax angewendet wird.
- Sigmoid-Output-Gate. Vor
o_proj, wobei der Output jedes Kopfes mit σ(gate + bias) multipliziert wird, wobei das Gate aus seiner eigenen voll breiten Projektion mit einem gelernten Bias pro Kopf stammt. Ein Kopf kann Token für Token heruntergeregelt oder abgeschaltet werden. - Kleiner KV-Cache. Nur die 9 Full-Attention-Schichten behalten KV für die gesamte Sequenz:
- 9 × 2 × 8 × 128 Werte pro Token, also 36 KiB in BF16 und 18 KiB in FP8.
- Etwa 18 GiB FP8-KV für einen vollständigen 1M-Token-Kontext, vor Sharding.
MoE und Residual-Stream
- MoE im DeepSeek-V3-Stil. 256 geroutete Experten (d_ff 2,560, NVFP4), geroutet auf die gleiche Weise wie bei DeepSeek-V3: Sigmoid-Scores plus ein Correction-Bias wählen die besten 4 von 8 Expertengruppen, dann die Top-8-Experten, und die renormalisierten Gewichte werden mit 2.5 skaliert. Anders als bei DeepSeek-V3 gibt es keinen Shared Expert. Die Schichten 0–2 verwenden stattdessen ein dichtes SwiGLU-MLP (d_ff 20,480).
- FP32-Router. Die Router-Gewichte, die Akkumulation und die Logits von 5120 × 256 sind alle FP32.
- Sandwich-Norm. Jede Sublayer hat ein RMSNorm davor und ein weiteres danach.
- Tiefenskalierte Residuen. Die n-te Residual-Addition berechnet
h ← √((n−1)/n)·h + x/√nstatth + x. Bei Sublayer-Ausgaben mit Einheitsvarianz behält der Residual-Stream bei jeder Tiefe die Einheitsvarianz, statt mit ihr zu wachsen.
Agentengetriebene Optimierung
Unsere erste Implementierungsversion war eine unoptimierte, fast reine PyTorch-Version des Modells. Anschließend optimierten wir sie autonom mit Coding-Agents: Sie profilierten das Modell, schrieben die Kernels und benchmarkten jede Änderung. Auf TP8 brachten die sieben Änderungen unten den Batch-1-Decode von 8.95 ms auf 3.30 ms pro Schritt und einen 8 × 2K-Prefill von 328 ms auf 176 ms.
Abbildung 2: TP8-Model-Forward-Latenz auf GB200 nach jeder Änderung, für Batch-1-Decode und einen 8 × 2,048-Token-Prefill bei ~100K Kontext. Die beiden Paneele verwenden unterschiedliche Skalen. Zeigen Sie die Tabelle für exakte Werte an, oder öffnen Sie sie im Vollbild.
- Fusierte Norm → Residual → Norm (−40 % Decode). Das Post-Norm, die skalierte Residual-Addition und das nächste Pre-Norm an jeder der 104 Sublayer-Grenzen laufen jetzt als ein Triton-Kernel, mit FP32-Mathematik und den BF16-Rundungspunkten der Referenz.
- Fusiertes Q/K-Norm, RoPE/SSMax und Output-Gate. Das RMSNorm pro Kopf für Q/K und RoPE (oder SSMax) laufen als ein Kernel, und das Sigmoid-Gate als ein anderer.
- All-Reduce in die Normen fusiert. Beide TP-All-Reduces in jeder Schicht laufen innerhalb des Norm-Kernels, aufbauend auf FlashInfer's Multicast-All-Reduce. Nach dem MoE kombiniert derselbe Kernel auch die Top-8-Experten-Outputs.
- Spezialisiertes GEMM-Kernel für den FP32-Router. Der Router fiel zuvor auf einen generischen Pfad zurück. vLLM's FP32-Router-Kernel für kleine Batches unterstützt jetzt Beams 5120 × 256-Form und behält FP32-Gewichte, Akkumulation und Logits bei.
- Zusammengeführte QKV- + Gate-Projektion mit einem Low-Latency-GEMM. Die Q-, K-, V- und Gate-Gewichte werden beim Laden in eine Matrix gepackt, sodass die vier Projektionen als ein GEMM laufen. Für kleine Batches verwendet es ein Low-Latency-CuTe-DSL-GEMM oder FlashInfer's TinyGEMM.
- Fused KV-Cache-Update. Der Q/K-Norm- und RoPE-Kernel schreibt nun auch K und V in den KV-Cache, sodass es keinen separaten Cache-Write-Kernel mehr gibt.
- Dense-MLP-Aktivierung in einem Kernel für die drei dichten Layer.
Der fusionierte Graph
Nach diesen Änderungen läuft ein MoE-Layer als 13 Kernel im Batch-1-Decode auf TP8.
Abbildung 3: Kernel in Launch-Reihenfolge für einen MoE-Layer, aus einem Rank-0-Trace eines Batch-1-TP8-Decodes. Goldene Kernel wurden für Beam geschrieben, fusioniert oder erweitert. Jeder Kernel listet die Operationen auf, die er berechnet. Vollbild öffnen.
- 6 Kernel wurden für Beam geschrieben, fusioniert oder erweitert. Jede kleine Beam-spezifische Operation ist in einen Nachbarn verschmolzen, und beide All-Reduces befinden sich innerhalb von Norm-Kernels.
- 7 Kernel stammen aus Bibliotheken: TRTLLM-gen-Attention, die cuBLAS-Output-Projektion und den TRTLLM-NVFP4-MoE-Pfad (Quantisierung, zwei Routing-Kernel, zwei grouped GEMMs). Der Großteil der verbleibenden Zeit liegt hier, daher sind diese als Nächstes dran.
Attention DP + MegaMoE
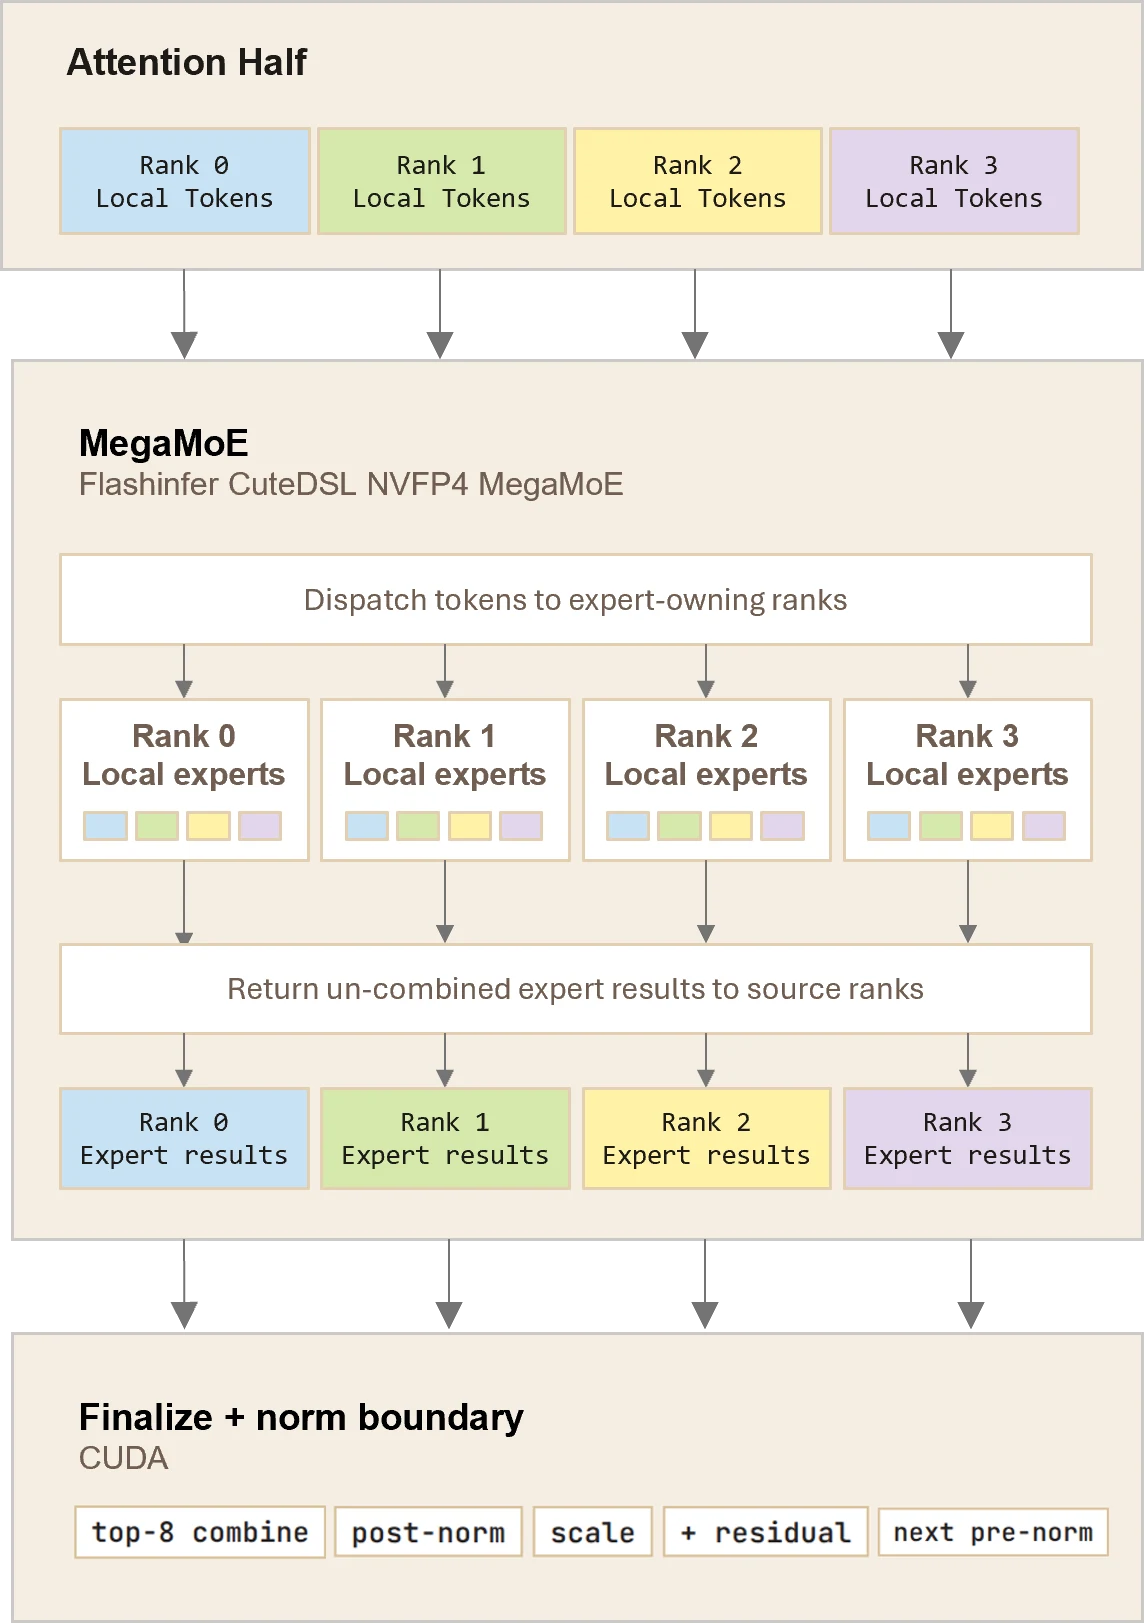
Abbildung 4: FlashInfer CuteDSL NVFP4 MegaMoE kann die Kommunikation mit der Expertenberechnung fusionieren.
Im Bereich hoher Concurrency kann die Leistung von Beam weiter verbessert werden, indem Attention DP mit MegaMoE kombiniert wird, angetrieben durch FlashInfers CuTe-DSL-NVFP4-MegaMoE-Kernel. Die Finalize-+-Norm-Boundary-Fusion bleibt anwendbar.
| Konfiguration | Maximaler Input-Token-Durchsatz |
|---|---|
| Attention DP + MegaMoE | 168.8K Tokens / Sekunde |
TP (flashinfer_trtllm, flashinfer_nvlink_one_sided) | 98.7K Tokens / Sekunde |
Attention DP mit MegaMoE lieferte einen 1,71× höheren maximalen Prefill-Durchsatz als TP4. Benchmark-Setup: 4×GB300, mit einer Input-Sequenzlänge von 32K Tokens und einer Output-Sequenzlänge von 1 Token, um die Prefill-Leistung zu isolieren.
Um Attention DP + MegaMoE zu aktivieren, ersetzen Sie die MoE- und Parallelitäts-Einstellungen durch:
  --moe-backend flashinfer_moe_ep_cutedsl \
  --data-parallel-size 4 \
  --enable-expert-parallel
DFlash2 Speculative Decoding
Beam wird mit einem DFlash2 -Draft-Head ausgeliefert, den vLLM ab Tag 0 unterstützt. Statt jeweils ein Token zu entwerfen, sagt er in einem einzigen Forward-Pass einen ganzen Block von Tokens aus den Hidden States des Zielmodells voraus.
- Drafter. 5 Sliding-Window-Layer, die Hidden States aus 5 Ziel-Layern lesen und sich Embedding und LM-Head des Ziels teilen. Eine grouped Convolution und ein kleiner Candidate-Selector stellen einen Teil der Links-nach-rechts-Abhängigkeit wieder her, die ein paralleler Drafter verliert.
- Adaptive Verifikation. Mit
"enable_adaptive_verification": truesagt vLLM voraus, wie wahrscheinlich jeder Draft-Token akzeptiert wird, und verifiziert nur diejenigen, die ihre Kosten wert sind, anstelle einer festen Anzahl pro Schritt. DFlash2 hat keinen Confidence-Head, daher stammt die Akzeptanzschätzung aus den eigenen Logits des Drafters (siehe unseren kürzlichen Beitrag zu adaptiver Verifikation). - Kernels. Die Faltung, Normen und KV-Schreibvorgänge des Drafters sind fusioniert, und der gesamte Draft-Schritt läuft in einem CUDA-Graphen. FP8 KV cache funktioniert auch für den Drafter, ohne Änderung der Akzeptanz.
Serving-Ergebnisse auf TP8, mit und ohne adaptiver Verifikation, in der Low-Entropie-Kategorie von SPEED-Bench- throughput_1k Split: ~1K-Token-Prompts, hauptsächlich Code-Vervollständigung und Textsortierung, mit Greedy-Decoding und bis zu 4K Ausgabe-Tokens. Low-Entropie-Text lässt sich leichter vorhersagen, daher erwarten Sie bei offenem Chat eine niedrigere Akzeptanz.
| Concurrency | Fixed draft (tok/s) | Adaptive (tok/s) | Change | Acceptance length |
|---|---|---|---|---|
| 1 | 708 | 707 | −0.1% | 3.71 → 3.61 |
| 8 | 3,232 | 3,221 | −0.3% | 3.67 → 3.57 |
| 32 | 7,744 | 8,275 | +6.9% | 3.68 → 3.29 |
| 128 | 15,012 | 16,632 | +10.8% | 3.68 → 3.23 |
Adaptive Verifikation zahlt sich unter Last aus. Bei einer Concurrency von 128 steigert sie den Ausgabe-Durchsatz um 10.8% und senkt den p99 TPOT um 9%, während pro Schritt weniger Draft-Token verifiziert werden, was die Akzeptanzlänge leicht senkt, aber mehr Rechenleistung spart, als sie verliert. Bei niedriger Concurrency, wo zusätzliche Draft-Token fast kostenlos sind, ist sie neutral.
Erste Schritte
Der Befehl am Anfang dieses Beitrags ist ein guter Standard: TP4 auf einem einzelnen GB300-Knoten, mit DFlash2 und FP8 KV cache. Um adaptive Verifikation zu aktivieren, fügen Sie "enable_adaptive_verification": true zu --speculative-confighinzu. Die anderen oben genannten Optimierungen sind standardmäßig aktiviert.
- Wahl eines parallelen Aufbaus.
- Für die niedrigste Latenz verwenden Sie TP4 oder TP8.
- Für höheren Durchsatz verwenden Sie datenparallele Aufmerksamkeit mit Expertenparallelität, z. B.
-dp 4 --enable-expert-parallel.
- Denken (Reasoning) und Tool-Aufrufe. Die
beamParsers lesen die Antwortvorlage, die mit dem Checkpoint mitgeliefert wird. Standardmäßig beschränkt vLLM zudem jede Antwort auf diese Vorlage, sodass Tool-Aufrufe immer geparst werden und dem JSON-Schema des jeweiligen Tools entsprechen.response_formatundthinking_token_budgetarbeiten wie gewohnt weiter. Um die Standard-Constraint zu deaktivieren, setzen SieVLLM_BEAM_ALWAYS_CONSTRAIN_OUTPUT=0.
Day 0 Support für RL mit SkyRL
Wir haben auch mit dem SkyRL-Team zusammengearbeitet, um Day 0 Support für RL auf Beam zu ermöglichen. LoRA, BF16 Full Fine-Tuning und MXFP8 RL werden von Anfang an unterstützt, mit einem verbesserten RL-Stack für die 500B-Skala.
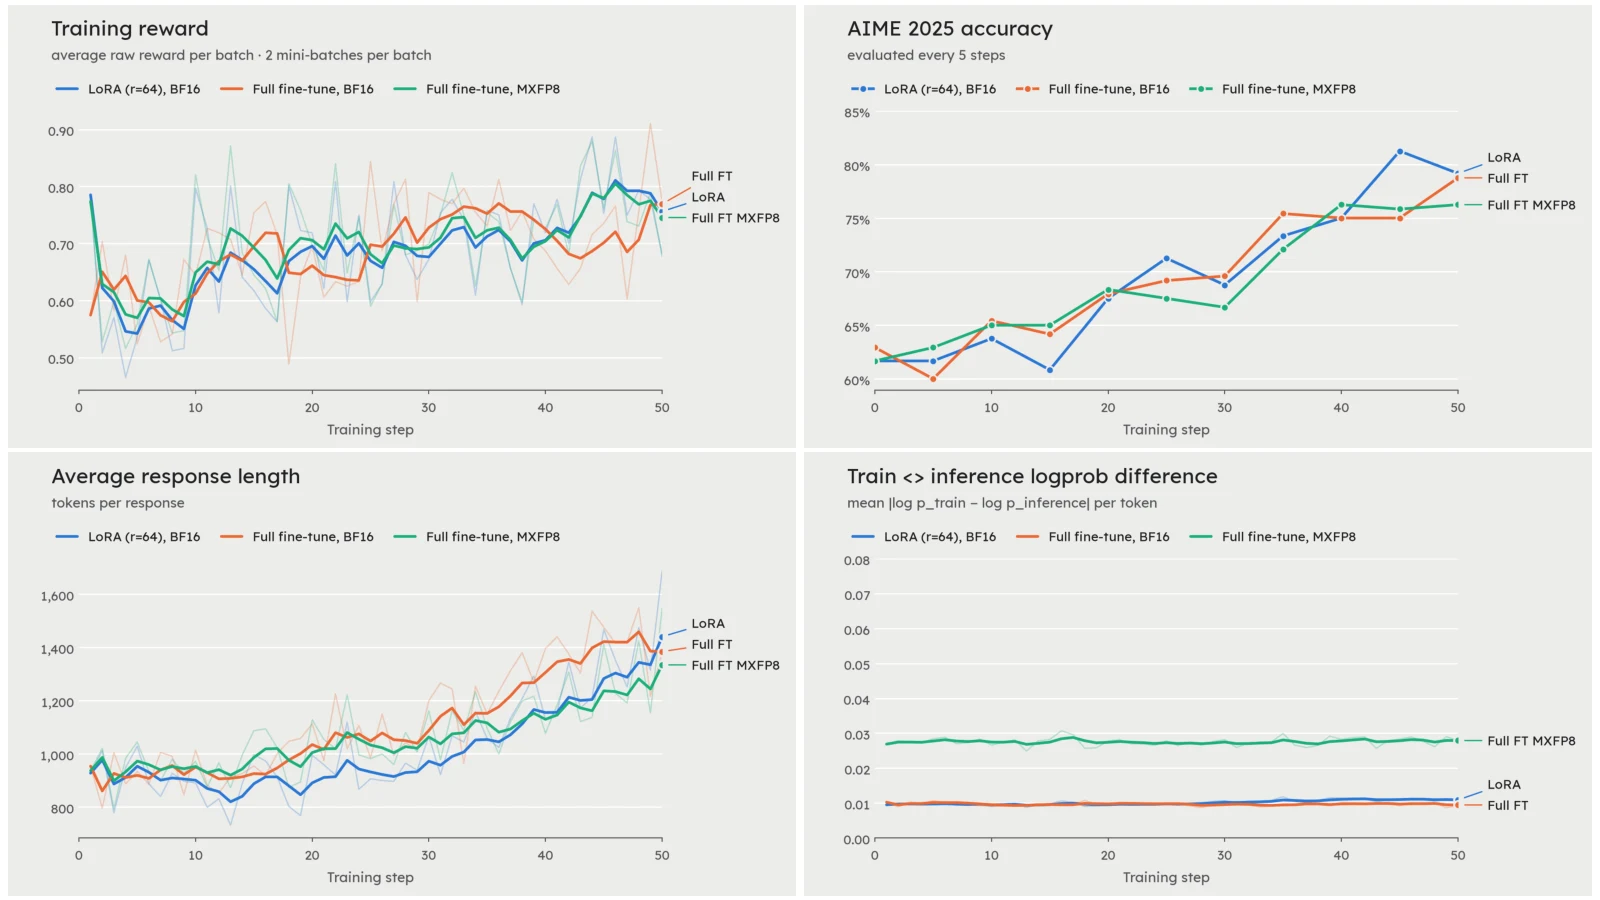
Das SkyRL-Team hat das Beam-Modell mit dem DAPO-Rezept nachtrainiert, mit vLLM für Inferenz und Megatron für Training. LoRA, Full Fine-Tuning und MXFP8 RL erzielen ähnliche Leistungsgewinne in 50 Trainingsschritten bzw. 100 Optimizer-Updates (reasoning minimal), mit einem Sprung der durchschnittlichen Genauigkeit (avg@8) von ~61% auf ~79% bei AIME25. Die durchschnittliche absolute Log-Wahrscheinlichkeitsdifferenz zwischen Megatron und vLLM bleibt mit aktiviertem Rollout Routing Replay (R3) unter 0.01 für LoRA und BF16 Full Fine-Tuning und unter 0.03 für MXFP8 RL.
Schauen Sie sich den SkyRL Blog für weitere Details an!
Danksagungen
Diese Arbeit war eine enge Zusammenarbeit zwischen den Teams Inferact, Reflection und Nvidia:
- Inferact: Woosuk Kwon, Ziqi Zhao, Ao Shen, Tiezhen Wang
- Reflection: Kaixing Wu, Yoni Gozlan, Neil Gollapudi, Thibaut Barroyer, Aymen Kallala, Matthias Reso, Florent Gbelidji
- Nvidia: Siyuan Fu