
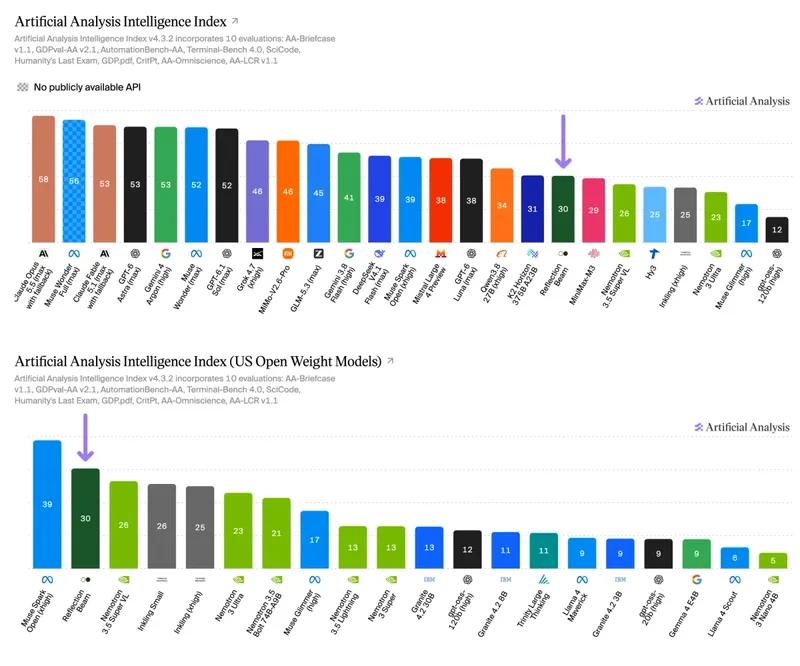
Reflections erstes Modell, Beam, erzielt 30 auf dem Artificial Analysis Intelligence Index und belegt damit Platz 2 unter den US-Open-Weights-Modellen
Modellseite ansehen Modellseite ansehenBeam ist ein Open-Weights-Modell mit 501B Parametern insgesamt und 23B aktiven Parametern
Die wichtigsten Erkenntnisse:
➤ Zweiter unter den US-Open-Weights-Modellen: Beam erzielt 30, nur hinter Metas Muse Spark Open (39) und vor der gestrigen Veröffentlichung NVIDIA Nemotron 3.5 Super VL (26). Außerhalb Chinas erzielen nur Muse Spark Open und K2 Horizon aus den VAE (31) höhere Werte
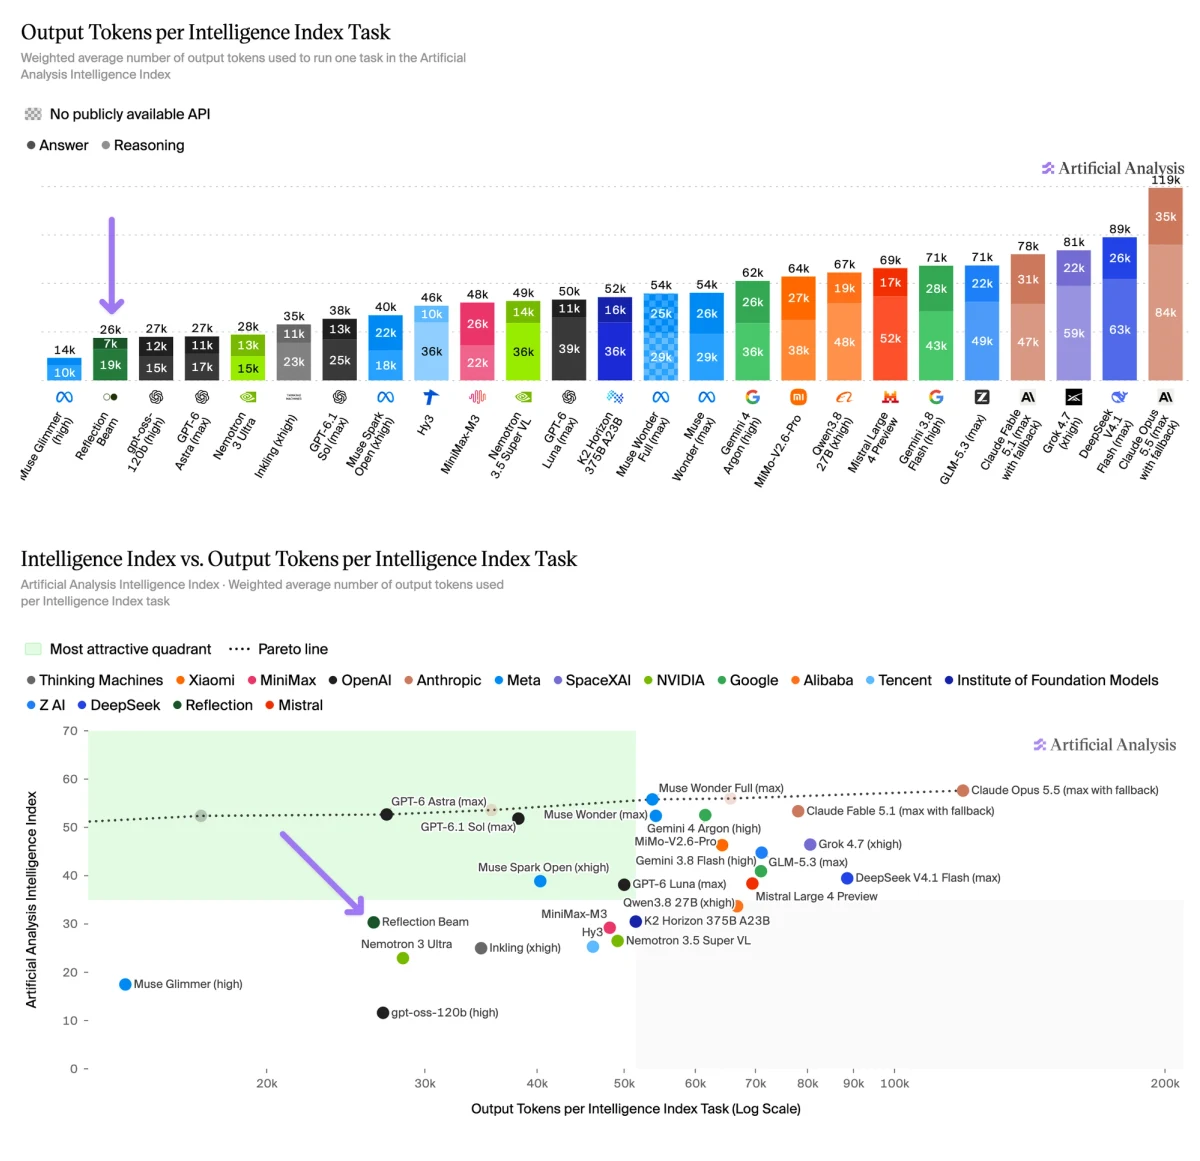
➤ Token-effizient für seine Intelligenz: Beam verwendet ~26k Ausgabe-Tokens pro Intelligence-Index-Aufgabe im Vergleich zu K2 Horizon, das einen Punkt vorne liegt und doppelt so viele (~52k) verwendet. Proprietäre Modelle setzen weiterhin die Spitze, wobei GPT-6 Astra (max) mit demselben Budget (~27k) 53 erzielt
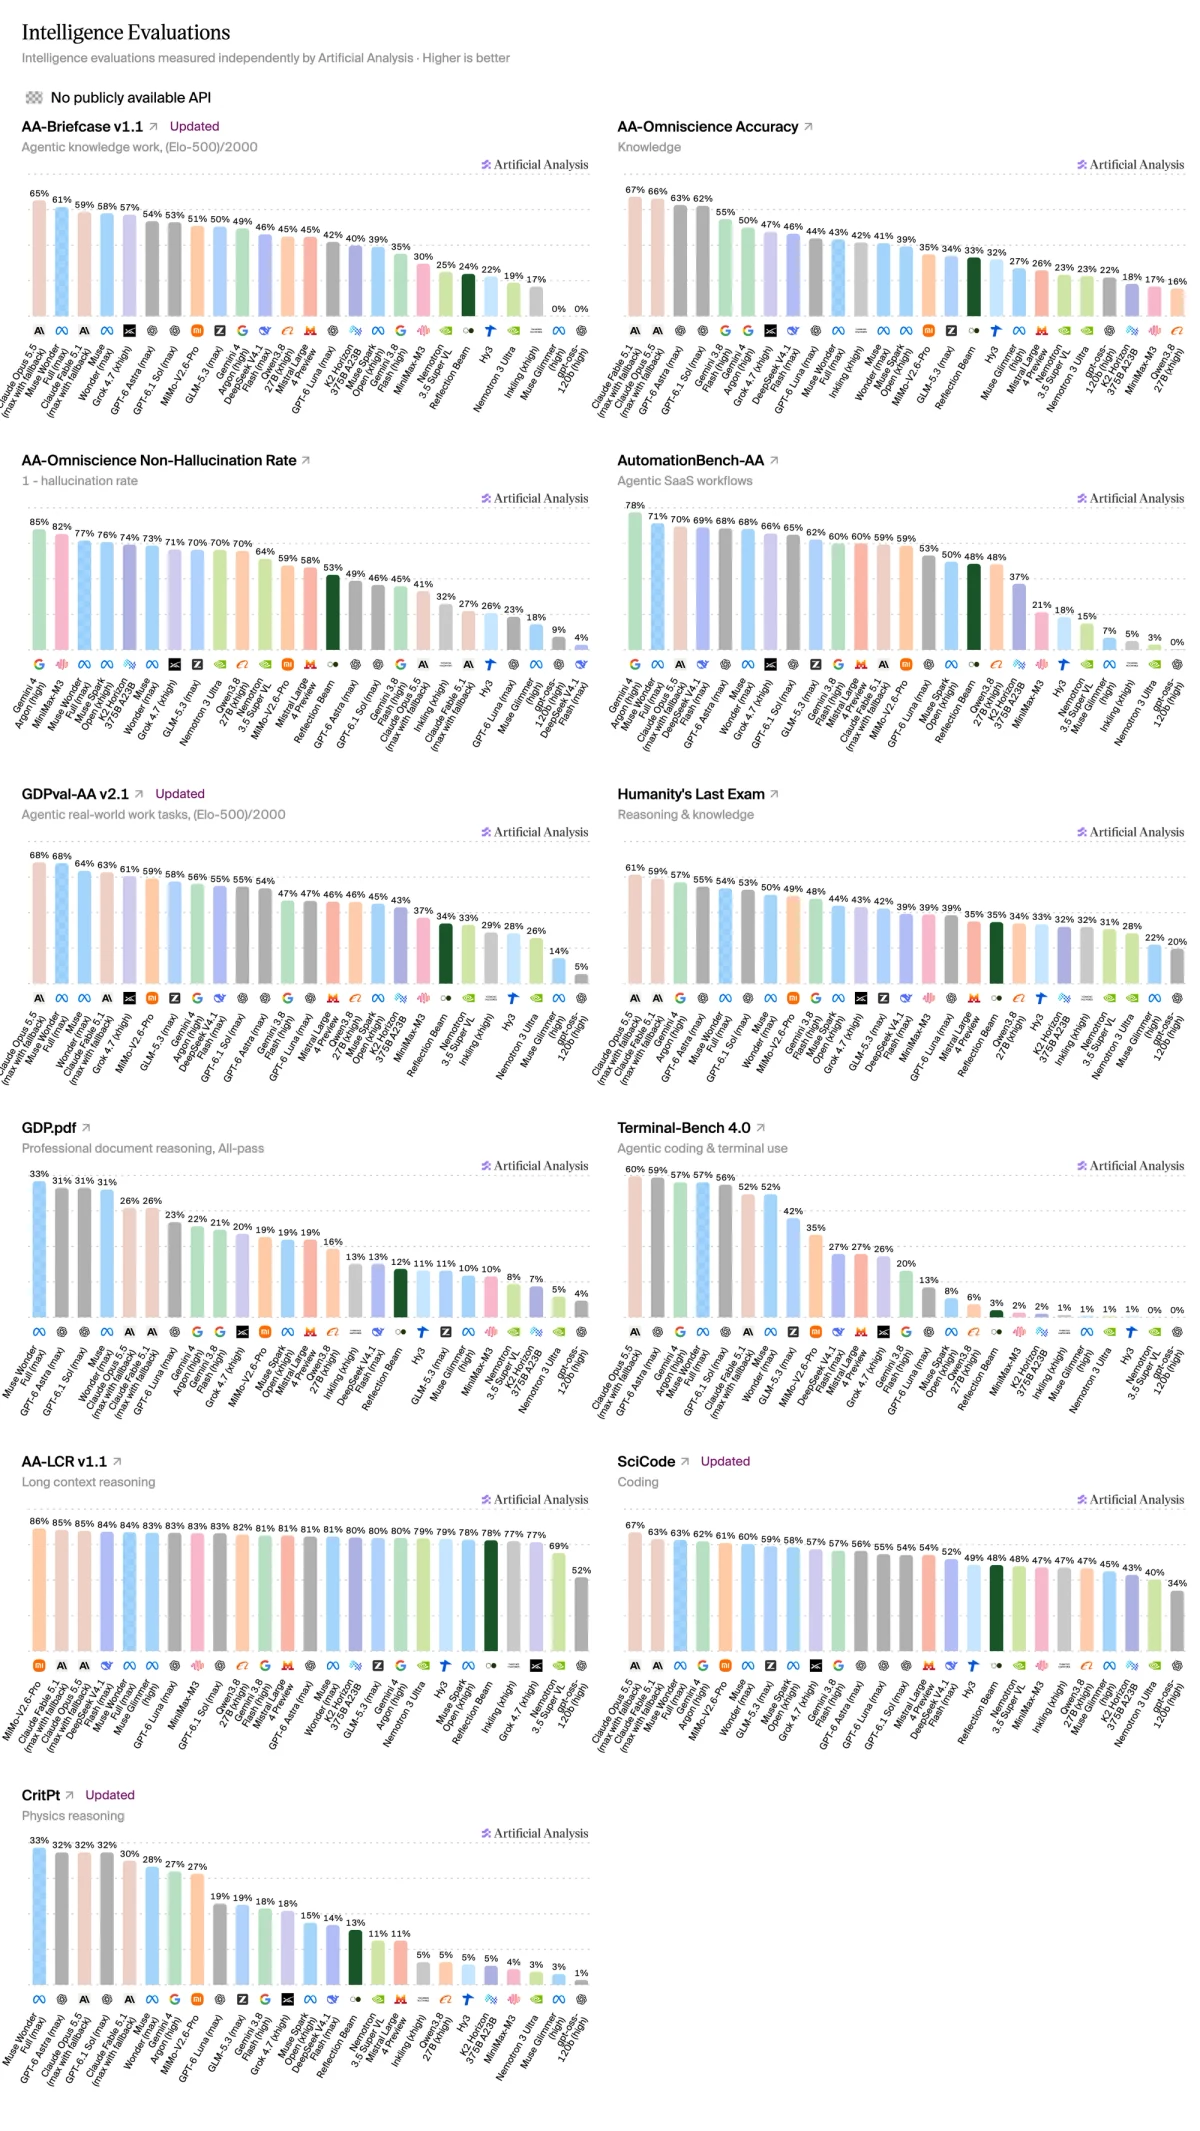
➤ Stark bei agentischen Workflows, schwächer im Terminal: Beam erzielt 48.5% auf AutomationBench-AA, 11 Prozentpunkte vor K2 Horizon (37.2%) und auf Augenhöhe mit Qwen3.8 27B (48.2%). Terminal-Bench 4.0 ist eine Schwachstelle, wo Beam 3.0% erreicht, hinter Qwen3.8 27B (5.6%) und Muse Spark Open (8.1%)
➤ Weiß mehr, rät mehr: Auf AA-Omniscience beantwortet es 33% der Fragen korrekt, weit vor K2 Horizon (18%) und Qwen3.8 27B (16%). Aber seine Halluzinationsrate beträgt 47%, gegenüber 26% bei K2 Horizon und 30% bei Qwen3.8 27B, was Beam einen Netto-Index-Score von 1.5 verschafft, vor beiden Konkurrenten (−3.0 und −10.0)
Weitere Modelldetails
- Kontextfenster: 1M Tokens
- Modalitäten: Text
- Parameter: 501B / 23B
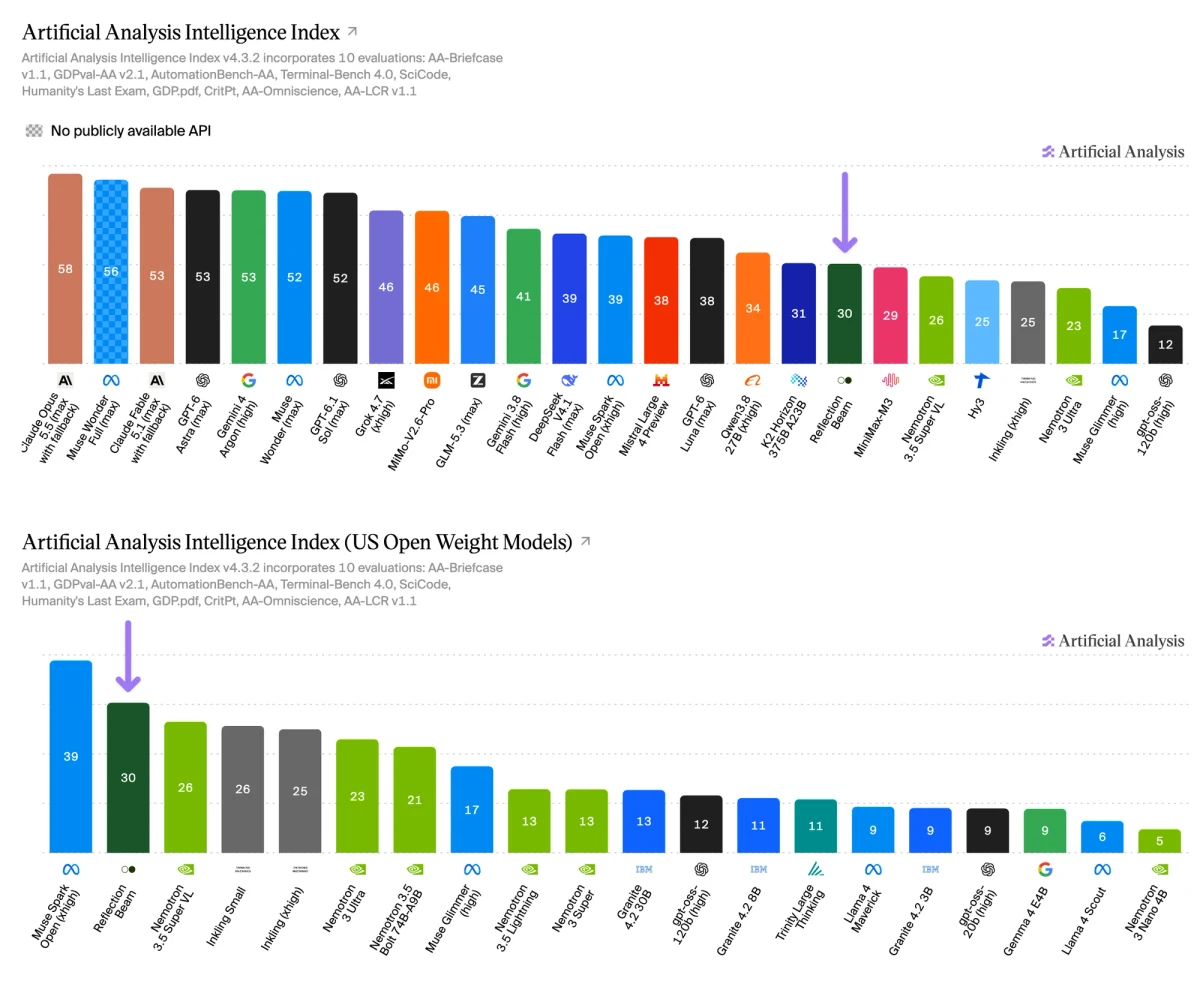
Im Vergleich zu Open-Weights-Konkurrenten
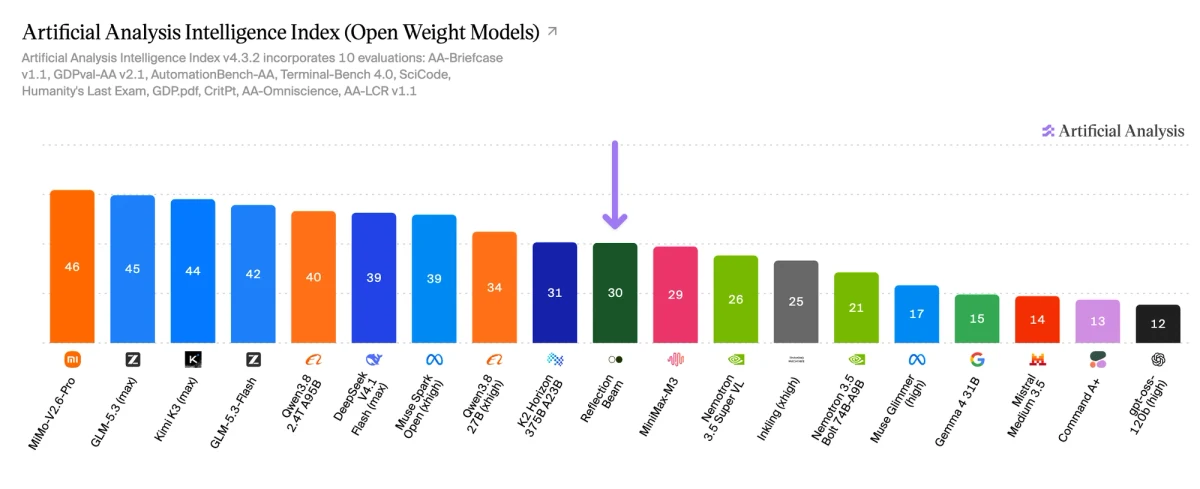
Beam schneidet im Vergleich zu US-Open-Weights-Modellen gut ab, hinter Metas Muse Spark Open (39) und vor NVIDIA Nemotron 3.5 Super VL (26), alle diese Woche veröffentlicht. Unter allen Open-Weights-Modellen belegt es Rang zehn, einen Punkt hinter K2 Horizon (31)
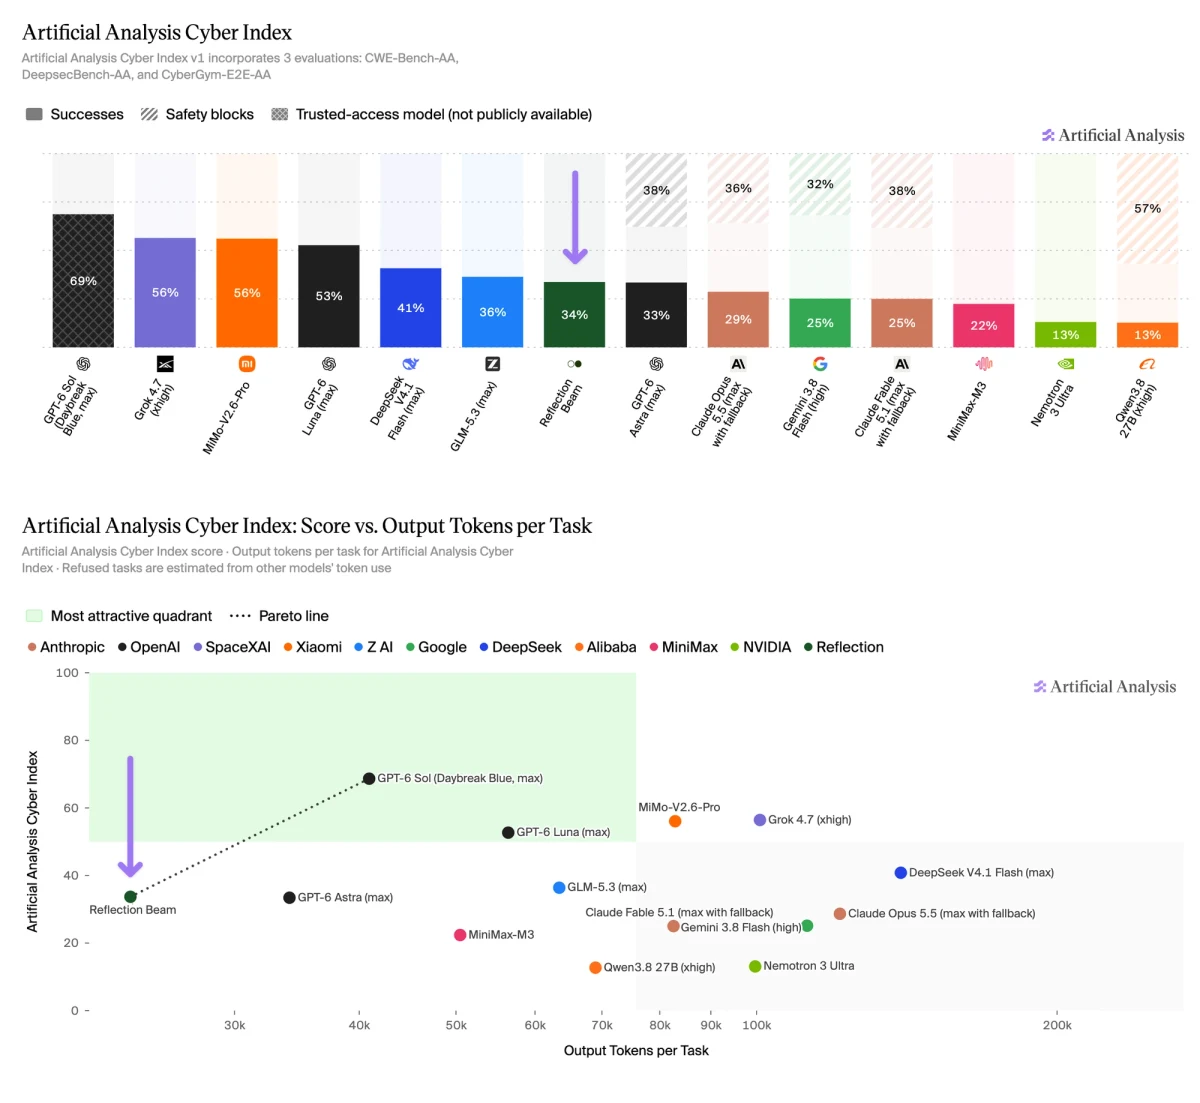
Cyber-Fähigkeiten
Beam absolviert 34% der Aufgaben im Artificial Analysis Cyber Index und ist damit das beste von uns getestete US-Open-Weights-Modell
Angetrieben durch seine Token-Effizienz liegt es auch auf der Frontier des Cyber Index vs. Ausgabe-Tokens pro Aufgabe, neben GPT-6 Sol (Daybreak Blue)
Hochgradig token-effizient
Beam verwendet ~26k Ausgabe-Tokens pro Intelligence-Index-Aufgabe: ~19k für Reasoning und ~7k für Antworten. Nur 26% seiner Ausgabe entfallen auf finale Antworten, der 28.-niedrigste Anteil von 219 getesteten Modellen auf Intelligence Index v4.3
Coding-Fähigkeiten
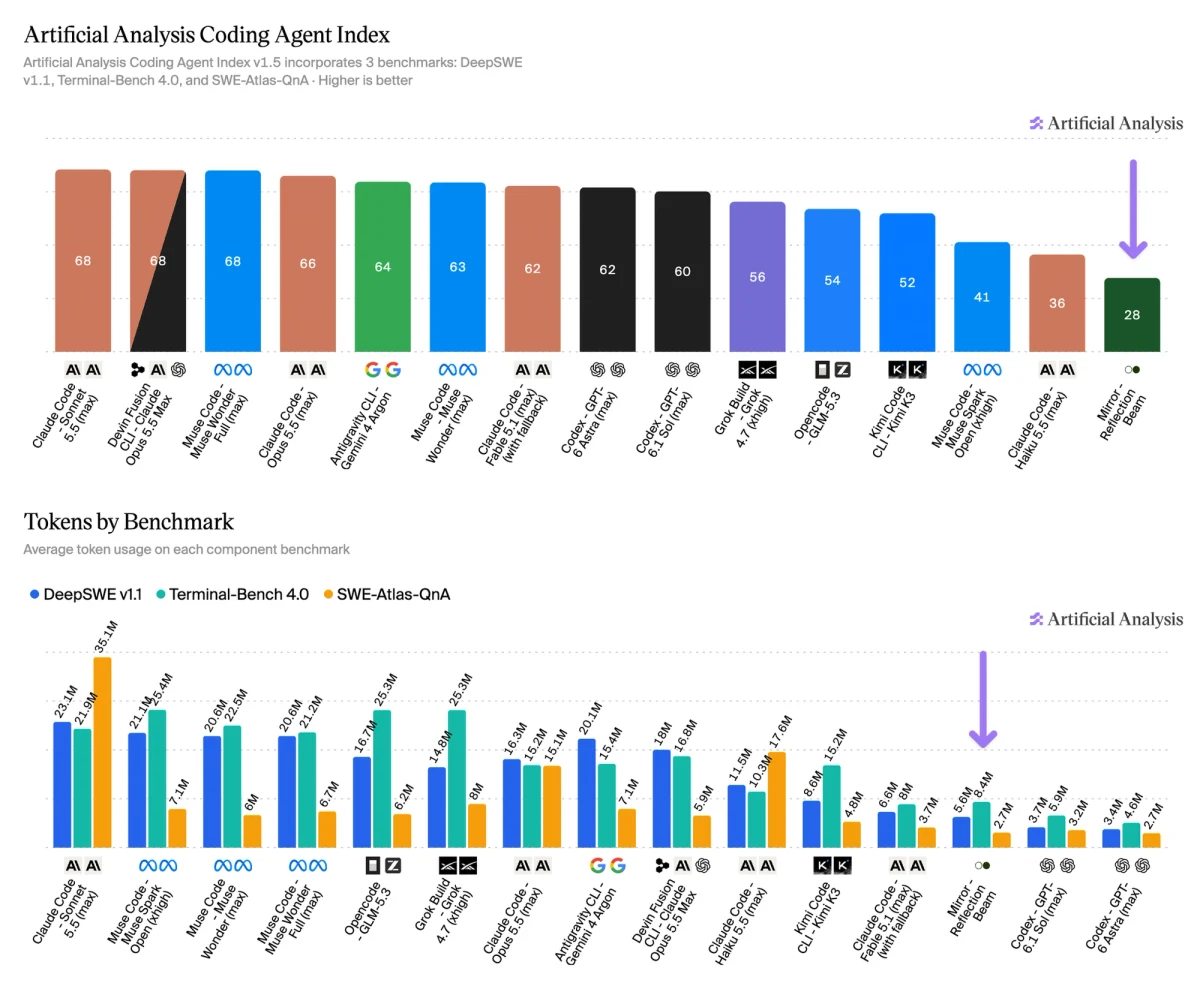
Betrieben in Mirror, Reflections Open-Source-CLI-Harness, erzielt Beam 28 auf dem Artificial Analysis Coding Agent Index. Es liegt 15 Punkte hinter dem nächsten Setup, Claude Code mit Qwen3.8 Max (43), und 40 hinter den Spitzenreitern (68). Es ist jedoch sparsam: Nur Codex mit GPT-6 Astra und Codex mit GPT-6.1 Sol verwenden weniger Tokens
Intelligence-Index-Komponenten
In den zehn Auswertungen des Intelligence Index hebt sich Beam bei AutomationBench-AA (48,5 %) und CritPt (13,1 %) hervor, wo es K2 Horizon (4,6 %) und Qwen3.8 27B (5,4 %) jeweils mehr als verdoppelt. Die schwächsten Ergebnisse erzielt es bei Terminal-Bench 4.0 (3,0 %) und AA-Briefcase (976 Elo)
Vollständige Details auf Beams Artificial-Analysis-Seite https://artificialanalysis.ai/models/reflection-beam