
Ist die Interpretierbarkeit von KI einem Durchbruch nahe? Ein neuer Aufsatz hat Wissenschaftler aufgeteilt
 Maximilian Schreiner
Sein LinkedIn-Profil von Maximilian Schreiner ansehen
Oct 16, 2026
 Nano Banana Pro wird von THE DECODER angefordert
Laut Nick Cammarata, einer der Personen hinter der Superposition-Hypothese, sind die neuronalen Netzwerke nicht so kompliziert, wie die Forscher annahmen. Roon von OpenAI bezeichnet dies als einen historischen Moment. Neel Nanda, Forscher bei Google DeepMind, warnt vor einer übermäßigen Bewertung.
In einem langen Artikel mit dem Titel „Neural Networks Are Already Clean“ argumentiert Nick Cammarata, dass die innere Funktionsweise großer KI-Modelle viel einfacher zu verstehen ist, als bisher angenommen. Cammarata ist Forscher im Interpretierbarkeitslabor Goodfire. Mit diesem Artikel lehnt er eine Erklärung ab, die er vor Jahren mitgeformt hat.
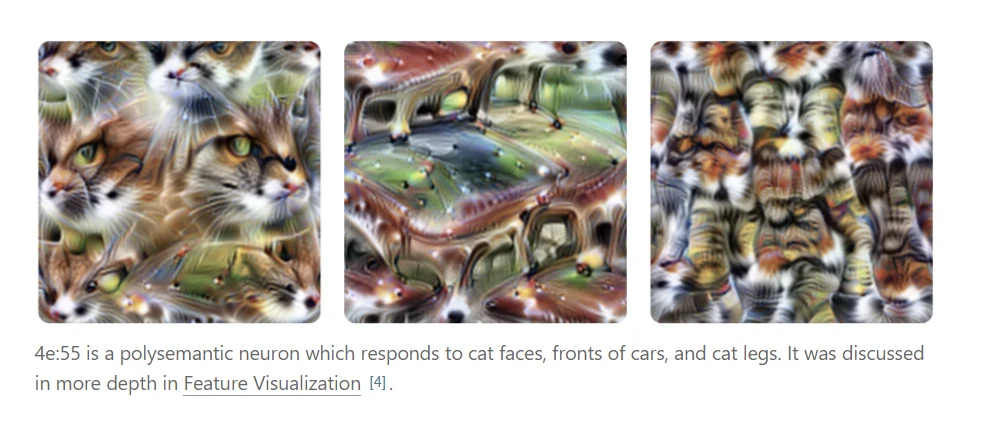
Die mechanische Interpretierbarkeit versucht mehr zu tun als nur zu beobachten, was ein KI-Modell ausgibt. Sie zielt darauf ab, zu verstehen, wie das Modell seine Antworten intern erhält. Idealweise würde jeder der Millionen künstlichen Neuronen ein erkennbares Konzept repräsentieren. In der Praxis schienen viele Neuronen auf völlig unverwandte Dinge zu reagieren, was die Forscher als Polysemie bezeichnen. Ein frühes und berühmtes Beispiel ist ein Neuron im Bildmodell InceptionV1, das sowohl auf Katzenmotive als auch auf das Front des Autos reagierte. Cammarata verwendete es als Beispiel in seinen frühen Forschungen.
Die Standarderklärung war die Überlagerung. Die Theorie besagt, dass, wenn ein Netzwerk keine Neuronen mehr hat, unabhängige Konzepte in dieselben Neuronen gepackt werden, da sie selten aufeinander wirken. Das Ergebnis sieht wie ein Knoten aus. Deshalb trainieren viele Labore ein zweites Modell, wie einen dünnen Autoencoder, um die Konzepte voneinander zu trennen. Dann untersuchen sie dieses Modell anstatt das ursprüngliche.
Cammarata spielte eine wichtige Rolle bei der Entwicklung dieser Sichtweise. Mit Chris Olah schrieb er gemeinsam den Artikel „Zoom In“, in dem das erste Superposition-Schaltkreis vorgestellt wurde. Im Jahr 2023 begann er an OpenAI ein automatisiertes Interpretierbarkeit-Projekt. Zu dieser Zeit wurden nur etwa 1,7 Prozent der Neuronen als verständlich eingestuft, selbst unter den größten Maßstäben.
Die Beweise könnten falsch gelesen worden sein
Cammarata glaubt jetzt, dass die berühmtesten Beispiele falsch interpretiert wurden. Er sagt, das „Kat-Auto-Neuron“ sei tatsächlich ein V-Form-Detektor. Spitzige Formen wie der Schnauze eines Fuchses oder Flammen aktivieren es, während runde Formen wie die Buchstaben O seine Aktivierung verhindern. Daher repräsentiert es keine zwei völlig unabhängigen Konzepte wie Katzenmotive und Autos – das bedeutet, dass es kein Beispiel für Superposition ist.
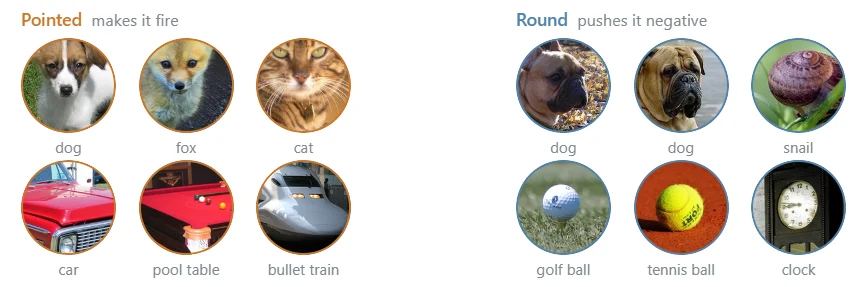
Er interpretiert auch den Überlagerungskreis aus „Zoom In“ neu – dabei schien ein Auto sich unter den Hunde Neuronen zu verbergen. Seiner Ansicht nach handelt es sich um eine gewöhnliche Generalisierung; der Kreis gruppiert einfach Autos und Hunde nach der Richtung, in die sie zur Kamera blicken. Er macht die Unordnung in den späten Schichten von InceptionV1 einer veralteten Architektur und schwachen Analysewerkzeugen schuldig.
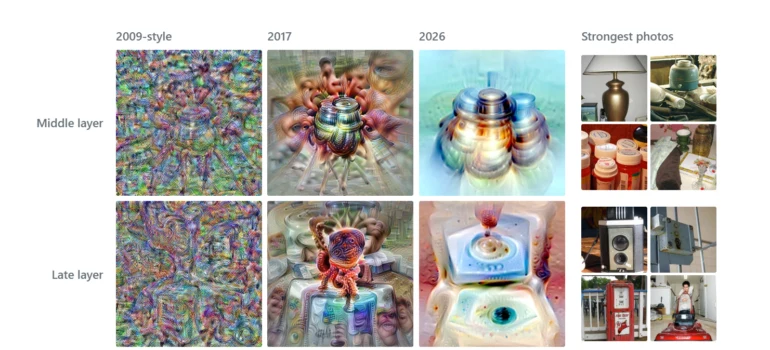
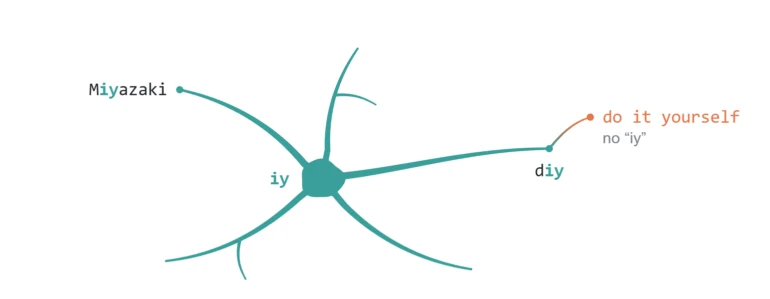
Cammarata erklärt die verbleibende Unklarheit mit einem Muster, das er „rekursive Generalisierung“ nennt. Er sagt, dass ein Neuron wie eine Ableitung wächst, die Seitenzweige ausstrahlt. Ein Neuron, das die Buchstabenfolge „iy“ erkannt hat, reagiert später auf „diy“ und schließlich auf „do it yourself“, was überhaupt kein „iy“ enthält. Im Gegensatz zur Superposition können diese Gruppen sich dazu eignen, etwas über das Netzwerk zu lehren.
Für Sprachmodellen liefert er vorläufige Zahlen. Bei Qwen3-32B haben etwa 90 Prozent der Neuronenpole eine Hauptaufgabe, und etwa 7 Prozent haben zwei verwandte Aufgaben. Nur 2 bis 4 Prozent bleiben unerklärt. Goodfire sagt, dass ähnliche Ergebnisse in Modellen mit bis zu Billionen von Parametern erzielt werden. Die AI-Agenten, die Neuronen im Großen Bereich analysieren, erledigen den größten Teil der Arbeit. Cammarata stellt sich auf Rich Suttons Arbeit beruhend ein. „Bitter Lektion“ Und man kommt zu dem Schluss, dass auch in Bezug auf die Interpretierbarkeit eine einfache Untersuchung in großer Skala besser ist als kluge Dekompositionstechniken.
Cammarata führt keine grundlegend neue Methode ein. Er kehrt zu dem ursprünglichen Ansatz des Fachgebiets zurück, bei dem Neuronen direkt untersucht werden – nur mit besseren Werkzeugen, größeren Modellen und automatisierten Agenten.
Lesbare Netzwerke wären ein großer Vorteil für die Sicherheit von KI-Technologien
Wenn Cammarata recht hat, wäre das gute News – besonders für die Sicherheit von KI. Im Moment gibt es außer der Überwachung von denkensträngen, die immer weniger zuverlässig werden, nur wenige Möglichkeiten, herauszufinden, ob ein Modell Menschen täuscht oder gefährlich handelt. Cammarata zweifelt daran, dass die Einhaltung der Ziele der KI – also das Steuern der KI auf menschliche Ziele – ohne Interpretierbarkeit gelöst werden kann, denn andernfalls wissen wir nicht, was wir erschaffen. Die Täuschung hat keinen Grund, vor den eigenen Schaltkreisen des Modells zu verstecken, schreibt er. Wenn Menschen nur noch ein weiterer „Leser“ des Netzwerks werden, können sie auch die Täuschung sehen und Fehler könnten gezielt behoben werden.
Roon, ein Mitarbeiter von OpenAI, der unter diesem Pseudonym auf X postet und eine einflussreiche Stimme in den AI-Welten ist, war begeistert. Er sagt, er sei enger Freund von Cammarata und hätte ohne ihn nie bei OpenAI angekommen sein. Die Arbeit „kann als ein wichtiger Moment in der wissenschaftlichen Geschichte erinnert werden“, Roon schrieb. Er fügte hinzu, dass die Nachrichten so gut sind, dass sogar Eliezer Yudkowsky, eine der prominentesten Stimmen, die vor einer AI-Katastrophe warnt, seine Schätzungen bezüglich des Unheils senken muss. In Roons Augen könnte die Alignment-Technologie zu einer „normalen Wissenschaft“ werden.
Auch Roon hat einige Bedenken. Andere in der Branche müssen noch die Ergebnisse bestätigen, und er vermutet auch, dass Durchbrüche in der Interpretierbarkeit die AI-Fähigkeiten vorantreiben werden. Die Tatsache, dass diese Durchbrüche von außen kommen, ist für die großen Labore, einschließlich OpenAI, nicht günstig.
Nanda sieht ein nützliches Werkzeug, nicht einen Durchbruch
Neel Nanda ist viel zurückhaltender. Er gilt als eine der Gründungsfiguren der mechanischen Interpretierbarkeit und leitet das Interpretierbarkeitsteam bei Google DeepMind. Davor arbeitete er bei Anthropic und als unabhängiger Forscher. Seine Ansichten haben sich laut ihm verändert: Seit Mitte 2024 ist er pessimistischer gegenüber ehrgeiziger Interpretierbarkeit und neigt zu pragmatischen Ansätzen. Sein Team hat die Forschung zu spärlichen Autoencoders in den Hintergrund gedrängt. Sie hielten die Technik nicht für nutzlos, aber es schien nicht wert zu sein, dass das Feld so viel Mühe in sie investierte.
Cammaratas Arbeit ist interessant, aber ändert nicht wirklich das große Bild, Nanda schreibt. Neuronbasierte Analyse könnte bei praktischen Fragen helfen, wie zum Beispiel warum ein Modell etwas fragwürdig tut, und es ist viel einfacher an Grenzmodellen anzuwenden. Aber er glaubt nicht, dass die Interpretierbarkeit fast vollständig gelöst ist. Er erwartet, dass neuronbasierte Analyse ernsthafte Fehler hat und viele Dinge übersehen wird.
Nanda glaubt immer noch, dass die Überlagerung real ist. Er argumentiert, dass Sprachmodellen viel mehr Fakten speichern als sie Neuronen haben, und dass besonders schwache Aktivierungen wahrscheinlich einen großen Teil dieser Informationen enthalten. Er zweifelt daran, dass die Erkenntnisse aus kleinen Bildmodellen übertragbar sind. Zudem glaubt er, dass das Aufsatzstück die Monosemantizität zu locker definiert, aber er würdigt Cammarata für die Überprüfung seiner alten Arbeit mit modernen Werkzeugen.
Ein Teil des Streits beruht auf Definitionen: Cammarata hat kein Problem mit Modellen, die mehr Konzepte darstellen als ihre Dimensionen, und Nanda sieht, dass er in diesem Punkt übereinstimmt. Was Cammarata bezweifelt, ist, dass Netzwerke willkürlich völlig unverwandte Dinge zusammenpacken.
Der technische Begleitartikel ist noch nicht veröffentlicht worden. Als Interpretierbarkeit-Unternehmen hat Goodfire auch eine deutliche Beteiligung an der Thesis. Wenn Cammaratas Erklärung stimmt, glaubt er, dass automatisierte Forscher in wenigen Monaten erreichen könnten, was Menschen fast ein Jahrzehnt lang mit Bildmodellen brauchen würden. Er schreibt, dass vielleicht nicht mehr viel Zeit bleibt.
AI-News ohne Hype – von Menschen zusammengestellt
Abonnieren Sie THE DECODER, um ohne Werbung zu lesen, ein wöchentliches AI-Bulletin, unseren exklusiven „AI Radar“-Bericht sechsmal jährlich, vollen Zugang zum Archiv und Zugang zur Kommentarspalte.
Lesen Sie weiter, um das volle Bild zu erhalten.
Abonnieren Sie, um eine unbeeinträchtigte Berichterstattung zu erhalten.
- Vollzugriff auf jedes Artikel auf THE DECODER
- Keine Anzeigen
- Teilen Sie Ihre Kommentare und diskutieren Sie mit der Gemeinschaft
- Wöchentlicher Überblick über AI-Newsthemen per E-Mail
- 6x/Jahr: „AI Radar“ – tiefgehende Einblicke in die wichtigsten Themen der KI
- Tägliche AI-Neuigkeiten, immer aktuell
- Unsere vollständige zehnjährige Archivdatei
- Beschützt von einem Team mit mehr als 10 Jahren Erfahrung im Bereich KI