

Gangs Gemini 4 Argon ist in den Monaten näher an die Grenzen der KI als jeder andere Google-Modell.
 Matthias Bastian
Sehen Sie das LinkedIn-Profil von Matthias Bastian
16. Oktober 2026
 Google
 Deepmind ist das zweite große AI-Labor, das 95 Prozent auf dem ARC-AGI-3 Benchmark erreicht hat. Doch die Ergebnisse hängen stark von der Testmethode ab, und Argon schneidet in Mathematik und Softwareentwicklung besser ab, wie Epoch AI berichtet.
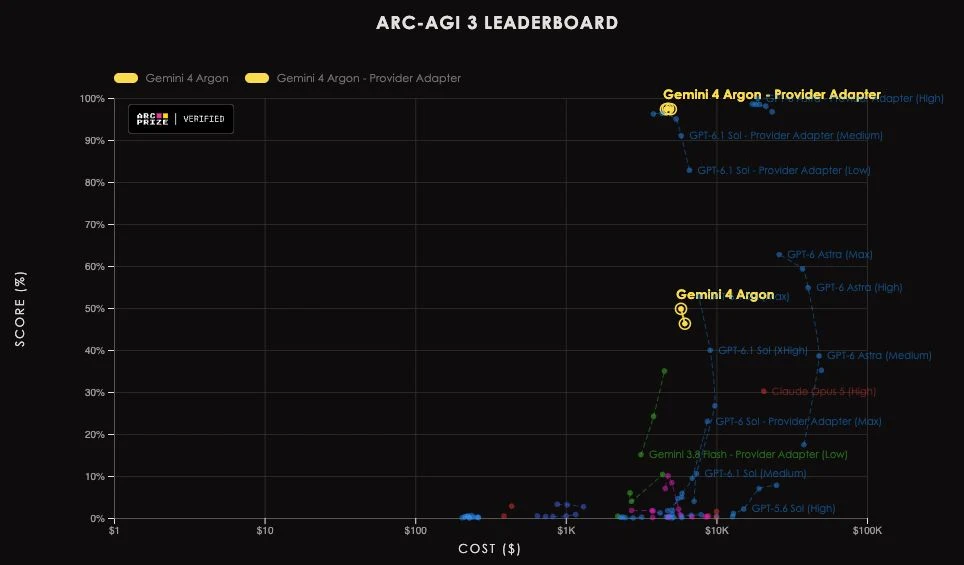
Das neue Frontier-Modell von Google Deepmind, Gemini 4 Argon, erreichte bei der ARC-AGI-3-Prüfung 97,5 Prozent – für einen Preis von 4.800 US-Dollar – unter Verwendung des „Provider Adapter Harness“, einer Testumgebung, die spezifische Funktionen des Anbieters wie erhaltenes Rechenvermögen und Kontextkompression nutzt. Laut dem ARC Prize ist Google nun das zweite AI-Labor nach OpenAI, das den 95-prozentigen Schwellenwert erreicht hat – was allgemein als die schwierigste Prüfung für die Lösung allgemeiner Probleme gilt. Nur GPT-6 Astra erreicht einen höheren Wert von 99,9 Prozent.
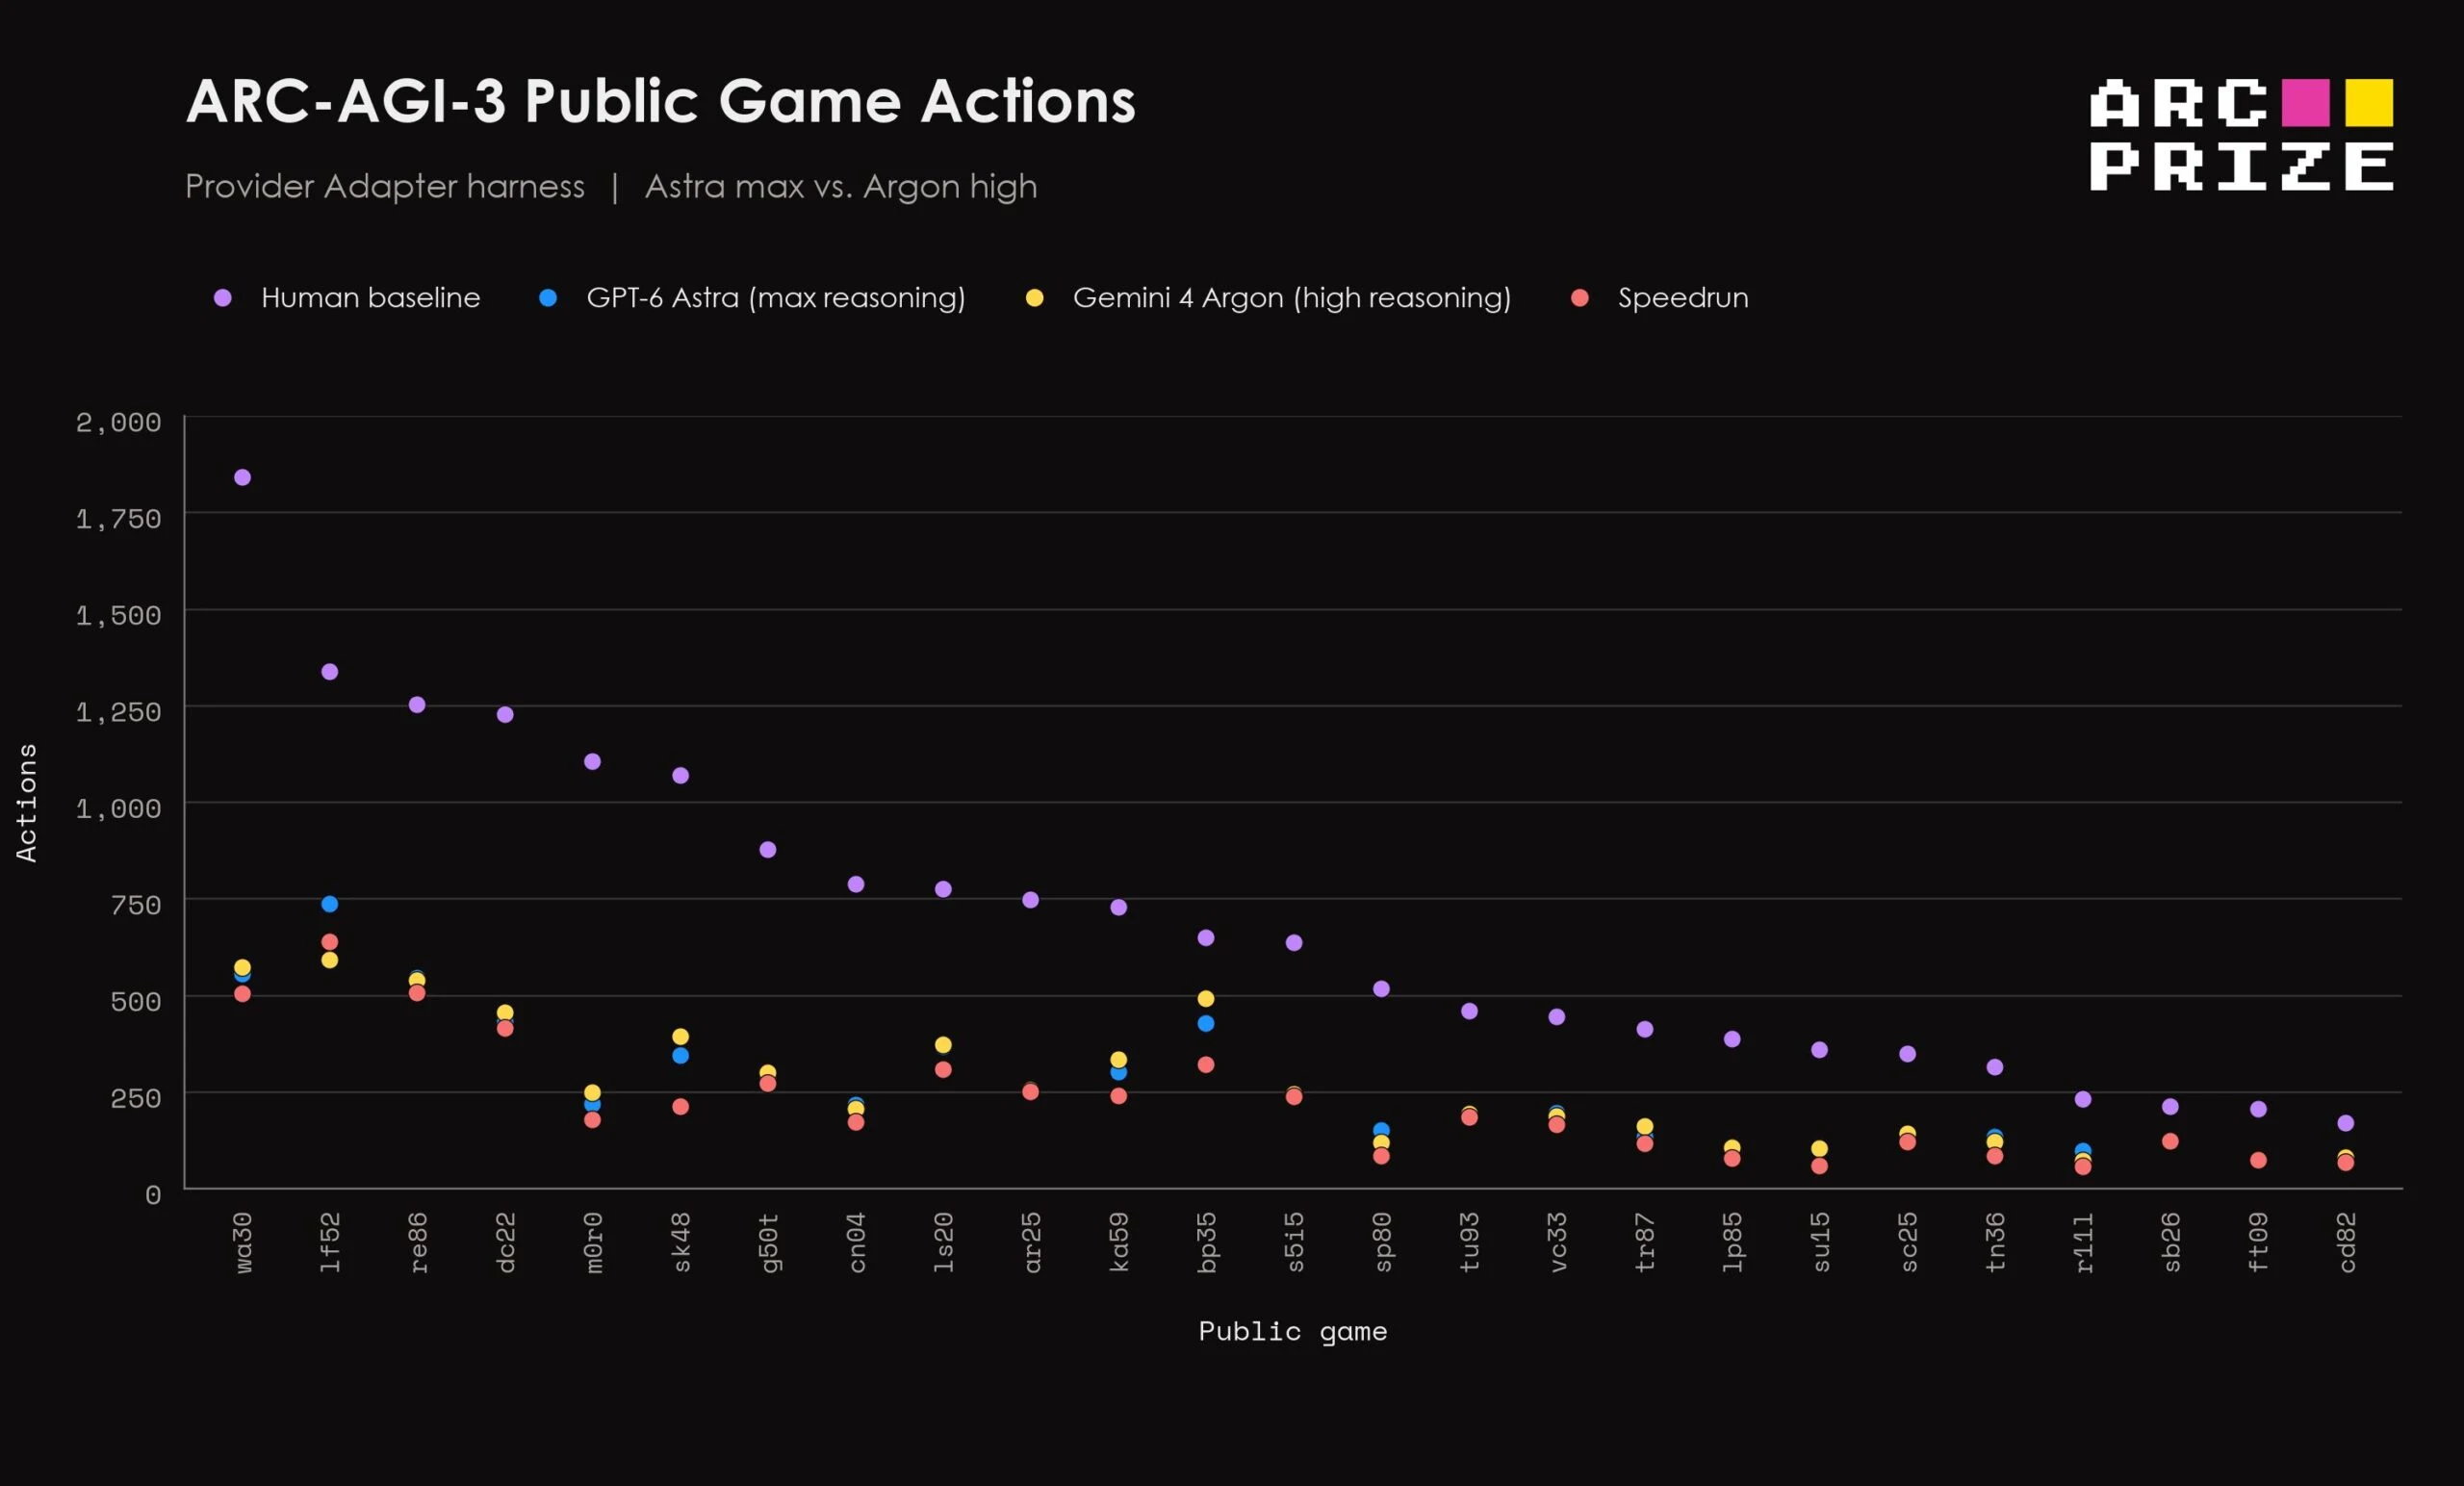
Wie Astra benötigte Argon 62 Prozent weniger Aktionen als der menschliche Baseline in den 25 öffentlichen Spielen. In drei Spielen erreichte er die Geschwindigkeitsrekorde und in sechs anderen Spielen lag seine Zeit innerhalb von 10 Prozent des besten Zeitstandards. Bei älteren Versionen des Benchmarks erzielte Argon 91,3 Prozent bei ARC-AGI-2 (0,32 $ pro Aufgabe) und 98,5 Prozent bei ARC-AGI-1 (0,16 $ pro Aufgabe), basierend auf dem Einleitungspreis von 2 $ pro Million Eingabetoken und 10 $ pro Million Ausgabetoken.
Die Benchmarkergebnisse hängen stark von der Testumgebung ab
Im „Standard Harness“, das nur einfache Notizen zwischen Runden erlaubt, fällt Argons Wert auf 49,8 Prozent bei niedriger Rechenleistung für 5.800 Dollar. Dieser Unterschied verläuft sich auf einen Streit im Juli 2026. OpenAI’s GPT-5.6 Sol besiegte Claude Opus 5 im ARC-AGI-3 mit zwei API-Einstellungen.ad
GPT-5.6 Sol erreichte nur 7,8 Prozent in der Standardumgebung, da es nach jeder Aktion das interne Denken verlor und eine ältere Schnittstelle verwendete, die die neuen Claude-API-Funktionen nicht enthielt. Das bedeutete, dass Claude unter anderen Bedingungen getestet wurde als GPT-5.6. Wenn er mit OpenAI’s eigenem Responses-API getestet wurde, einschließlich „Beibehaltung des Denkens“ und „Smart Context“ „Compaction“, stieg das Modell auf 38,3 Prozent und übertrumpfte Opus 5 mit 30,2 Prozent. OpenAI argumentierte, dass die Benchmarks immer auch den technischen Umfeld messen. Der Mitbegründer des ARC-Prize, Francois Chollet, erlaubte anschließend allgemeine, öffentlich zugängliche API-Einstellungen.
API-Probleme haben auch dazu geführt, dass Argon nicht alle 55 Spiele im Standard Harness absolvieren konnte nach den Tests. Bei niedrigem Niveau hat das System 42 Spiele abgeschlossen (49,8 Prozent), bei mittlerem Niveau 46 Spiele (46,3 Prozent). Bei höchstem Niveau hat es nur 19 Spiele abgeschlossen, daher hat ARC Prize keine Punktzahl veröffentlicht. Die gemelten Ergebnisse umfassen immer noch alle 55 Spiele, indem sie Teilpunkte von abgebrochenen Spielen berücksichtigen.
Argon schließt den Abstand, aber liegt bei Mathematik und Programmierung zurück
Das Forschungsinstitut Epoch AI verfolgte auch Gopes Fortschritte. Argon erhielt 165 Punkte im Epoch Capabilities Index (ECI), was dem Fable 5.1 entspricht, und liegt knapp hinter Opus 5.5 (167) sowie GPT-6 Astra (166). Der ECI kombiniert über 50 Benchmarks in eine einzige Kapazitätsskala, ähnlich wie Artificial Analysis seinen Hauptpunktestand aufbaut.
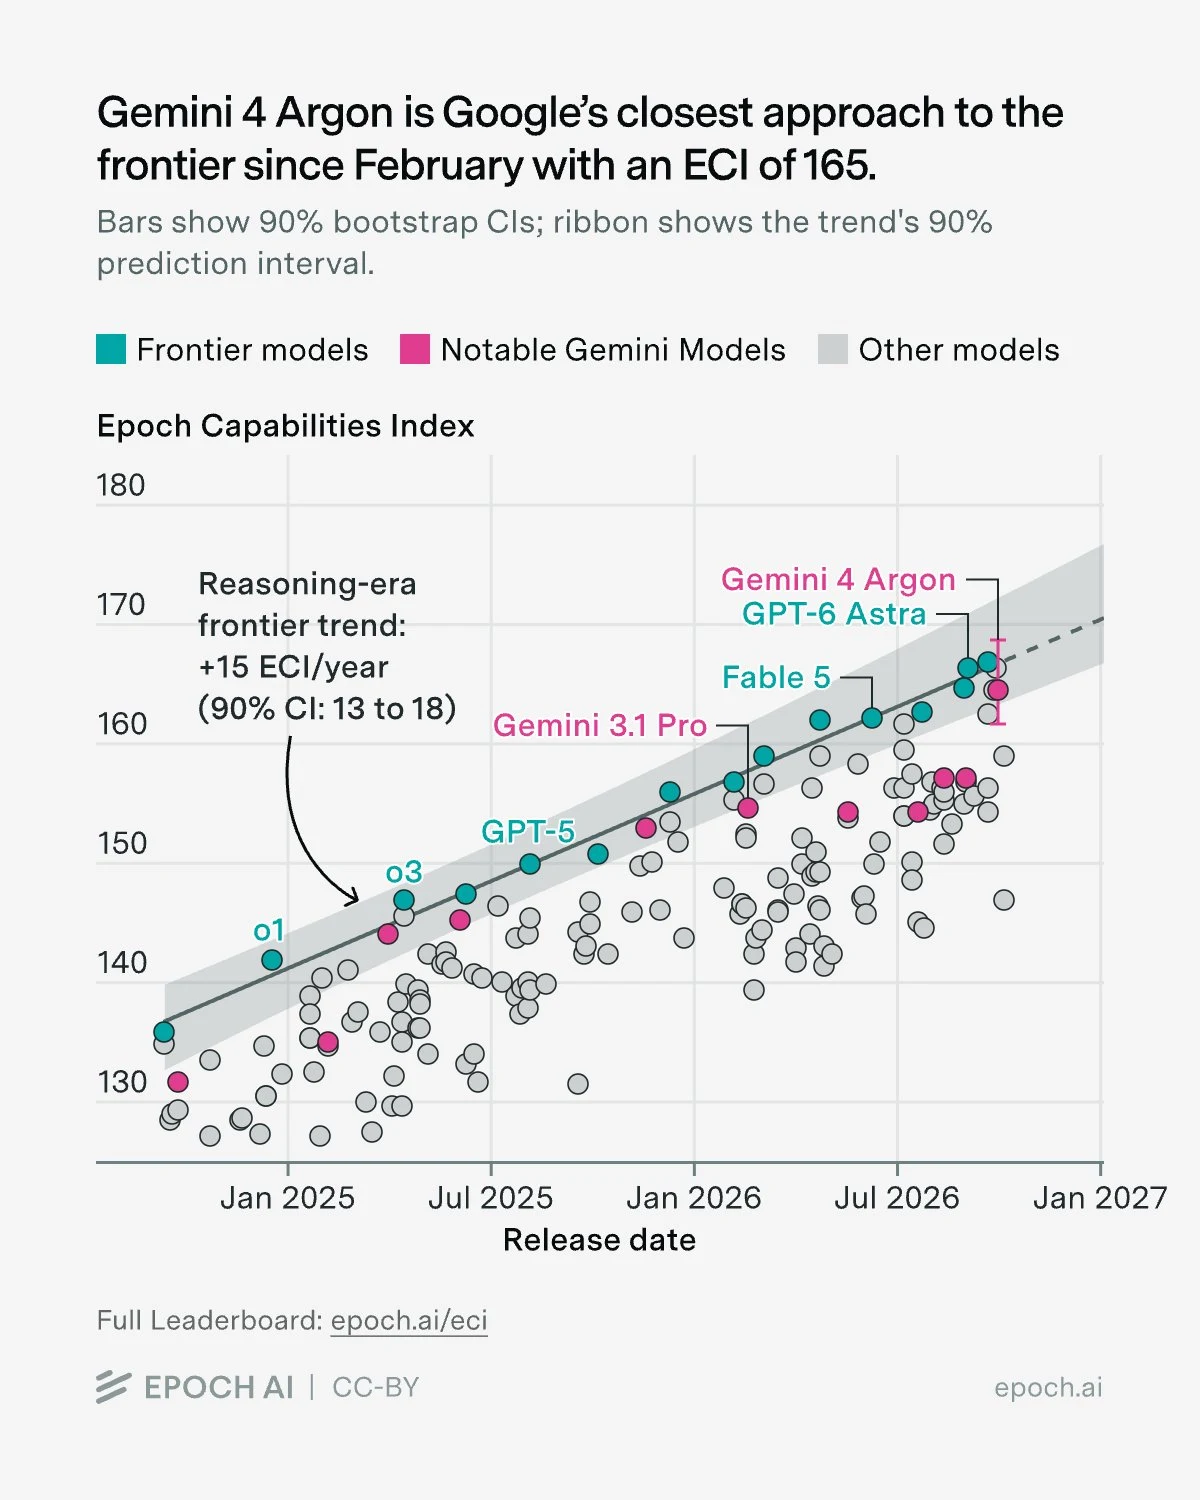
Argon springt deutlich vor Gemini 3.8 Flash (157 Punkte) hervor und bringt Google näher an die Spitze als zuvor seit Gemini 3.1 Pro im Februar. Artificial Analysis und Vals.ai bestätigten diese Entwicklung bereits zuvor.
Die Leistung variiert jedoch je nach Bereich. Laut Epoch AI liegt Argon bei mehreren Wissens-, Agent- und Vision-Benchmarken an der Spitze, doch frühe Schätzungen zufolge belegt es den achten Platz im Math ECI und den sechsten im Software Engineering Index (SWE ECI).
AI-Neuigkeiten ohne Hype – von Menschen ausgewählt
Abonnieren Sie THE DECODER, um eine adfreie Lektüre, einen wöchentlichen AI-Bulletin, unseren exklusiven „AI Radar“-Report sechsmal jährlich, Zugang zum vollständigen Archiv und Zugang zur Kommentarsektion zu erhalten.
Quelle: EpochAI | ARC Prize