
Reflection AI hat Beam vorgestellt, ein Open-Weight-Modell für agentisches Coding und Aufgaben mit langem Zeithorizont wie die Wartung von Code, die Nutzung von Tools, die Interpretation von Ergebnissen und die Ausführung mehrstufiger Workflows. Die Open-Weight-Veröffentlichung gibt Entwicklern und Forschern die Kontrolle über die Laufzeitumgebung, die Deployment-Umgebung und den Anpassungsprozess.
In diesem Beitrag erläutern wir die Vision von Reflection und zeigen, wie Sie Beam auf AWS bereitstellen können. Beginnen Sie mit einem Amazon SageMaker JumpStart Real-Time-Endpunkt für einen vollständig verwalteten Weg. Wenn Sie Kubernetes-native Kontrolle über verteilte GPU-Infrastruktur benötigen, verwenden Sie Amazon SageMaker HyperPod Inference mit JumpStart, SGLang oder vLLM. Wir erläutern auch, wie Beams insgesamt 501 Milliarden Parameter die Checkpoint-Speicherung, Gewichtsspeicher, Sharding und Parallelisierung beeinflussen, während seine 23 Milliarden aktiven Parameter den Rechenaufwand pro Token bestimmen.
Zum Start ist Beam in Amazon SageMaker JumpStart in US East (N. Virginia) und US East (Ohio) verfügbar.
Reflections Vision für offene Intelligenz
Reflections Mission ist es, Intelligenz für alle offen und zugänglich zu machen durch offene Modellgewichte, veröffentlichte Forschung und Open-Source-Software. Deren vollständiger KI-Stack umfasst Modelle, Kernsoftware, Produktionsinfrastruktur und Anwendungen. Beam bringt diesen Ansatz zu Entwicklern, die Software-Engineering- und agentische Systeme bauen.
Über Reflection Beam
Beam ist ein sparsames Mixture-of-Experts-Modell zur Behebung von Softwareproblemen, zum Modifizieren von Code, zum Aufrufen von Tools und zum Agieren auf Zwischenergebnissen. Es hat insgesamt 501 Milliarden Parameter und 23 Milliarden aktive Parameter, und Reflection meldet eine effektive Kontextlänge von 1 Million Token.
Reflection veröffentlicht Beams Gewichte über Hugging Face unter der Apache-2.0-Lizenz. Beam 1.0 ist in BF16-, FP8- und NVFP4-Checkpoint-Varianten verfügbar. Diese Formate bieten unterschiedliche Speicherbedarfe und Hardware-Kompatibilitäten. Sie können das Modell mit der AWS-verwalteten JumpStart-Container-Konfiguration bereitstellen oder das Modell mit SGLang oder vLLM in Ihrer AWS-Umgebung untersuchen und anpassen.
Verstehen Sie die Deployment-Architektur
Wählen Sie den Serving-Pfad, der Ihre Anforderungen an Kontrolle und Skalierung erfüllt.
- Beginnen Sie mit einem SageMaker JumpStart Real-Time-Endpunkt wenn Sie ein AWS-verwaltetes Modellpaket, einen Endpunkt und eine Aufruf-API möchten, ohne Kubernetes zu betreiben.
- Verwenden Sie JumpStart auf HyperPod Inference wenn Sie die AWS-verwaltete Container- und Modellkonfiguration auf einem von Amazon Elastic Kubernetes Service (Amazon EKS) orchestrierten HyperPod-Cluster möchten.
- Verwenden Sie SGLang oder vLLM auf HyperPod Inference wenn Sie das Serving-Image, Laufzeitargumente, Quantisierung oder verteilte Ausführung selbst steuern müssen.
- Dimensionieren Sie das Deployment für Checkpoint-Speicherung, Gewichtsspeicher, KV-Cache, Kontextlänge, Batching, Laufzeit-Overhead und die unterstützte Parallelisierung.
- Definieren Sie die erwartete Konkurrenz und Latenzziele und konfigurieren Sie dann Replikate, Caching, Routing und Autoscaling anhand des gemessenen Arbeitslastverhaltens.
Der JumpStart Real-Time-Pfad paketiert Modell, Container und Endpunkt hinter einem verwalteten Deployment-Workflow. Der HyperPod-Pfad legt Cluster und Serving-Laufzeit offen, sodass Sie verteilte Ausführung, Caching, Routing und Skalierung steuern können.
Das folgende Diagramm zeigt die Komponenten, die vom HyperPod-Pfad verwendet werden. Beam kann über SageMaker JumpStart, den Hugging Face Hub oder einen optionalen Amazon Simple Storage Service (Amazon S3)-Spiegel bezogen werden. Die verteilten Worker nutzen den AWS managed JumpStart-Container oder eine benutzerdefinierte SGLang- oder vLLM-Laufzeitumgebung.
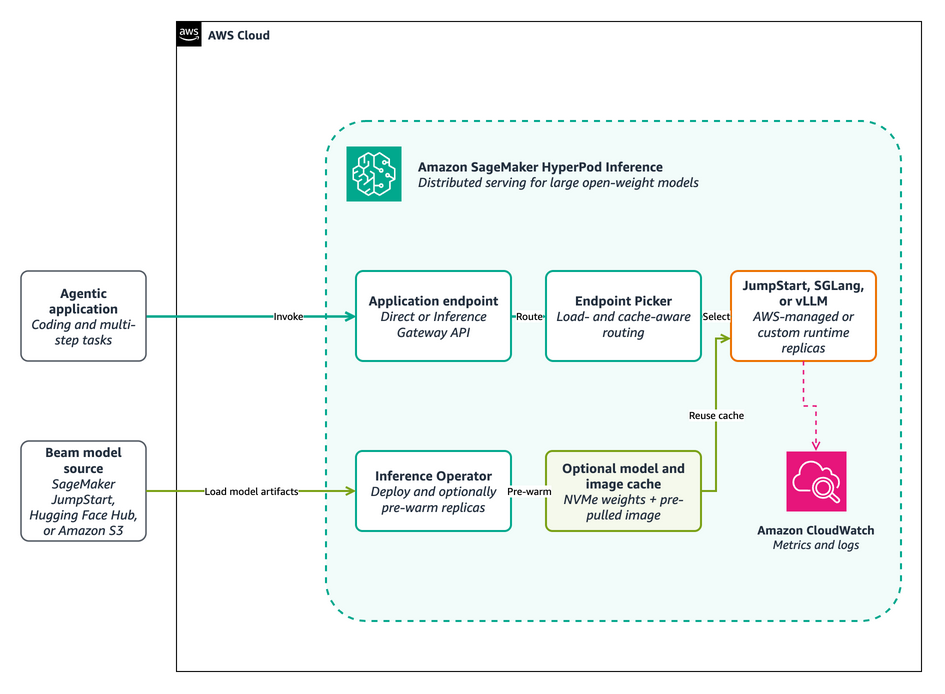
Abbildung 1: Verteilte Beam-Bereitstellung mit Amazon SageMaker HyperPod Inference
Voraussetzungen
Sie benötigen:
- Ein AWS-Konto mit Berechtigungen für Ihren ausgewählten SageMaker-Bereitstellungspfad und die zugehörigen AWS Identity and Access Management (IAM)-, Netzwerk- und Speicherressourcen.
- Zugriff auf Beam über SageMaker JumpStart oder eines der Beam 1.0-Checkpoint-Repositorys auf Hugging Face.
- Die Annahme der Modellbedingungen, die AWS Command Line Interface (AWS CLI) und Python 3.11 oder höher.
- GPU-Kontingent und -Kapazität für eine unterstützte Beam-Konfiguration.
GPU-Kapazität planen und beschaffen
Beams insgesamt 501 Milliarden Parameter erfordern eine Multi-GPU-Bereitstellung. BF16 hat den größten Gewichtsspeicherbedarf, planen Sie daher eine Multi-Node-Konfiguration mit ausreichend aggregiertem GPU-Speicher für die Gewichte und den Laufzeit-Overhead. Für FP8 verwenden Sie ml.p5.48xlarge mit NVIDIA H100 GPUs oder ml.p5e.48xlarge und ml.p5en.48xlarge mit H200 GPUs. Für NVFP4 verwenden Sie ml.p6-b200.48xlarge mit NVIDIA B200 GPUs. Bestätigen Sie, dass der veröffentlichte Checkpoint, die Laufzeitumgebung und das parallele Layout den ausgewählten Instanztyp unterstützen.
- Berechnen Sie den Speicher für Gewichte, KV-Cache und Laufzeit-Overhead für ein Replikat und bestätigen Sie die Schätzung mit einem Lasttest.
- Wählen Sie eine AWS-Region, die den erforderlichen beschleunigten Instanztyp unterstützt.
- Prüfen Sie das Servicekontingent und die verfügbare Kapazität für den ausgewählten Instanztyp. Verwenden Sie On-Demand-Kapazität, wenn verfügbar, oder verwenden Sie einen SageMaker-Trainingsplan als kurzfristige Reservierung für geplante Arbeiten.
- Planen Sie Zeit für die Bildübertragung, den Gewichtungs-Download, das Laden von Shards und die Laufzeitinitialisierung ein.
Pfad 1: Einstieg mit einem SageMaker JumpStart Real-Time-Endpunkt
Verwenden Sie zunächst einen JumpStart Real-Time-Endpunkt, wenn Sie den kürzesten Weg vom Modellkatalog zu einem verwalteten HTTPS-Endpunkt möchten. Das Beispiel unterstützt die Modell-IDs BF16, FP8 und NVFP4 über einen einzigen variantenbewussten Befehl. Seine README- und Python-Datei sind die maßgebliche Quelle für unterstützte Instanztypen, das Anforderungsschema, den Bereitstellungsbefehl und den Cleanup-Befehl.
- Klonen Sie das Beispiel-Repository.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Wechseln Sie in das Verzeichnis des SageMaker JumpStart-Bereitstellungsbeispiels.
cd sagemaker-genai-hosting-examples/01-models/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/ - Erstellen und aktivieren Sie eine Python-virtuelle Umgebung.
python3 -m venv .venv source .venv/bin/activate - Installieren Sie die Beispiel-Abhängigkeit.
python -m pip install -r requirements.txt - Führen Sie den begrenzten Lebenszyklus aus Bereitstellung, Aufruf und Cleanup für FP8 aus.
python jumpstart_real_time.py \
--variant fp8 \
--endpoint-name reflection-beam-fp8-smoke
Der Befehl stellt den FP8-Endpunkt bereit, sendet eine kurze Anfrage, gibt die Antwort aus und bereinigt den Endpunkt. Verwenden Sie
bf16odernvfp4um eine andere Checkpoint-Variante auszuwählen; NVFP4 ist die Standardeinstellung, wenn Sie--variantweglassen. Verwenden Sie die Python-Funktionen in der README, wenn Sie einen Endpunkt dauerhaft laufen lassen möchten.
Pfad 2: Bereitstellung mit SageMaker HyperPod Inference
Verwenden Sie HyperPod Inference, wenn Sie eine Kubernetes-native Kontrolle über verteilte GPU-Infrastruktur benötigen. Sie können die AWS-verwaltete JumpStart-Containerkonfiguration verwenden oder Beam mit SGLang oder vLLM bereitstellen. Die HyperPod Inference-Bereitstellungsbeispiel-README und ihre Konfigurationsdateien sind die maßgebliche Quelle für veröffentlichte Manifeste, Modell- und Bildkennungen, unterstützte Laufzeitversionen und Befehle.
Bevor Sie beginnen, konfigurieren Sie kubectl den Zugriff auf einen EKS-orchestrierten HyperPod-Cluster mit dem HyperPod Inference Operator und den erforderlichen Add-ons. Sie benötigen außerdem die virtuelle private Cloud (VPC) des Clusters, Subnetze, Sicherheitsgruppen, Zugriff auf die ausgewählten Beam- und Laufzeitartefakte sowie lokalen NVMe-Speicher, falls Sie Modell-Caching aktivieren. Verwenden Sie ein isoliertes Hugging Face-Zugriffstoken, wenn das ausgewählte Repository eine Authentifizierung erfordert.
Stellen Sie für Entwicklung und Experimente eine gepinnte Beam-Revision aus dem Hugging Face Hub bereit. Kopieren Sie für Produktionsbereitstellungen und Modell-Caching den Checkpoint nach Amazon S3 oder Amazon FSx. HyperPod-Modell- und Image-Caching kann Gewichtungen auf den knotenlokalen NVMe-Speicher vorladen und das Serving-Image vorab abrufen.
Das HyperPod Inference Gateway bietet eine OpenAI-kompatible Schnittstelle und leitet Anfragen über Replikate weiter. HyperPod Inference unterstützt außerdem verwaltetes gestuftes KV-Caching und intelligentes Routing. Dies gehört zu den im Jahr 2026 eingeführten Amazon SageMaker Inference-Funktionen.
Das nächste Diagramm erweitert den Ablauf von Modellvorbereitung und Laufzeitanfragen. Wenn Modell-Caching aktiviert ist, wärmt der Inference Operator geeignete Knoten mit den ausgewählten Gewichtungen und dem Serving-Image vor. Zur Laufzeit können das Inference Gateway und der Endpoint Picker jede Anfrage an ein geeignetes JumpStart-verwaltetes, SGLang- oder vLLM-Replikat weiterleiten.
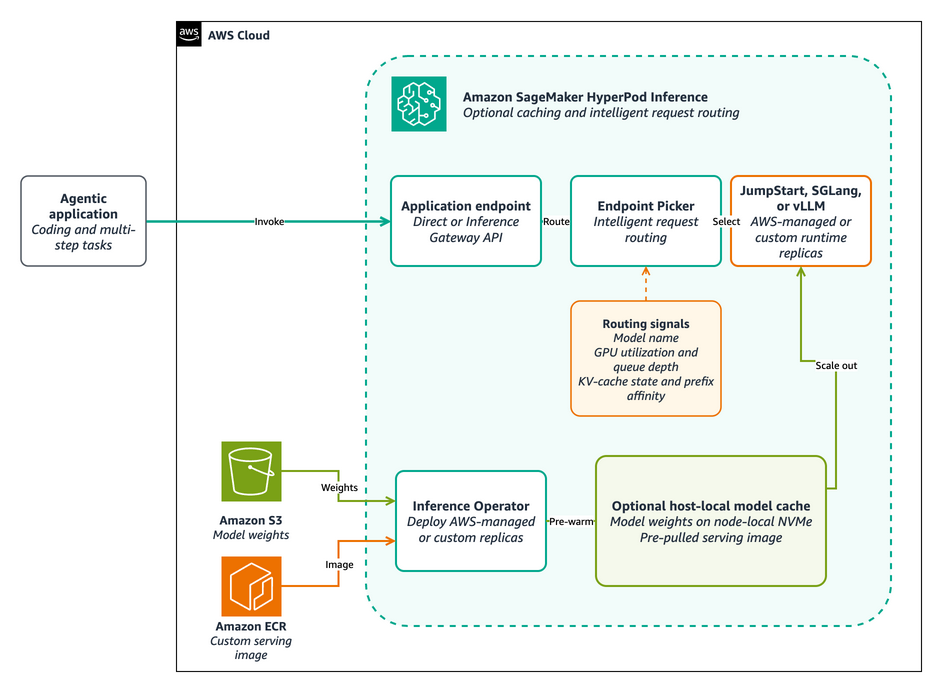
Abbildung 2: HyperPod-Modell-Caching und Anfrage-Routing
Bereiten Sie die Bereitstellungsartefakte vor
Verwenden Sie unveränderliche Eingaben, damit Sie Bereitstellungs- und Leistungsergebnisse reproduzieren können.
- Verwenden Sie die im Bereitstellungsbeispiel aufgezeichnete JumpStart-Modellversion.
- Wählen Sie das BF16-, FP8- oder NVFP4-Checkpoint für eine eigene Runtime.
- Behalten Sie für eine eigene Runtime die öffentliche Beam-Commit-SHA und das Image-Digest in der Beispiel-Release-Konfiguration bei.
- Spiegeln Sie das veröffentlichte Image nur dann in ein privates Amazon Elastic Container Registry (Amazon ECR)-Repository, wenn Ihr Cluster das Upstream-Image nicht abrufen kann oder Ihre Organisation eine genehmigte Registry verlangt.
- Halten Sie Tokens, generierte Secrets, private Modell-IDs, Registry-Zugangsdaten und unveröffentlichte Ergebnisse aus dem Repository heraus.
Wählen Sie einen Serving-Pfad
Beginnen Sie mit SageMaker JumpStart, es sei denn, Ihre Workload erfordert eine bestimmte Inferenz-Runtime oder Konfiguration.
| Serving-Pfad | Verwenden Sie es, wenn | Was Sie verwalten |
| SageMaker JumpStart | Sie möchten einen AWS-verwalteten Container und eine Modellkonfiguration mit weniger Runtime-Wartung. | Wählen Sie die Beam-Modellversion, den unterstützten Instance-Typ, die Endpoint-Konfiguration und die Scaling-Richtlinie aus. |
| SGLang oder vLLM | Sie benötigen eine spezifische Inferenz-Laufzeitumgebung oder Konfiguration, wie z. B. benutzerdefinierte Laufzeitargumente, Parser, Quantisierung oder Parallelität. | Pinning Sie das unterstützte Laufzeit-Image, die Modellrevision, die Parser-Konfiguration und die Einstellungen für die verteilte Ausführung. |
Mit SageMaker JumpStart bereitstellen
„SageMaker JumpStart reduziert den Aufwand für die Container-Integration, während HyperPod die Kontrolle über Cluster-Kapazität, Skalierung und Observability behält.“
- Öffnen Sie in SageMaker Studio die JumpStart-Modellkatalog.
- Unter Alle öffentlichen Modelle, wählen Sie Beam.
- Wählen SageMaker HyperPod als Bereitstellungsziel.
- Wählen Sie den Cluster und den Kubernetes-Namespace aus.
- Geben Sie einen Endpunkt-Namen ein und wählen Sie Bereitstellen.
- Bestätigen Sie den Bereitstellungsstatus, bevor Sie den Endpoint mit dem freigegebenen JumpStart-Anfrage-Schema aufrufen.
Für einen Infrastructure-as-Code-Workflow verwenden Sie die veröffentlichte JumpStart-Konfiguration im HyperPod-Beispiel. Sie können die reflection-beam-jumpstart.yaml Manifest-Vorlage bevor Sie die Bereitstellung konfigurieren.
- Klonen Sie das Beispiel-Repository und wechseln Sie in das HyperPod-Beam-Verzeichnis.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Erstellen Sie die in der README beschriebenen lokalen Konfigurationsdateien.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validieren Sie die JumpStart-Konfiguration, bevor Sie den Cluster ändern.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate jumpstart - Wenden Sie die JumpStart-Konfiguration an.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy jumpstart \
  --timeout-seconds 1800
Das Hilfsskript rendert und wendet die veröffentlichte JumpStartModel Ressource an, ohne ausgefüllte Release-Werte auf die Festplatte zu schreiben.
Bereitstellung mit SGLang oder vLLM
Wählen Sie SGLang oder vLLM, wenn Sie direkte Kontrolle über die Serving-Runtime benötigen. Bevor Sie die Bereitstellung konfigurieren, sehen Sie sich die reflection-beam-sglang.yaml Manifest-Vorlage oder die reflection-beam-vllm.yaml Manifest-Vorlagean. Die Beispiel-README bleibt die maßgebliche Quelle für veröffentlichte Werte und Befehle.
- Klonen Sie das Beispiel-Repository.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Wechseln Sie in das HyperPod-Beam-Verzeichnis.
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Erstellen Sie die lokalen Konfigurationsdateien, die in der README beschrieben werden.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validieren Sie die ausgewählte Konfiguration, bevor Sie den Cluster ändern.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate sglang - Deployen Sie Beam und warten Sie auf einen abschließenden Deployment-Status.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy sglang \
  --timeout-seconds 1800
Ersetzen Sie
sglangdurchvllmum vLLM zu verwenden. Der Helper validiert die ausgewählten Einstellungen, wendet das gerenderte Manifest an, ohne Release-Werte auf die Festplatte zu schreiben, wartet mit einem festen Timeout und gibt Diagnosen aus, wenn das Deployment fehlschlägt.
Rufen Sie Beam auf
Rufen Sie JumpStart-Endpunkte mit dem freigegebenen Modell-Request-Schema auf. Verwenden Sie für SGLang oder vLLM den begrenzten Smoke-Test, der im HyperPod-Beispiel enthalten ist.
Rufen Sie den bereitgestellten Endpunkt auf
- Installieren Sie die Beispiel-Client-Abhängigkeit.
python3 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt - Führen Sie eine private Integritätsprüfung und eine kurze Anfrage mit den empfohlenen Start-Sampling-Einstellungen aus.
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
Ersetzen Sie
sglangdurchvllmfür ein vLLM-Deployment. Der Helper wählt einen bereiten Worker aus, öffnet einen temporären Port-Forward, prüft die Integrität des Endpunkts, sendet die Anfrage und schließt den Port-Forward.
Die Antwort sieht in etwa wie folgt aus:
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
Verwenden Sie für ein authentifiziertes Inference Gateway das Bearer-Token-Verfahren in der HyperPod-Beispiel-README. Halten Sie Zugangsdaten fern von Quellcode, Manifesten und dem Befehlsverlauf.
Leistung messen und optimieren
- Testen Sie jeden Serving-Pfad mit wiederholten, repräsentativen Coding- und Tool-Use-Anfragen bei der erwarteten Parallelität.
- Erfassen Sie die Beam-Modellversion, das Image-Digest, den Instanztyp, die Präzision, die Kontextlänge, die Parallelität, die Serving-Argumente, den Cache-Zustand und die Anzahl der Testwiederholungen.
- Messen Sie die Anforderungserfolgsquote, p50 und p95 Zeit bis zum ersten Token, Zeit pro Ausgabe-Token, End-to-End-Latenz und aggregierte Ausgabe-Tokens pro Sekunde.
- Optimieren Sie Batch-Größe, KV-Cache-Zuweisung, Replika-Anzahl, Autoscaling sowie Modell- und Image-Caching auf Grundlage dieser Ergebnisse.
- Überprüfen Sie die Ausgabequalität nach Änderungen an der Präzision oder Quantisierung erneut.
Aufräumen
Löschen Sie Ressourcen, wenn Sie die Tests abgeschlossen haben, um laufende Kosten zu vermeiden.
- Folgen Sie für einen SageMaker JumpStart Real-Time-Endpoint den Anweisungen zum Aufräumen in der README des SageMaker JumpStart Deployment Samples.
- Folgen Sie für JumpStart, SGLang oder vLLM auf Amazon SageMaker HyperPod Inference den Anweisungen zum Aufräumen in der README des HyperPod Inference Deployment Samples.
- Löschen Sie einen eigens für die Anleitung erstellten HyperPod- oder Amazon EKS-Cluster.
- Löschen Sie ungenutzte zwischengespeicherte Gewichte, gespiegelte Artefakte, Load Balancer, Log-Gruppen, temporäre IAM-Rollen und erfasste Inferenzdaten.
Fazit
Reflection Beam bietet Entwicklern ein Open-Weight-Modell, das für agentisches Coding und mehrstufige Aufgaben entwickelt wurde. Beginnen Sie mit einem SageMaker JumpStart Real-Time-Endpoint für ein vollständig verwaltetes Deployment. Verwenden Sie SageMaker HyperPod Inference mit JumpStart, wenn Sie eine Kubernetes-native Kontrolle der Infrastruktur ohne Verwaltung des Serving-Containers benötigen, oder wählen Sie SGLang oder vLLM, wenn Sie eine eigene Runtime benötigen.
Verwenden Sie das SageMaker JumpStart Deployment Sample oder das HyperPod Inference Deployment Sampleund folgen Sie dann den Anweisungen.
Um mehr über Reflection AI und seine Vision für offene Intelligenz zu erfahren, besuchen Sie Reflection AI und lesen Sie Introducing Beam.
Ressourcen
- Reflection Beam Checkpoint-Varianten: BF16, FP8und NVFP4
- SageMaker JumpStart Deployment Sample
- HyperPod Inference Deployment Samples mit JumpStart, vLLM und SGLang
- Stellen Sie Foundation Models von SageMaker JumpStart für HyperPod Inference bereit
- Amazon SageMaker Inference – Rückblick auf die Produkteinführungen im Jahr 2026 bis heute