
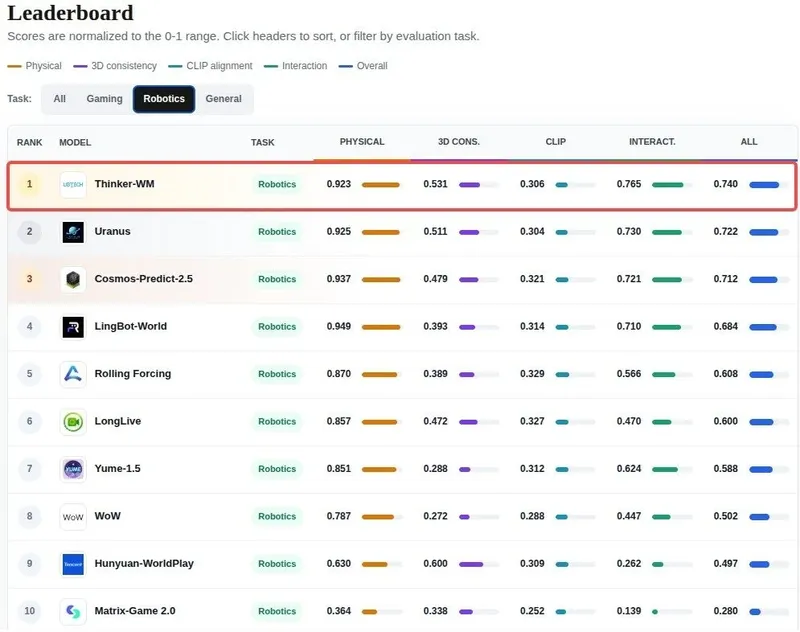
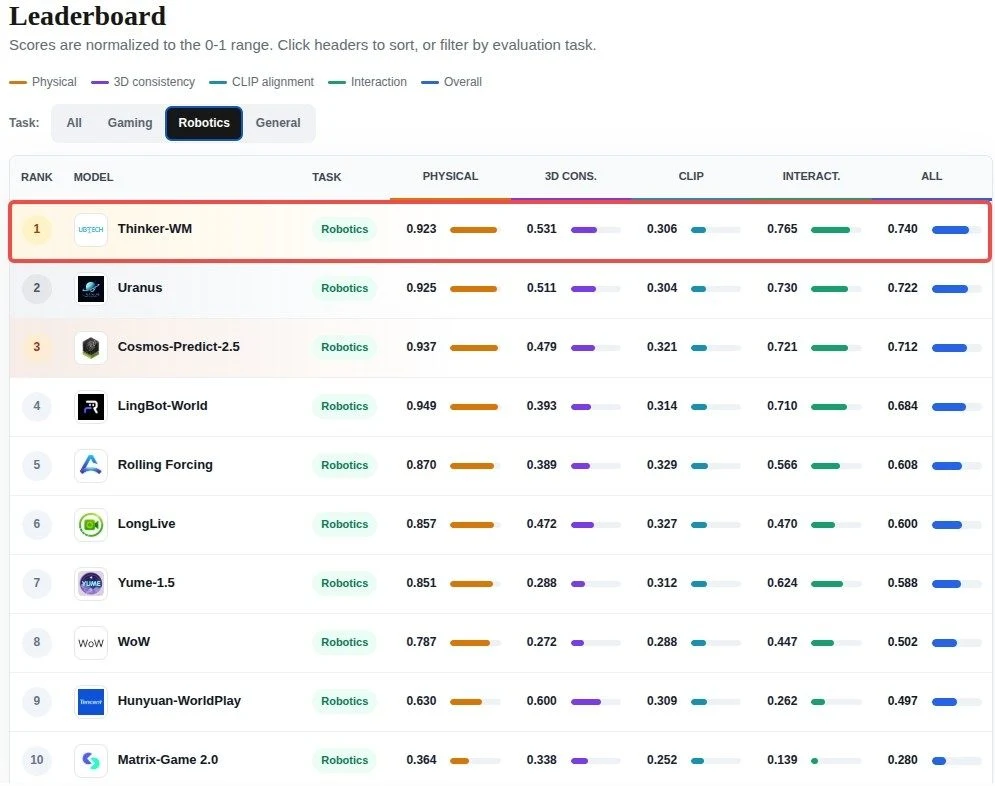
01 Alle drei Benchmark-Listen an der Spitze – Thinker-WM erzielt drei erste Plätze
Vor kurzem errang der YubiXiang Thinker-WM in allen drei anerkannten Weltmodell-Benchmarking-Tests den ersten Platz und verbesserte damit seine Branchenleistung:
WorldOlympiad:
Der Thinker‑WM erzielt einen Gesamtwert von 0,740 und belegt den ersten Platz. Dieser Benchmark basiert auf umfangreichen echten Roboterinteraktionsdaten, die mehr als zehn verschiedene Robotermodelle und verschiedene Kamerakonfigurationen umfassen. Der Schwerpunkt liegt auf der Generalisierungsfähigkeit des Modells in verschiedenen Roboterformen und Perspektiven. Das Modell erreicht Werte für die 3D-Konsistenz von 0,531 und die Interaktionsgenauigkeit von 0,765 – beide Indikatoren sind bei allen Teilmodellen die höchsten. Dies zeigt die exakte Modellierfähigkeit des Modells bezüglich der dreidimensionalen Geometrie und des Roboterinteraktionsprozesses.
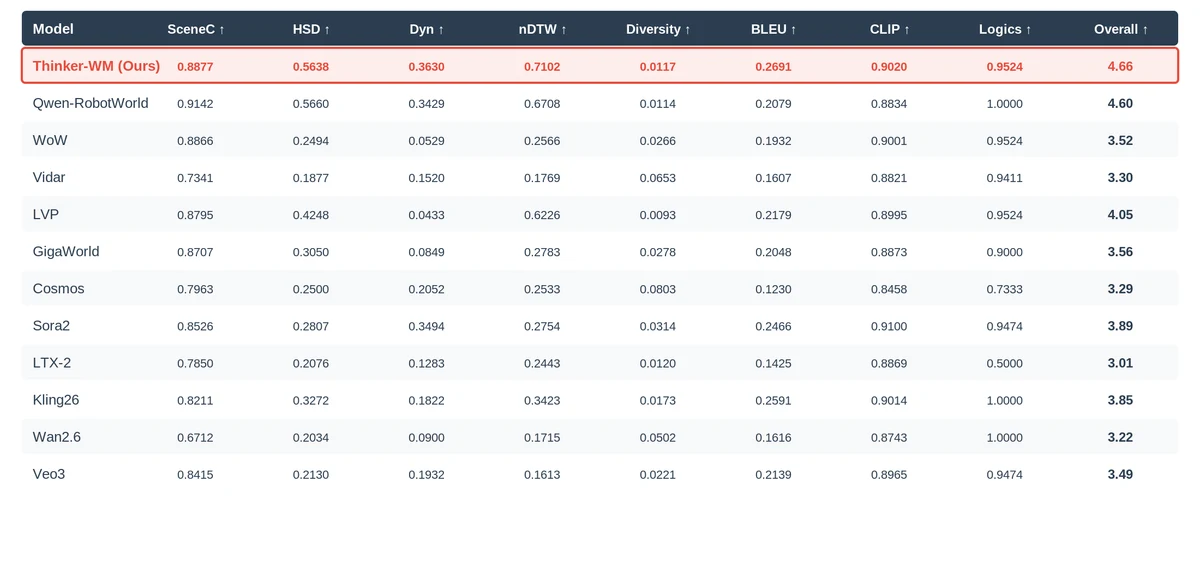
EWMBench:
Der Thinker‑WM erzielt einen Gesamtscore von 4,66, der höher ist als die wettbewerbsfähigen Modelle wie Qwen‑RobotWorld und Sora2. EWMBench bewertet drei Hauptkriterien: Konsequenz des vollständigen Testscenarios, Korrektheit der Endbewegungen des Roboters und semantische Übereinstimmung der Befehle. Dank des multimodalen gemeinsamen Modellings auf representativer Ebene ist der Thinker‑WM bei den zentralen Kriterien der Robotbewegung führend – wie nDTW (Normalisierte dynamische Zeitregulierung) zur Darstellung der räumlich-zeitlichen Übereinstimmung der Robotentrajektorie und Dyn (Dynamikkonsequenz) zur Berechnung der Bewegungsgeschwindigkeit und Beschleunigung.
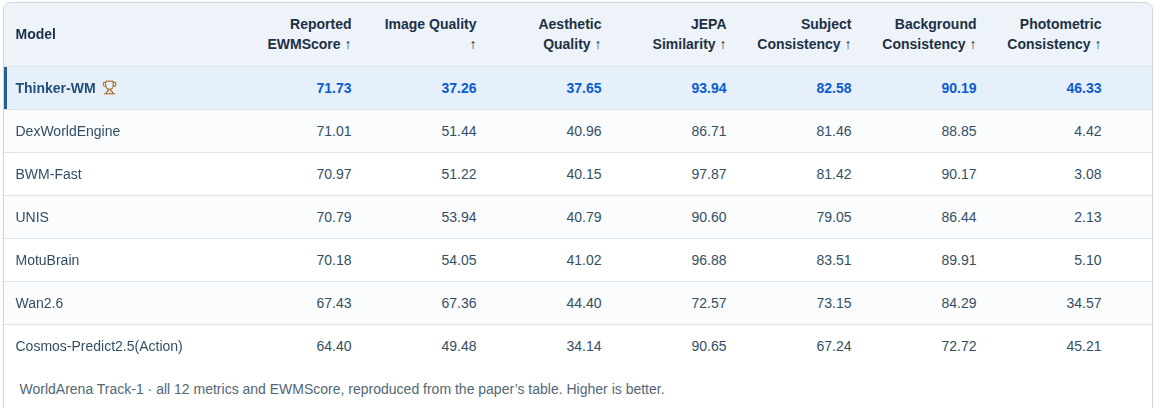
WorldArena1.0 Track-1:
Im Simulationsumfeld-Referenz-WorldArena Track‑1 ist Thinker‑WM in 12 Schlüsselbewertungsdimensionen wie visuelle Qualität, Inhaltliche Kohärenz, physikalische Richtigkeit, 3D-Geometrische Genauigkeit und Anleitungsempfang überlegen – und kombiniert somit die visuelle Erzeugungsqualität im Simulationsumfeld mit der Glaubwürdigkeit der physischen Interaktion. Der Thinker‑WM basiert auf dem Unified Dynamic Transformer (UDT), der die Charakterisierungsschichten vereint, und integriert RGB-Bilder, Metrik-Depth sowie Roboterbewegungen in ein gemeinsames dynamisches Charakterisierungsmodell, um eine Kombination von Video- und Bewegungsgenerierung, Weltvorhersage, Strategieabwägung, Video-auf-Bewegung und inverse Dynamik zu ermöglichen. Dies bietet eine neue Generation eines grundlegenden Weltmodells für embodied Intelligence.
02 Thinker-WM-Technologiebreakthrough: Auf der Representationsseite eine Einheitlichkeit von visuellen, geometrischen und motorischen Multimodalen Ebenen erreicht
Das Schwierigste, um den Roboter in der realen Welt zu nutzen, ist nicht die Erkennung der Objekte vor den Augen, sondern die Vorhersage der nächsten Veränderung des Umfelds. Das ist auch der Wert und die Bedeutung des Weltmodells. In der Vergangenheit verwendeten die Weltmodelle üblicherweise ein „Schnittmuster“-Verfahren: Die Videogenerierung ist für die Bilder zuständig, das Strategienetzwerk für die Bewegungen, die geometrische Vorhersage für die räumlichen Informationen. Die Module berechnen unabhängig und werden dann über Schnittstellen zusammengesetzt und ausgegeben.
Das Problem dieses technischen Modells besteht darin, dass Handlungen die Umgebung verändern und die Umgebung wiederum Handlungen einschränkt. Die geometrische Struktur beeinflusst beide Aspekte gleichzeitig. Signale, die physisch eng miteinander verbunden sind, werden in verschiedene Module aufgeteilt, wodurch ihre innere kausale Verbindung verloren geht.
Zum Beispiel ist die Aussage „Ein Becher wird vom Tisch geschoben“ in der Sprache eine einzige Beschreibung, in der Handlung eine Reihe von Befehlen, im Video eine Sequenz von Objektbewegungen und in der Tiefe eine Reihe von kontinuierlich variierenden Distanzfeldern. Die vier Darstellungen beziehen sich auf denselben Ereignis, nicht auf vier unterschiedliche Objekte. Daher ist die Anforderung, dass das Modell jedes dieser Ausdrucks generiert, im Grunde genommen die Frage nach demselben Prozess.
Aber diese Überlagerung ist auch unvollständig. Die Bewegungen tragen weder Erscheinungsbild noch Kontext; dieselben Gelenkbefehle haben bei einer leeren Tischfläche und bei einer chaotischen Tischfläche völlig unterschiedliche Bedeutung. Die Sprache trägt auch keine Zeit- und Raumdetails: Der Satz „Der Becher wird vom Tisch geschoben“ vorgibt weder, von welcher Seite er geschoben wird, mit welcher Kraft oder mit welcher Geschwindigkeit, noch die genaue Bewegungskurve der Hand, wie oft der Becher umkippt oder wo er schließlich landet. Die Video-Datei enthält keine expliziten Geometrien und Maße; sie wird lediglich durch eine Reihe von Pixel dargestellt. Es ist nicht bekannt, wie groß das Glas ist oder wie weit es vom Tisch entfernt ist. Die Tiefe trägt ebenfalls keine äußere Erscheinung, Namenssemantik oder Absicht; sie gibt an, wo die Oberfläche ist, wie sie verdeckt wird und wie sie berührt wird, aber es ist nicht bekannt, ob es sich um ein Glas oder eine Tischdecke handelt, noch warum man es bewegt.
Zu dieser Problematik hat das Team von U必选 Thinker eine völlig neue Lösung vorgeschlagen: Anstatt einfacher Kombinationen an der Schnittstelle zu verwenden, wird die Multimodalität auf der Repräsentationsebene vereint. Der Thinker-WM (Thinker World Model) ist das von U必选 entwickelte einheitliche Multimodalmodell der Welt, der RGB-Video, Tiefen und Roboterbewegungen in denselben mittleren Repräsentationsraum einbettet und durch eine gemeinsame Parametergruppe kooperativ evolviert. Ästhetik, Geometrie und Bewegung sind nicht mehr drei unabhängige Prozesse, sondern drei Ausdrucksformen eines einzigen Welt-Entwicklungsprozesses. Das heißt, die unterstehende Designlogik von Thinker-WM kann wie folgt zusammengefasst werden: Unterschiedliche Modi sind verschiedene Darstellungen desselben Prozesses; das Modell bringt sie in einen gemeinsamen Repräsentationsraum zusammen und inferiert auf diesem gemeinsamen Repräsentationsraum, anstatt eine Bedingungskombination an den Modi-Interferenzen durchzuführen.
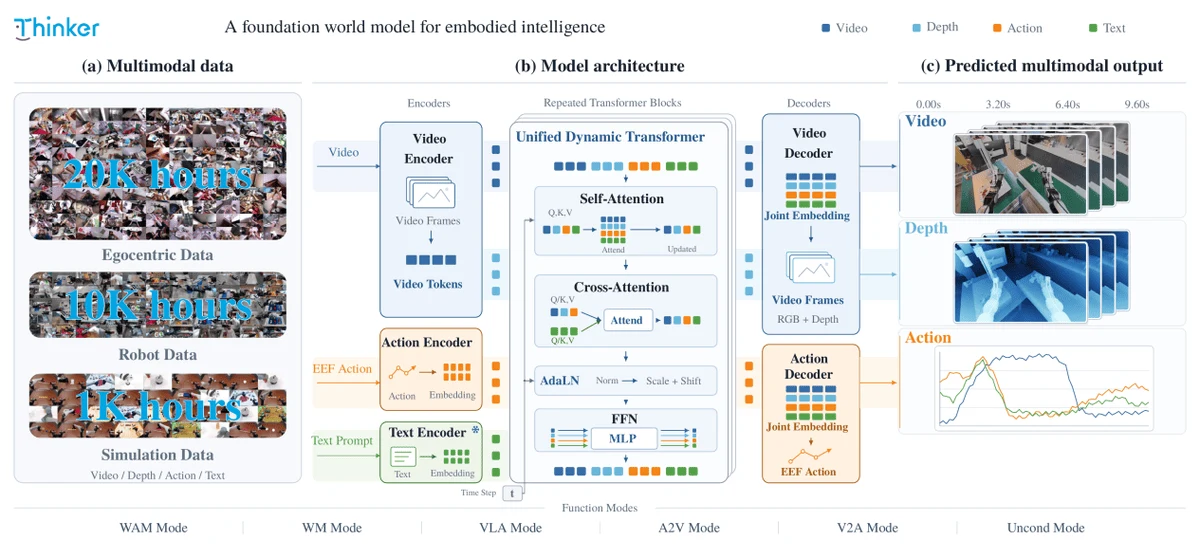
Thinker-WM: Ein einheitliches Modellierungsrahmenwerk für Vision, Geometrie und Bewegung
Insbesondere werden die RGB-Bilder, die Tiefeninformationen und die Handlungen des Roboters jeweils durch ihre entsprechenden Encoders in einen gemeinsamen Potenzialraum übertragen. Anschließend werden sie an den gemeinsamen Unified Dynamics Transformer (UDT) übergeben, um eine gemeinsame zeitliche Modellierung durchzuführen. Schließlich werden die jeweiligen Decoder das Ausgabevideo, die Tiefenbild und die von dem Roboter ausführbaren Handlungen wiederherstellen. Dies bedeutet, dass die Multimodale Interaktion innerhalb des Transformer stattfindet. Die visuellen Tokens, die geometrischen Tokens und die Action-Tokens tauschen Informationen direkt durch das gleiche Attention-Modell aus, anstatt in den Eingangs- oder Ausgangsschichten oberflächlich zusammengefügt zu werden.
Die geometrischen Informationen sind nicht mehr nur als unterstützende Überwachungssignale. Thinker-WM verwendet den Tiefenmodus als natürliche Generierungsmodalität, die dieselbe potenzielle Topologie und zeitliche-räumliche Organisation wie das Video aufweist. Der Tiefenüberwachung wird direkt eine gemeinsame Repräsentation verliehen, wodurch die Struktur des physischen Raums zur „Muttersprache“ des Weltmodells wird und nicht zu einem nachträglichen zusätzlichen Modul, was wiederum dem humanoiden Roboter hilft, den physischen Raum genauer zu verstehen. Der Wert der einheitlichen Modellierung zeigt sich auch in der tatsächlichen Ausführung des Roboters. Im RoboTwin-Single-Task-Ablation-Experiment stieg die Erfolgsrate der Operationen nach dem Einfügen des Tiefenmodus um 15 Prozentpunkte im Vergleich zum ohne Tiefenmodus, was zeigt, dass die räumlichen geometrischen Informationen nicht nur dazu beitragen, das Modell die Szene zu verstehen, sondern auch die Handlungsebene und die Aufgabenerfüllung verbessern.
03 30.000 Stunden heterogene Daten – ein Modell mit sechs Fähigkeiten aktivieren
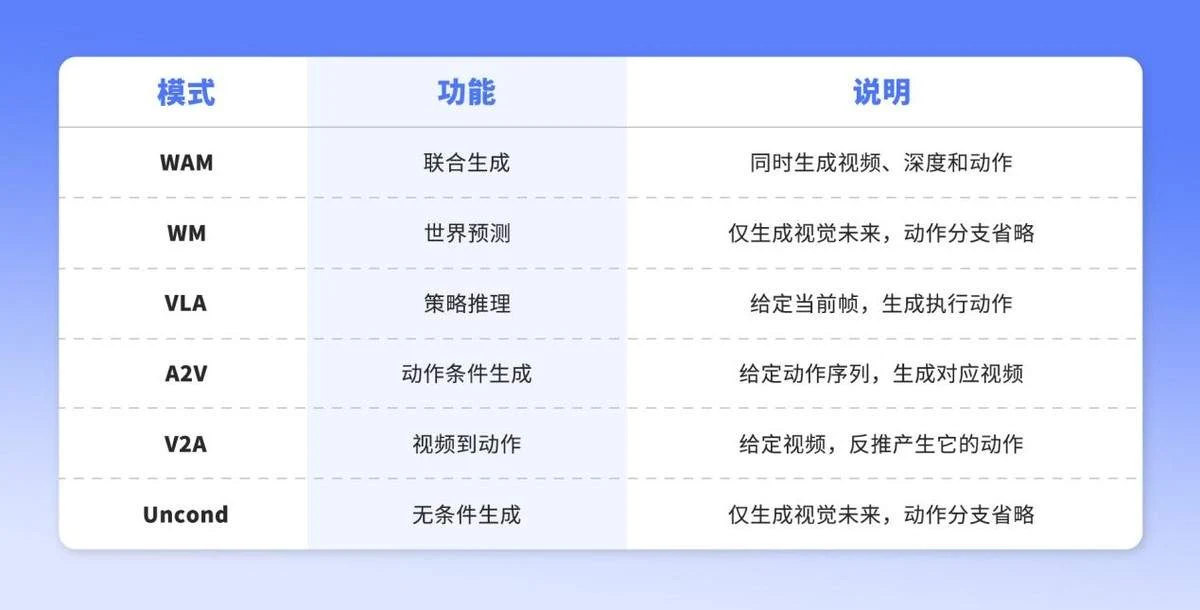
Durch eine multimodale einheitliche Repräsentation teilen alle Modi denselben Parametergruppe. Thinker-WM kann durch die flexible Wechselung zwischen Bedingungsmodus und Erzeugungsmodus sechs Fähigkeitsmodi unterstützen.
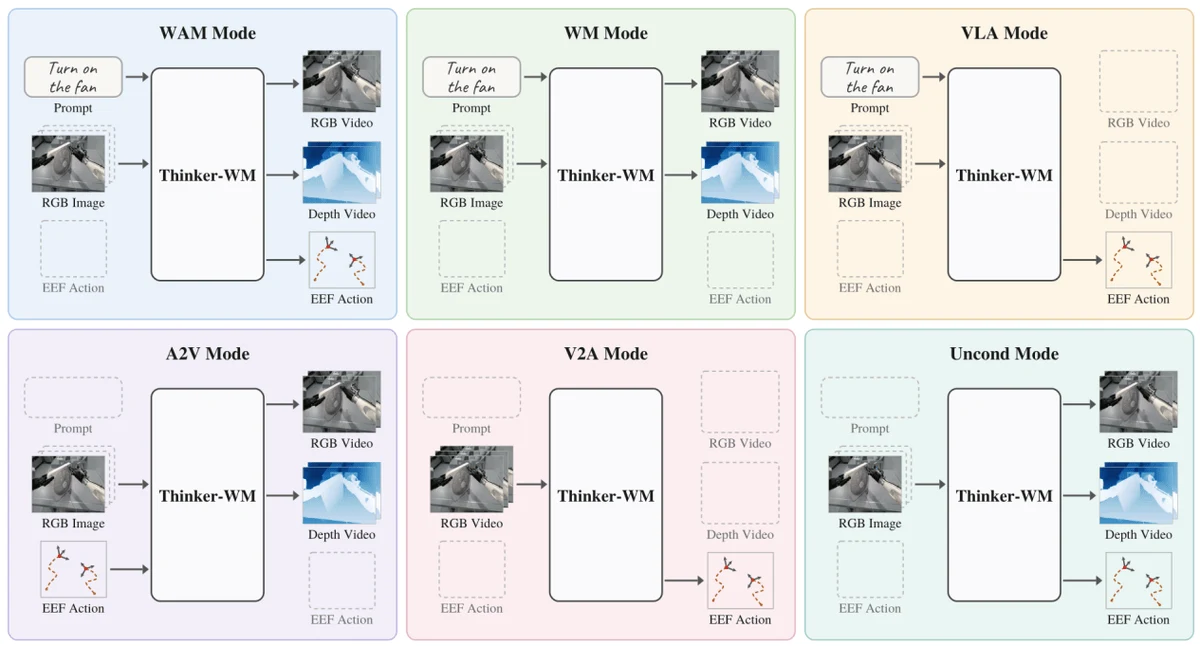
Derselbe Gewichtungswert ermöglicht es, die zukünftigen Bilder vorherzusagen und zu imaginieren, die Verlaufsspuren des Roboters rückwärts zu simulieren, sowie Informationen über Bewegungen aus Videos zu extrahieren. Das sind die wesentlichen technischen Vorteile, die durch die einheitliche Repräsentation entstehen.
04 30.000 Stunden heterogene Daten – das bildet die Grundlage des Allgemeinen Weltmodells
Hinter der einheitlichen Repräsentationsfähigkeit steht die Unterstützung durch reichhaltige und vielfältige Trainingsdaten von Yobit. Das Trainingsmaterial von Thinker-WM verfügt über eine beträchtliche Menge im Bereich der embodied Intelligence:
- Etwa 20.000 Stunden an Personenvideos: Beziehen sich auf Haushalt, Einzelhandel und Industrie-Szenarien. Sie ergänzen die Vielfalt an Aufgaben, Objekten und Szenen, bei denen die Fernsteuerung von Robotern auf niedrigem Preisniveau nicht möglich ist, und umfassen zusätzlich etwa 1.000 Stunden an Daten über die Ausrichtungstiefe.
- Etwa 10.000 Stunden echte Roboterdaten: von verschiedenen Robotformen, die eine Kombination aus visueller Beobachtung und ausführbaren Handlungen bieten, wobei etwa 3.000 Stunden mit tiefen Annotierungen für die Ausrichtung verfügbar sind.
- Etwa 1.000 Stunden Simulationdaten: Bereitstellung von präzisen geometrischen und physikalischen Überwachungssignalen.
Die Bewegungsräume, Koordinatensysteme und Steuerprotokolle verschiedener Roboter unterscheiden sich stark voneinander. Der einheitliche Ansatz von Thinker-WM wird nicht nur auf das Modellmodul angewandt, sondern auch bei der Datenauswahl. Das Modell verwendet eine einheitliche Endposition zur Darstellung aller Roboterbewegungen und fügt gleichzeitig spezifische Tags in die Tokens ein, um die unterschiedlichen Roboterformen zu ermöglichen. So können Roboter verschiedener Formen denselben Generationsraum teilen, ohne dabei die präzise kinetische Steuerung zu verlieren.
05 Daten Infra: Eine große Anzahl heterogener Daten zur effizienten Unterstützung des gemeinsamen Modelltrainings
Um riesige Daten in die Modelleigenschaften zu überführen, ist eine stabile und effiziente Dateninfrastruktur unerlässlich. Angesichts der Unterschiede in Format, Modus und Annotationen zwischen verschiedenen Roboten, menschlichen Videodaten und Simulationsdaten hat das Team von U5Sense Thinker die Data Factory entwickelt. Dadurch wird die Datenverwaltung von der Trainingssamplingsierung getrennt, sodass mehrquellenbasierte Daten flexibel nach den Anforderungen des Modells kombiniert werden können.
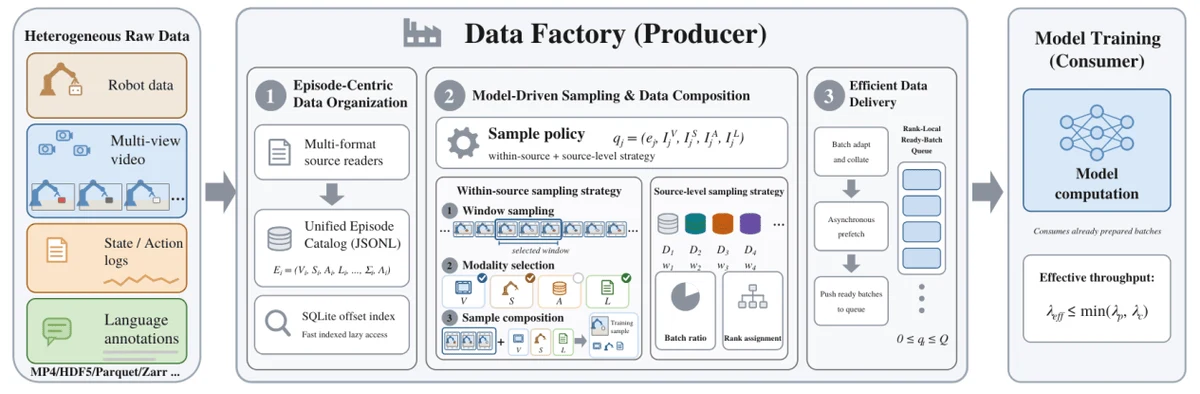
Data Factory: Von heterogenen Daten aus verschiedenen Quellen bis zum Training eines einheitlichen Modells
Data Factory unterstützt das Training durch drei Schlüsselaspekte: eine einheitliche Organisation von Videos, Statusdaten, Handlungen und Sprachinformationen, sowie die Erzeugung von Beispielen für verschiedene Trainingsmodi nach Bedarf; schichtweise Qualitätskontrolle, um anormale Abschnitte zu filtern, Überprüfung der Tiefe und der Video-Aufnahme, um die Zuverlässigkeit der Trainingssignale zu gewährleisten; asynchrone Vorablagerung und Kompensation von Kodierung, um die Vorbereitung der Trainingsdaten vorzubereiten und Wartezeiten sowie wiederholten Berechnungen zu reduzieren.
Diese Dateninfrastruktur ermöglicht es, multi-Quellen-spezifische heterogene Daten zuverlässig zu organisieren, flexibel zu nutzen und effizient bereitzustellen, und bietet technische Unterstützung für die gemeinsame Trainierung sowie die kontinuierliche Iteration der sechs Fähigkeitsmodi von Thinker-WM.
06 Durch die Experimentdesign-Strategie mit Motion Probe: Leichtes Experiment – Überprüfung der echten Kombination zwischen Modi
Auf der Repräsentationsebene ist die Einheitlichkeit mehrerer Modi erreichbar – das klingt wie eine Innovation in der Architekturdesign. Doch es gibt eine zentrale Frage: Handelt es sich wirklich darum, dass das Modell die koppelnden Beziehungen zwischen visuellen, geometrischen und bewegungsbezogenen Daten im gemeinsamen Raum lernt, oder verarbeitet es einfach parallel verschiedene Informationen und setzt die verschiedenen Modi einfach zusammen?
Um diese Frage zu beantworten, hat das Thinker-Team von UebaiX ein leichtes Motion Probe-Validierungsexperiment entwickelt. Das Forschungsteam führte eine sehr kleine Bewegungsvorhersage-Kopplung auf die gefrorene UDT-visuelle Repräsentation ein und trainierte nur diese Kopplung, um zu sehen, ob es möglich ist, den Abstand des Endausführers aus der reinen visuellen Repräsentation wiederherzustellen.
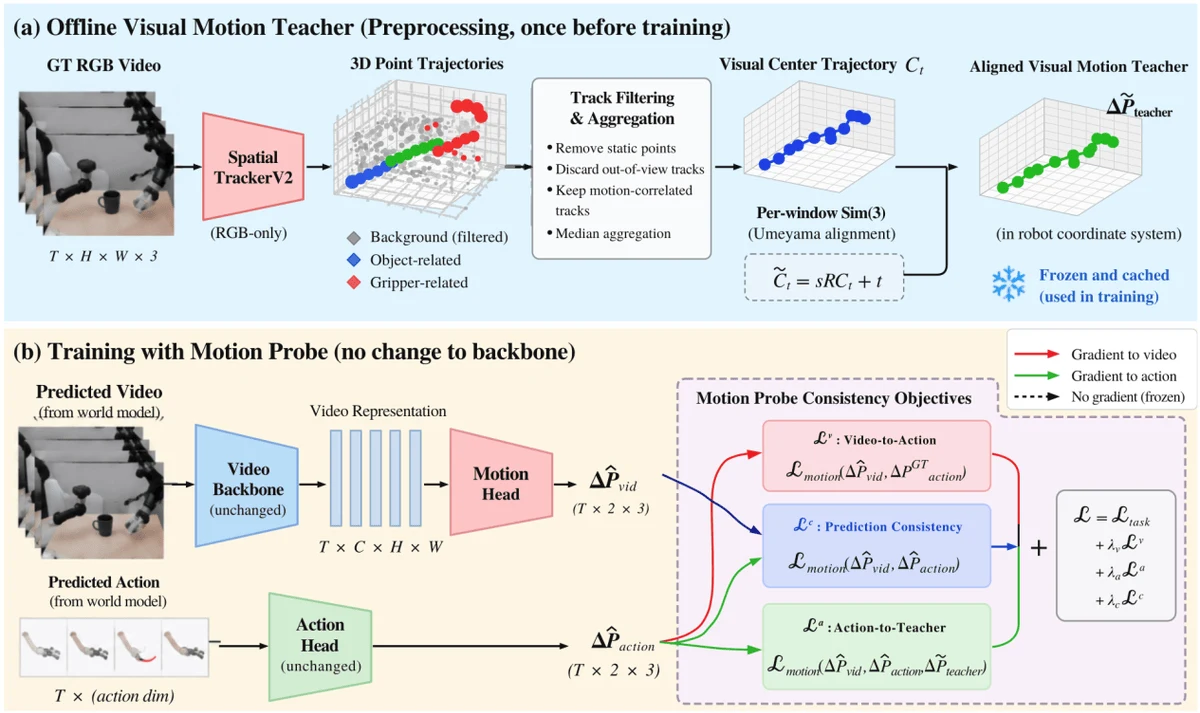
Skizze der Motion Probe
Die Experimentergebnisse bestätigen die Vermutung: Die Vorhersagefehler des Sensors sind sehr niedrig. Selbst ohne Aktionsüberwachung ist die visuelle Repräsentation bereits mit Bewegungsinformationen über Aktivitäten gekodet. Dieses Ergebnis beweist direkt, dass die Multimodalität auf der Repräsentationsebene tatsächlich wirksam ist. Die visuelle Wahrnehmung und die Aktionsplanung sind nicht zwei unabhängige Prozesse, sondern realisieren eine tiefe Kopplung im gemeinsamen potenziellen Raum.
07 Was bedeutet das?
Das zeigt auch weiterhin, dass der technische Durchbruch von Thinker-WM weit mehr wert ist als nur die Erfolge bei der Rangsteigerung. Es weist auf das neue Grundprinzip des Körper-basierten Weltmodells hin:
Das Weltmodell der embodied Intelligenz sollte keine einfache Kombination von „Video-Generator + Strategie-Kopf“ sein, sondern ein vollständig integriertes Generierungsprozess – visuelle Beobachtung, räumliche Struktur, Handlungsplanung – die verschiedenen Ausdrucksformen eines einheitlichen physikalischen Weltprozesses sind.
Wenn Roboter in derselben Darstellungsraum die Veränderungen der Bildübergabe, die Raumstruktur und die Bewegungsbahn synchron ausführen können, kommt das Verständnis für die kausale Logik der physischen Welt einen großen Schritt voran. Dies ist auch der entscheidende Sprung, den Roboter von „Verfügbarkeit zur Ausführung von Aufgaben“ zu „Verständnis des echten Welt“ machen.
Thinker-WM hat die Implementierung und Verifizierung auf der Yibaiyi-Roboterplattform abgeschlossen. Die damit verbundenen Technologien werden weiterhin die nächste Generation von körperbasierten Intelligenzsystemen unterstützen.
Die Erkundungen von Thinker-WM werden nicht nur durch die Veröffentlichung dieser Ergebnisse enden. Der technische Bericht über das Modell sowie die folgenden Iterationsversionen werden im offiziellen Community-Forum für Entwickler von Thinker Cosmos von UBTRobot kontinuierlich aktualisiert werden; das Programm zur Offenlegung der Fähigkeiten bei der zweiten Entwicklung von Weltmodellen und Vorankündigungen zu technischen Interpretationen werden ebenfalls sofort den Entwicklern bekannt gegeben. Bitte schließen Sie sich Thinker Cosmos an (https://thinkercosmos.ubtrobot.com/), um gemeinsam die Ökologie der körperbasierten Intelligenz zu gestalten.
Projekt-Link
Artikellink: https://arxiv.org/abs/2610.18447
Projektadresse: https://thinkercosmos.ubtrobot.com/thinker-wm
Github: https://github.com/UBTECH-Robot/Thinker-WM
Huggingface: https://huggingface.co/UBTECH-Robotics/Thinker-WM
Dieser Artikel wird von UBeiX bereitgestellt, QuantumBit hat die Lizenz zur Veröffentlichung erhalten, die Meinungen gehören dem ursprünglichen Autor.